ARTICLE · 1130512
为什么说Scan函数,改变了Excel几十年的使用习惯?
为什么说Scan函数,改变了Excel几十年的使用习惯?
我们先来看一张图。 A列是“款项”。A2是“应收账款”,下面跟着两笔金额15,200和3,600;A5是“应付账款”,下面跟着三笔金额;A9是“预付账款”,下面跟着一笔金额。而B列我们想要的结果也很直观:每一笔金额都要带上它所属的科目名称,让人一眼就知道这17,450是应付账款而不是应收账款。 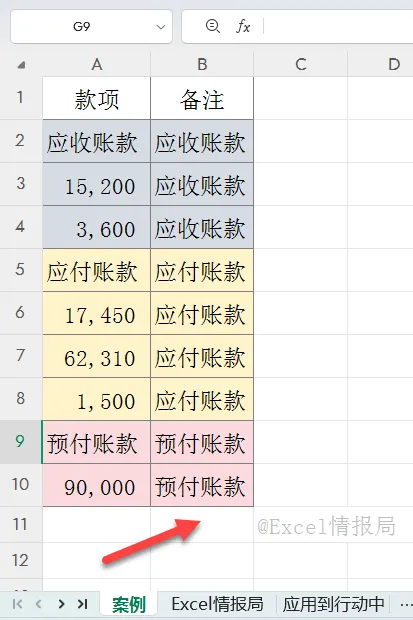
这是财务、会计、审计场景里最常见的一类需求。 问题不难。但解法的转变,恰好展示了Excel从上古时代到现阶段动态数组时代的演化过程。 
在上古时代,我们一般都是用手动辅助+相对引用拖公式的方法。 这是绝大多数老用户的肌肉记忆。 第一步:在B2手动输入“应收账款”。 因为公式没法自己知道第一行该是什么。 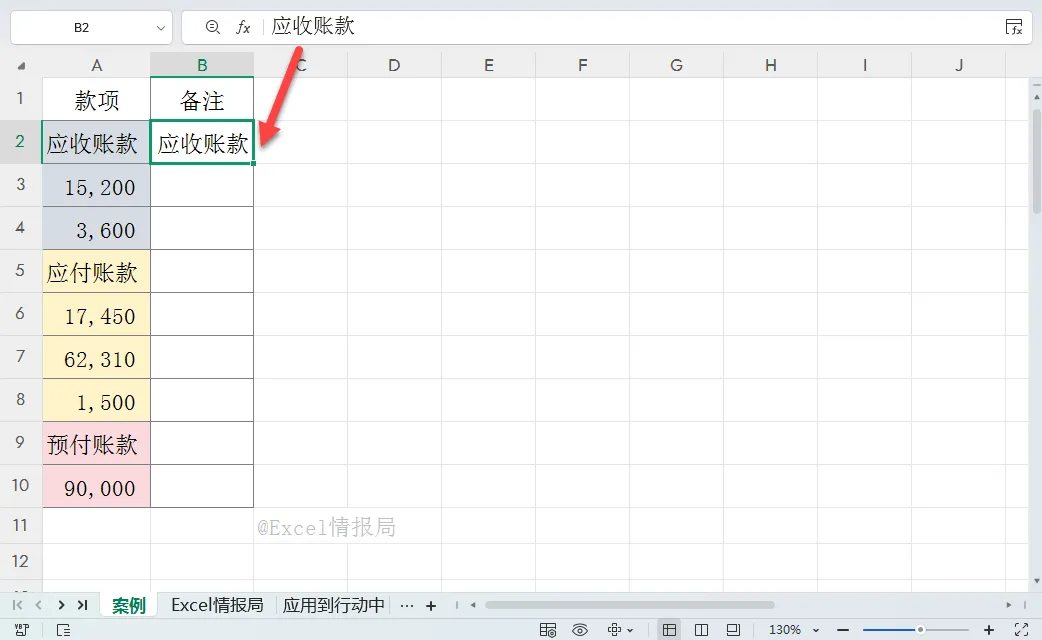
第二步:在B3输入公式: IsNumber(A3)判断当前行的A列是不是一个数字。 如果是数字,比如15200,说明这是一笔金额,它自己不带科目名,那就继承上一行B列的值,也就是B2里的“应收账款”。如果不是数字,比如A5又出现了“应付账款”,说明遇到了新科目,那就取当前行A列自己的值,也就是A3这个位置的文本。 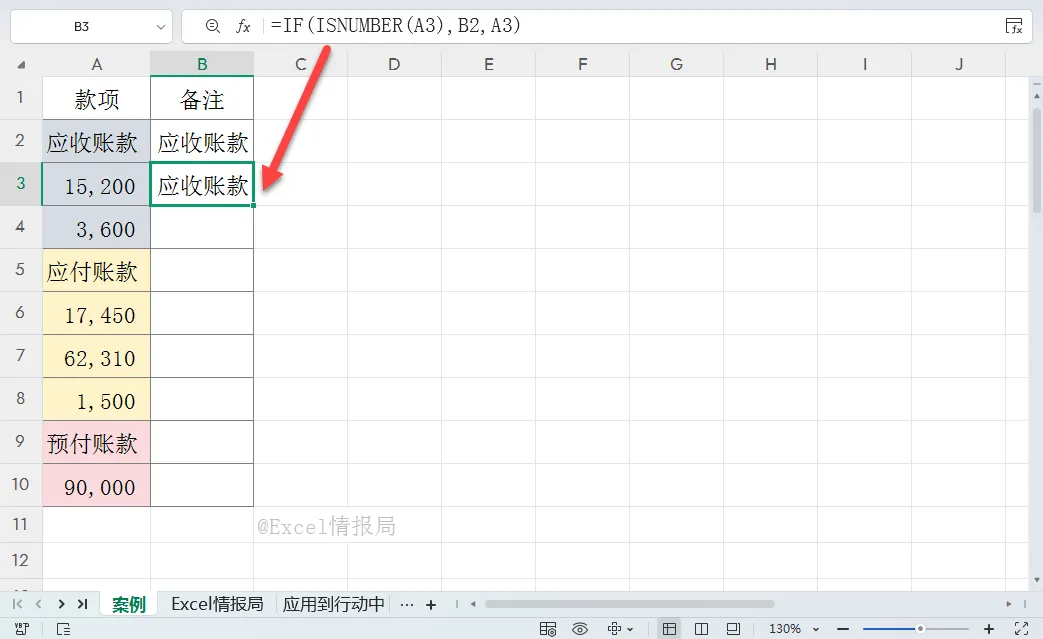
然后双击或拖动右下角填充柄,一路拖到B10: 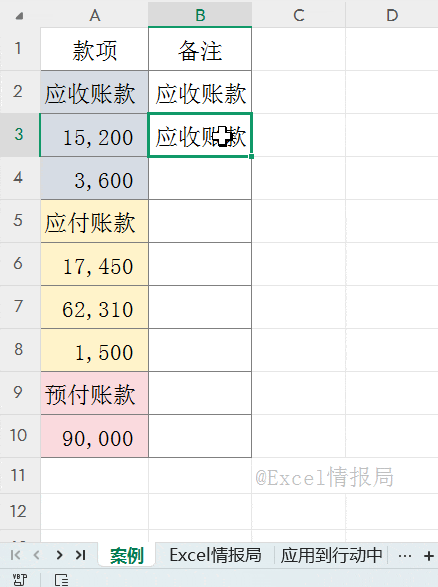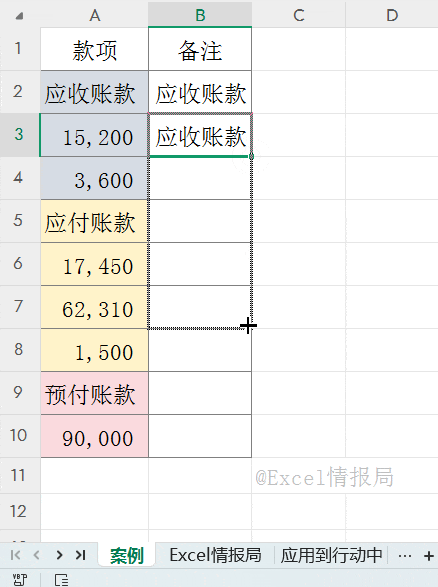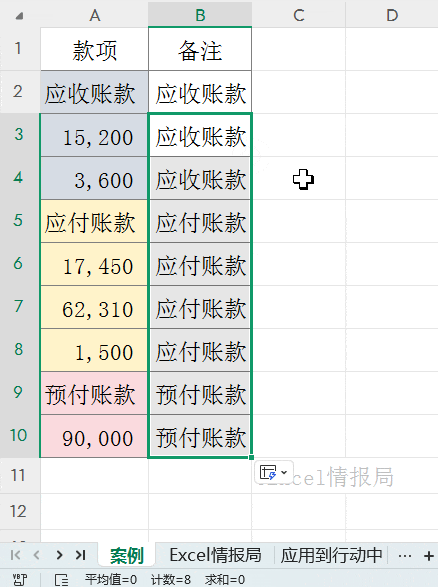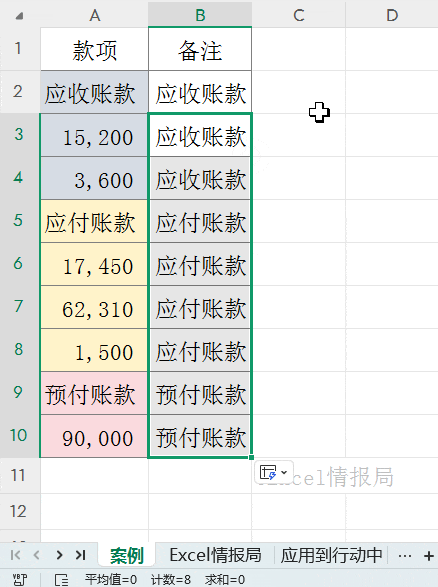
这个公式能跑通,全靠一个心照不宣的默契:B3永远看着B2,B4永远看着B3。公式里的B2是一个相对引用,拖到哪一行,它就自动指向上一行。你甚至不需要理解“状态”这个概念,Excel会帮你把“上一行”这个物理位置记住了。 但它的脆弱性也藏在了这个默契里。也就是说你必须手动在B2敲第一行,否则整张公式链从开头就断了。公式依赖“上一行”这个物理位置。如果有人在数据源中间删了一行,整个逻辑链立刻错位。你永远要先知道 数据一共有多少行,再手动拖到那个位置。 稍微聪明一点的写法,是把起点从B3挪到B2,让公式自己处理第一行: 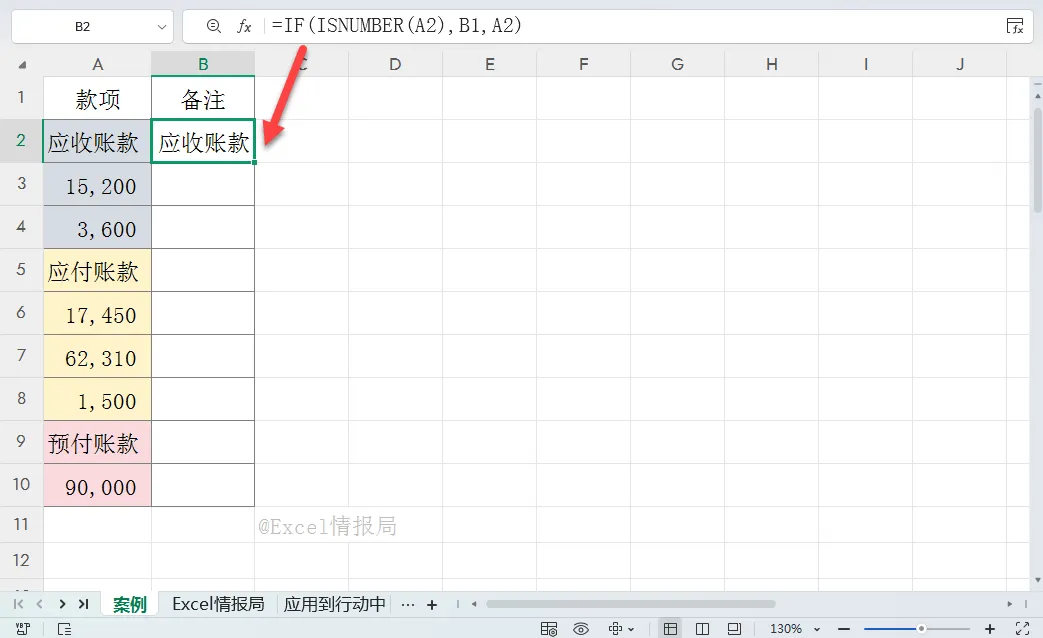
从B3开始,逻辑和解法一完全一样:A3是数字就取上一行B列,A5是文本就取当前行A列。 所以在上面B2输入完公式后,直接向下填充就行了: 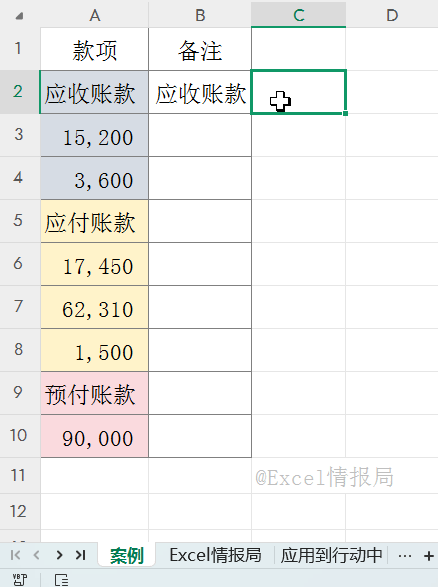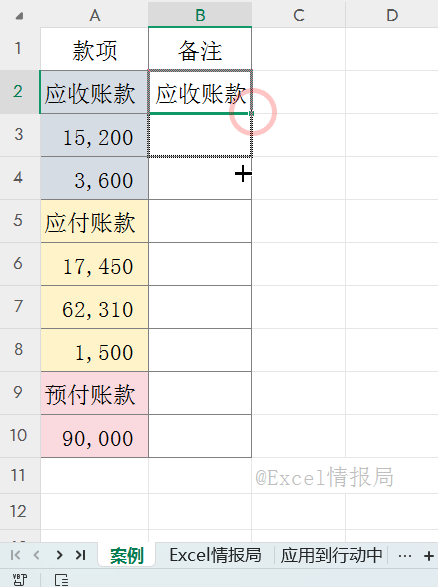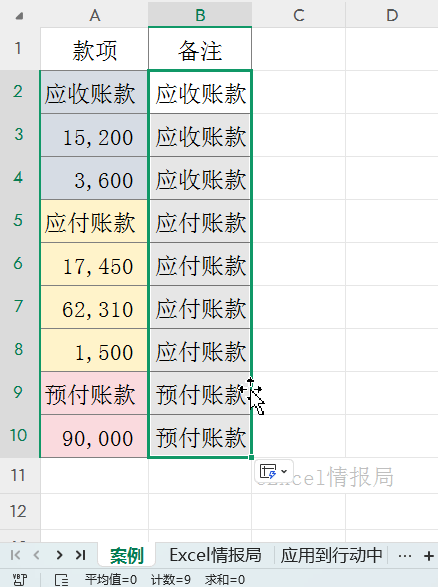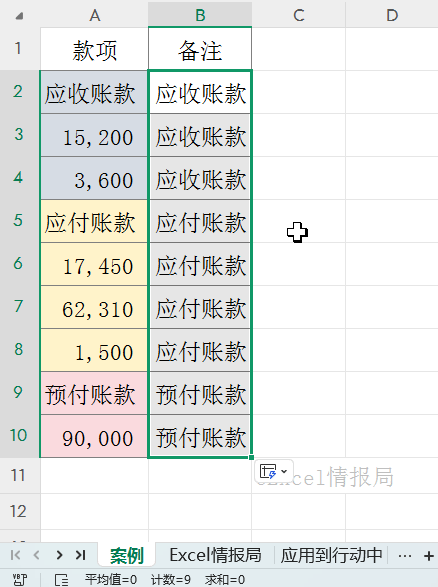
这是一个很聪明的小改进,但骨子里还是那套东西。公式依然在看隔壁单元格,依然要你亲手拖下去,依然依赖行与行之间的物理位置关系。它只是把之前的需要手动输入B2这一固定的会计科目这一步自动化了,并没有改变Excel的计算范式。 但现在已经进入2026年了。 我们只需要在B2输入一个Scan动态数组函数: 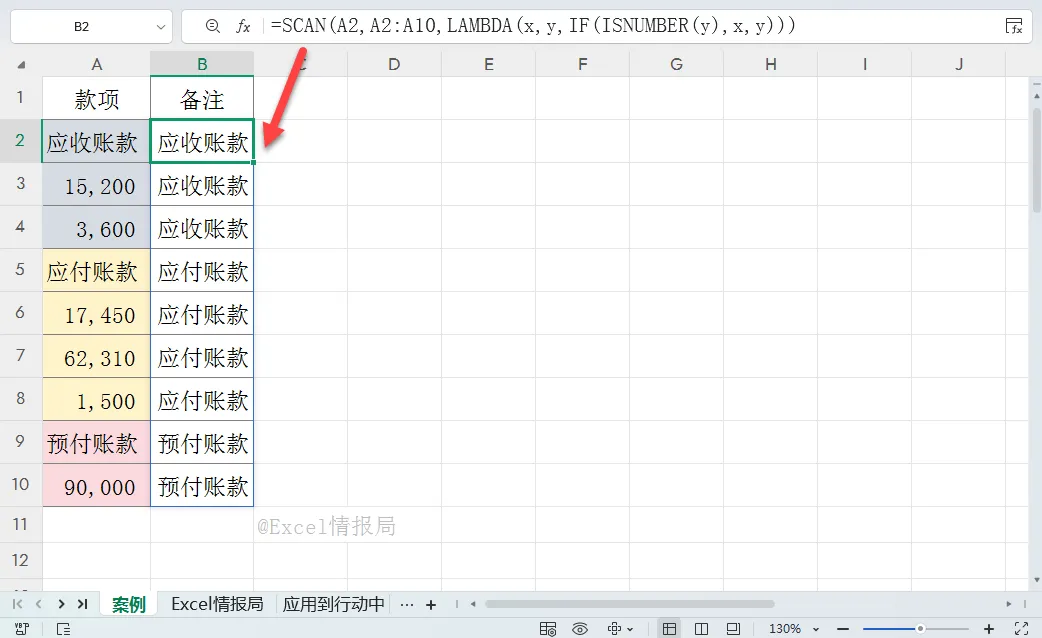
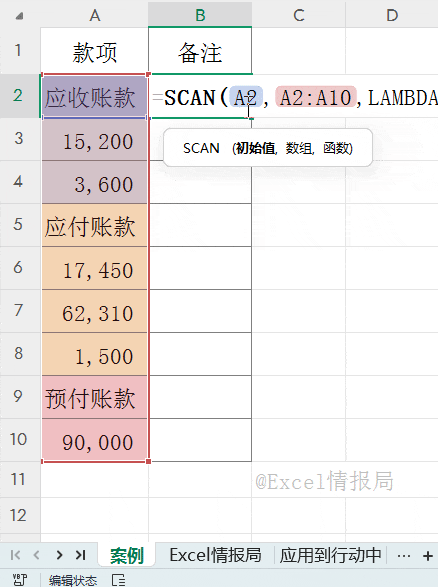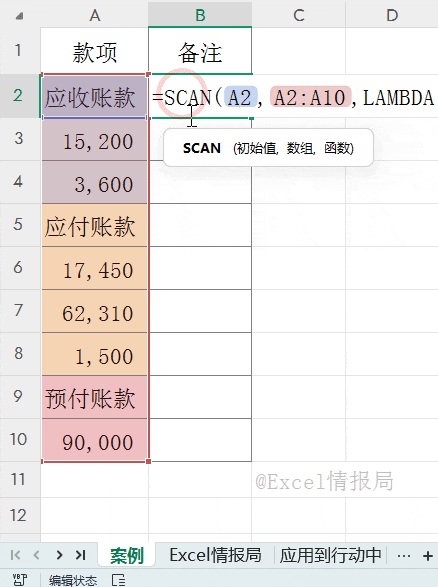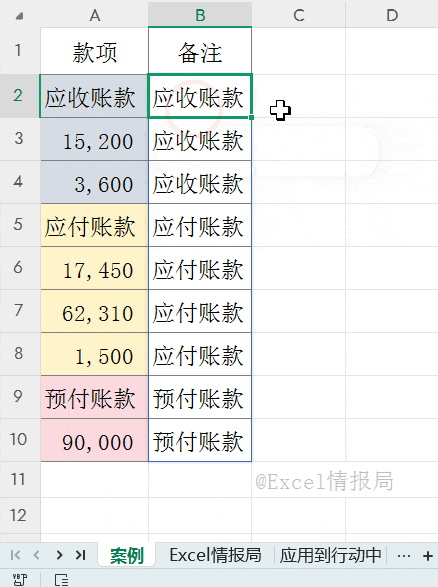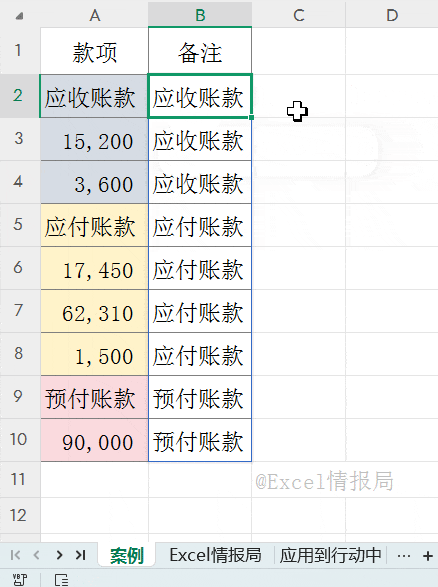
这串公式到底在干什么呢? Scan这个单词英语中是“扫描”的意思。 所以Scan是一个从头扫到尾的函数。它带着一个累积值,依次遍历A2到A10的每一个单元格,每走一步就产出一个结果。 第1个参数A2是初始状态,也就是出发时我身处哪个科目下。 第2个参数A2:A10是要扫的范围。 第3个参数是一个lambda,定义了每遇到一个新值y,我怎么更新我的状态x: y是当前正在看的那个单元格的值。 如果y是数字金额,那就保持当前状态x不变,表明我还在原来这个科目下。 如果y是文本新科目名,那就把状态更新为y,表明我切换到新科目了。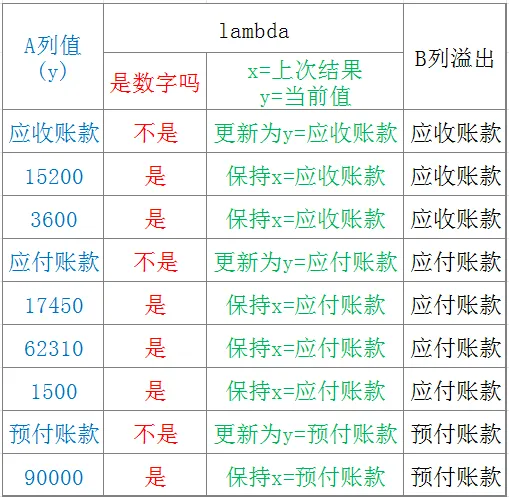
大家看到区别了吗? 老方法里的B2、B3,在Scan里变成了x:一个逻辑上的记忆存储器,即上一次计算结果的累积值。 它不再指着某个物理单元格,它只关心一件事:此刻,我正在哪个科目下? 三种解法,实际是两种主要的思路,代表了两个时代。 把它们并排放在一起看,你会发现这不只是哪个公式更短的问题,而是思考方式的根本不同。 解法一和解法二,本质上都是位置思维,也就是说B3的值由B2决定,B4的值由B3决定。这就像一串多米诺骨牌,公式之间靠相邻的物理关系传递信息。我们必须先在脑子里建立“这一行的结果依赖上一行哪个格子”的空间布局,公式才能写得对。 而Scan是状态思维,也就是说它不关心上一行在哪个物理位置,它只维护一个抽象的状态:我现在在哪个科目下?遇到金额,状态不变;遇到新科目,状态切换。至于这个状态最终要输出到哪一行,由Scan自动对齐第二参数遍历数组的形状,自己决定。 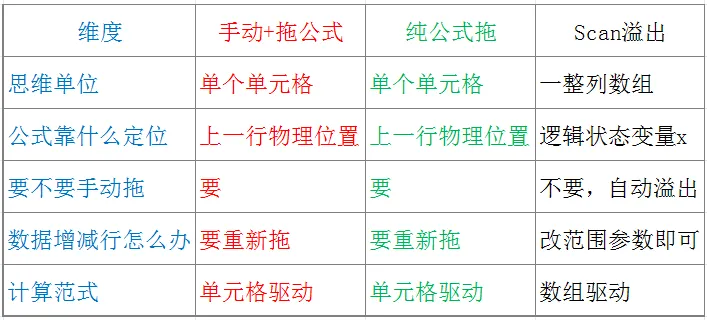
那为什么说这是Excel最重要的一次转变呢? 如果你只用过上古时期的老版本Excel,比如2019年以前的老Excel,可能会觉得不就是多了个函数嘛。但如果你真的在做表格,你会感受到背后那股地震级的变化。 第一,Excel从格子变成了数组。 过去二十年,我们对Excel的心智模型是“单元格的海洋”,即A1是什么,B2是什么,C3是什么。公式在格子之间跳转,像在地图上走路。而大概从2019年开始,Microsoft 365 引入了动态数组,一整套新函数登场:Filter、Sort、Unique、Xlookup、Sequence、Scan、Reduce等等等等。它们的共同特征是:一个公式,吐出一整片结果。我们不再逐格思考,而是整组数据一起思考。 第二,公式从被动填充变成了主动溢出。 老时代做模板,最头疼的就是不知道用户会填多少行。所以你得提前在B列写满5000行公式,哪怕很多行根本没数据。表格又慢又卡,还经常出现空行里残留的0或者错误值。还要继续用Iferror修饰。现在,一个公式写进去,数据有多少行,结果就溢出多少行。数据删了,溢出范围自动收缩;数据加了,自动扩展。这在老时代是不可想象的。 第三,lambda让Excel第一次拥有了编程能力,也就是自定义逻辑的能力。Scan、Reduce、Byrow、Bycol这些函数的第3个参数都是一个lambda,本质上就是一个可以自定义的小函数。你可以把,遇到文本怎么办、遇到数字怎么办,这些个规则,像写代码一样定义进去。这意味着Excel不再只是一个表格软件,它开始具备轻量级的数据处理语言的能力。分组、归类、清洗、累积计算,这些过去要写VBA或者Power Query才能搞定的事,现在一个公式就能表达。 一旦我们习惯了数组思维,再回头看老的单元格公式,会觉得像在老算盘和计算器之间切换。 Scan不是一个需要你死记硬背的函数。 它代表的是一种新的直觉。 Excel是可以“扫描一遍”数据、带着状态往前走的。掌握了这种直觉,后面遇到的Reduce、Byrow、Map,甚至你自己写的自定义Lambda函数,都会顺理成章。 所以下次如果再遇到今天这种“把上面的分类名填充到下面每一行”的需求,别再用单单元格公式填充了。在B2敲下那个Scan,回车,看着结果自动铺开,那一瞬间你感受到的,就是现阶段Excel和上古Excel之间,那种巨大的落差感。 学习Excel/你可以不常用/但不能不会用/如果你没有天赋/那就一直重复/当你快到本能反应的时候/你的重复就是别人眼中的天赋/冲破捆绑/展翅翱翔 
=IF(ISNUMBER(A3),B2,A3)
=IF(ISNUMBER(A2),B1,A2)
B2自己先判断A2:A2是“应收账款”,是文本不是数字,所以IsNumber返回 False,B2直接取A2,也就是“应收账款”。
此时,第一行就不再需要手动输入辅助科目了。
=SCAN(A2,A2:A10,LAMBDA(x,y,IF(ISNUMBER(y),x,y)))
之后回车。
最后我们会看到B2到B10自动铺满了所有结果,不需要拖,不需要填充柄,公式自己溢出到了该去的所有单元格:
(如果您觉得本文对自己有所启发,希望点一个“推荐”鼓励小编;如果您还有其它方面的问题,可后台消息框回复“提问”进行咨询)