ARTICLE · 1132203
HyperExtract:从非结构化文档到多类型知识结构
从文档中抽取知识,核心在于选择合适的结构,而不止于识别实体和关系。不同任务需要不同结构:人物档案适合字段模型,术语汇总适合列表或集合,实体关系适合知识图谱,多实体事件适合超图,带时间和位置的信息则需要时序图、空间图或时空图。
HyperExtract 是一个由 LLM 驱动的开源知识抽取与增量演化框架。它通过统一的 CLI 和 Python SDK,将文档转换为强类型 Knowledge Abstract,内置 8 种知识结构、10 多种抽取引擎和 80 多个领域模板,并提供可视化、语义检索、问答、Obsidian 导出、MCP 服务和本地模型支持。项目曾进入 GitHub Trending,并持续围绕结构化知识抽取场景更新。
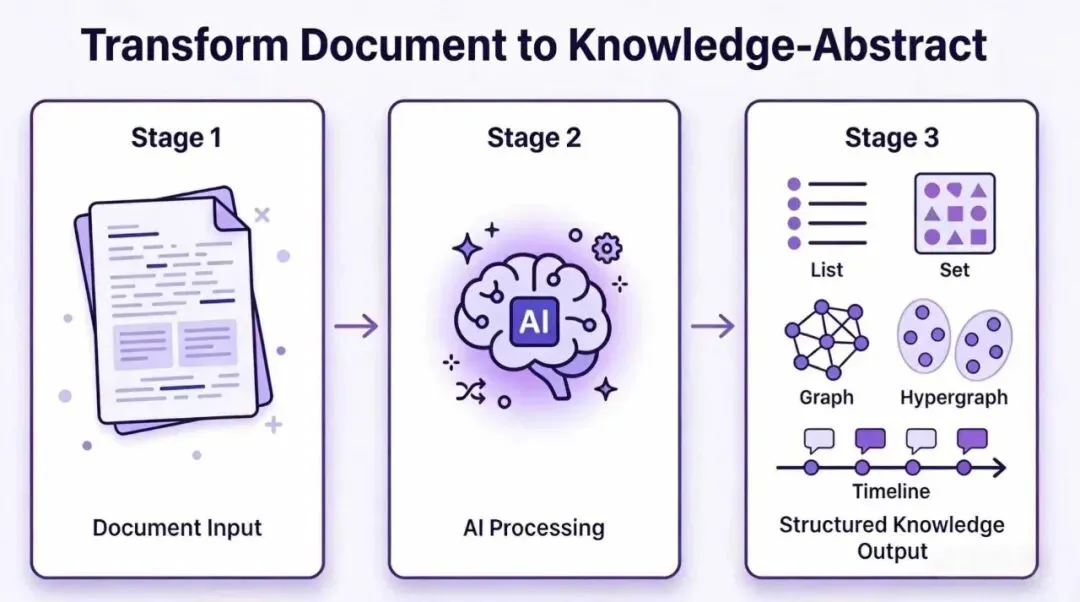
图 1:HyperExtract 将文档转换为多种知识结构
项目地址:https://github.com/yifanfeng97/hyper-extract
在线文档:https://yifanfeng97.github.io/Hyper-Extract/latest/
LLM 让知识抽取的入口变得简单:给定文档和提示词,模型可以返回 JSON、实体列表或关系三元组。但当任务进入批量处理,几个问题会很快出现。
首先,输出格式不稳定。同一提示词在不同文档上可能返回不同字段,模型生成的 JSON 也可能不符合下游代码要求。其次,知识结构并不统一。把所有任务都压成“实体-关系-实体”会限制多实体关系、时间属性和空间属性的表达。再次,文档库会持续更新,如果每次新增资料都重新处理全部语料,成本和一致性都难以控制。
HyperExtract 把这些问题拆成三个独立层面:输出使用什么数据结构,由 Auto-Type 决定;采用什么抽取算法,由 Method 决定;面向什么领域和任务,由 Template 决定。三者解耦后,同一个文档可以按不同目标生成不同知识抽象。
设输入文档为 ,目标知识结构类型为 ,抽取方法为 ,领域模板为 。HyperExtract 的过程可以抽象为:
其中 是具有固定字段、节点类型或关系约束的 Knowledge Abstract。模板提供领域定义和抽取规则,方法负责调用 LLM、RAG 或图构建流程,Auto-Type 则校验最终结构。
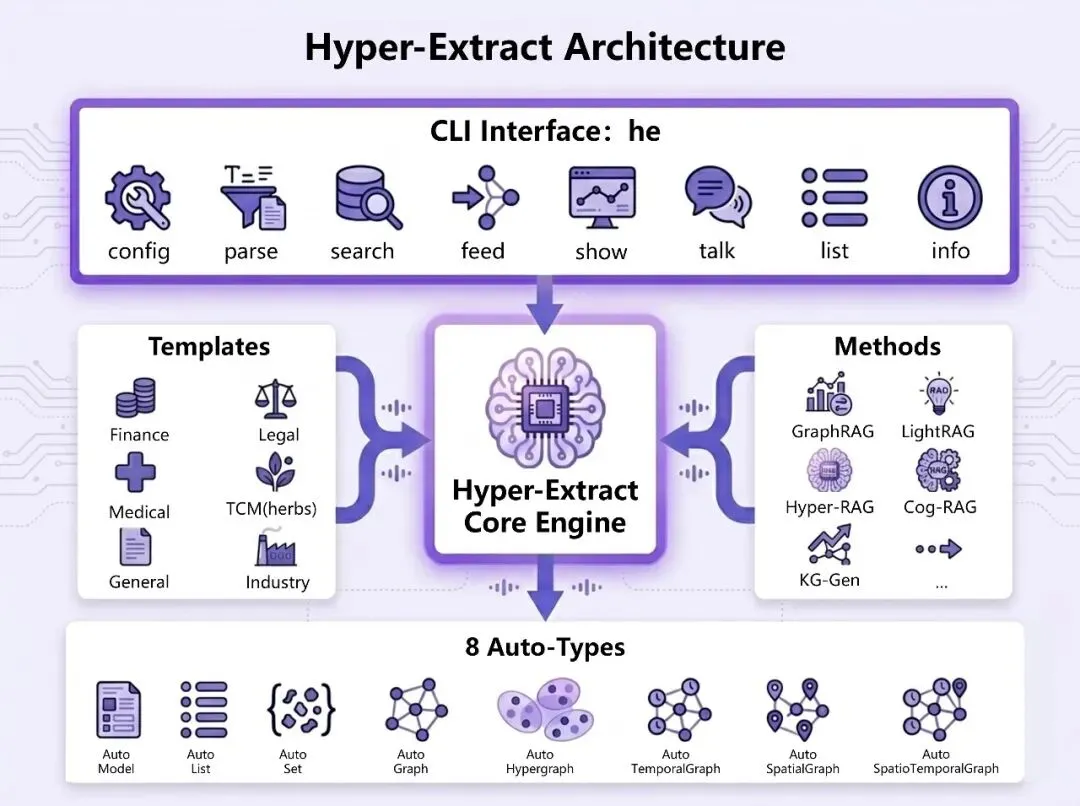
图 2:HyperExtract 的三层系统架构
官方文档将架构概括为三层:底层输出是强类型知识结构;中间层由 Auto-Type 统一表示;上层的模板和方法决定抽取内容及实现方式。用户可以直接选模板,也可以只选方法,或者使用 Python SDK 自定义完整流程。
HyperExtract 提供 8 类 Auto-Type:
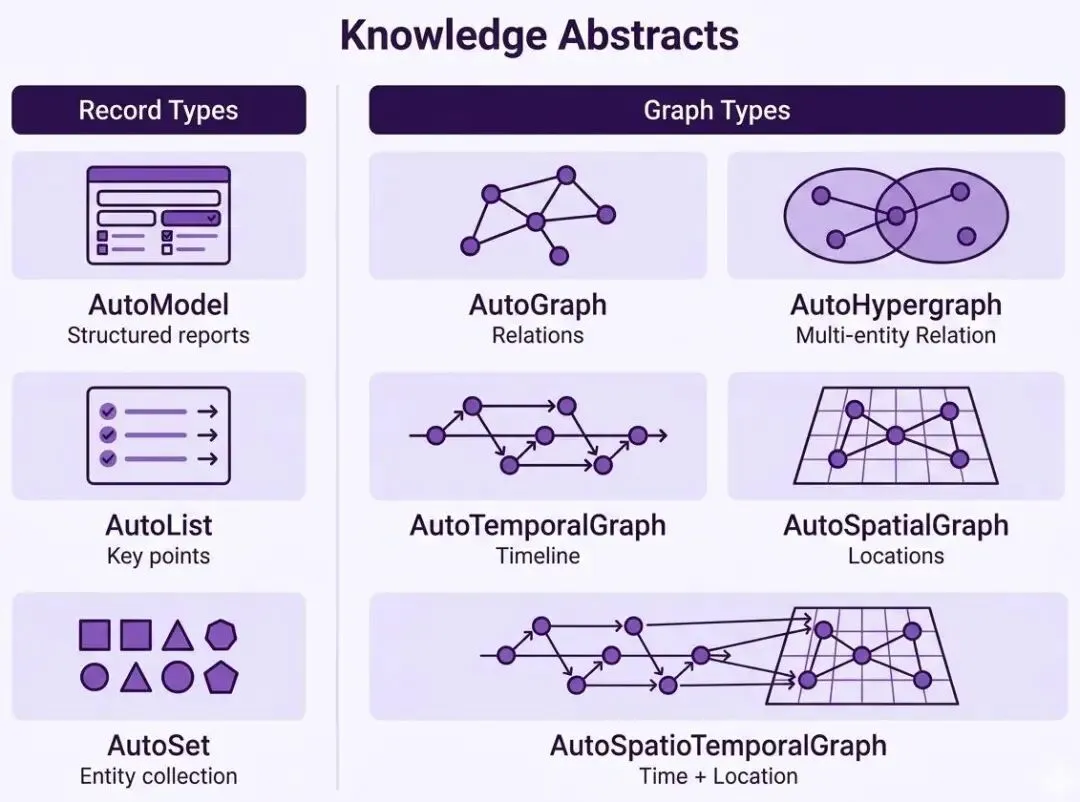
图 3:官方文档中的 8 种 Auto-Type 知识结构
这套类型系统解决的是“输出应该长什么样”。例如,合同中的甲乙双方关系可以使用普通图,一场多方会议及其共同决议更适合超图,设备故障的地点和发生时间则可以交给时空图。
项目内置 GraphRAG、LightRAG、Hyper-RAG、KG-Gen、iText2KG 等 10 多种抽取引擎。方法层统一处理分块、提示、合并、去重和结构写入,使用户可以在同一输出类型下替换不同引擎。
模板层覆盖学术、金融、法律、医疗、中医、工业和通用场景,共 80 多个 YAML 模板。模板中定义目标类型、字段说明、抽取要求和默认方法。对于已有明确 schema 的任务,可以从模板开始;对于研究性任务,则可以直接定义新的 Auto-Type 或方法。
CLI 的基本流程包含安装、配置、抽取和查看:
uv tool install hyperextract he config init -p bailian -k YOUR_API_KEY he parse tesla.md -t general/biography_graph -o ./output/ -l en he show ./output/第一条命令安装工具,第二条配置模型提供方,第三条按模板解析文档,第四条启动知识结构可视化。对于已有 Python 应用,也可以通过 SDK 调用:
from hyperextract import Template ka = Template.create("general/biography_graph", "en") result = ka.parse(open("tesla.md", encoding="utf-8").read()) result.show()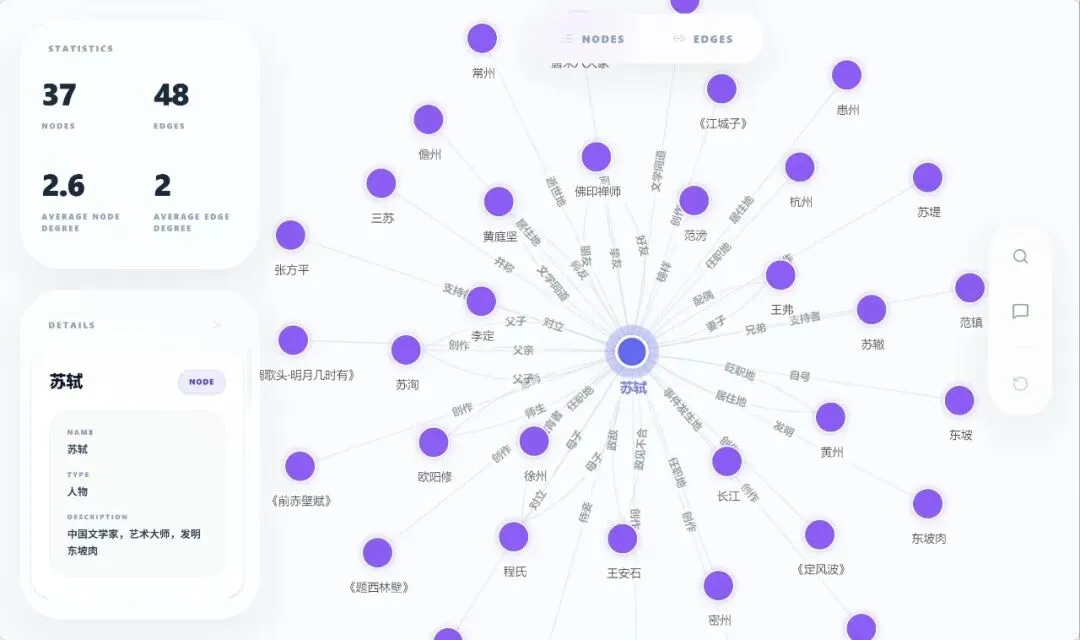
图 4:HyperExtract 的图结构可视化界面
框架还提供 he feed 增量写入、he build-index 构建语义索引、he search 检索、he talk 问答、he export obsidian 导出笔记库以及 he-mcp MCP 服务。因而它既可以作为一次性抽取 CLI,也可以作为持续更新的知识库组件。
结构选择应由任务决定。只需要摘要字段时,AutoModel 比知识图谱更容易校验;抽取术语清单时,AutoSet 能直接去重;当下游任务需要实体之间的关系传播时,图结构才有必要。
普通图与超图的选择取决于关系是否具有不可拆分的群组语义。若一句话表达“公司 A 收购公司 B”,二元边已经足够;若一项临床试验同时涉及药物、患者组、剂量和不良反应,将关系拆成多条边可能丢失它们属于同一试验记录的事实,此时 AutoHypergraph 更合适。
时间和空间同样不应被简单塞进文本描述。政策版本、设备故障和病例进展需要显式时间轴,地理事件和设施信息需要空间字段;当二者同时影响推理时,再使用 AutoSpatioTemporalGraph。逐级选择可以减少无效节点、关系和后续维护成本。
知识库更新可以表示为:
新增文档 只需抽取增量内容,再与已有 Knowledge Abstract 合并。合并过程中需要处理实体对齐、重复关系和字段冲突。相比每次重建全部知识库,增量模式更适合报告、法规、病例或工业日志等持续增长的数据。
HyperExtract 支持 OpenAI 兼容接口,可以连接云端模型,也可以对接本地 vLLM 服务。对法律、医疗和企业内部资料,本地部署能够减少文档外发,但仍需自行评估模型能力、显存占用、日志留存和访问权限。
Obsidian 导出会把图中的实体生成 Markdown 笔记,并使用 [[wikilinks]] 建立链接。它适合人工复核和知识整理,但导出的链接网络仍然依赖抽取质量,不能替代事实核验。
知识抽取项目常把提示词、JSON 解析、图数据库写入和可视化分别实现。HyperExtract 的主要作用是把这些步骤放进统一接口,让“文档输入、结构定义、抽取方法、结果校验和增量更新”形成完整流程。
其中,Auto-Type 约束输出,模板降低领域配置成本,方法注册机制允许替换抽取引擎。对于研究人员,这便于比较 GraphRAG、Hyper-RAG 等方法;对于工程场景,则能减少围绕不同输出结构重复开发数据管线。
HyperExtract 能把文档处理、结构定义和结果写入串成一条完整流程,但抽取结果仍然需要回到原文核验。LLM 可能漏掉实体、误合并关系,也可能把语义相近但来源不同的事实放到同一个结构里。模板越细、关系阶数越高,越需要把结构化结果和证据片段一起保存。
实际使用时建议保留四类记录:原始文档片段、抽取模型与版本、模板版本、结构合并日志。对超图和时空图,还要额外检查超边规模、重复关系、时间格式和空间坐标是否一致。这样后续做检索、问答或人工复核时,才能顺着结构回到原始材料。
HyperExtract 将知识抽取从单次提示词调用扩展为结构化工程流程。它把列表、集合、模型、普通图、超图、时序图、空间图和时空图放进统一类型系统,并通过模板和方法连接不同领域与抽取引擎。
这种设计适合需要批量文档处理、结构校验、增量更新和多种知识表示的场景。其效果最终仍取决于模型、模板、数据质量和评估机制,但作为开源工具,它提供了一套可以直接运行、扩展和审查的知识抽取基础设施。