ARTICLE · 1134117
不只是跟文档聊天!腾讯超3万Star让资料自己长成Wiki
↑ 点击上方名片关注,看 AI 与开源好工具
把一份几十页的规章资料交给 AI,如果它吐出来的只是对话框里的一段零散回复,你还是得自己手动复制、整理、排版。但在腾讯开源的知识管理框架 WeKnora(维娜拉) 里,事情变成了另一种玩法:
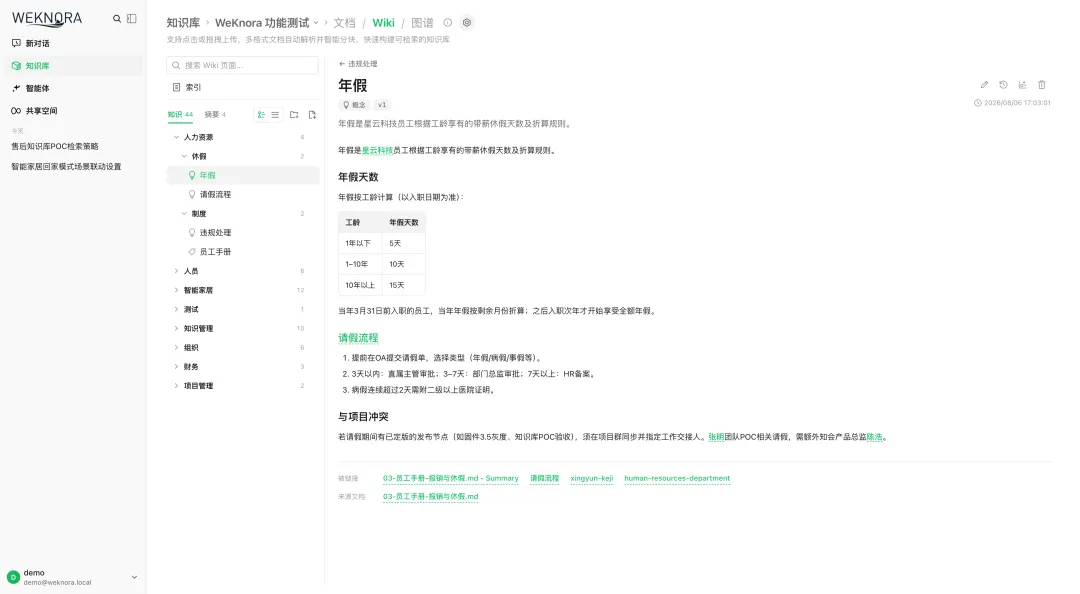
在这张官方演示的 Wiki 页面中,系统基于导入的规章文档,直接整理出了一份结构规整的网页文档。左侧带有层级分明的大纲导航,正文清晰拆解了年假核算标准与申请规则,底部还标明了关联文档与出处引用。
在 GitHub 上收获超 3 万 Star 的 WeKnora,最大的突破正是跳出了“只能在输入框里你问我答”的局限。它不仅能做检索问答,更能把团队或个人手里零散散落的资料,自动重组为条理清晰的 Wiki 知识库与交互图谱。
资料不再是孤岛:自动重组知识与可视化图谱
平时搭建知识库,最麻烦的往往是文档格式五花八门。WeKnora 提供了统一的文档管理后台:
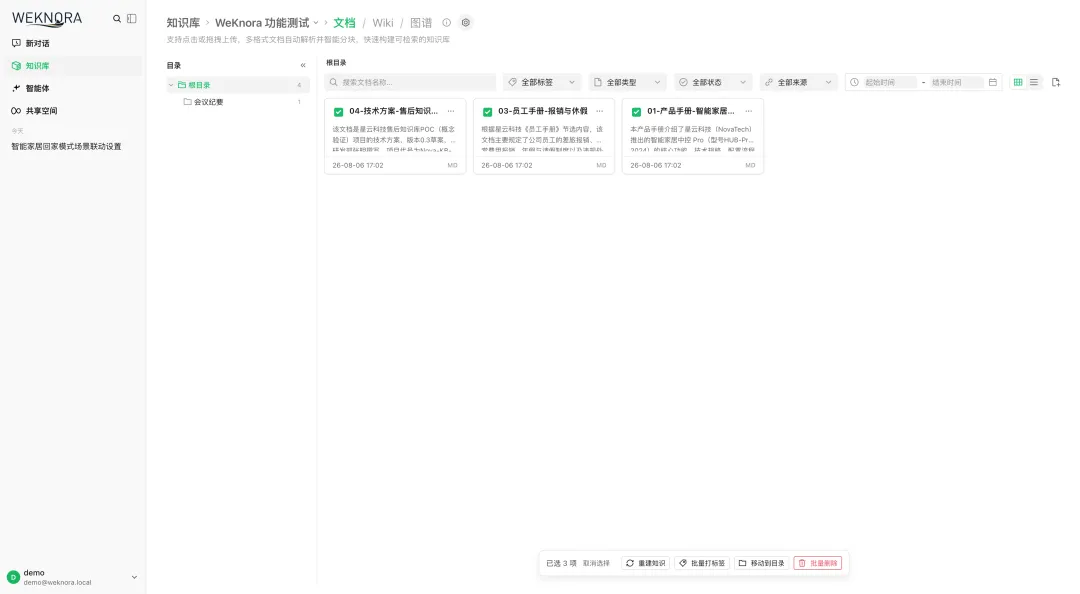
文档管理中心支持建立树状目录与标签分类,除了本地上传,还支持对接飞书、Confluence、GitLab 等外部数据源。针对常见的 Office 文档(如 Word、Excel),项目内置了由 Go 语言编写的 anydoc 解析引擎,在进程内即可完成基础文本与表格的高效抽取,减少了对额外繁重解析工具的依赖。
在文档完成解析与切片后,WeKnora 能够从文档中提取概念与来源,将分散的信息聚合成主题 Wiki 页面。更进一步,系统还能将跨文档的实体关系可视化:
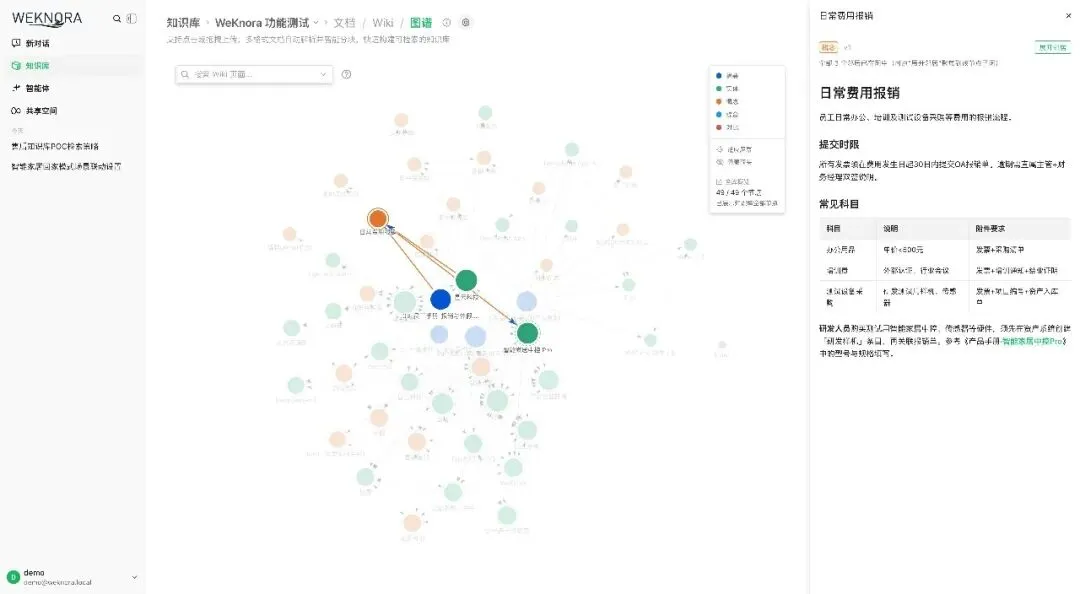
在知识图谱界面中,诸如报销标准、差旅规范、审批流等交织在一起的概念,被绘制成一张可交互的节点网络。选中图谱节点,右侧即可阅读对应条目。对于需要理清繁杂业务脉络的团队来说,这种自动编织的关联网络让静态资料真正具备了结构化沉淀的价值。
问答附带出处:便于核对原文,降低幻觉困扰
当然,作为知识库的基础功底,智能检索与问答依然至关重要。很多人对大模型读文档最大的顾虑,就是担心模型在长文本里“幻觉瞎编”。
WeKnora 在问答界面中强化了原文引用的可核验性:
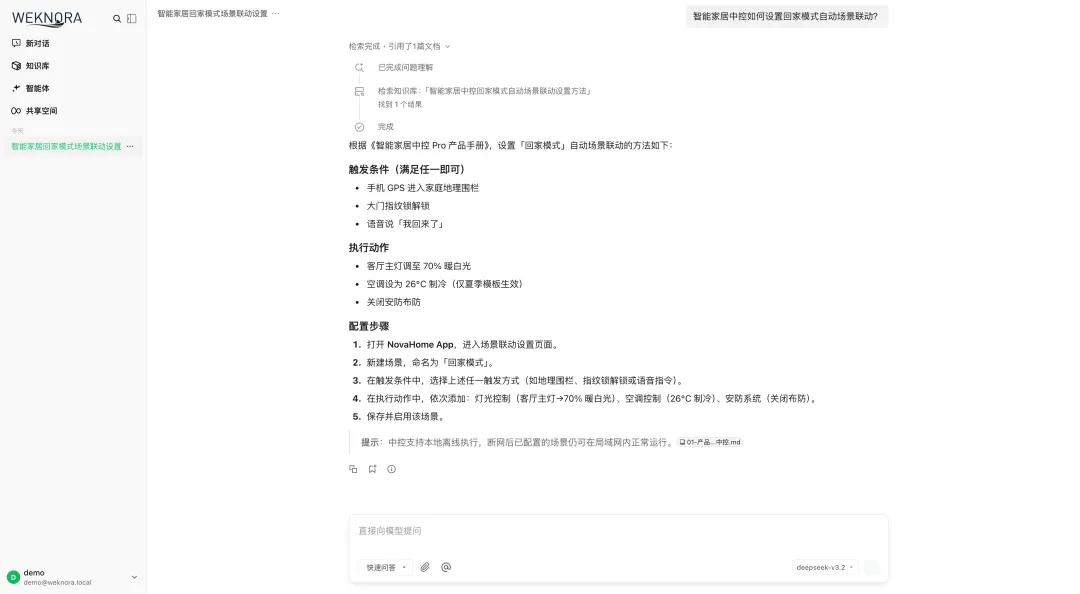
在这张以智能家居设备配置为例的交互中,用户询问具体的场景规则,系统在梳理步骤的同时,右下角附上了明确的产品手册引用标签。点击即可调出原始段落对照。
需要说明的是,混合检索(全文搜索与语义向量结合)能大幅提升找到关键上下文的概率,附带出处也让人工核实变得十分便捷,但这并不代表大模型生成的每一句总结都绝对零误差。将答案与原始文档对照确认,依然是严肃业务场景下的良好习惯。
智能体协作与数据链路:算力与隐私如何平衡?
除了资料管理与问答,WeKnora 还进一步集成了智能体(Agent)能力。
它支持在独立的容器沙箱中执行多步推理任务,并且能够通过标准的 MCP 协议将内部脚本或外部工具开放给智能体调用。问答组件还可以作为小挂件嵌入团队网站,或接入企业微信、飞书、Slack 等办公即时通讯工具中。
在很多团队关心的隐私与部署方面,实际数据的流向取决于你的架构选择:若接入外部云端模型,检索召回的文档切片会发送给对应服务商;若选择全本地部署,需同时配置好本地解析与模型链路,硬件要求取决于所选模型的具体规模,并不强制绑定独立 GPU。
完整的本地部署与启用路径
如果你希望在本地或私有服务器上跑起这套系统,官方提供了标准的 Docker 容器化流程:
第一步:环境拉取与配置。通过 Git 克隆官方仓库,在配置文件中完成模型接入与解析服务配置,随后执行:
docker compose pull docker compose up -d 启动核心容器服务后,在浏览器打开 http://localhost 即可进入系统。
第二步:文档导入与解析。进入管理后台建立知识空间,导入 PDF、Markdown 或 Office 资料,系统会自动调用 anydoc 等解析器切分文本块。
第三步:启用并浏览 Wiki。资料解析完成后,即可在知识库中启用 Wiki 功能,系统会提炼生成条理清晰的主题页面与概念网络,并能在页面中逐项检查内容出处与关联来源。
从被动的一问一答,走向结构清晰的自动化 Wiki 与概念网络,WeKnora 为开源知识库提供了一种不仅能查、更善于系统梳理的新可能。
项目地址:https://github.com/Tencent/WeKnora
觉得内容有用就点个关注,带你看实用的AI与开源项目,把具体用途和上手方法讲清楚。