ARTICLE · 1137137
脸谱|国产AI突破算力瓶颈的关键路径:小两个数量级,最适合AI的架构来了
大部分人还在靠堆参数换效果,但HBM的紧缺已经成了最贵、也最买不到的那一环。在统一的视频生成评测条件下,参数不变、只把计算量翻 4 倍投在隐状态循环上,脸谱的94M的Loop视频类世界生成式模型有7项指标反超5B的BWM,这代表着同一台8卡H100服务器,并发路数从57路提升到至少336路。可能是解决国产算力瓶颈的关键技术。
⚠️ 本文指标数值为本地统一管线实测。
01 HBM 正在成为最贵的那一环
算力可以排队等,HBM 等不到。在这样一个年份,模型的评价标准必须多一条,不是"谁更强",而是"每 GB HBM 能换来多少效果"。
就在上个月,这条路被端到了最前面。
9月,The Information 报道称 OpenAI 即将发布的模型 Astra 使用了一项叫「循环深度」(recurrent depth)的技术—— looped transformer(循环 Transformer):不是增加参数,而是把同一段层堆栈重复跑多次,用循环把网络"展开"到更深的等效深度。
同月,OpenAI 正式发布GPT-6 Astra,官方口径是"全球最智能、最对齐的模型",在计算机操作、编程、网络安全、科学研究上全面刷新纪录;在 OSWorld 2.0 的延迟模拟中,它用约 47% 更少的时间完成比上一代更强的计算机操作表现。
这套机制的原理,一句话能说清
重复使用层堆栈,而不是复制权重。效果上相当于把网络加深,但存储和内存占用不变,增加的是计算量。
03 脸谱心智Loop模型对比口径
讨论生成式模型时,大家习惯比"谁更强"。但真到部署环节,先卡住你的通常不是算力,是显存:
在HBM 缺口50%–60%的年份,这个差别不再只是工程细节,而是能不能把服务开起来的差别。
05 我们的做法:参数不变,把计算量花在循环上
设了两组对照,把"参数量"和"计算量"两个变量拆开(本文的拆解当中采用固定循环次数,不让模型自主决定循环次数):
取舍方向:我们加的是计算量,加的不是参数量。参数不变意味着权重 HBM 占用不变,多出来的开销只落在计算上,而计算可以排队,HBM 买不到。且一般来讲,循环模型即使循环的更少,仍然有效。
06 Loop结构正在替换传统的AI架构
6.1 效果侧:16 项指标,7 项反超
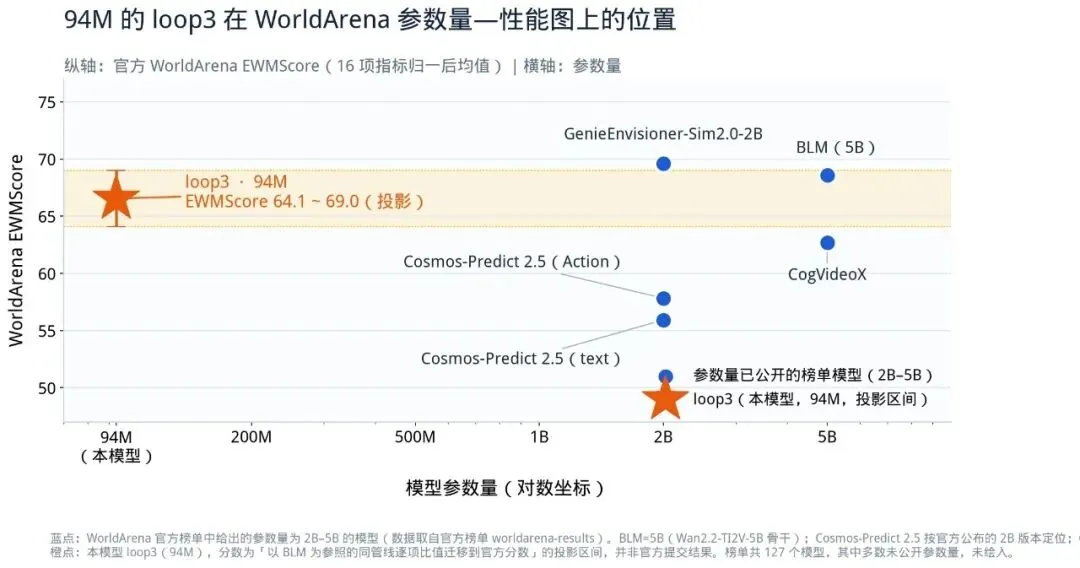
Loop3又小又好,甚至超越或接近榜单中比Loop3大50倍左右的模型。并且,Loop3不仅节省内存,在计算上也显著节省。
6.2 显存侧:权重(确定性计算,无假设)
权重显存 = 参数量 × 精度字节数,fp16 即 ×2:
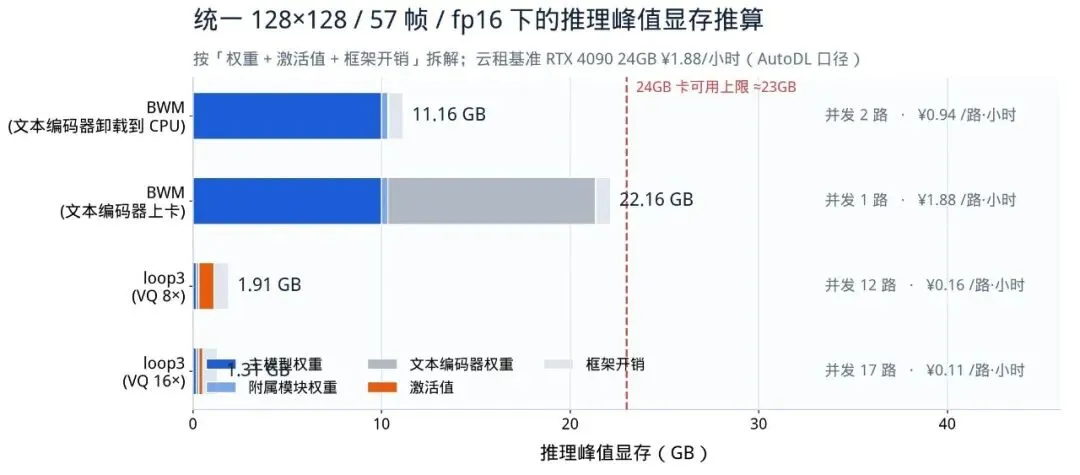
未来优化方向:Wan2.2 那个 VAE 压缩得太狠(16×16×4),而我们的 VQ tokenizer 只压 8×、且不做时间压缩。直接指向下一步的优化方向。
07 Loop架构正在解决国产AI算力瓶颈
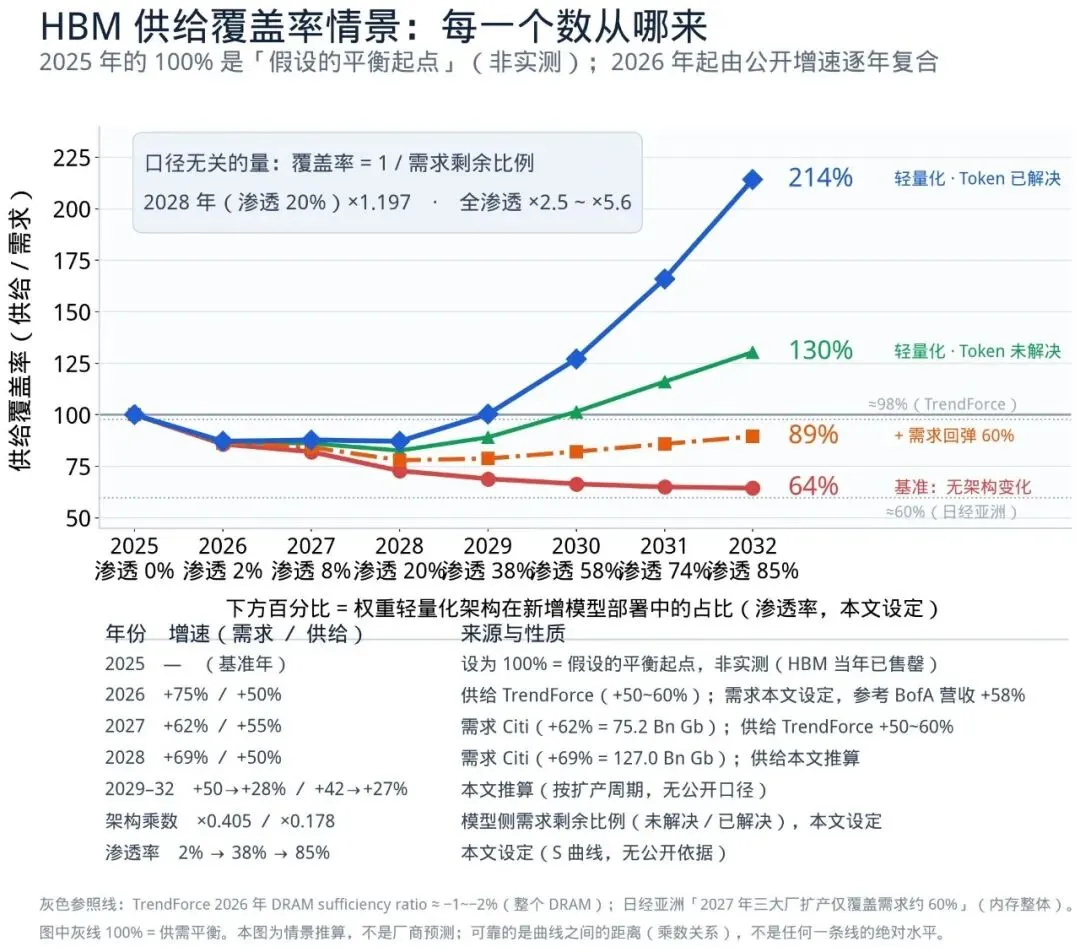
如图例,根据公网信息估算,当使用脸谱Loop3类型架构,HBM的内存供需会随渗透率逐渐迫近并且超越100%。且如果Loop3架构渗透率更快,将更快超越100%,预计27年即可全面覆盖内存需求。权重轻量化对国产链的相对价值更大,可能是解决国产算力瓶颈的关键技术。
附 A:完整指标数值
Available on Request
附 B:引用目录文章
HBM 供需与价格
〈全球抢"芯" 产业链"涨"声不断〉— 21世纪经济报道 〈"存储三巨头"2027 产能已售罄?消息人士:一些 AI 公司已在"跪…〉— 财联社 〈报道:存储三大原厂"2027 年产能已提前售罄"〉— 华尔街见闻
GPT-6 Astra 与循环深度(Looped Transformer)
〈GPT-6 Astra: A new generation of intelligence〉— OpenAI 官方 〈OpenAI Technique in 'Astra' Model Sparks Security Concerns〉— The Information 〈OpenAI Astra and Looped Transformers〉— Sebastian Raschka
对照模型与硬件口径
〈万相|领先的 AI 视频与图像生成模型〉(Wan2.2 开源说明,含 16×16×4 压缩比)— 阿里云万相 〈通义万相 2.2 开源!可一键生成电影感视频〉(22GB 显存口径)— 知乎 〈AutoDL 算力云|GPU 算力零售价格〉(¥1.88/小时 RTX 4090 口径)— AutoDL
评测基准与对照模型出处
〈WorldArena: A Unified Benchmark for Evaluating Perception and Functionality of Embodied World Models〉— arXiv:2602.08971 WorldArena 官方榜单与评分数据 — WorldArena 团队 〈BWM: A Low-Cost High-Fidelity World Simulator for Robot Learning〉(本文对照模型 BWM 的来源)— arXiv:2607.29302
说明:文中 16 项指标的评测口径与 BWM 的模型信息分别来自第 13–15 条。本文所有指标数值为本地统一管线(128×128 / 57 帧)下的测量值,与上述榜单在 480×640 协议下公布的分数不可直接比较。