ARTICLE · 1143081
Fast-dLLM关键技术总结文档
Fast-dLLM关键技术总结文档扩散语言模型(Diffusion LLMs)因其非自回归生成特性与双向注意力机制,在理论上具备并行生成多个token的潜力,有望显著提升推理速度。然而,当前开源的扩散语言模型在实际部署中仍面临两大瓶颈:一是缺乏对Key-Value(KV)缓存的支持,导致每一步均需重复计算全部注意力状态;二是并行解码时因条件独立假设破坏了token间的依赖关系,引发生成质量下降。为弥合与自回归模型之间的性能差距,Fast-dLLM被提出,旨在实现无需训练即可加速扩散LLM推理过程的目标。该方法通过引入块状近似KV缓存机制与置信度感知并行解码策略,有效解决了上述挑战。 传统自回归模型利用KV Cache存储历史token的注意力键值对,避免重复计算,从而大幅提升推理效率。然而,由于扩散语言模型采用全注意力结构,每一步都需重新处理整个序列,标准KV Cache无法直接应用。为此,Fast-dLLM提出了适用于双向注意力机制的块状近似KV缓存机制,其核心思想是将输出序列划分为若干固定大小的块,并在块级别上复用KV状态。 具体而言,在生成某一目标块之前,系统首先计算并缓存所有已知部分(包括提示词前缀和后续被掩码的后缀)的KV状态。在该块的多步去噪过程中,这些缓存的KV状态被反复使用,仅动态更新当前正在生成的块内token的表示。当一个块完成生成后,再统一更新整个序列的KV缓存,以确保信息一致性。这一流程使得尽管模型整体仍保持全注意力能力,但在局部生成阶段实现了高效的计算复用。 为进一步提升缓存效率,Fast-dLLM设计了DualCache变体,即同时缓存前缀与后缀token的KV状态。尽管后缀token在初始阶段均为[MASK],但实验证明其对应的KV激活值在相邻推理步骤间表现出高度稳定性。如Figure 3所示,红框区域分别展示了前缀(图a)与后缀(图b)KV激活值在连续步骤中的相似性,数值接近1,表明其变化极小,因此可安全地进行跨步复用。 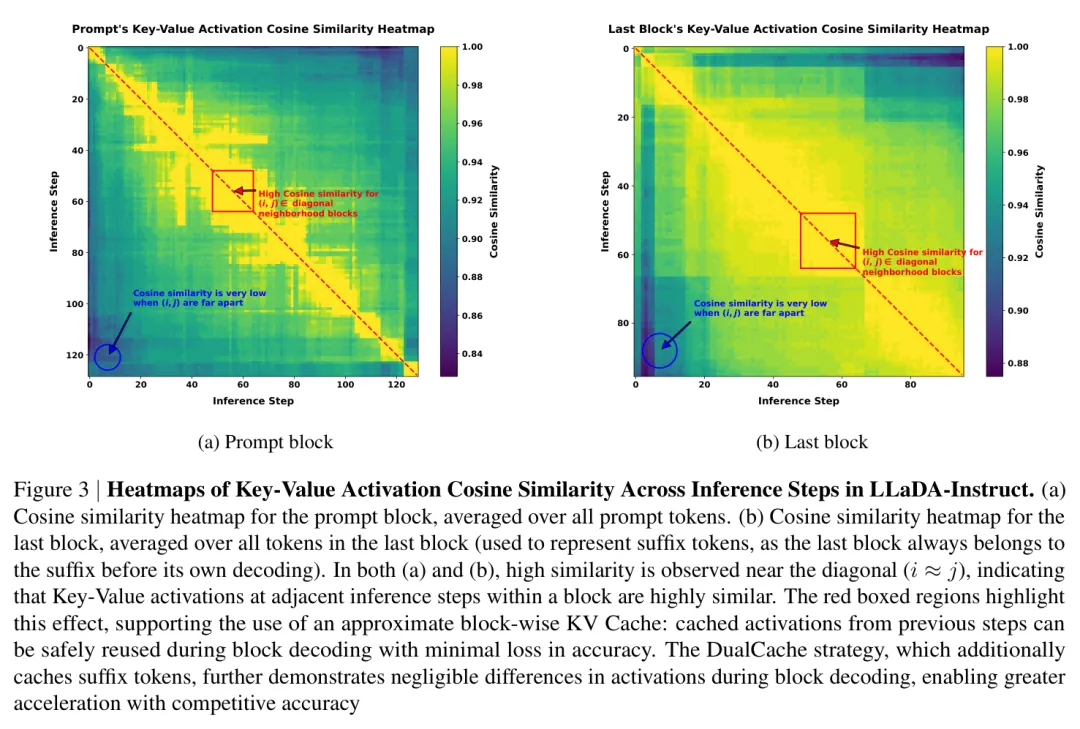
原论文图 3(截自原 PDF) 该机制的有效性被多项实验所验证。Table 3与Table 4显示,在不同shot设置及生成长度下,DualCache相较于基础模型实现了显著加速。例如,在8-shot设置、生成长度为1024时,端到端吞吐量最高达到27.6×的提升,远超仅缓存前缀的PrefixCache版本(18.6×)。更重要的是,这种加速并未以牺牲准确性为代价。Table 5与Table 6的定性分析表明,无论采用何种缓存策略或块大小(8/16/32),模型均能正确完成算术推理任务,回答逻辑清晰且语义一致,说明缓存机制未损害生成内容的保真度与可解释性。 综上所述,块状KV缓存机制成功克服了扩散模型无法使用KV Cache的技术障碍,通过近似但高效的缓存复用策略,在几乎不损失准确率的前提下实现了数量级的推理加速。 尽管“跳跃”式并行解码能够一次性恢复多个被掩码token,加快生成进程,但其基于条件独立假设的采样方式忽略了token间的语义依赖,容易产生不合理组合,如论文中提到的“high house”错误示例。此类质量问题严重制约了并行化带来的实际收益。 为解决此问题,Fast-dLLM提出了置信度感知并行解码策略。该方法摒弃了固定数量解码(如Top-K)的做法,转而根据每个token的预测置信度动态决定是否在当前步骤中解码。具体而言,系统在每一步计算各masked token的最大softmax概率作为置信度分数,仅当该分数超过预设全局阈值时,才允许其被解码。若无任何token满足条件,则强制解码置信度最高的那个token,以保证生成进程持续推进。 该策略的理论基础由Theorem 1提供支持。该定理证明:若存在一个真实最优序列𝑎***,其中每个token的边际预测概率均大于1−𝜖,且满足(𝑛+1)𝜖 ≤ 1的约束条件,则贪婪并行解码(最大化边际分布乘积)与贪婪串行解码(最大化联合分布)的结果完全等价。这表明在高置信度区域,忽略依赖关系所带来的误差是可控甚至可消除的。此外,定理还给出了两种分布之间Total Variation Distance与KL散度的上界,进一步量化了独立假设的风险边界。 实验结果验证了该策略的有效性。Figure 5对比了动态阈值方法与固定token-per-step基线的表现,结果显示前者在相同函数求值次数(NFE)下能达到更高准确率,或在相同准确率下实现更高吞吐量,体现了其在效率与质量间的优越权衡能力。Table 7进一步探讨了不同阈值(0.7~0.9)的影响,发现随着阈值提高,NFE从9增至20,反映出更高的计算成本,但生成答案的正确性与解释完整性保持稳定,说明阈值调节主要影响计算开销而非最终输出质量。 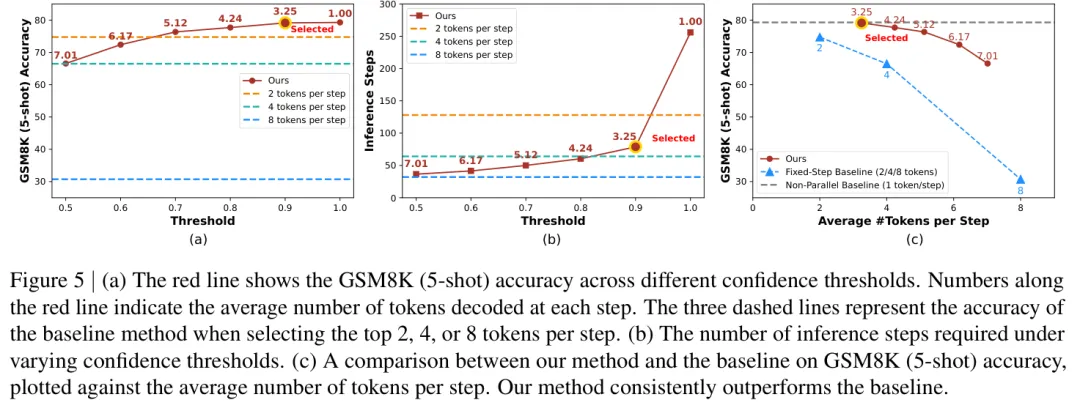
原论文图 5(截自原 PDF) 因此,置信度感知机制通过智能筛选高可信token进行并行更新,有效规避了低置信预测引发的依赖冲突,在保障生成质量的同时充分释放了并行潜力。 Fast-dLLM在LLaDA-Instruct与Dream-Base两类主流扩散语言模型上进行了全面评估,涵盖GSM8K、MATH、HumanEval、MBPP四个典型基准任务。实验数据汇总于Table 1与Table 2,揭示了其卓越的加速效果与稳健的性能表现。 关键发现如下:单独启用KV Cache即可带来2.5×至3.6×的吞吐量提升;引入并行解码后,加速比进一步扩大至4×–6×;而当两项技术结合时,端到端加速效果达到峰值——在LLaDA上最高实现24.1×加速(GSM8K, len=512),在Dream-Base上也达到了7.8×加速(MBPP, len=512)。值得注意的是,如此巨大的速度增益伴随着极小的精度波动,绝大多数配置下的准确率变化控制在±2个百分点以内,部分场景甚至略有提升,充分证明了方法的鲁棒性与实用性。 两种技术展现出明显的互补效应。KV Cache减少了注意力计算冗余,而置信度感知并行解码提升了每步的信息增益,二者协同作用显著放大了整体收益。此外,方法具有良好的可扩展性。如Table 4所示,随着生成长度从256增至1024,加速比持续上升,尤其在长序列任务中优势更为突出,表明其特别适用于代码生成、复杂推理等需要长输出的应用场景。 超参数分析进一步揭示了优化路径。Figure 4表明,缓存块大小对性能有显著影响:过小的块导致频繁更新开销,过大的块则可能引入上下文错配。实验发现块大小为32时在吞吐量与准确率之间达到最佳平衡,成为推荐配置。 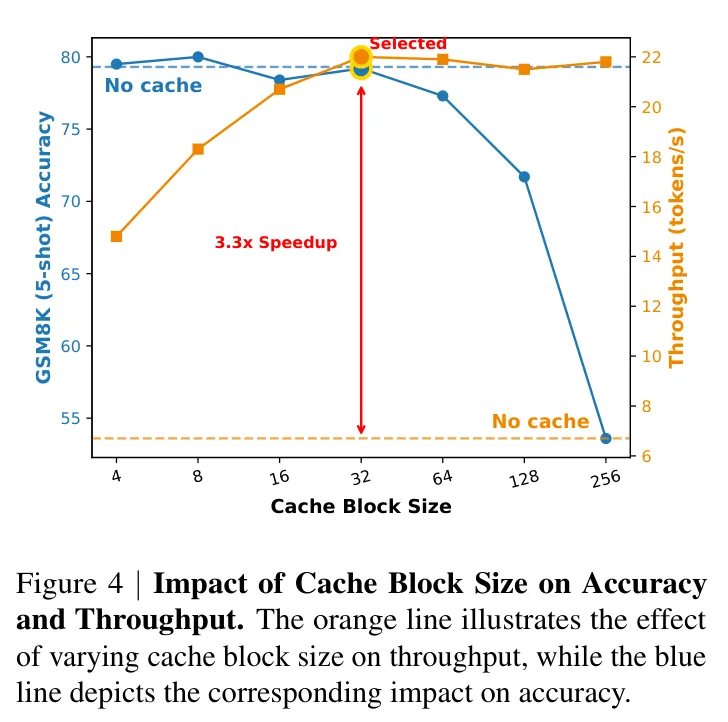
原论文图 4(截自原 PDF) Fast-dLLM针对扩散语言模型推理效率低下的核心问题,提出了两项创新性解决方案:块状近似KV缓存机制与置信度感知并行解码策略。前者通过块级缓存复用,突破了双向注意力模型无法使用KV Cache的限制;后者基于置信度阈值动态选择解码目标,有效缓解了并行生成中的依赖冲突问题。实验表明,该方法在LLaDA与Dream等多种架构上均实现了高达27.6×的端到端加速,且几乎不损失生成质量。 本工作的贡献不仅在于显著缩小了扩散LLM与自回归模型之间的性能鸿沟,更在于其“无需训练”的通用性设计,使其可广泛应用于现有及未来的扩散语言模型,为其实现高效、可靠的工业级部署提供了切实可行的技术路径。
关键技术一:块状近似KV缓存机制
关键技术二:置信度感知并行解码
实验验证与综合性能分析