ARTICLE · 1143486
掀翻英伟达“模板地狱”!DeepSeek公开神秘底层引擎,把GPU榨到物理极限
大模型每天在成千上万张顶级显卡上狂奔,它们到底在忙些什么?
把所有花哨的概念剥开,底层几乎只剩下一件事:把海量的巨大矩阵乘起来。
权重和激活相遇,注意力层层叠叠,专家网络频繁分流。在现代人工智能的超级工厂里,最耗电、最吵闹、最核心的工位,有一个共同的名字,GEMM(通用矩阵乘法)。
谁能把矩阵乘法写得更贴近硅晶片,谁就能在同样的芯片上,挤出成倍的 Token,砍掉数以亿计的算力账单。
过去,这是芯片巨头严防死守的绝对领域,也是无数底层工程师望而生畏的“黑盒”。
然而,DeepSeek 在开源周第三天,直接把自家模型胸膛剖开,掏出了这颗跳动的心脏,DeepGEMM。
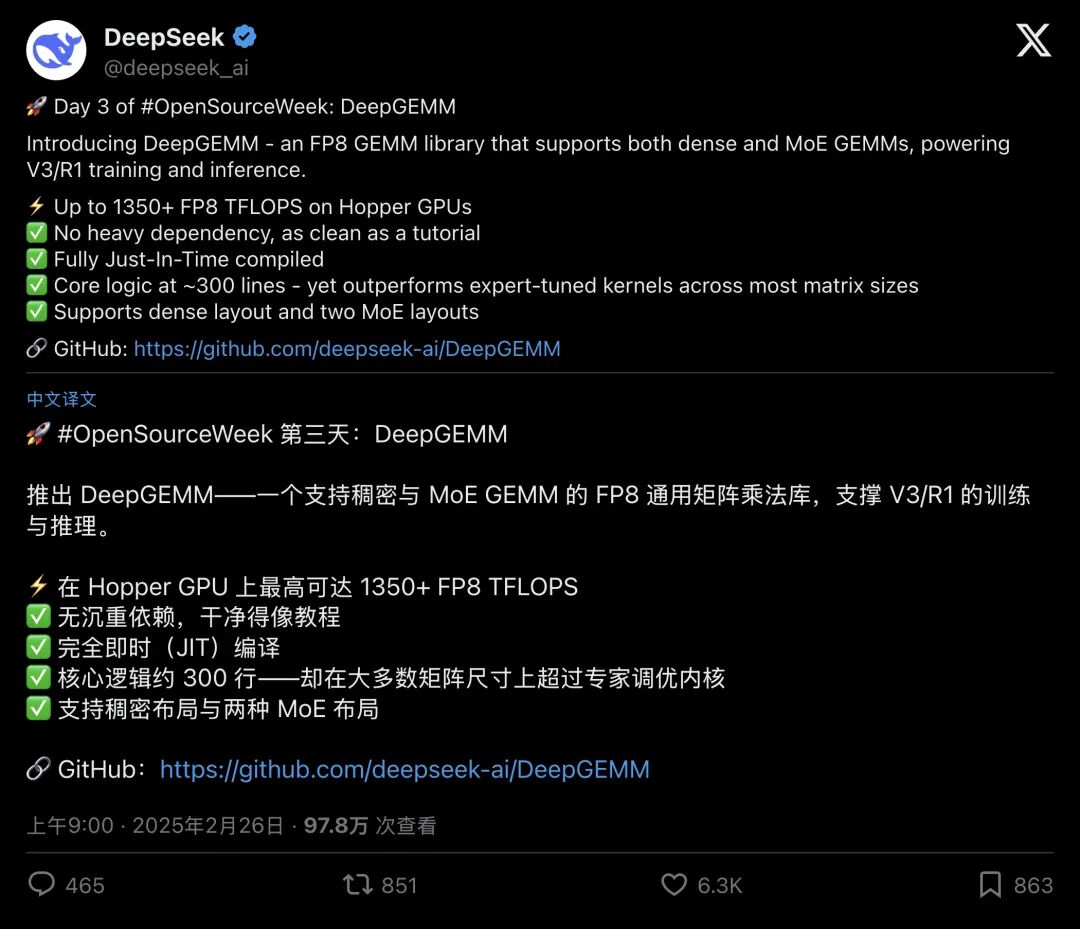
▲ DeepSeek 官方发布 DeepGEMM,宣称核心逻辑约 300 行,算力直奔 1350+ TFLOPS
不仅代码干净得像一本公开教科书,它的实测性能更是让整个硅谷倒吸一口凉气:在英伟达顶级芯片上,它能飙出 1350+ 乃至 1550 TFLOPS 的惊人算力;更有一群极客发现,这套引擎的微架构“黑魔法”,甚至能把小尺寸计算提速 50% 以上。
这是一场用极简代码,对传统繁复软件体系发起的降维打击。
01模板地狱 vs 300行代码:软件工程的减法奇迹
在高性能计算领域,长久以来盘踞着一个让人又爱又恨的庞然大物:英伟达官方的 CUTLASS 模板库。
为了兼顾通用性,传统官方库包裹了极其厚重的 C++ 模板代数。打开源码,层层嵌套的抽象如同迷宫编译一次动辄数十分钟,报起错来屏幕上滚过几千行天书。
开发者想要改动一个算子,就像戴着镣铐在泥潭里跳舞。
旧时代的方案,是用无尽的抽象来对抗硬件的复杂。
DeepSeek 选择了彻底反其道而行之。
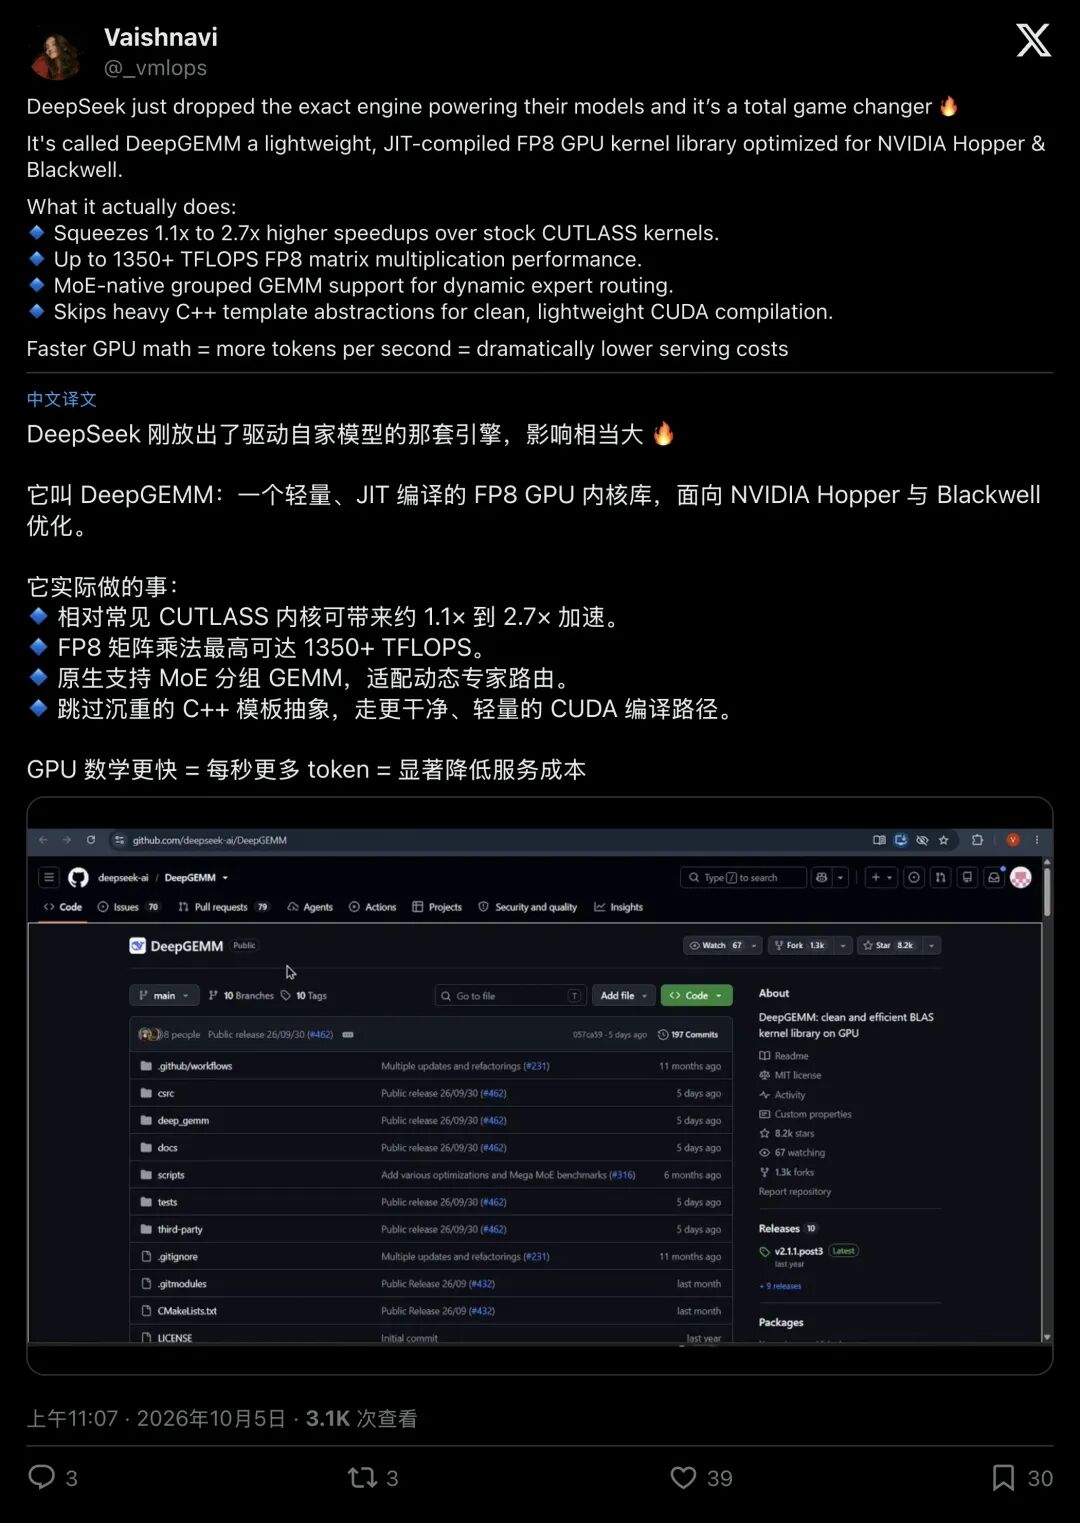
▲ 海外博主解说 DeepGEMM:抛弃沉重抽象,直接榨干硬件潜能
他们砍掉了所有华而不实的重型依赖,最初的核心内核代码,仅仅只有大约 300 行。
这里看不到层层嵌套的继承树与繁琐模板。为了彻底告别安装时的冗长等待,DeepGEMM 引入了运行时即时编译(DeepJIT)。
你不需要提前几个小时预编译一个庞大的库。在模型跑起来的那一瞬间,系统根据当前矩阵的实际长宽,现场定制生成最极致的 CUDA 机器码。
这种“轻装上阵”不仅让代码像教科书一样清晰可读,更直接带来了恐怖的性能表现:
在 Hopper(H800)架构上,面对 DeepSeek-V3 和 R1 的真实矩阵形状,DeepGEMM 相比精心调优过的内部 CUTLASS 基线,跑出了 1.1 倍到 2.7 倍 的加速。
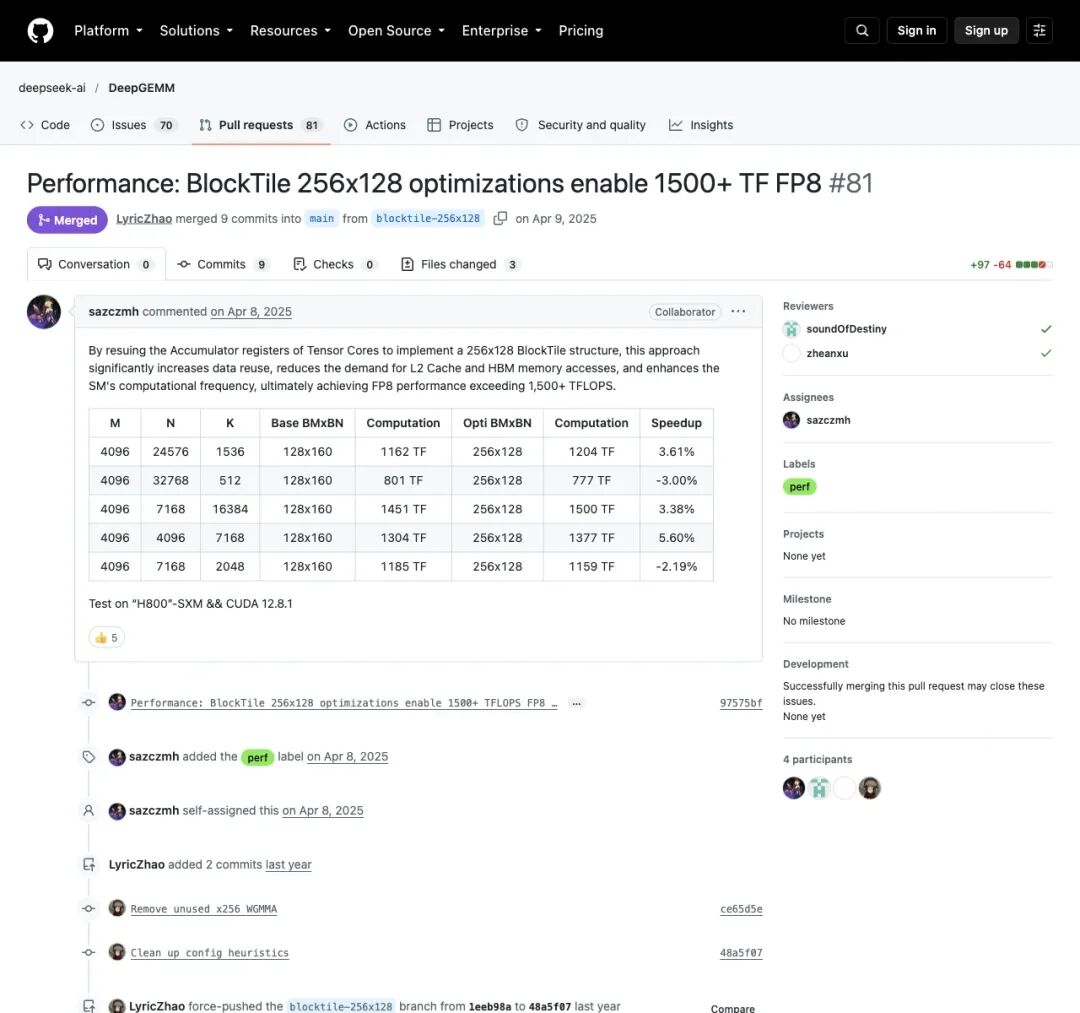
▲ 社区与官方 PR 记录:通过复用寄存器与扩大分块,性能被进一步推向 1550 TFLOPS
在后续的优化中,团队通过重构张量核累加寄存器,更把大矩阵性能从 1350 TFLOPS 一路推到了 1550 TFLOPS。
把复杂留给底层物理,把纯粹留给代码设计。 这是老派硬核黑客对繁冗现代软件工程的一次彻底洗礼。
02MoE 的致命痛点:专家很忙,但 GPU 在“挨饿”
如果只是算规整的大矩阵,业界或许还不至于如此震撼。DeepGEMM 最具突破性的地方,在于征服了混合专家模型(MoE)的恶梦级难题。
在 DeepSeek-V3 这种前沿模型中,各路输入由路由机制动态分发给对应的专家网络,矩阵负载因此高度分散。
这就带来了一个极度头疼的矛盾:每个专家分到的 Token 数量是动态变化的,甚至极度不均。
▲ Agentpedia 针对 DeepGEMM 的全景架构解析:聚焦 MoE、FP8 与底层布局
在传统的旧方案里,面对忽大忽小的任务,GPU 会陷入两难:
如果为每个专家单独启动一次计算,GPU 的发射开销(Launch Overhead)会彻底把管线拖垮; 如果在显存里拼命搬运、切分、对齐数据,显存搬运的时间往往比实际计算的时间还要长!
针对这个结症,DeepGEMM 祭出了两把严丝合缝的手术刀:连续布局(Contiguous)与掩码布局(Masked)。
1. 预填充阶段(Prefill):连续布局,吞吐拉满
在用户刚刚敲下一大段 Prompt 时,Token 数量巨大。
DeepGEMM 调度器将所有分给专家的有效数据紧凑排列,消除所有空隙,同时利用专门的对齐接口,严格匹配张量内存加速器(TMA)的硬件抓取规则。
这就像把集装箱严丝合缝地塞满货船,在单次计算发射中并行处理完所有专家,显存带宽利用率持续压在 1600 GB/s 以上的高位,性能直逼稠密矩阵的物理极限。
2. 解码阶段(Decode):掩码布局,微秒级绝杀
到了逐字输出结果的解码阶段,工程设计的巧思展现得尤为明显。
此时每次只有寥寥几个 Token,传统方法如果频繁重排内存,不仅巨慢,更会直接摧毁英伟达的 CUDA Graph(静态执行图),动态的矩阵尺寸会导致静态图无法捕获,每一次操作都要由 CPU 重新调度,延迟高得令人绝望。
DeepGEMM 给出了一个极其优雅的解法:我不改变矩阵形状,我用掩码(Mask)标记。
系统预先开好一个最大固定形状的张量池,带上一组布尔掩码。计算核心读到有效标记就正常运算,遇到无效标记,在片上寄存器层面顺手归零跳过。
物理尺寸自始至终没有发生丝毫变化!这让自回归解码过程完美拥抱 CUDA Graph,CPU 发射延迟被彻底降维抹平,每一步推理时延被生生压进了微秒级的绝对盲区。
在此基础上,该掩码布局直接无缝连通了自研的专家通信库 DeepEP。通信刚把数据送进缓冲区,计算内核原地就地开跑,中间零拷贝、零重排。
两条腿并作一条腿,把流水线彻底喂饱。
03神奇的 swapAB:“反着算”反而快了 50%?
如果说掩码布局是顶层架构的巧思,那么在更新一代的 Blackwell(SM100)架构上,DeepGEMM 展现的则是一种近乎妖异的底层微架构嗅觉。
许多人发现了一个极其反直觉的现象:在 DeepGEMM 的 Blackwell 路径里,矩阵乘法并未按常规计算 $C = A \cdot B$,转而计算:
$$C^T = B^T \cdot A^T$$
把输入矩阵对调反过来算,为什么性能会凭空暴涨?
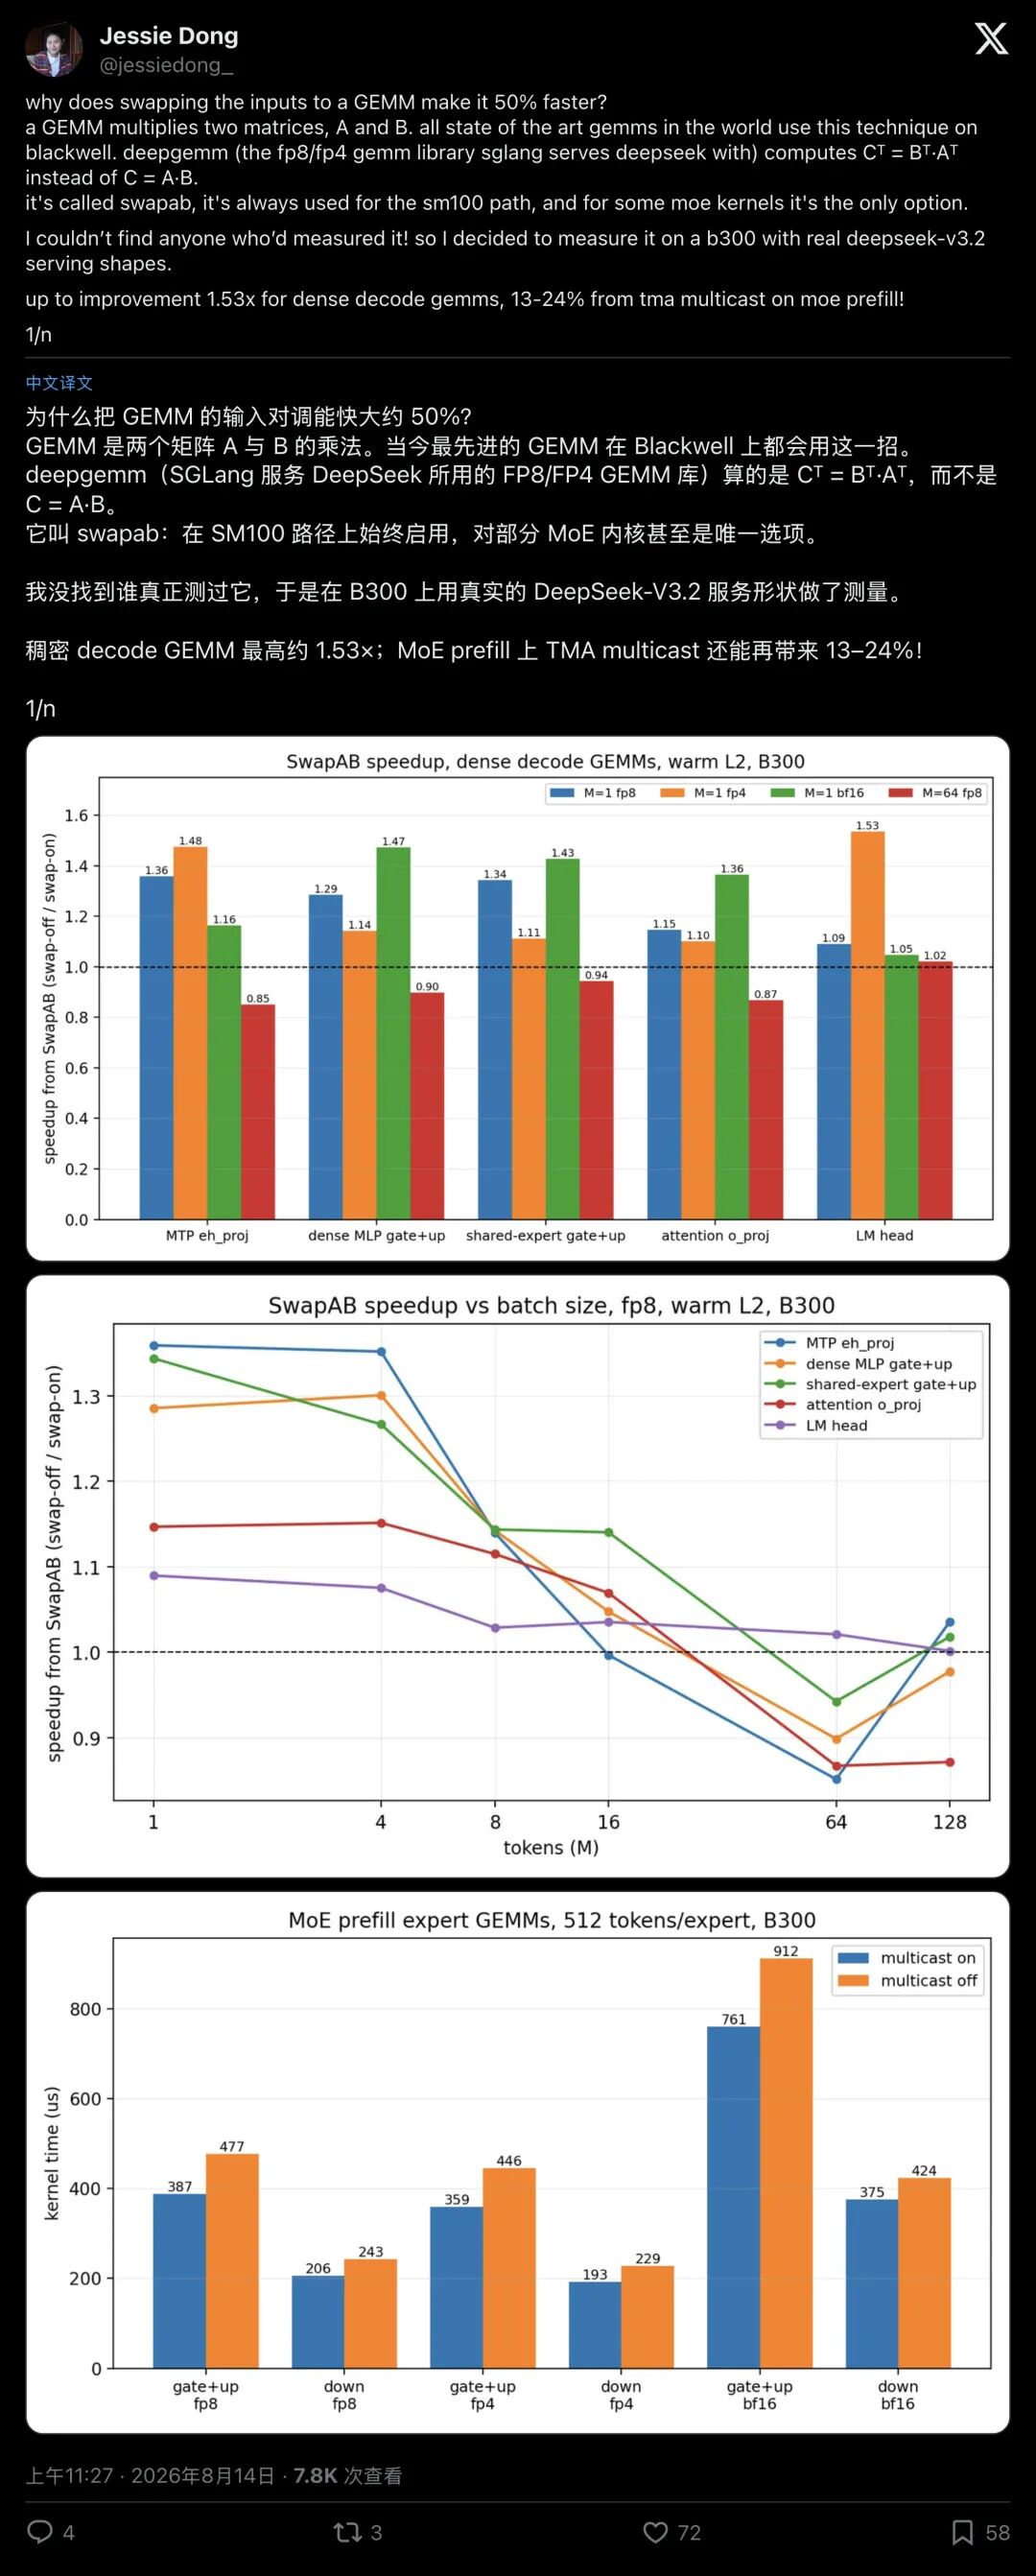
▲ 工程师 Jessie Dong 在 B300 上针对真实形状的实测:decode 场景下性能飙升 1.53 倍
资深工程师 Jessie Dong 亲自在 B300 硬件上跑了真实测试,揭开了这个被称为 swapAB 的底层秘密。
在大模型的自回归解码时,输入矩阵 $A$(代表 Token 序列)往往非常“瘦长”,行数极小,维度极高。
而在英伟达最新的张量核心微架构里,$M$ 维度和 $N$ 维度的硬件处理灵活性是完全不对称的。如果你老老实实按原样送入计算,硬件的很多处理通道(Lane)由于分不到足够的数据,只能在每一个时钟周期里被动“摸鱼”,硬件有效利用率断崖式下跌。
算不对,就反着算
DeepGEMM 坚决启用了转置对调。这一换,直接把短板挪到了硬件更擅长调度的一侧。
在实测数据中,这种神级操作直接让密集解码的性能飙升了 1.53 倍;在 MoE 预填充阶段,借由 TMA 组播硬件红利,又额外白捡了 13% 到 24% 的加速!
这种打破教科书常规的构想,唯有长期深耕汇编指令与硬件微架构的工程师,才能精准发掘出捷径。
04终局融合:Mega MoE 压榨硬件物理极限
如果一个内核只在自己的地盘跑得快,在全局系统里依然会被其他环节拖累。
在传统推理管线中,跨卡通信和显卡计算是泾渭分明的两截木头:通信时计算单元干等,计算时网络链路闲置。
DeepGEMM 的进化终局,是将这一切全部融为一体的 Mega MoE。
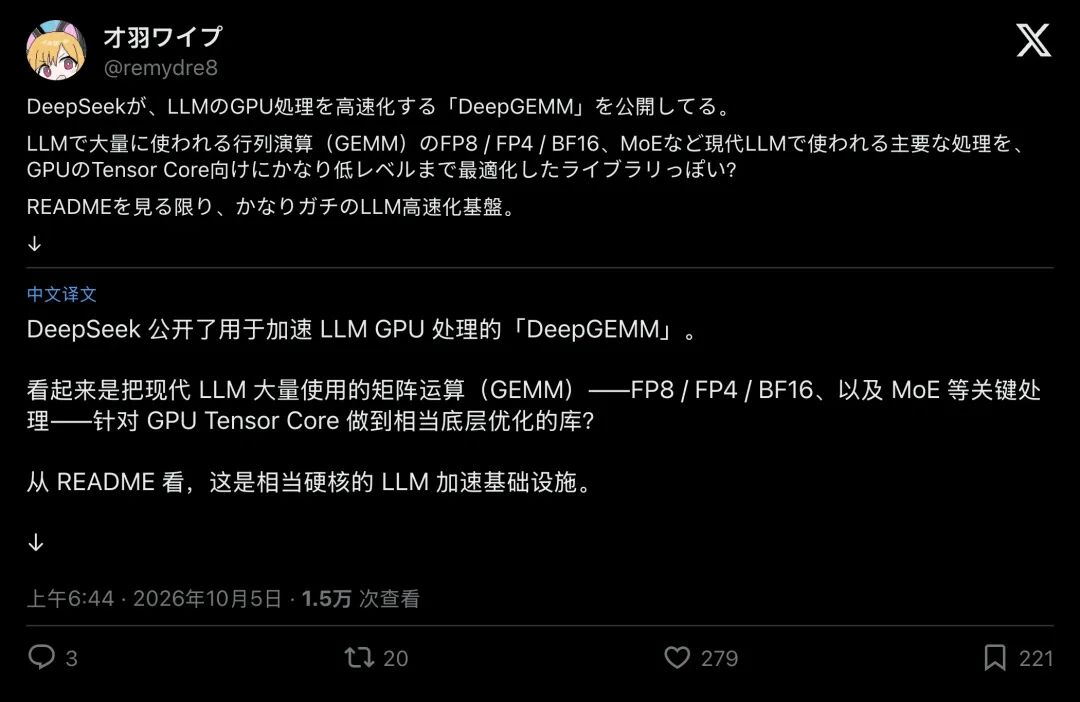
▲ 日本技术社区评论:直达 Tensor Core 底层的基建级神器
它超越了单纯矩阵库的范畴,将跨节点通信分发(EP Dispatch)、第一层前向计算、SwiGLU 激活函数、第二层反向投射、直至最终合并(Combine),全流程打包融进了一个复合内核之中。
通过对称显存分布与多进程协作,NVLink 高速通信与张量核矩阵乘在微秒级尺度上完成了极致的重叠覆盖。数据还在飞驰,计算已经启动;计算刚刚落幕,输出已经抵达下一张卡。
05走向纯粹开源:告别黑盒时代
在技术圈的喧嚣中,总有一种声音喜欢把工程优化简化为算力的数字堆砌。
但在 DeepGEMM 的开源推文下方,一条看似简单的评论引发了无数开发者的由衷共鸣:
“DeepSeek is the true Open AI.”
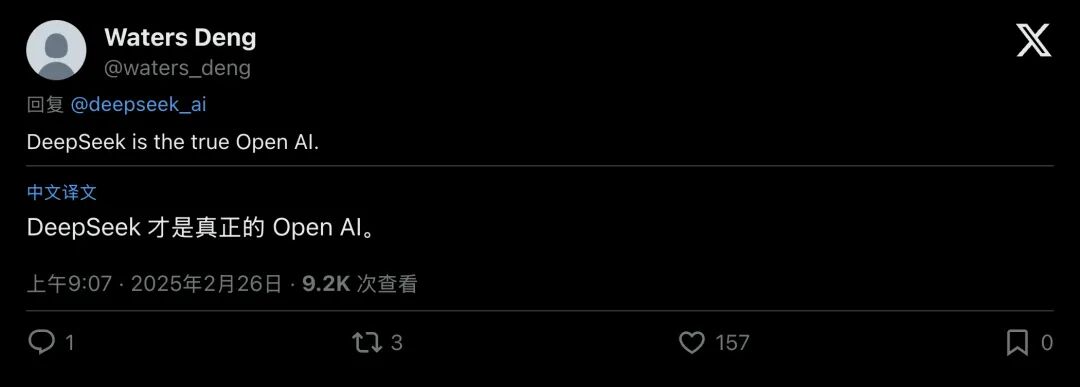
▲ 开发者在 DeepSeek 开源周推文下的高赞回复
这句话的含金量,只有每天在服务器机房和底层指令集里挣扎的人才懂。
很多大厂所谓的开源,只是居高临下地扔出一个训练好的几十GB权重文件,把怎么炼成、怎么加速、底层如何运转的所有扳手和螺丝刀牢牢锁在黑箱之中。
而 DeepSeek 做的事情,是把自己在万卡集群上撞得头破血流才摸出来的避坑指南、把价值数千万美元试错成本换来的底层算子、把精简到只有几百行却快到窒息的代码,连同所有注释和测试用例,毫无保留地交给了全世界。
甚至连老牌高性能计算标杆 CUTLASS 的维护者们,都开始在官方讨论区里认真研读 DeepSeek 的代码,讨论如何吸收其 FP8 细粒度缩放与注意力算子的创新设计。
算力向深处演进,靠的是对每一枚硅晶体潜能的极致挖掘,单纯堆砌芯片无法取代底层优化。
当昂贵芯片摆脱繁重框架的空耗,当每一个时钟周期都被纯粹的数学填满,大模型高昂的商业推理成本才会从底层被彻底击穿。
这才是那 300 行底层代码,给全行业带来的最大震荡。