ARTICLE · 1143483
AI 不再只会生成文字:一文读懂 OpenAI Decisions API 与 Jev 决策模型
AI 不再只会生成文字:一文读懂 OpenAI Decisions API 与 Jev 决策模型
从生成式 AI 到决策式 AI,Agent 的下一步是什么?
过去几年,大语言模型(LLM)的发展几乎都围绕着一个核心能力展开:生成。
从最初的文本问答,到代码生成、多模态理解,再到如今能够自主调用工具、执行复杂任务的 AI Agent,大模型的能力正在不断扩展。
但在实际的 Agent 系统中,我们会发现一个有趣的现象:
很多时候,我们根本不需要大模型生成一段回答,只需要它帮我们做一个判断。
例如:
• 当前用户的问题是否需要进行 RAG 检索? • 应该将任务分配给哪个 SubAgent? • 某个工具是否适合处理当前请求? • 检索到的文档与用户问题是否相关? • 某个操作是否具有较高风险?
这些问题并不需要复杂的文本生成。系统真正需要的,可能只是一个布尔概率、一个候选选项,或者一个评分。
2026 年 9 月 15 日,AI 初创公司 TypeSafe AI 发布了专门面向决策任务的 Jev 模型。
不到一个月后的 10 月 6 日,OpenAI 也推出了全新的 Decisions API,并正式开放 Public Beta。
两项技术先后出现,指向了一个值得关注的方向:
让 AI 从生成文本的工具,进一步成为软件系统中可组合、可控制的决策组件。
今天就来介绍这两项新技术,以及它们可能如何改变未来的 Agent 架构。
一、为什么我们需要专门的决策模型?
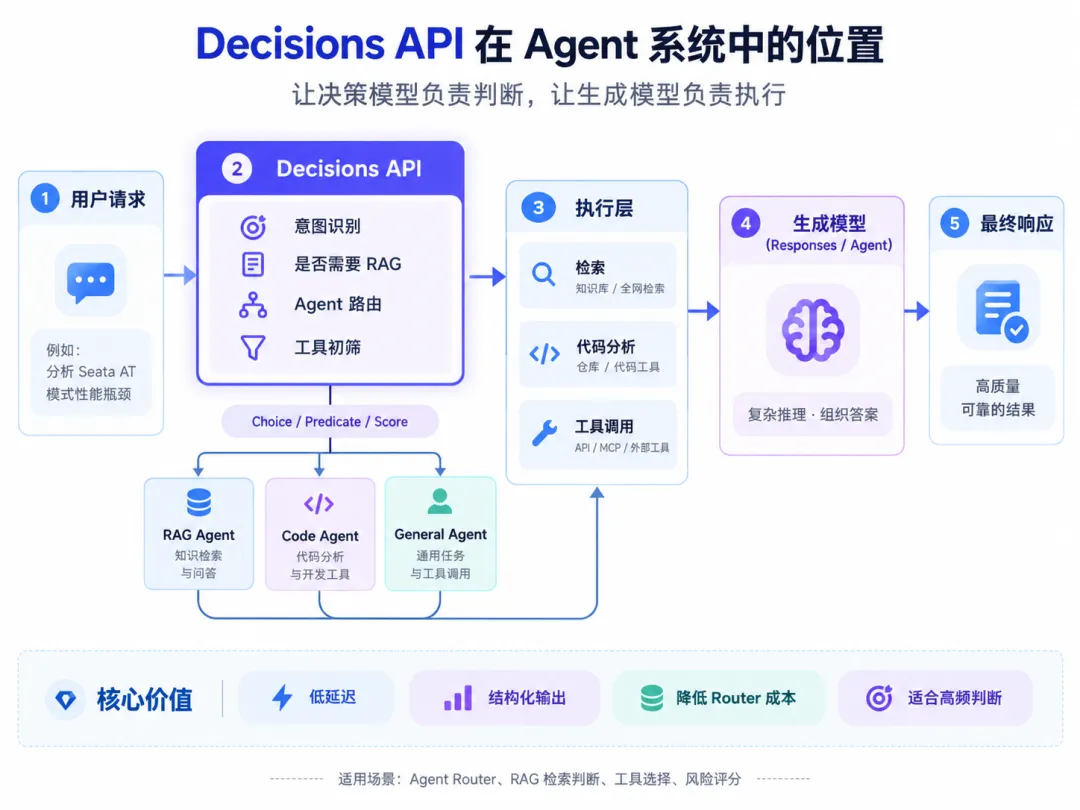
先来看一个典型的 Agent Router。
假设我们正在开发一个多 Agent 系统,内部包含三个处理节点:
• RAG Agent:负责知识检索与问答。 • Code Agent:负责代码分析与生成。 • General Agent:负责通用任务。
当用户输入:
“分析一下 Seata AT 模式中的性能瓶颈。”
系统需要判断应该由哪个 Agent 处理。
1. 传统方案:调用 LLM 进行分类
最常见的实现方式,是让大模型阅读用户问题,根据 Prompt 中定义的规则输出一个分类结果。
例如:
{"agent": "CODE_AGENT"}
随后,Router 读取这个字段,将任务分发给对应的 Agent。
这种方式已经能够很好地完成任务。借助 Structured Outputs,开发者甚至能够强制模型输出符合 JSON Schema 的结果。
但是,它依然面临几个工程问题。
首先,传统 LLM 主要围绕自回归文本生成构建。当我们只需要一个简单分类结果时,完整的生成过程可能显得过重。
其次,实际业务并不总是只需要一个标签。有时候我们还想知道:模型对这个判断有多大把握?其他候选选项分别有多大可能性?
最后,如果 Router 位于每一次请求的必经路径上,其响应延迟就会直接影响整个 Agent 的端到端耗时。
这使得一个问题变得越来越重要:
能否让模型不再生成答案,而是直接计算决策结果?
Jev 和 Decisions API 都在尝试解决这个问题。
二、Jev:专门为决策而生的 System One 模型
2026 年 9 月 15 日,TypeSafe AI 发布了第一款 System One 模型——Jev。
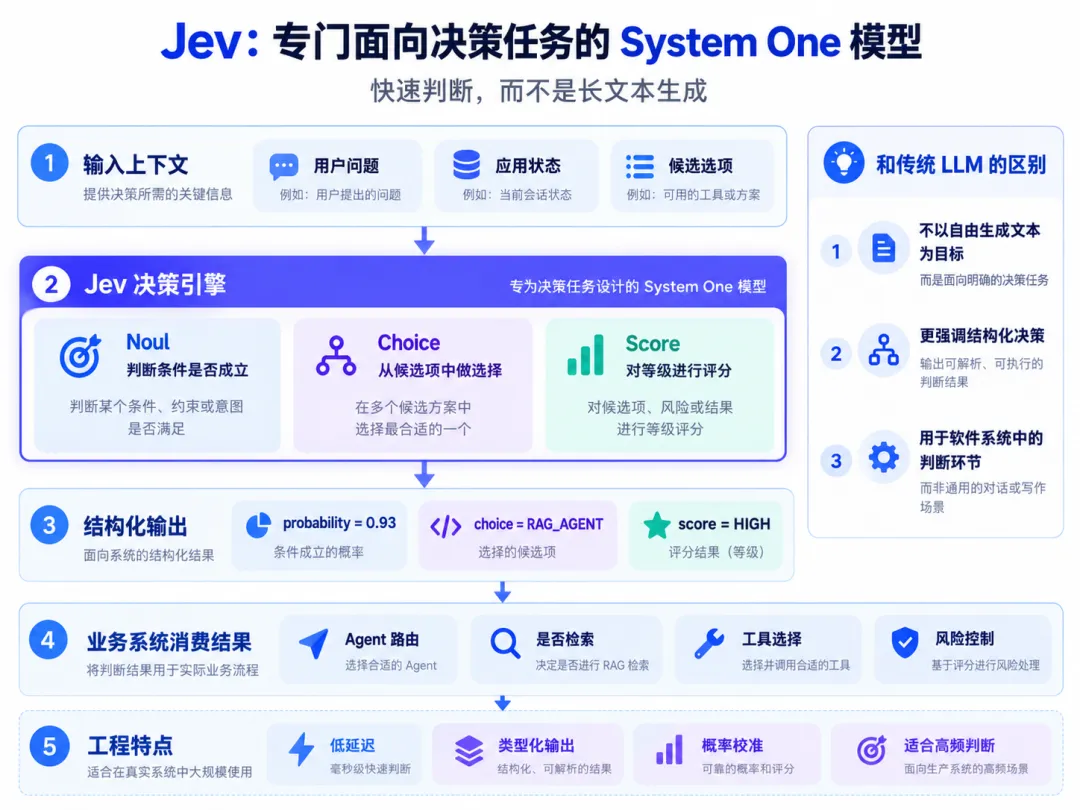
TypeSafe AI 的创始人 Diogo Almeida 曾在 OpenAI 从事模型训练相关研究。
其团队提出的一个核心观点是:
传统大模型擅长生成面向人类阅读的内容,但软件系统真正需要的,很多时候是可以直接使用的结构化判断。
1. 什么是 System One?
System One 的命名灵感来自心理学家丹尼尔·卡尼曼在《思考,快与慢》中提出的双系统理论。
• System 1:快速、直觉式判断。 • System 2:缓慢、需要更多推理的思考。
TypeSafe 借用了这一概念,将 Jev 定位为能够快速处理边界明确的判断任务的模型。
与传统 LLM 不同,Jev 不追求生成长篇文本,而是直接输出带有概率信息的结构化结果。
可以将其理解为:
输入上下文 + 明确的问题 → 输出结构化决策。
2. Jev 提供三种决策原语
Jev 当前提供三种核心能力。
① Noul:真假概率判断
用于判断某个条件是否成立。
例如:
“当前用户的问题是否需要查询知识库?”
可能返回:
noul: 0.93
表示模型估计该条件成立的概率为 93%。
② Choice:候选项选择
用于从预先定义的选项中选择结果。
例如:
“以下三个 Agent,哪一个最适合处理当前请求?”
候选项包括:
RAG_AGENT / CODE_AGENT / GENERAL_AGENT
Jev 会返回选中的选项,以及候选项的概率分布和置信度信息。
③ Score:等级评分
用于根据一组有序等级进行评估。
例如,对工单严重程度进行分类:
LOW / MEDIUM / HIGH
模型返回评分及各等级的概率分布。
需要注意,Score 的最终结果可以是介于相邻等级之间的加权数值,而不一定是整数等级。
这三种决策原语可以组合使用,一个请求中也可以包含多个独立问题。
3. Jev 的核心技术:RLCD
Jev 最值得关注的地方在于其训练方向。
传统生成式大模型经常使用 RLHF(基于人类反馈的强化学习)或者 RLVR(基于可验证奖励的强化学习)。
而 TypeSafe 提出了:
RLCD:Reinforcement Learning for Calibrated Decisions
即面向校准决策的强化学习。
所谓概率校准,可以通过一个例子理解。
假设模型对 100 次判断都给出了 90% 的概率。
如果这些判断中最终约有 90 次被证实正确,那么从这组样本来看,模型的概率估计就具有较好的校准性。
反过来,如果只有 60 次正确,却始终输出 90% 的概率,那么模型就存在明显的过度自信问题。
对于 Agent 系统而言,这一点非常重要。
因为我们不仅关心模型选择了什么,还关心:
当前决策的不确定性,是否足以让系统安全地自动执行?
此外,TypeSafe 官方还表示,Jev 采用了新的模型架构和并行采样机制,避免传统自回归模型逐 Token 输出带来的部分开销。
不过,Jev 的完整网络结构和训练细节尚未公开,因此不能简单将其理解成某种已知架构的缩小版。
三、OpenAI Decisions API:让 GPT 直接做决策
在 Jev 发布后,OpenAI 于 2026 年 10 月 6 日推出 Decisions API。
它是 OpenAI 新增的一套独立 API 接口:
POST /v1/decisions
目前处于公开测试阶段,使用的模型为 gpt-6-luna。
官方将其定位为一种能够快速处理文本和图像输入,并直接返回结构化决策结果的 API。
1. 它和 Responses API 有什么不同?
Responses API 是面向通用生成、复杂推理和工具调用的接口。
开发者可以让模型完成问题解答、代码生成、信息提取,以及调用外部工具等任务。
Decisions API 则更加聚焦。
它只提供有限类型的判断结果,而不以自由生成文本为目标。
其请求结构主要包含三个部分:
• model:指定决策模型。• input:输入文本或图像等上下文。• questions:定义需要判断的问题及候选结果。
2. 三种核心决策类型
① Predicate
用于判断某个条件成立的概率。
例如判断一段检索文档是否与 Query 相关,返回 probability,取值介于 0 和 1 之间。
② Choice
从给定候选选项中选择一个结果。
例如 Agent Router 可以定义三个候选 Agent,由模型选择最合适的一个,并给出概率分布和置信度。
③ Score
根据预先定义的有序等级进行评分。
例如评估工单的严重程度、文档的相关性等级或任务的风险级别。
从能力上看:
• Predicate 对应 Jev 的 Noul。 • Choice 对应 Jev 的 Choice。 • Score 对应 Jev 的 Score。
因此,两者在 API 能力层面具有很高的相似性。
但这并不意味着它们采用了完全相同的底层实现。
3. 性能和成本
OpenAI 官方表示,在适合的决策任务中,Decisions API 的响应速度相较使用 GPT-6 Luna 的 Responses API,可以提升约 10 倍。
其标准输入定价为:
每百万输入 Tokens:0.10 美元。
不单独收取输出 Token 费用。
这意味着,对需要大量执行轻量判断的应用来说,它可能成为传统生成式调用之外更经济的选择。
当然,官方性能数据只针对特定比较条件,并不代表所有生产请求都能够获得相同加速。
4. 实际如何使用
官方使用独立接口:POST https://api.openai.com/v1/decisions下面是一个符合官方请求结构的 Agent Router 示例。
{ "model": "gpt-6-luna", "input": "分析 Seata AT 模式的性能瓶颈", "questions": [ { "type": "choice", "name": "agent_router", "instructions": "选择最适合处理该请求的 Agent", "choices": [ { "value": "RAG_AGENT", "description": "技术知识库检索与问答" }, { "value": "CODE_AGENT", "description": "源码分析和代码优化" }, { "value": "GENERAL_AGENT", "description": "通用问答和交流" } ] } ]}API 会返回 answers,对于 choice 类型包含选中的 choice、confidence 以及候选项的概率分布。这意味着你的 Agent Router 可以直接消费结构化结果,而不必让大模型先生成一段自然语言再解析
四、Jev 和 Decisions API,到底有什么区别?
虽然两者提供了相似的决策能力,但其技术路线和产品定位依然存在区别。
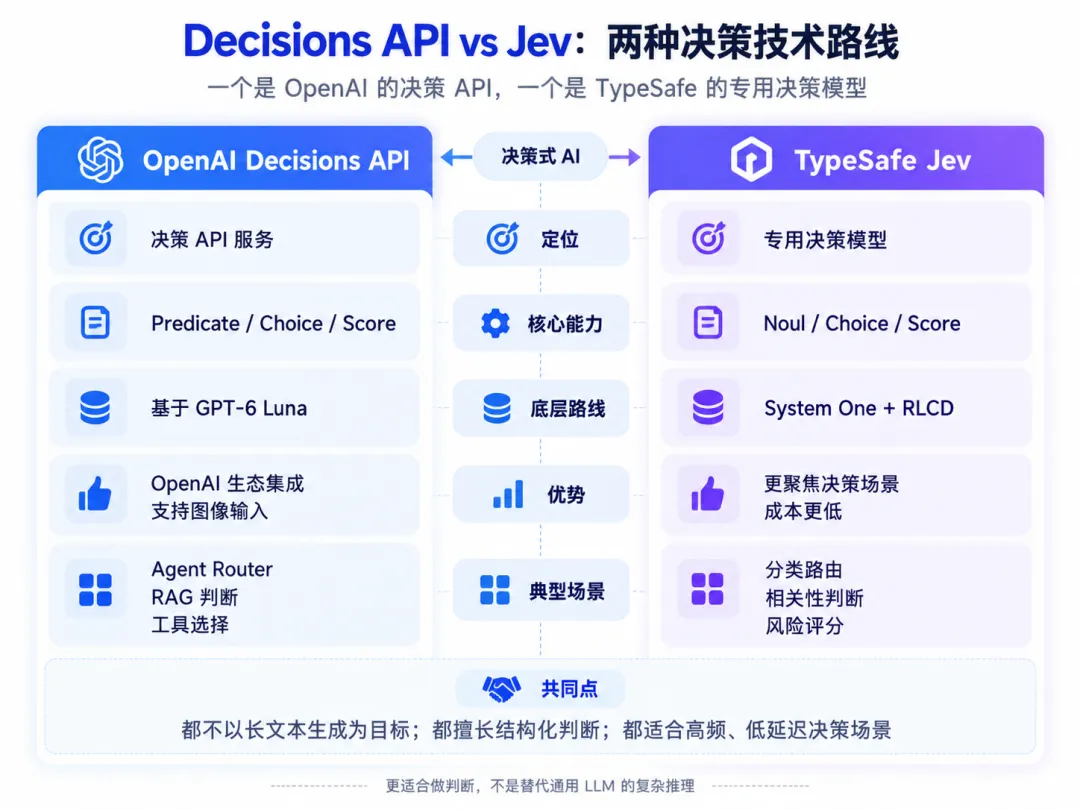
以上为 2026 年 10 月 9 日官方公开信息,模型能力和价格后续可能调整。
从价格来看,Jev 的标准输入 Token 单价更低。
从产品生态来看,Decisions API 可以与 OpenAI 已有的模型服务及开发工具配合使用。
从技术研究角度来看,Jev 更有意思。
它不是单纯提供一个不同的 API,而是尝试从模型架构、采样方法和训练目标上,重新设计适合软件自动化场景的 AI。
但我们也不能因此认定 Jev 在实际任务中的准确率一定更高。
决策质量、概率校准程度、P95 延迟和实际成本,仍然需要在具体业务数据集上评测。
五、决策模型会如何改变 Agent 架构?
这是我认为最值得关注的部分。
过去设计 Agent 时,我们习惯让一个大模型承担多个角色:
理解用户意图、选择工具、决定是否检索、执行任务、评估结果,并生成最终答案。
但这些步骤所需要的模型能力其实并不相同。
有些任务需要复杂推理,有些只需要快速分类,有些甚至应该完全由确定性业务代码处理。
因此,一种值得探索的架构是:
决策模型负责判断,生成模型负责复杂推理,业务代码负责执行与控制。
以 RAG Agent 为例:
场景一:意图识别与 Agent Router
用户发起问题后,先由决策模型完成意图分类。
例如:
用户问题 → Decisions API / Jev → RAG Agent / Code Agent / General Agent
对于置信度较高的明确问题,可以直接路由。
对于边界模糊的问题,则可以交给更强的生成模型进一步分析,或者进入兜底处理流程。
这是一种典型的模型级联(Model Cascade)思路。
场景二:RAG 检索必要性判断
并不是每个用户问题都需要访问知识库。
例如:
“你好。”
通常不需要检索。
但如果用户询问:
“Seata 2.x 的 AT 模式有哪些性能优化?”
系统可能需要检索实时或内部技术资料。
这时可以使用 Predicate 或 Noul 判断:
requires_retrieval = 0.96
再结合业务阈值决定是否进入 Retriever。
需要强调,检索决策也存在误判风险。如果错误跳过了知识库,反而可能增加模型幻觉。
因此,阈值应根据漏检代价和历史评测结果设置,而不是简单固定为 0.5。
场景三:RAG 检索结果相关性判断
对于典型的 RAG 系统,其检索链路可能是:
Query Rewrite → 多路召回 → RRF 融合 → Reranker → Context 构建
在候选文档数量有限的情况下,可以探索让决策模型对每条候选文档做相关性判断。
例如:
• 候选文档是否直接回答用户问题? • 是否包含明确的证据? • 是否存在明显的主题偏离?
决策模型返回概率或等级后,系统可以将其作为辅助排序、过滤或拒答判断的信号。
不过,这并不意味着它能够直接替代 Cross-Encoder Reranker。两者的相关性排序效果与成本,需要通过 Recall@K、NDCG、P95 等指标综合比较。
场景四:Agent 工具选择与安全控制
当 Agent 拥有越来越多的工具时,工具选择本身也变得复杂。
例如一个 Agent 同时拥有数据库查询、代码搜索、日志分析和浏览器访问工具。
决策模型可以先对工具进行筛选,再交给生成模型构造具体调用参数。
同样,对于删除数据、支付、修改权限等敏感操作,模型可以辅助判断风险,但最终授权必须由明确的业务规则和权限系统完成。
六、一个容易被忽略的问题:结构化不等于正确
TypeSafe 在介绍 Jev 时强调了类型安全以及避免幻觉输出的能力。
这里需要澄清一个概念,网上很多人说Jev是零幻觉的,官方材料说的零幻觉并非指的是输出的对象或者概率必定正确,而是比如限定了ABC中的一个,不会出现第四个答案D。
这里需要区分两个不同的概念。
第一种是输出层面的错误。
例如模型生成了一个不存在的工具名称,或者返回了不符合预期 Schema 的内容。
通过限制输出类型和候选集合,可以显著减少这类问题。
第二种是语义层面的错误。
例如系统本来应该选择 RAG Agent,模型却选择了 Code Agent。
即便结果完全符合 Schema,它仍然是错误决策。
因此,所谓“不会产生幻觉”,不能理解为“模型永远不会判断错误”。
对于实际生产系统,应该建立完整的决策评测机制,至少关注:
• 分类准确率及错误类型。 • 概率校准程度。 • 高置信度错误决策率。 • P50 / P95 / P99 延迟。 • 单次请求的实际成本。 • 低置信度时的兜底效果。
尤其是当决策结果会触发真实业务操作时,概率仅仅是辅助信号,而不是安全保证。
七、决策模型会取代传统大模型吗?
我认为不会。
至少在当前阶段,它们更适合形成互补关系。
决策模型擅长边界清晰、候选有限、需要高频执行的判断任务。
而生成式大模型擅长复杂推理、开放式内容生成、多阶段规划以及动态工具调用。
例如用户提出:
“分析当前系统的性能瓶颈,检查相关代码,设计优化方案,并给出压测验证策略。”
这显然不是一次简单的 Choice 判断就能够完成的任务。
它需要理解系统架构、拆解问题、使用工具,并不断根据新信息调整计划。
这仍然是通用 LLM 或复杂 Agent 更擅长的工作。
未来更有可能出现的是职责分层:
• 决策层:使用轻量决策模型完成分类、过滤、路由与评分。 • 推理层:使用通用 LLM 完成规划、分析与内容生成。 • 执行层:通过代码、工具和业务规则完成确定性操作。 • 评估层:通过测试和反馈机制持续改进整个系统。
这种架构的目标并不是让 AI 做更多事情,而是让每种 AI 能力出现在最合适的位置。
八、写在最后
Jev 和 OpenAI Decisions API 的出现,反映了 AI 应用开发中的一个变化。
过去,我们习惯把大模型当成一个无所不能的智能入口,几乎所有任务都交给 LLM。
但随着 Agent 系统逐步走向工程化和生产环境,我们开始更加重视延迟、成本、稳定性、可观测性以及结果的可控程度。
一个成熟的 Agent 系统,并不一定需要让最强大的模型参与每一次判断。
相反,它应该知道:
什么时候需要复杂推理,什么时候只需要一个简单决策,什么时候应该交给确定性的代码。
从 Jev 到 Decisions API,我们看到的也许不是某一种 API 的短暂流行,而是 AI 能力进一步模块化的开始。
未来的 Agent,可能不再是一个大模型包办所有事情,而是由多个不同能力的模型与软件组件协同完成任务。
让 LLM 负责思考,让决策模型负责判断,让代码负责执行。
这或许会成为下一阶段 Agent 工程化的重要方向。
参考资料
1. OpenAI — Decisions API 官方文档 2. OpenAI — API Changelog 3. TypeSafe AI — Introducing System One Models & Jev 4. TypeSafe AI — Models 5. TypeSafe AI — System One 开发文档