ARTICLE · 1156189
OpenClaw火到39万Star,研究却发现:AI自己写Skill,平均没变强
当所有人都在给AI安装技能时,我们可能忽略了一件更重要的事:专家的能力,究竟是怎样形成的?
2026年,AI圈最热闹的事情之一,就是“养龙虾”。
这个叫OpenClaw的开源AI Agent,迅速成为开发者社区的现象级项目。
截至10月上旬,它在GitHub上已经获得超过39万个Star。
与它一起火起来的,还有一个词:
Skill。
简单说,就是给AI安装一套可以反复使用的工作方法,让它不必每次都从头摸索。
写代码有Skill,做表格有Skill,查资料有Skill,处理邮件也有Skill。
只要安装相应的技能,AI就能按照预先整理的方法完成任务。
这听起来很像一场生产力革命。
但最近看到两项研究,我突然觉得,事情可能没有那么简单。
2026年9月,一篇研究OpenClaw技能生态的论文发现:截至当年6月22日,ClawHub公开目录中已经有65,175个Skill条目。
其中,77.86%的条目既没有Star,也没有评论。仅从这些公开反馈,难以判断大量Skill的实际质量。
另一个更有意思的结果来自SkillsBench。
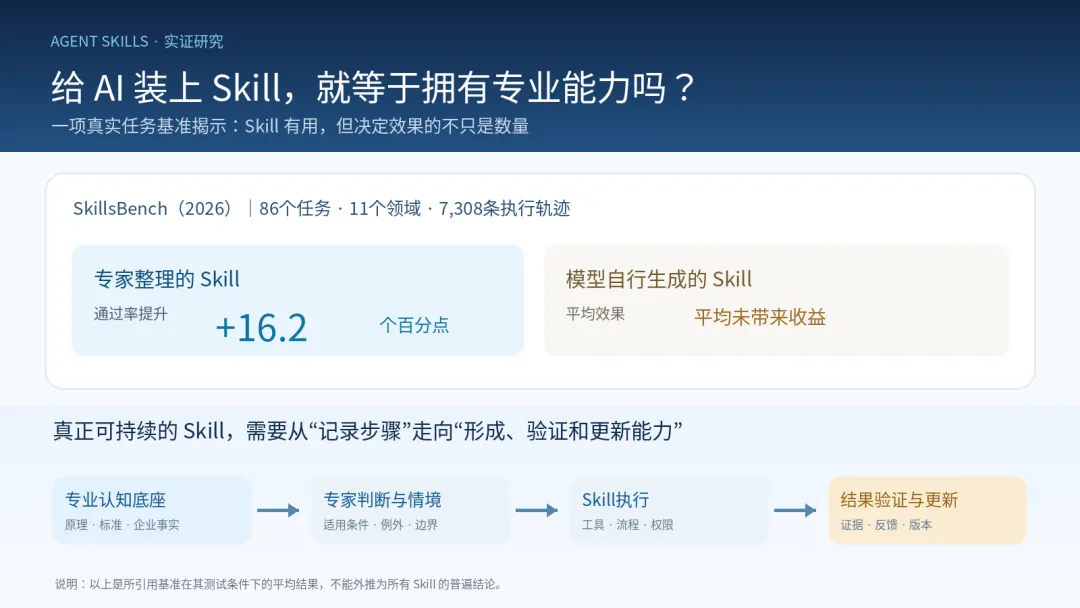
研究者针对11个领域的86项任务,进行了7,308条Agent执行轨迹测试。
他们发现:
经过专业人员整理的Skill,能够让AI任务通过率平均提高16.2个百分点。
但在相同研究设置下:
AI自行生成的Skill,平均并没有带来收益。
需要说明的是,这项SkillsBench研究并不是专门针对OpenClaw的测试,也不意味着AI永远无法生成有效Skill。
但它揭示了一个很值得思考的现象:
为什么Skill已经可以由AI自动生成,模型也越来越聪明,却不能保证生成出来的Skill真正有效?
我认为,这背后隐藏着一个比Skill本身更重要的问题。
我们正在努力教AI复制专家的做法,却未必真正理解专家的能力究竟是怎样形成的。
一、会按照流程干活,不等于真正掌握了一项专业能力
想象一下。
一家制造企业有位工作了三十年的老工程师。
他有一个让年轻同事十分佩服的本领。
拿到一张复杂的产品图纸,看上几眼,就能发现一些别人不容易注意的问题。
某个尺寸不合理。
某个材料选择有风险。
某个工艺条件虽然满足了图纸要求,但放到实际使用环境里,可能还是会出问题。
企业很担心。
等这位老师傅退休以后,他几十年积累的经验怎么办?
过去,这个问题很难解决。
现在有了AI,似乎容易多了。
把他检查图纸的过程记录下来。
整理他的工作步骤。
提取常用的判断条件。
然后做成一个AI Skill。
以后年轻工程师只要调用Skill,就可以让AI按照老专家的方法审核图纸。
看起来,我们终于把老师傅的本领保存下来了。
可是,有一天,产品发生了变化。
原来的材料换了。
某个制造工艺调整了。
相关技术标准也发布了新版本。
这时,年轻工程师发现,AI仍然在按照原来的步骤检查。
于是他问:
“为什么这个尺寸必须这样检查?”
AI能够重复检查步骤。
他又问:
“现在材料变了,原来的要求还适用吗?”
这时,系统可能就没有足够依据了。
问题出在哪里?
我们保存了老工程师过去怎样做,却没有完整保存他为什么这样做。
这两件事,看起来只差了几个字。
实际上差得很远。
一个人能够成为专家,不只是因为他记住了更多步骤。
更重要的是,他理解这些步骤背后的专业原理、适用条件和失效边界。
他知道什么时候可以沿用经验。
更知道什么时候必须放下原来的经验,重新判断。
熟练执行一种方法,与具备重新形成方法的能力,不是同一回事。
二、Skill可以复制经验,也可能把错误复制一万遍
这也是我认为企业建设Skill库时,必须警惕的地方。
一个资深员工的经验,通常非常宝贵。
但宝贵,不意味着永远正确。
比如,一位工程师发现,某种产品采用一套特定工艺,质量最稳定。
于是他总结出一条经验:
遇到类似产品,优先采用这种工艺。
企业把它做成Skill。
从此,所有相关任务都可以调用。
效率确实提高了。
但有没有人追问过:
这套工艺为什么有效?
是因为符合普遍的工程规律?
还是因为企业恰好使用了某种特定设备?
是行业标准的要求?
还是企业内部的一项经验规定?
如果设备换了、材料变了,原来的经验还成立吗?
这些问题如果没有解决,AI就可能把一个特定场景下的有效经验,错误地推广到其他场景。
以前,错误经验可能只影响一位员工。
现在,一个被广泛调用的Skill,可能在短时间内重复同样的错误。
所以我认为,企业建设Skill库,不能只追求一个指标:
积累了多少个Skill。
还需要回答另一个问题:
我们能不能解释每一个关键Skill为什么有效,以及它什么时候会失效?
这才是专业Skill真正的质量基础。
三、真正的问题来了:Skill到底是从哪里长出来的?
我觉得可以用一个简单的比喻。
Skill就像一棵树结出的果实。
我们当然应该保存果实。
但是,一棵树能够不断结果,并不是因为我们把过去结出的果实保存得很好。
而是因为它还有根,有土壤,有持续生长的条件。
专业能力也是如此。
一个优秀工程师的能力,通常来自几个相互作用的方面。
第一,是专业原理。
他理解材料、结构、力学和制造过程中的基本规律。
第二,是行业标准与规范。
他知道什么是明确要求,什么是适用条件,哪些情况存在例外。
第三,是企业的真实工作条件。
他知道哪些设备可以使用,哪些工艺能够实现,哪些制造限制必须考虑。
第四,是长期实践形成的经验。
他见过失败,处理过异常,接受过指导,也不断修正过自己的判断。
这些知识和经历在真实工作中长期相互作用,才逐渐形成专业技能。
所以,当我们把专家最后总结出来的方法制作成Skill时,获得的往往只是整个能力形成过程的一个结果。
而不是全部形成机制。
保存Skill,是保存已经长出来的果实。
保存支撑Skill形成的专业知识和验证机制,才有可能让组织继续长出新的果实。
这就引出了一个我认为很有价值的方向:
企业不能只有Skill库。
在高价值专业场景中,还需要建立支撑Skill形成的专业认知底座。
四、什么是专业认知底座?不是把所有文件扔进知识库
这里特别容易产生一个误解。
有人可能会说:
“这不就是知识库吗?把标准、制度、手册全部上传,让AI搜索就行了。”
我认为还不够。
因为真正的专业能力,不只是知道一条知识。
而是理解知识之间的关系,以及它们怎样共同支持一个判断。
比如,一本工业技术标准。
它里面可能有技术要求、公式、表格、脚注、例外,以及不同条款之间的引用关系。
一个普通的知识库,可以帮助AI找到相关内容。
但一个真正有价值的专业标准引擎,还需要进一步回答:
这条要求适用于哪种产品?
在什么工况下成立?
涉及哪些参数和计算?
是否存在例外?
当前有效的是哪个版本?
如果条件发生变化,原来的判断还能成立吗?
对于能够确定性计算的部分,是否可以使用经过验证的程序和规则,而不是每次依赖模型临时推测?
这样,标准才逐渐从一本供人阅读的文件,变成可以支持专业判断的知识和规则体系。
当然,行业标准不等于全部专业知识。
完整的专业认知底座,还需要工程理论、企业事实、专业经验和实践验证。
它的目的不是代替专家,而是为专家和AI提供一套更可信、可追溯、可更新的专业依据。
这也意味着,未来的专业Skill应该与底层依据建立联系。
调用Skill时,不只是知道“下一步做什么”。
还能够在必要时追溯:
为什么这样做,依据什么这样做,什么条件下不能这样做。
五、未来真正有价值的,不是拥有1000个Skill,而是能不断产生新的Skill
假设两家企业,都拥有300个AI Skill。
第一家企业,把优秀员工过去的操作方法整理成了一套套标准流程。
第二家企业,也拥有这些Skill。
但每个重要Skill还与专业依据、适用条件、工作结果和验证记录建立了联系。
平时,两家企业可能没有明显差别。
AI都能帮员工完成大量工作。
但如果行业标准更新了呢?
第一家企业可能需要重新找专家,逐一检查哪些Skill需要修改。
第二家企业则可能根据标准的版本变化,识别哪些Skill引用了相关要求、哪些判断可能受到影响,并组织重新验证。
如果出现一种以前没有遇到过的新工况呢?
第一家企业可能没有现成的Skill可用。
第二家企业则有机会利用已有的专业知识、工程关系和历史经验,辅助形成新的候选方法,再通过测试和专业审核,把成熟方法变成新Skill。
两家企业的区别,不一定在于当下谁自动化了更多任务。
而在于:
当环境发生变化时,谁更有能力重新学习。
这实际上对应着三种不同的组织能力。
第一种,知道什么。
也就是专业知识、事实、标准和经验的积累。
第二种,会做什么。
也就是能够调用Skill,完成已经掌握的任务。
第三种,怎样学会新的事情。
也就是在已有知识的基础上,面对新问题形成判断,通过实践验证,再发展出新的能力。
我认为第三种能力,才是未来企业Skill体系可能产生长期价值的地方。
六、如何建立一套真正能成长的Skill体系?
这里还有一个需要避免的误区。
是不是应该把企业所有专业知识全部结构化,建成一个庞大的知识系统,再开始制作Skill?
我认为没有必要。
如果企业一开始就追求包罗万象,很可能把一个实际问题变成永远做不完的知识工程。
更合理的做法,是从真实工作出发。
比如,先选择一个高价值的质量审核场景。
第一步,把需要完成的任务和成功标准定义清楚。
第二步,找出支撑这项工作的关键专业知识、标准、规则和判断条件。
第三步,让AI辅助形成Skill,并由专业人员检查其依据和边界。
第四步,通过真实案例、异常案例和反例测试,验证它是否可靠。
第五步,投入受控使用,持续收集执行结果和失败反馈。
最后,将经过验证的新经验更新到相关知识、规则或Skill中。
这样就形成了一个循环:
专业认知底座 → 情境分析 → 方法形成 → Skill执行 → 结果验证 → 能力更新。
这个循环不意味着让AI自动修改所有规则。
恰恰相反。
重要标准、关键业务规则和高风险技术决策,都应该保留必要的权限控制、专业审核和正式发布机制。
因为企业真正需要的,不是越来越多未经验证的自动化。
而是越来越多能够被信任的专业能力。
这里还有一个值得注意的变化:
企业的专业知识不再只是被动等待员工搜索。
它开始通过Skill进入真实工作,又从真实工作中获得反馈。
于是,知识和工作之间形成了持续联系。
七、企业可能一直在支付一笔看不见的成本
为什么值得研究这件事?
因为企业对专业知识传承不足所付出的成本,往往被严重低估。
一个年轻工程师不理解某项标准,需要询问资深员工。
另一个部门碰到同样的问题,又重新研究一遍。
同一项技术要求,不同团队可能有不同解释。
一位老员工退休,某些原本很容易解决的问题,突然变得复杂。
企业能够计算培训费、招聘费和人工成本。
但这些反复发生的理解成本、协调成本和试错成本,往往隐藏在日常工作中。
我把它暂时称为:
基础专业认知传承的隐性成本。
它不是已经被统一统计的会计成本项目,而是一个值得企业识别和测量的管理问题。
建立可靠的专业认知底座,可能带来一种不那么显眼、但持续存在的收益:
新人更快理解专业依据。
老员工减少重复指导。
不同部门对规则的理解更一致。
原有方法更新时更容易找到受影响的工作。
新的Skill也不必每次都从零开始设计。
这些收益,可能比某一个Skill节省几分钟更加重要。
因为它们影响的是整个组织形成和传承专业能力的速度。
八、AI时代真正值得复制的,不只是高手的做法
回头再看OpenClaw和Skill热潮,就会发现一个很有意思的现象。
我们正在越来越容易地让AI学会干活。
但是,让AI按照某种方法执行,与让AI可靠地掌握支撑这种方法的专业判断之间,仍然存在距离。
这不是否定Skill。
恰恰相反。
Skill的普及,让我们第一次有机会以相对低的成本,将大量专业工作方法变成可复用的数字能力。
但是,当越来越多企业开始建设Skill库时,我们可能需要把注意力从数量转向另一个问题:
这些Skill依赖什么知识?
为什么有效?
什么情况下失效?
怎样验证?
当现实变化时,又怎样形成新的Skill?
这也与组织知识创造和组织学习领域长期讨论的问题发生了连接。
组织真正需要传承的,不只是过去成功的答案。
还包括产生这些答案的知识、判断方法和学习机制。
从这个角度看,未来成熟的企业智能体系,可能不仅需要知识库和Skill库,还需要一套连接专业认知、工作执行、结果验证和能力演化的机制。
它不应该取代人的专业成长。
而应该让专业人员在已有知识的基础上,更快地面对新问题,减少重复试错,并把经过验证的成果留给组织。
写在最后
一个老工程师工作了三十年。
如果我们只是把他过去做过的事情全部记录下来,那保存的是他的经验。
如果我们还能弄清楚他依赖哪些专业知识、怎样判断、如何处理例外,并让这些知识和方法持续得到验证,那么我们才有机会让组织继承更多真正有价值的东西。
复制一个专家过去的做法,可以让AI更快完成已经熟悉的事情。
保留专家能力形成所依赖的基础,才可能帮助组织在面对未来时,继续学会新的事情。
所以,OpenClaw有多少Star,Skill商店里有多少技能,当然值得关注。
但对于真正希望长期建设AI能力的企业,我觉得还有一个问题更加重要:
当现有Skill都不再适用时,我们的组织还有没有能力创造下一个Skill?
如果答案是否定的,那么再大的Skill库,也可能只是保存过去经验的仓库。
如果答案是肯定的,Skill库才有机会成为一个能够持续成长的组织能力系统。
AI的下一场竞争,可能不只是看谁拥有更多Skill,而是看谁更有能力让Skill持续形成、验证和进化。
真正有价值的组织智能,不是让企业永远重复过去的正确答案。
而是让企业始终保有寻找新答案的能力。
主要资料来源
OpenClaw官方GitHub;《After the Party: Governing What a Viral Agent-Skill Ecosystem Left Behind》,2026年9月;《SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks》,2026年2月;Anthropic:Skill创建、测试与迭代实践。
说明:文中关于Skill效果的研究结论,均限定在各自测试范围内。专业认知底座及组织能力演化机制属于基于现有实践与研究提出的进一步分析,并非上述研究已经直接验证的全部结论。