ARTICLE · 1156317
源码没了,AI还能接着查?REA把逆向分析接进了Agent
维护老系统,最怕接到这样一个包:程序还能跑,源码找不到了。一个导出按钮到底调了什么,一个桌面应用为什么往剪贴板里塞了特殊格式,只看界面,猜不出答案。
让编程 Agent 接手?它擅长读仓库,可这次连仓库都没有。
REA 想补上这个缺口。它把二进制、JavaScript、Electron 等分析工具接进 MCP,让 Agent 能继续查程序本身。这个方向很诱人,也很容易被吹过头。少读几屏汇编,是实在的收益;把模型讲得流畅的猜测当成结论,则是另一回事。分界线在于:它拿回来的究竟是证据,还是一段听起来合理的解释。
没源码就停工?这次Agent有了新入口
REA 全名是 Reverse Engineer Anything。名字很大,理解时可以缩小一点:它给 Agent 提供一套调查软件行为的工具入口。
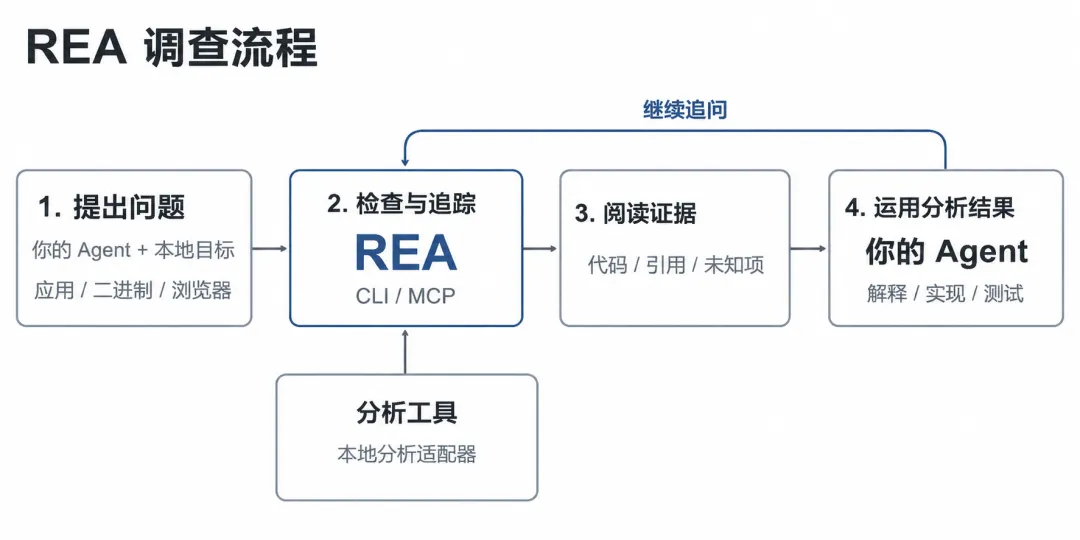
Agent 提出问题,REA 调用相应分析能力,返回代码线索、引用关系和未确认部分;Agent 再沿着这些线索追问,必要时编写实现并测试。终端命令也能走这些工作流。
这里没有“上传程序,一键吐出原版源码”的承诺。能解释一个功能怎样运转,和恢复出当年的完整工程,是两回事。
官网用计算器举了一个容易理解的例子:为什么输入 200 + 10% 会得到 220?光看结果,可以猜它把百分数算成了前一个数的比例。沿着分支与调用继续查,才能判断这套规则适用于哪些运算路径。
对开发者来说,这类工具真正有用的地方,是把“我猜它这样做”往“这几处代码支持这个判断”推进一步。
别急着装一堆工具,先看你手里是什么包
REA 支持的目标不少,但前提各不相同。把它接进 Agent,不代表电脑自动具备所有分析能力。
如果只是检查自己公司的 Electron 安装包,不必先折腾反汇编环境。静态 JavaScript 分析就能作为入口。
反过来,拿到原生程序,想追到具体函数,就得准备相应分析引擎。setup 可以在批准后安装 Hopper;Ghidra 和 IDA 使用已有安装。不要把“支持某种目标”理解成“无需条件就能分析”。
一条命令接进去,但这两步漏了就白忙
先检查 Node.js。当前 README 列出的范围是:22.x且不低于22.19、24.x且不低于24.11,或26及以上,同时需要 npm。不是随便一个“Node 22+”就够了。
在 setup 中选择要接入的 Agent,查看配置修改计划并批准。它会注册 REA 的 MCP server,安装匹配的工作流指令,并备份已有配置。
然后,重启 Agent。
审批配置、重启客户端,这两步别省。只装一份 skill,得到的是调查方法说明,并不等于 MCP 工具已经注册好。当前 setup 支持 Claude Code、Codex、Cursor、Gemini CLI 等客户端,其他兼容本地 MCP server 的客户端可以按文档手动接入。
如果想先绕开客户端配置,直接看静态 JavaScript 分析结果,可以运行:
将路径换成自己的已解包 JavaScript/Electron 应用目录或 ASAR 文件。Windows 可以使用类似 "D:/apps/example" 的路径。
返回内容包含模块、导入、Electron边界及相关证据。先确认工具能读懂手里的目标,再让 Agent 接着追问,排查起来会省事得多。
最危险的不是看不懂,是它说得太像懂了
支持这条路线的理由很实际:人工来回找字符串、跟引用、整理调用链,确实费时间。让 Agent 帮忙缩小范围,能减少重复劳动。
怀疑也有道理。反编译结果不是原始源码,静态关联不等于运行时一定经过,一次观察也覆盖不了所有输入。回答写得再顺,缺失的证据仍然缺失。
我的判断是:让它缩短调查路径,把结论的验收留在手里。
比如检查一个自有 Electron 应用的导出功能,可以这样提问:
找到导出入口,沿着 renderer、preload和IPC追到main进程。列出支持结论的文件或位置;区分已经观察到的事实、推断,以及还需要运行验证的部分。先解释,不修改程序。
这比一句“帮我还原整个应用”更容易得到可以检查的结果。拿到分析后,挑一个小功能,在测试环境中对照输入输出;正常输入通过了,再补空值、错误路径和边界情况。
还有一个容易忽略的区别:分析工具在本地运行,不等于使用云端模型的 Agent 全程离线。涉及内部软件时,要按客户端的实际配置确认哪些工具结果会进入模型上下文。
升级也会踩坑:旧采集文件别硬塞给新版本
REA 更新很快。6.3.0 的变更说明里,有一条值得单独记住:缺少当前生产端记账信息或事务标识的历史 capture,会被拒绝;缺少可访问性或存储维度的网页差异结果,也不能直接沿用。
官方建议保留原始采集,再用当前生产端重新采集,同时更新读取结果的比较程序。别为了让脚本“跑绿”,把缺少的观察字段随手补成默认值。没有采到的数据,不能靠补 JSON 变成事实。
这也提醒我们,真要把 REA 接进长期工作流,除了记安装命令,还要记下版本、目标文件和采集条件。否则今天的结论,明天可能连依据都对不上。
先查一个小功能,别上来就喊“重建整个软件”
适合起步的场景其实很朴素:排查自有旧程序、检查获得授权的软件包、研究兼容性,或者分析练习样本。选一个明确问题,保存目标副本,先做静态调查,再决定是否需要运行观察。
REA 值得关注的地方,是把程序分析工具接进了编程 Agent 的调查流程。但程序的原始设计意图、丢失的类型信息、没有覆盖到的行为,不会因为接了 MCP 就自动回来。
源码没了,调查不一定结束。只是接下来每往前走一步,都更需要知道:这一步,有什么依据。
资料来源: