ARTICLE · 1157811
光子 AI 芯片大爆发:不取代 GPU,一场从通信、计算到原位学习的架构革命
导读:过去我们讨论光子 AI,总在追问 “光能不能比 GPU 算得更快更省电”。而 2025‑2026 年的一系列重磅科研与产业成果告诉我们,故事早已改写。光子芯片不再只是做矩阵乘法的实验玩具,它可以跑大模型、片上训练、原位学习,甚至拥有记忆。但产业落地的第一站,并不是 “光子 GPU”,而是光互连。一场电子与光子融合的 AI 架构变革,正在真实发生。
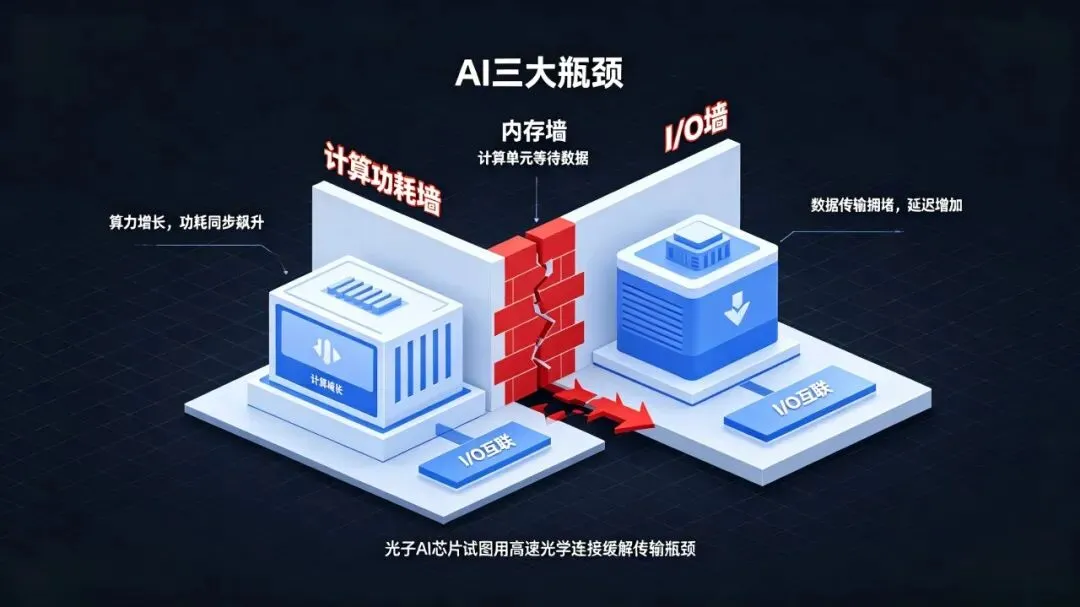
近几年 AI 大模型疯狂迭代,GPU 算力一路狂飙,但整套系统却撞上了三道绕不开的高墙:计算功耗墙、内存墙、I/O 墙。很多时候功耗不是耗在模型运算本身,而是无休止的数据搬运:参数、KV Cache、梯度在 GPU、HBM、集群节点之间来回流转,电互连的带宽、功耗、距离短板被无限放大。
光子技术,被视作破解困局的关键钥匙。但绝大多数人对光子 AI 芯片的认知,还停留在 “用光彻底干掉 GPU” 的想象里。事实上,无论是《Nature》系列的前沿论文,还是英伟达、Marvell、一众初创企业的产业动作,都指向一个完全不同的现实:全光通用 GPU 短期不会到来,真正的未来,是电子‑光子异构融合的全新 AI 计算体系。
一、分清三条技术路线:短期看互联,中期看混合计算,长期看全光体系
市面上五花八门的 “光子 AI”,其实分属三条完全不同的赛道,发展成熟度天差地别。
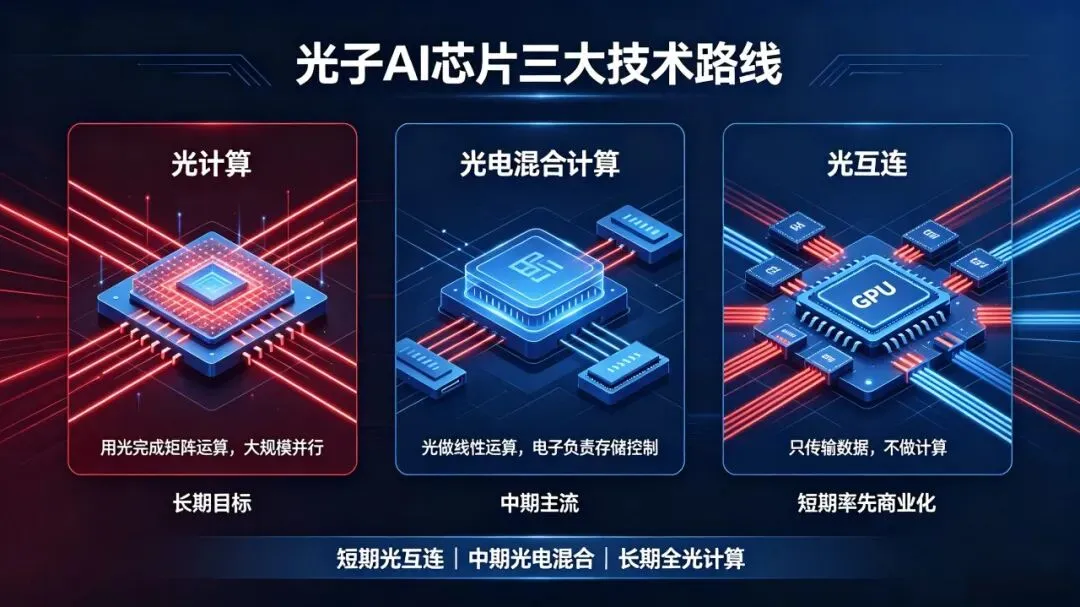
✅ 路线 1:纯光计算 —— 用光直接完成运算
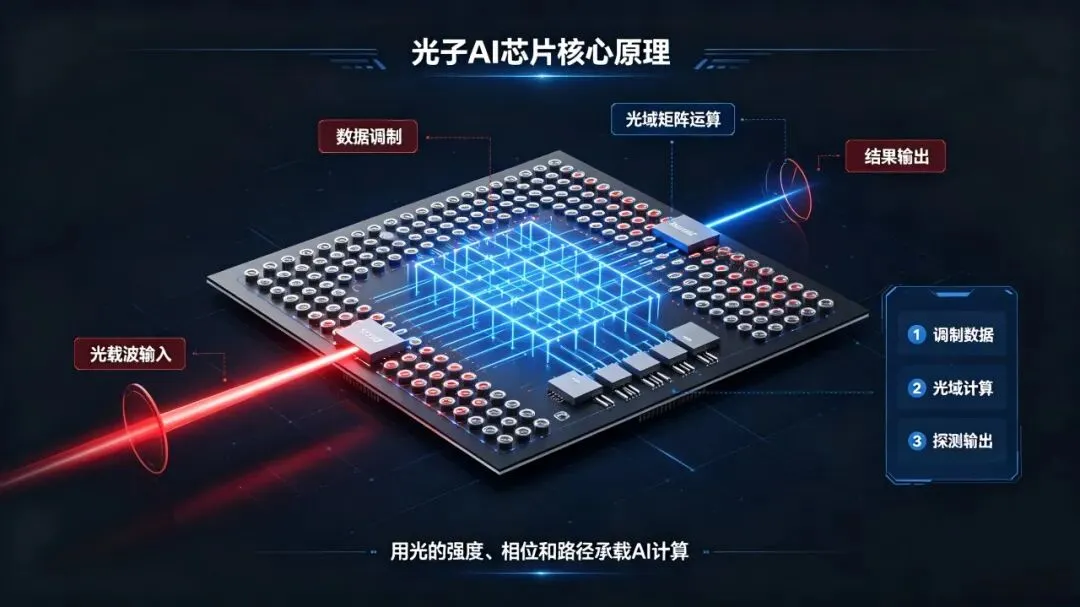
神经网络的核心是矩阵向量乘法。光子依靠干涉、衍射、相位、振幅、波长等物理特性,光在传播的过程中就直接完成矩阵变换。MZI(马赫‑曾德尔干涉仪)、微环谐振器、衍射结构,就是这套系统里的 “光学乘法器”。
优势是天然大规模并行;短板同样突出:光很难存储,难以实现高精度数字逻辑,非线性运算实现难度很高。
✅ 路线 2:光电混合计算 —— 现阶段最现实的落地方向
光负责大规模线性矩阵运算,电子承担存储、控制、非线性运算、数字接口和高精度计算,不完全抛弃成熟的 CMOS 工艺。
Lightmatter、Lightelligence、Lumai、Q.ANT 等主流光计算创业公司,产品本质都属于光电异构混合架构。
✅ 路线 3:光互联 / Optical I/O—— 最先大规模商业化的赛道
它并不运行神经网络,只解决数据搬运问题:GPU 与 GPU、GPU 与 HBM 内存、Chiplet 与 Chiplet、服务器与服务器之间高速数据传输。
二、AI 为什么刚好把光子技术推到产业临界点?
大模型时代,算力瓶颈早已不只是 “算得慢”,搬数据的开销,正在超过计算本身。光子的特性恰好对症下药:
超高并行能力:单根波导 / 光纤依靠波分复用 WDM 可以同时传输多路波长,空间、偏振、相位都可以拓展并行维度; 高速长距离优势:电互连速率越高、距离越远,损耗和功耗会急剧恶化;光纤则适配机架间、集群间超高速交换; 和线性代数天生匹配:光的干涉衍射本身就是线性变换,矩阵乘法不需要像电子那样逐个晶体管完成累加。
当然光子并非万能:光信号难以留存存储、精确数字逻辑难做、非线性运算困难。所以行业主流判断:未来竞争力最强的架构,一定不是纯光芯片。电子管记忆、控制与高精度逻辑,光子管大规模矩阵运算与高速数据流转。
三、科研范式彻底转向:从 “证明光能算”,到 “真实 AI 全链路跑通”
就在两三年前,大量光子神经网络论文还局限在 MNIST 手写数字识别这类小型测试任务。纸面 TOPS/W 能效数据再惊艳,也跑不动真实大模型。
而从 2023 开始,研究重心彻底切换。不再回答 “光能不能做神经网络”,而是攻坚五大现实命题:能不能跑真实 AI 业务?能不能线上训练?能不能容忍制造误差?能不能拥有记忆状态?能不能规模化落地?
👉 跨越第一关:光子芯片成功运行真实 AI 大模型
2025 年 Lightmatter 登上《Nature》的研究,是标志性转折点。
过去很多光计算系统,纸面性能华丽,一旦运行深度网络,相位噪声、热漂移、工艺缺陷带来的误差层层叠加,精度直接崩盘。这套光子 AI 处理器,证明光子硬件可以稳定执行 ResNet、BERT、强化学习等现实 AI 任务。光子计算正式走出玩具实验,迈向实用化。
👉 跨越第二关:从 “GPU 训练、光子推理”,到光子芯片自己做训练
传统光子系统模式:GPU 完成全部训练,导出权重参数,再把参数配置到光子芯片,光子只做推理。
2026 年 3 月诺基亚贝尔实验室实现片上反向传播,把线性运算、非线性激活、梯度计算全部放到光子芯片内部完成。光子加速器不再只是单纯推理协处理器,进化为可参与训练的计算介质。
👉 2026 年最大科研突破:INSPIRE 原位物理学习
即便实现片上训练,还有一道拦路虎:现实光子芯片永远不完美。制造偏差、温度漂移、器件老化、散射耦合,很难用软件建立 100% 精准的数字仿真模型。
INSPIRE(原位物理梯度下降)给出颠覆性思路:不去模拟芯片,直接读取真实物理芯片内部的光场,拿到真实硬件的梯度来更新参数。
✅ 矩阵相对误差低至 0.26%;
✅ 不受网络拓扑限制,适配多种光子硬件;
✅ 支持原位元学习,实现最高 251 倍模型压缩,136 倍任务训练加速。
这标志着光子计算,正式从「Photonic Computing 光子计算」迈向Physical Learning 物理学习。
演进链路:软件 GPU 训练→光子仅推理 → 光子芯片参与片上训练 → 直接采集硬件物理梯度 → 基于芯片真实物理状态原位学习
👉 光子拥有记忆:补上光计算最大短板
光跑得极快,但信号转瞬即逝,很难存储,这一直是光计算的致命弱点。
2026 年 FLARE 架构给出解法:融合光电机制,单芯片集成7378 个光子记忆神经元,既有 GHz 级高速短期响应,还拥有 7.45 秒长期记忆。硬件原型已经用于无人机自主导航。
这一步的意义远高于算力数字:它向着光子感‑存‑算一体迈出关键一步,未来不再需要反复把数据在存储单元和计算单元之间来回搬运。
👉 解决规模瓶颈:加宽、立体,而不是一味加深
光子网络不能无限堆叠深度,光路越深,损耗、误差、控制难度同步飙升。学界走出两条新路:
光子 MoE 专家网络:不加深,做加宽。单片集成多个光学专家子网络,根据任务动态路由,图像分类准确率 97.1%,削减 67% 数字参数开销; 3D 光子神经网络:把光路向垂直空间拓展,解决二维波导交叉、IO 数量受限问题。
未来大规模光子系统,更可能是「光子 Chiplet + 三维光子集成 + 多计算核心」的组合。
四、科研百花齐放,产业落地却优先爆发在光互连
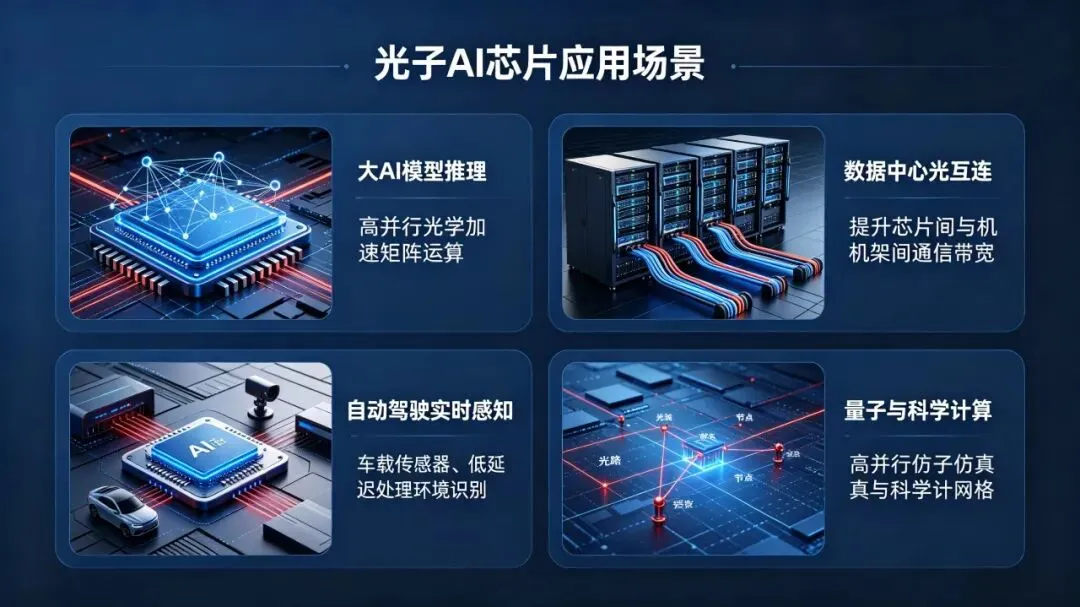
实验室目光聚焦 “用光做计算”,商业资本优先解决的却是 “怎么让成千上万 GPU 高效对话”。光子产业落地逻辑:先做芯片之间的数据传输,再逐步渗透进芯片内部计算,纯光 GPU 不是起点。
1)英伟达:CPO 光互连进入量产,重构 AI 工厂基础设施
英伟达 Vera Rubin 平台正式将 Spectrum‑X 光子以太网纳入架构,采用 CPO 共封装光学方案,光学引擎与交换芯片紧密封装,200Gb/s SerDes。2026 年已经量产,相比传统光模块网络功耗效率提升 5 倍。
这是明确的信号:光子不再是边缘外设,成为 AI 算力集群核心基础设施。
2)Marvell 收购 Celestial AI:光互连升级为核心半导体 IP
2026 年 2 月 Marvell 收购 Celestial AI,重点不是光计算,而是 Photonic Fabric 光子互联底座,目标解决大规模 AI 集群的带宽、功耗瓶颈。
半导体巨头用收购表态:光互连已经是下一代 AI 系统不可或缺的核心资产,而不是简单通信配件。
3)Lightmatter:从光计算芯片,转向光互连平台
最早以光计算出圈的 Lightmatter,商业重心明显向光互连迁移。Passage L20 光互连产品单向带宽可达 6.4Tbps,复用单根光纤双向传输。
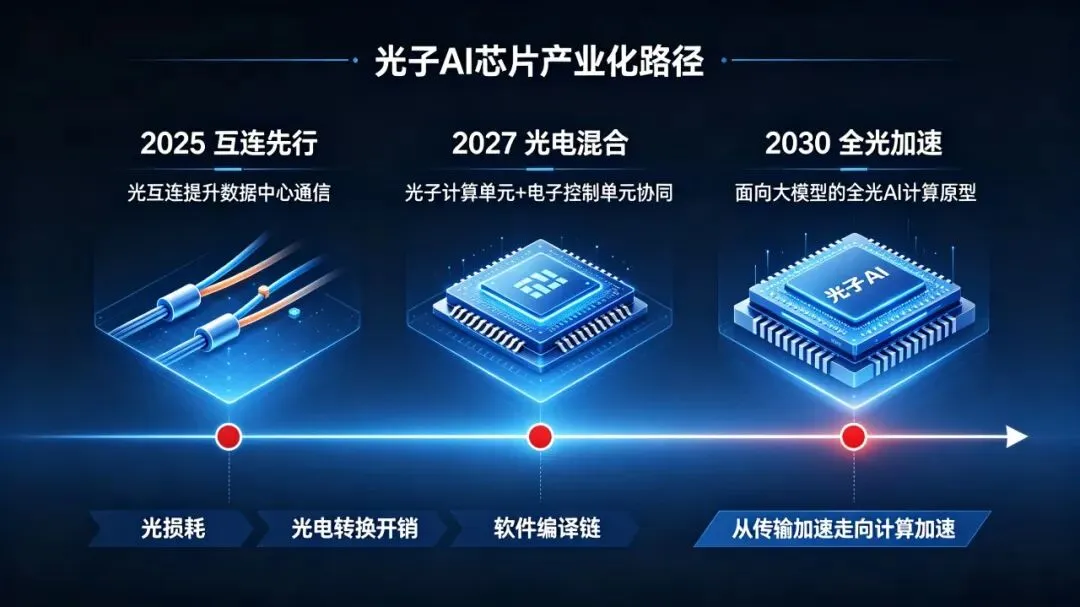
它给出极具参考价值的落地路径:Interconnect 光互连 → Optical I/O 光输入输出 → Photonic Interposer 光子中介层 → Photonic Compute 光子计算。
4)Ayar Labs:专注 Optical I/O,改造 GPU 对外接口
不重做 GPU,专注把 XPU 传统电 IO 替换成光 IO。2026 年累计融资达 6.5 亿美元,英伟达、AMD、英特尔、联发科均为战略投资方。行业竞争已经从 “能不能造出样品” 进入大规模制造、封装、量产交付的工程阶段。
5)商用光计算推理硬件,已经走出实验室
与此同时,真正参与 AI 矩阵运算的商业化产品也陆续问世,全部走异构加速器路线,兼容现有服务器生态。
Lightelligence:PACE2 加速卡,PCIe 标准形态,128×128 可配置光学矩阵,基于 3D‑TSV 先进封装,直接插在普通服务器使用; Lumai(牛津孵化):Iris 系列推理服务器,可以原生跑 Llama‑8B/70B 大模型。光学张量引擎承担矩阵运算,主攻大模型 Prefill 密集计算阶段,宣称最高 90% 能耗下降(仍待第三方基准测试验证); Q.ANT:基于薄膜铌酸锂材料,用电场调制替代热调制,降低热串扰。标准 19 英寸机架服务器,光子 NPU 已经可以运行扩散模型、xLSTM 时序循环网络。
下一个主战场:GPU 与内存之间的光通路
光互连的演进路线正在持续向内渗透:服务器之间 → GPU‑GPU 互联 → 封装内 Chiplet 互联 →GPU 与 HBM/DRAM 内存直连。代表项目:Volantis、英特尔 OCI 光互连 Chiplet,目标破解当下 AI 的一大痛点:不是 GPU 算不动,而是内存喂不饱算力。
五、理性看待光子算力:别被纸面 TOPS/W 迷惑,GPU 不会被快速淘汰
很多论文给出惊人的 TOPS/W 能效,很容易让人产生 “光子马上替代 GPU” 的错觉。
一套完整光子 AI 系统链路是:激光器 → DAC 数模转换 → 光调制器 → 光子矩阵网络 → 光电探测器 → TIA 放大器 → ADC 模数转换 → 数字存储与控制。
激光器、ADC/DAC、温控、控制芯片、内存读写都会吃掉大量功耗开销。只看中间光 MAC 运算,能效数据很漂亮;统计整套端到端服务器系统,优势会大幅缩水。
✅ 评估光子 AI 硬件,不能单看 TOPS/W,更要关注:tokens/s、tokens/J 推理能效、模型精度、整机功耗、ADC/DAC 与光源开销、硬件实际利用率。
也正是这个原因,INSPIRE、FLARE 这类前沿研究的价值极高:它们不再单纯优化光学矩阵,而是直面整套系统里转换开销、工艺误差、训练、存储等现实难题。
✅ 当前光子 AI 尚未解决的六大核心难题
精度与稳定性:模拟光计算受温度漂移、激光噪声、工艺偏差干扰;原位学习是缓解该问题的重要方案; 非线性运算短板:ReLU、Softmax、归一化等操作光并不擅长,光电混合架构是短期必然选择; 光子存储能力不足:FLARE 实现神经元记忆,但距离 TB 级大模型参数存储仍差距巨大; 数模‑模数转换开销:频繁的光域‑数字域转换,可能抵消光计算带来的能效收益; 软件生态鸿沟:CUDA 构建的完整开发生态壁垒很高;光子硬件必须做到对开发者透明,兼容现有框架 API; 制造与封装工程挑战:CPO 时代,激光器、光子芯片、ASIC、光纤耦合、散热、良率修复,更多属于半导体工程难题,不只是实验室光学创新。
六、未来 5‑10 年:不会诞生光子 GPU,而是电子‑光子融合新体系
综合科研与产业现状,光子 AI 最可能的未来,并不是一颗光子芯片颠覆英伟达。
📌 未来的 AI 硬件形态:GPU/XPU + HBM 内存 + CMOS 电路 + 光子矩阵引擎 + 光 I/O + CPO 共封装 + 光子互联网络,异构融合系统。
光子的终极命题,不是取代,而是边界内移。回看光子 AI 的演进,我们可以看到两条并行向前的主线。
科研线:跑通真实 AI 模型 → 片上反向传播训练 → 原位物理梯度学习 → 光子神经元实现记忆;
产业线:光模块 → CPO 共封装 → 光 IO 接口 → Chiplet 光互连 → GPU‑内存光链路 → 光电混合计算。两条路径终将交汇。
过去大家总在争论:光子芯片什么时候干掉 GPU?2026 年的答案已经逐渐清晰:光子大概率不会彻底取代电子计算。真正发生的,是电子与光子的分界线,一步步向芯片内部迁移。
当光子技术同时渗透进互联通信、矩阵计算、存储、硬件原位学习四大维度,光子 AI 才不再是一款特色加速器,而是一套全新的 AI 计算架构。这不是一场 “光打败电” 的零和博弈,而是电子与光子携手,共同破解大模型时代算力困境的全新变革。