ARTICLE · 1157913
给 AI 挂了 20 个插件,它反而变蠢了:硅谷正在疯传的「Agent 减法铁律」
硅谷一线架构实测 · 编号 EP19
过去一个月,很多技术负责人都在抱怨同一个怪象:刚开始只给 Claude Code 或 Cursor 挂 2 个工具时,它聪明得像个硅谷资深架构师;可一旦贪心把 GitHub、Jira、数据库、浏览器等 20 个 MCP 插件全挂上去,它突然就开始胡言乱语、乱调工具,连最简单的指令都执行错。
01.为什么插件越多,大模型越「降智」?
很多人把大模型的上下文窗口(Context Window)当成了无限容量的硬盘,以为支持 200K 甚至 1M Token,就能把所有工具说明书一股脑全塞进去。但在真实生产环境里,「上下文容量」不等于「有效注意力预算(Attention Budget)」。
当你把 20 个 MCP 插件挂载为常驻工具时,哪怕你只是让 AI 改一行代码,系统在每一轮对话底座都会先把这 20 个插件、上百个函数的 JSON Schema 说明书(动辄 30,000+ Token)强行灌进提示词里。
结果就是:真正关键的业务代码和指令被淹没在海量无用的工具定义噪音里。信噪比(SNR)断崖式下跌,模型不仅每一轮都在白烧几万 Token 的过路费,还会因为工具描述相似而频繁调错接口。
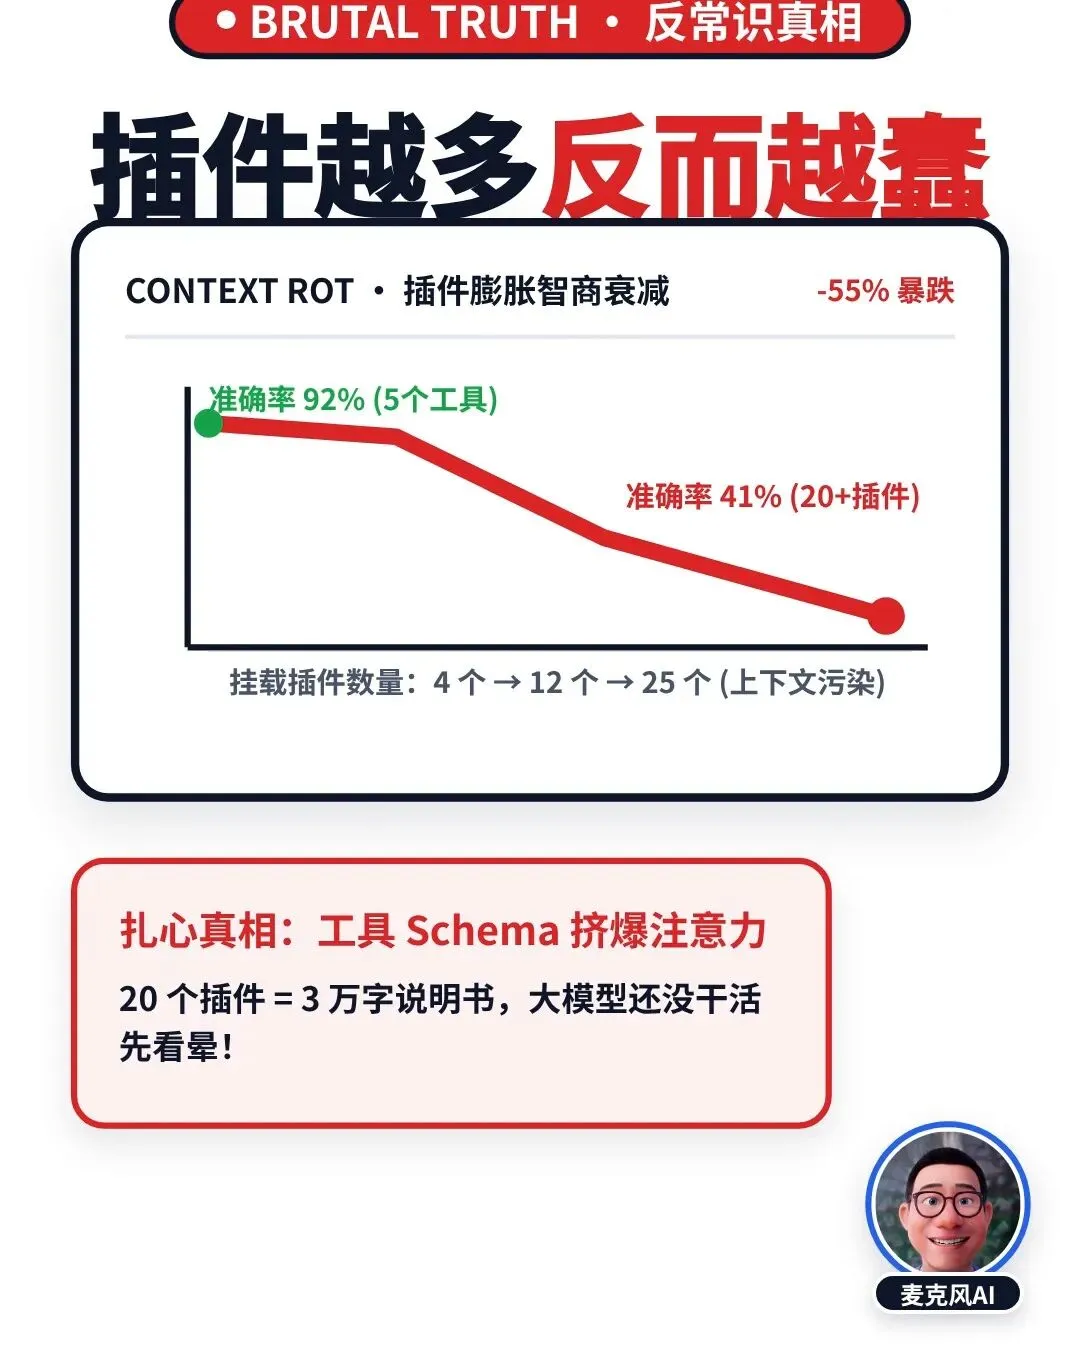
▲ 常驻插件超过 5 个后,大模型有效注意力被 Schema 噪音吞噬
02.破局第一刀:常驻 MCP 严控 ≤ 5 个,把专业能力改成「懒加载 Skill」
硅谷最近在 GitHub 上 3 天狂揽 10 万星的高信噪比 Agent 架构,核心只做了一件事:给常驻工具做极致的减法。
第一条死规矩:全局常驻的底层工具(如文件读写、Bash 终端、全局搜索)永远不超过 5 个。把所有低频、垂直的插件全部从常驻列表里卸掉。
第二条死规矩:把特定场景的复杂工作流(比如发版检查、数据库迁移、财务对账、UI 走查)封装成独立的 Skill(按需技能包)。平时上下文里只放一行 30 字的目录简介;只有当任务真正触发该场景时,Agent 才动态读取对应的 `SKILL.md` 说明书。用完即焚,绝不污染主干上下文。
▲ 常驻底座做减法(≤5个)+ 专业 SOP 技能包按需懒加载
03.终极提效:跑通 3 次的固定动作,立刻固化为「0-Token 脚本」
还有一个最容易被忽视的吞金兽:让大模型每次都现场思考怎么拼接固定命令。比如拉取日志、清洗固定格式的表格、或者打包部署,如果每次都让大模型靠推理去一步步试错,既慢又容易中途翻车。
真正的「一人抵十人」超级个体怎么做?凡是已经跑通 3 次以上的确定性操作,立刻让 AI 把它写成一行独立的 Python 或 Shell 脚本,挂进 Skill 的 `scripts/` 目录里。
下次再遇到同类任务,大模型不需要耗费任何推理 Token 去重新发明轮子,直接一键调用脚本拿结果——执行耗时从 3 分钟缩短到 2 秒,Token 消耗直接归零,准确率 100%。
★高信噪比 Agent 组装三大铁律(建议截图保存)
建议直接长按保存下方高清总表,发到你们的研发群或业务群对照自查:
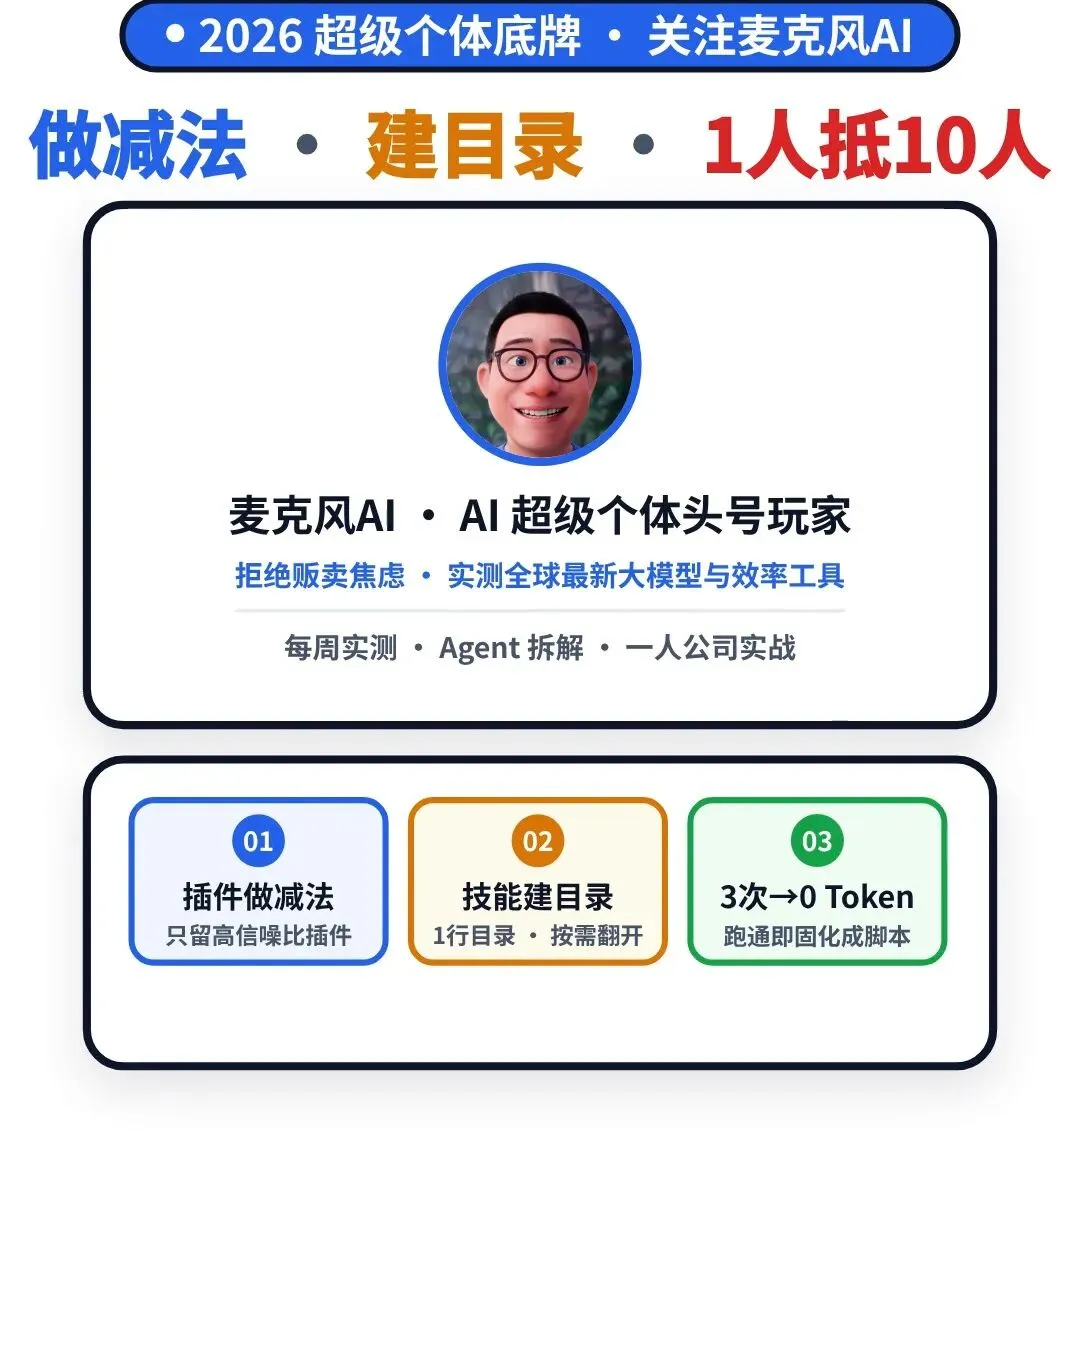
铁律一 · 常驻工具做减法:全局常驻 MCP 工具严控 ≤ 5 个,砍掉一切低频插件,把上下文信噪比拉满。
铁律二 · 专业 SOP 懒加载:将垂直领域经验写成独立 Skill(目录索引 + 按需加载),平时零占重,用时高精度。
铁律三 · 高频动作脚本化:跑通 3 次的固定流程直接固化为 0-Token 本地脚本,让 AI 调脚本而不是每次重新推理。
🎙️ 麦克风AI · AI 超级个体头号玩家
拒绝贩卖焦虑 · 实测全球最新大模型与效率工具。如果这篇内参对你有启发,欢迎点赞、在看、转发到工作群。
💡 关注公众号【麦克风AI】,后台私信回复【Agent】,获取本篇配套高清架构图与历史实测合集。