ARTICLE · 1158419
langgraph4j原理源码分析图 II图编译
简介
langgraph4j是java技术栈ai agent框架,深入掌握其源码与原理,指导agent的开发,重构/改造框架,增加特性,快速定位和修复bug,发布私有版本
系列内容:
> 架构,包括逻辑架构,运行架构,集成架构
> 状态图
>> 状态和序列化
>> StatGraph分析
>> 推理框架
> 编译图
> 执行图
>> 检查点
>> aync-generator
>> 执行分析
>>> 中断/恢复
>>> 取消执行
> agent和集成
>> 简单agent
>> 多agent
> 观测
> studio
本文分析图编译
本文基于langgraph4j v1.8.20
关键词
agent
graph
缩写
spring ai 缩写sa
spring ai alibaba 缩写saa
参考资料
Overview - LangGraph4j langgraph4j官网
mp.weixin.qq.com/mp/appmsgalbum?action=getalbum&album_id=4540202703779627014
spring ai Alibaba原理源码分析,包括spring ai部分
lg4j概览
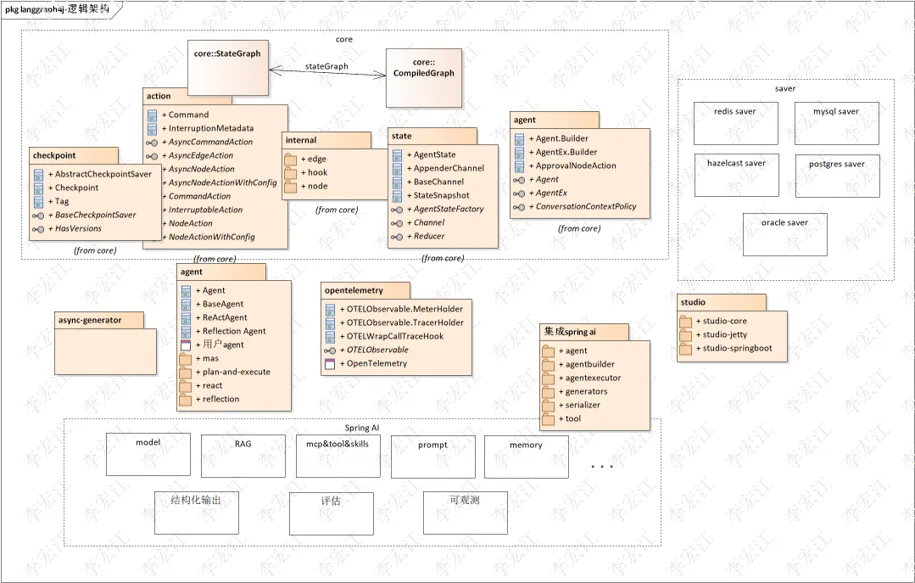
上图 lg4j的逻辑架构图,逻辑架构展示lg4j功能模块,描述其职责,模块通过精密的协作,共同支撑起复杂 Agent 的构建与运行。
逻辑架构解构为以下四个核心域:图编排、执行与状态、基础设施扩展、集成外部能力生态、开发支持
1. 核心编排层:图的蓝图与引擎
StateGraph (状态图):这是开发者构建 Agent 的核心抽象。它代表了整个工作流的“蓝图”,开发者在这里定义有哪些节点(Node)以及它们之间的流转规则(Edge)。
CompiledGraph (编译图):当 StateGraph 被构建完成后,经过 compile() 方法转化而来。编译图重整了状态图的数据结构,支持高效的图执行;编译图包含了流执行逻辑、状态机引擎和调度策略的“可运行实例”。
2. 执行与状态层:原子动作与数据流转
3. 基础设施扩展层:持久化、异步与可观测
4. agent,agent有两部分,core内agent包是lg4j提供; core外的agent框架,spring ai alibaba移植,提供完整的agent框架,也包括基于core内agent重构的agent builder组件
5. 外部能力生态层:AI 核心能力
这一层是LangGraph4j 与 AI 生态对接。
- Spring AI
作为底层的能力供给层,Spring AI 提供了 Agent 所需的原子能力,包括 LLM model(大语言模型)、RAG(检索增强生成)、prompt(提示词工程)、memory(长期记忆)、mcp&tool&skills(工具调用与技能扩展)等。 - LangGraph4j
也集成了langchain4j
5. 开发工具
Studio (可视化开发工具):lg4j的Studio模块提供了一套完整的可视化调试和开发界面,让开发者能够直观地看到图的执行路径和状态流转,极大地降低了复杂 Agent 的开发门槛。
graph
lg4j是workflow框架,以图的结构,节点,边构建处理流程,节点执行动作实现逻辑,边决定下一个节点。agentic是另一种模式,整个流程大模型自主编排,agentic省心省事,但同时agentic容易失控,纯粹看大模型心情,因此,目前比较好的方案,主体使用flowable,需要的时候使用agentic节点。
在lg4j, agent的推理框架映射成graph,以图的节点承载执行逻辑,边决定下一节点,支持检查点保存执行状态,实现执行的暂停和恢复
编译图
上篇分析了状态图,状态图是图的结构,目的是为了方便构建图;而编译图数据结构,目的是为了高效执行
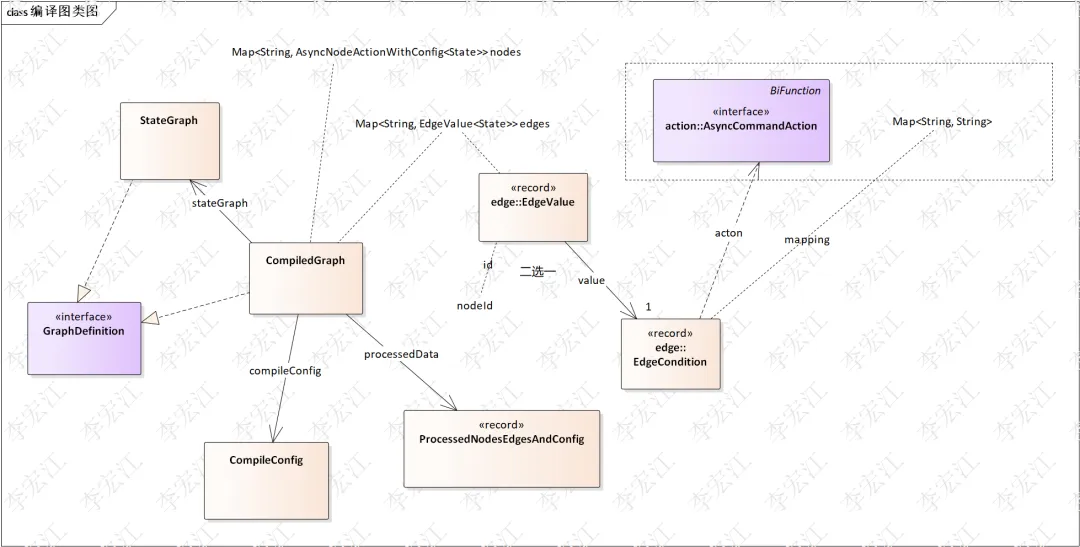
上图是编译图类图,编译把整个图,包括子图的数据结构转换为扁平化的邻接表结构。并行分支,使用并行节点,节点内处理并行,执行器无需处理并行。
nodes 图的节点集,类型Map<String, AsyncNodeActionWithConfig<State>>
edges 图的边集,类型Map<String, EdgeValue<State>>
结构是变种的邻接表,与正常邻接表不同,编译图有默认起始节点START,节点Id获取EdgeValue计算出后续的连接的节点
EdgeValue: 封装了边的信息,二选一
字符串: 节点的id,简单路由,指向一个节点 EdgeCondition: 条件 EdgeCondition: 条件,决定走哪条边。 AsyncCommandAction: 返回命令 (Command)。 动作 (acton): 条件的判断逻辑 映射关系 (mappings): 条件和节点的映射关系集,例如,X:_x_, EdgeCondition返回‘X’,边走’_x_’节点
下面分析编译的原理和源码
扁平化邻接表
ProcessedNodesEdgesAndConfig 负责扁平化状态图数据结构,以示例解释代码逻辑
介绍一下连接表,
'A': ['B'],
'B': ['C'],
'C': []
连接点结构,左是head节点,’A’,’B’,’C’; 右是数组,代表head节点连接的节点
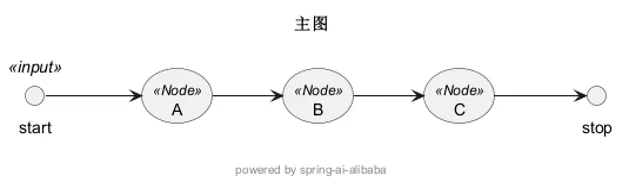
对应的图
进一步,假设B是子图节点,其子图 D->E, D->F,E->G,F->G
ProcessedNodesEdgesAndConfig处理过后
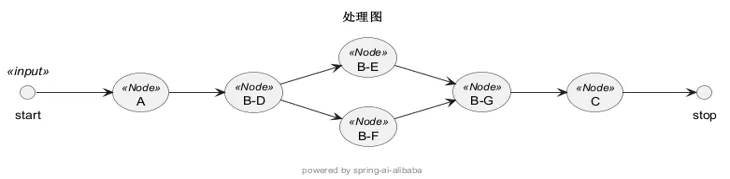
'A': ['B-D'], 'B-D': ['B-E', 'B-F'], 'B-E': ['B-G'], 'B-F': ['B-G'], 'B-G': ['C'], 'C': [] | 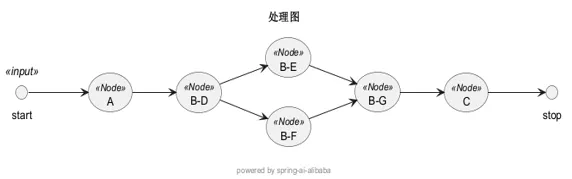 |
图的数据结构扁平化,合并到一个邻接表结构,主图与子图节点(B)的连接重定向到子图的节点,子图节点名称修改,格式%s-%s
最后,返回子图的Node写入到nodes,节点id为key,action为value的map
CompiledGraph.CompiledGraph()
nodes是最终的邻接表head节点集
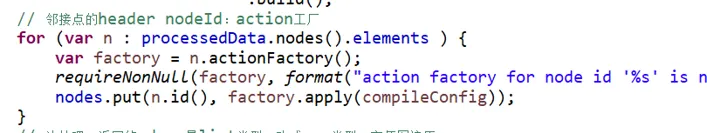
!lg4j子图节点有两种,一种是StateGraph,状态图,另一种CompiledGraph,编译图,只有状态图编译打平,编译图是保留独立的执行,用在多agent的子agent
边和并行处理
ProcessedNodesEdgesAndConfig处理后,返回边(edges)是list,图遍历按节点找边需要遍历list,因此边数据需要转为map,以sourceNodeId为key,List<Edge>类型转为Map<String, EdgeValue>,另外,图有并行分支,编译使用并行节点替代,并行执行action完成在并行节点内完成,不需要执行器介入
下图,边处理分多targes和单个target
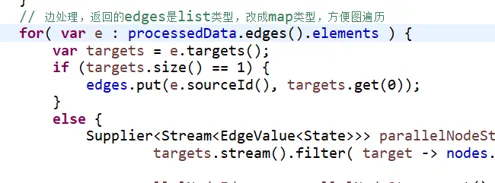
elements是list类型,下面是编译图的数据结构,Map类型
nodes 图的节点集,类型Map<String, AsyncNodeActionWithConfig<State>>
edges 图的边集,类型Map<String, EdgeValue<State>>
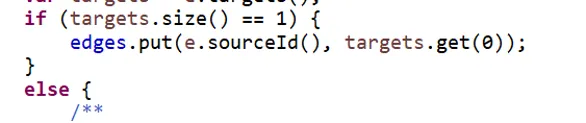
上图,target=1,直接put入edges,虽然target=1,可以是只有一个边,也可以是多个边,当EdgeValue是EdgeCondition,AsyncCommandAction<S>和边mappings,支持多个边选一
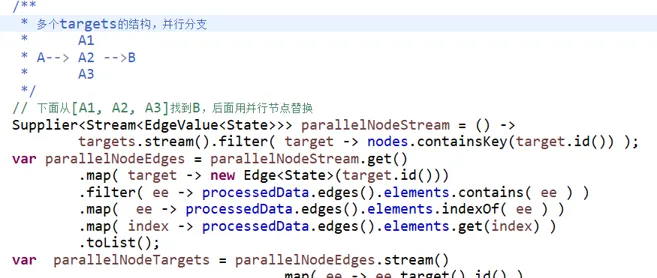
上图 target>1,并行分支,上图的代码逻辑是从A找到[A1, A2, A3],再找到B,分支的聚合点
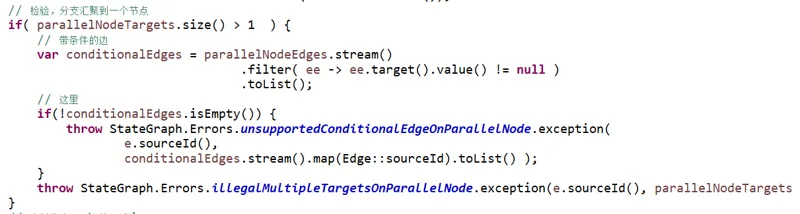
上图 图的约束,规定并行分支只能聚合到同一个节点,如上图B,否则报错illegalMultipleTargetsOnParallelNode
还有一个约束,分支的边的值类型不能是条件,也就是只能是字符串,nodeId
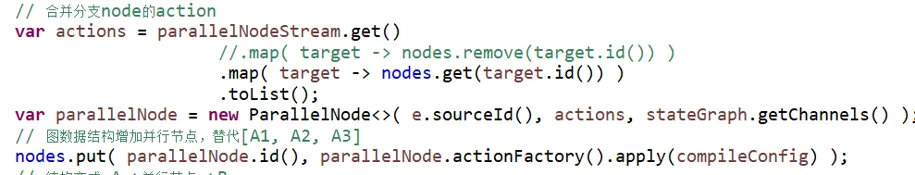
上图 并行分支action合并到并行节点执行,并行节点写入nodes
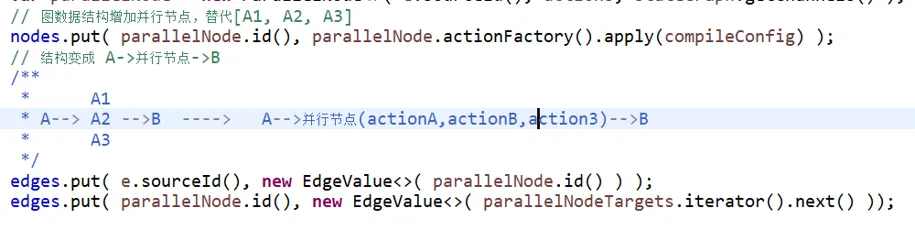
原分支节点前后节点连到新的并行节点,到此图结构编译完成
总结:
编译前
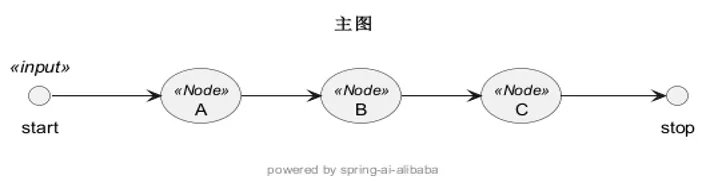
其中节点B是子图
编译中,扁平的邻接点
编译后
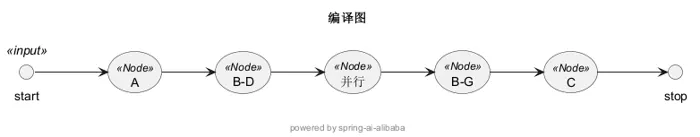
上图是示例编译后的图,可以理解为是一个”降维”的处理,”摆平”多层的主图子图结构,”摆平”并行处理,降低执行器复杂度,提高执行效率