ARTICLE · 1158409
胃癌T分期AI|npj Digit Med(IF=18.0)中国医科大学等多中心CT研究:不用手工勾画,术前判断T1–T4,并显著提高放射科医生分期一致性
胃癌术前分期,尤其是 T分期,一直是临床决策里的关键一步。
同样是胃癌,T1、T2、T3、T4对应的治疗策略并不一样。
T1期患者,如果符合条件,可能考虑内镜下切除或直接手术;
T3、T4这类局部进展期患者,很多时候需要考虑新辅助治疗或围手术期治疗;
T4如果侵犯邻近器官,还会影响手术方式、切除范围和术前沟通。
所以,术前能不能把胃癌侵犯深度判断清楚,直接关系到治疗路径。
问题是,临床上这件事并不容易。
增强CT是胃癌术前评估的常规检查,但CT判断T分期有明显主观性。胃壁层次在CT上没有内镜超声那么清楚,T2和T3之间的边界有时候很模糊,浆膜侵犯也经常不容易判断。
内镜超声对早期胃癌有优势,但也依赖操作者经验,遇到肿瘤较大、位置靠近贲门或病变形态复杂时,准确性也会下降。
npj Digital Medicine 发表了一篇来自中国医科大学肿瘤医院、辽宁省肿瘤医院、中国医科大学盛京医院、浙江省肿瘤医院等团队的研究:
Interpretable deep learning for multicenter gastric cancer T staging from CT images
这篇文章开发了一个CT深度学习模型:
GTRNet
全称为:
Gastric Cancer T-stage ResNet Network
它要做的事情很直接:
用常规门静脉期增强CT,自动判断胃癌T1、T2、T3、T4分期。
这项研究纳入了 1792例病理证实的胃癌患者,来自3家三级医院。训练集和内部测试集来自辽宁省肿瘤医院,另外两个外部测试集分别来自中国医科大学盛京医院和浙江省肿瘤医院。
比较重要的是,这个模型不需要医生逐层手工勾画肿瘤。
它使用肿瘤最大横截面的轴位CT图像,经过标准化预处理后直接输入模型。外部测试时,还会把关键层面及其上下相邻层面一起纳入,通过多数投票得到最终病例级结果。
整体结果显示,GTRNet在内部测试和两个外部测试队列中,都保持了较高的T分期预测表现,并且在读片研究中明显优于放射科医生的单独判断。医生在AI辅助后,分期准确率和病理一致性也明显提高。
清璟AI——清北医工交叉团队,擅长AI智能体、大模型、深度学习、机器学习、多模态与多组学等,能够为医学研究者和临床医生提供全方位的支持与创新解决方案。我们拥有顶级科研资源,欢迎咨询!共同探索AI与医学的无限可能,一起发顶刊!
胃癌T分期,为什么一直不好做?
胃癌T分期看的是肿瘤侵犯胃壁的深度。
简单说:
T1:侵犯黏膜或黏膜下层;
T2:侵犯固有肌层;
T3:侵犯浆膜下结缔组织,但没有穿透浆膜;
T4:穿透浆膜或侵犯邻近结构。
从病理切片上看,这些层次当然可以分清楚。
但术前影像并没有那么理想。
CT上医生主要看胃壁增厚、强化方式、浆膜面是否毛糙、周围脂肪间隙是否模糊、有没有邻近器官受侵等征象。很多时候,T2和T3之间只差一层很薄的浆膜下结构,影像表现会非常接近。
临床上真正容易纠结的地方,也正是这些边界状态。
如果把T2低估或高估,治疗方案可能变化;
如果把T3/T4漏掉,患者可能错过新辅助治疗机会;
如果把早期病变过度判断为进展期,患者又可能接受不必要的治疗。
所以这篇研究的核心问题很实在:
能不能让AI从CT图像里学习胃壁侵犯深度,提高术前T分期的稳定性?
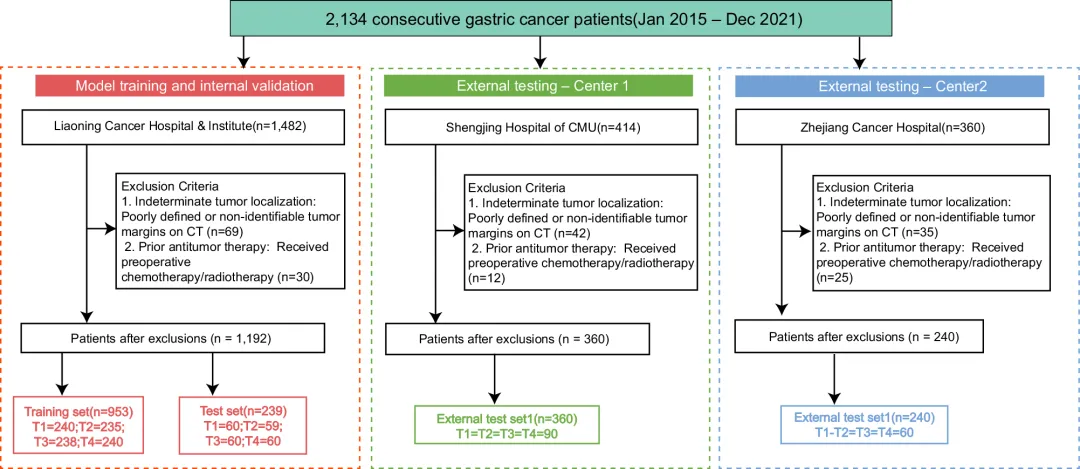 图1|患者纳入流程
图注:研究共筛选2134例连续胃癌患者,最终纳入1792例。辽宁省肿瘤医院数据用于模型训练和内部测试,其中训练集953例,内部测试集239例;中国医科大学盛京医院和浙江省肿瘤医院分别构成两个外部测试集,样本量为360例和240例。
1792例,多中心训练和外部测试
研究纳入的是2015年1月至2021年12月期间接受根治意图手术的胃腺癌患者。
入组条件主要包括:
病理证实为T1–T4胃癌;
术前有增强腹部CT;
术前未接受化疗或放疗;
图像质量满足分析要求。
排除标准包括肿瘤定位不清、CT质量差、资料不完整,以及远处转移导致无法行根治性手术等。
最终队列构成为:
训练集:953例
内部测试集:239例
外部测试集1:360例
外部测试集2:240例
三个中心的CT设备和扫描参数并不完全一样,比如扫描仪、重建层厚、对比剂浓度、注射剂量和门静脉期延迟时间都有差异。
这一点反而更接近真实临床。
如果一个模型只在同一台机器、同一套扫描协议下表现好,意义会有限。多中心数据至少能初步检验模型在不同医院和不同CT参数下的稳定性。
GTRNet怎么工作?
GTRNet基于改良的 ResNet-152。
作者没有直接照搬普通ResNet,而是在早期网络结构中加入了并行的最大池化和中心裁剪分支,让模型同时关注局部肿瘤细节和胃壁周围更大的上下文信息。
模型输入是门静脉期增强CT图像。
训练和内部测试时,每例患者选择一张肿瘤最大横截面的轴位图像。图像经过标准化处理,包括重采样、HU范围归一化、腹部窗设置、N4偏场校正、Z-score标准化等。
外部测试时,为了减少单一层面选择带来的偶然性,作者把关键层面、上一层和下一层共3张图像都输入模型,再用多数投票得到病例级结果。
这个设计比较贴近临床。
因为医生读片时也不会只看一层。虽然文章的模型主体仍然是2D输入,但在外部测试中加入相邻层面,能一定程度上弥补单层面信息不足的问题。
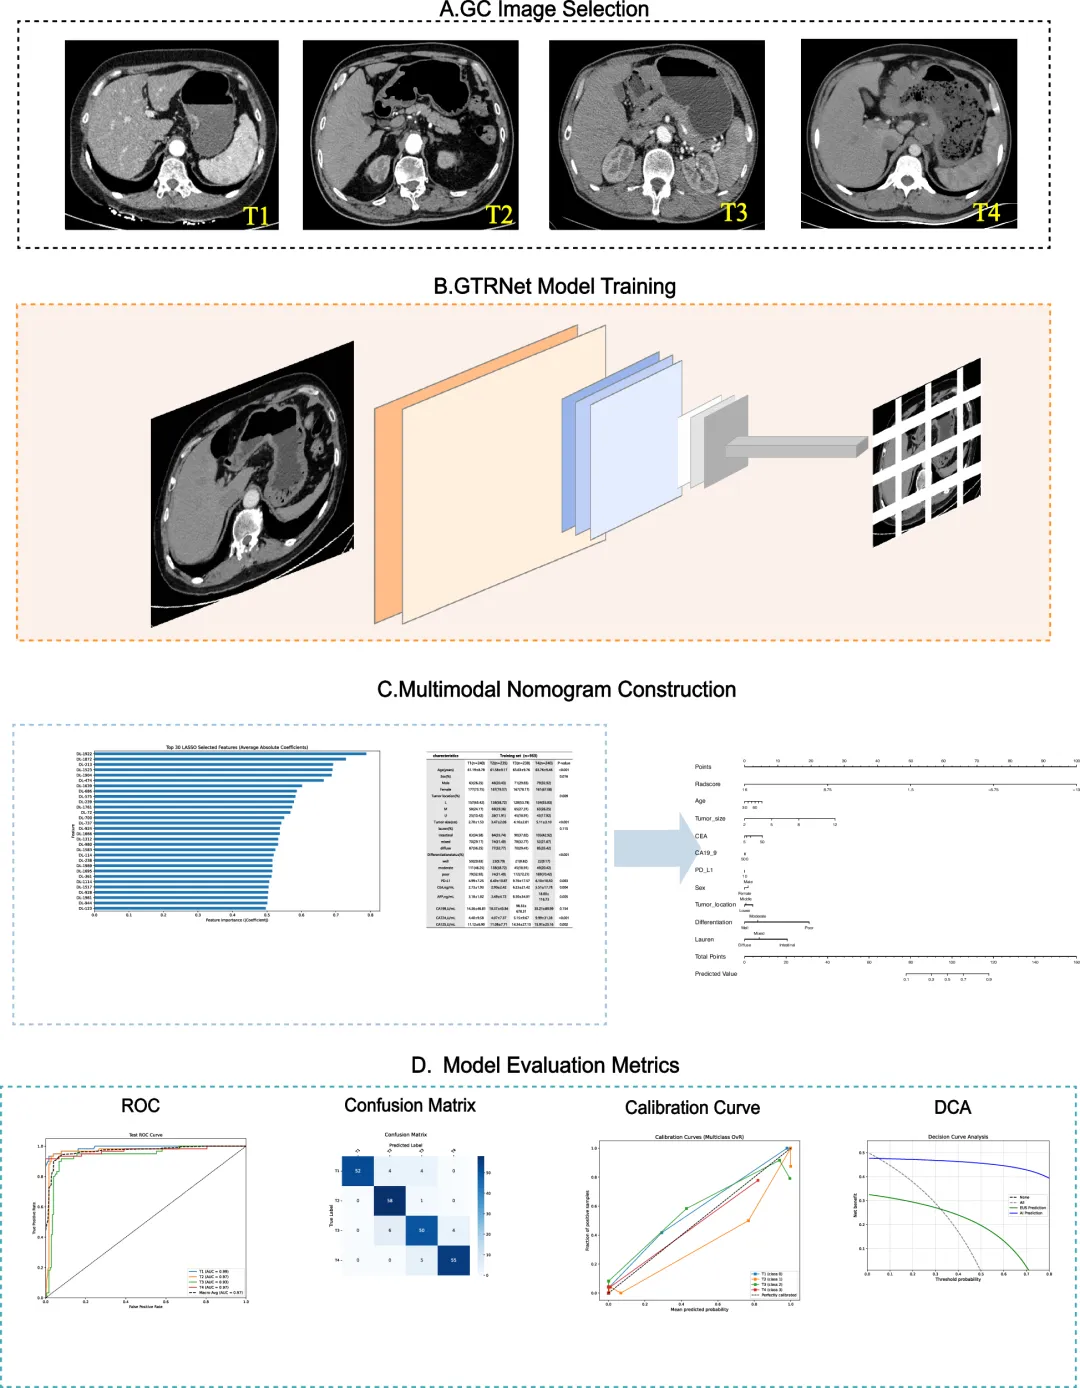 图2|模型整体开发流程
图注:GTRNet使用门静脉期增强CT中肿瘤最大横截面作为输入,基于改良ResNet-152完成T1–T4四分类预测。模型还提取深度学习Rad-score,并与肿瘤大小、分化程度和Lauren分型等变量结合,构建临床-影像列线图。
模型表现:外部测试仍然保持较高准确率
在T1–T4四分类任务中,GTRNet表现比较稳定。
训练集:
准确率 90.1%
AUC 0.98
内部测试集:
准确率 89.9%
AUC 0.97
外部测试集1:
准确率 93.6%
AUC 0.95
外部测试集2:
准确率 86.7%
AUC 0.91
从结果看,第二个外部测试集性能有所下降,但整体仍然保持在较高水平。
这很正常。
不同医院的患者构成、肿瘤位置、扫描协议、重建层厚和图像质量都会影响模型表现。完全不下降反而不太真实。
分期细分来看,模型对T1和T2的敏感度很高。
在外部测试集中,T1敏感度达到 85.0%–99.9%,T2敏感度达到 93.3%–97.8%。
对于临床来说,这部分很重要。
因为早期胃癌和进展期胃癌之间的区分,会影响是否考虑内镜治疗、直接手术或新辅助治疗。
T3、T4的表现也较好,外部测试中T3敏感度为 83.3%–86.7%,T4敏感度为 81.7%–93.3%。
这说明模型不仅能识别早期病变,对局部进展期病变也有一定判断能力。
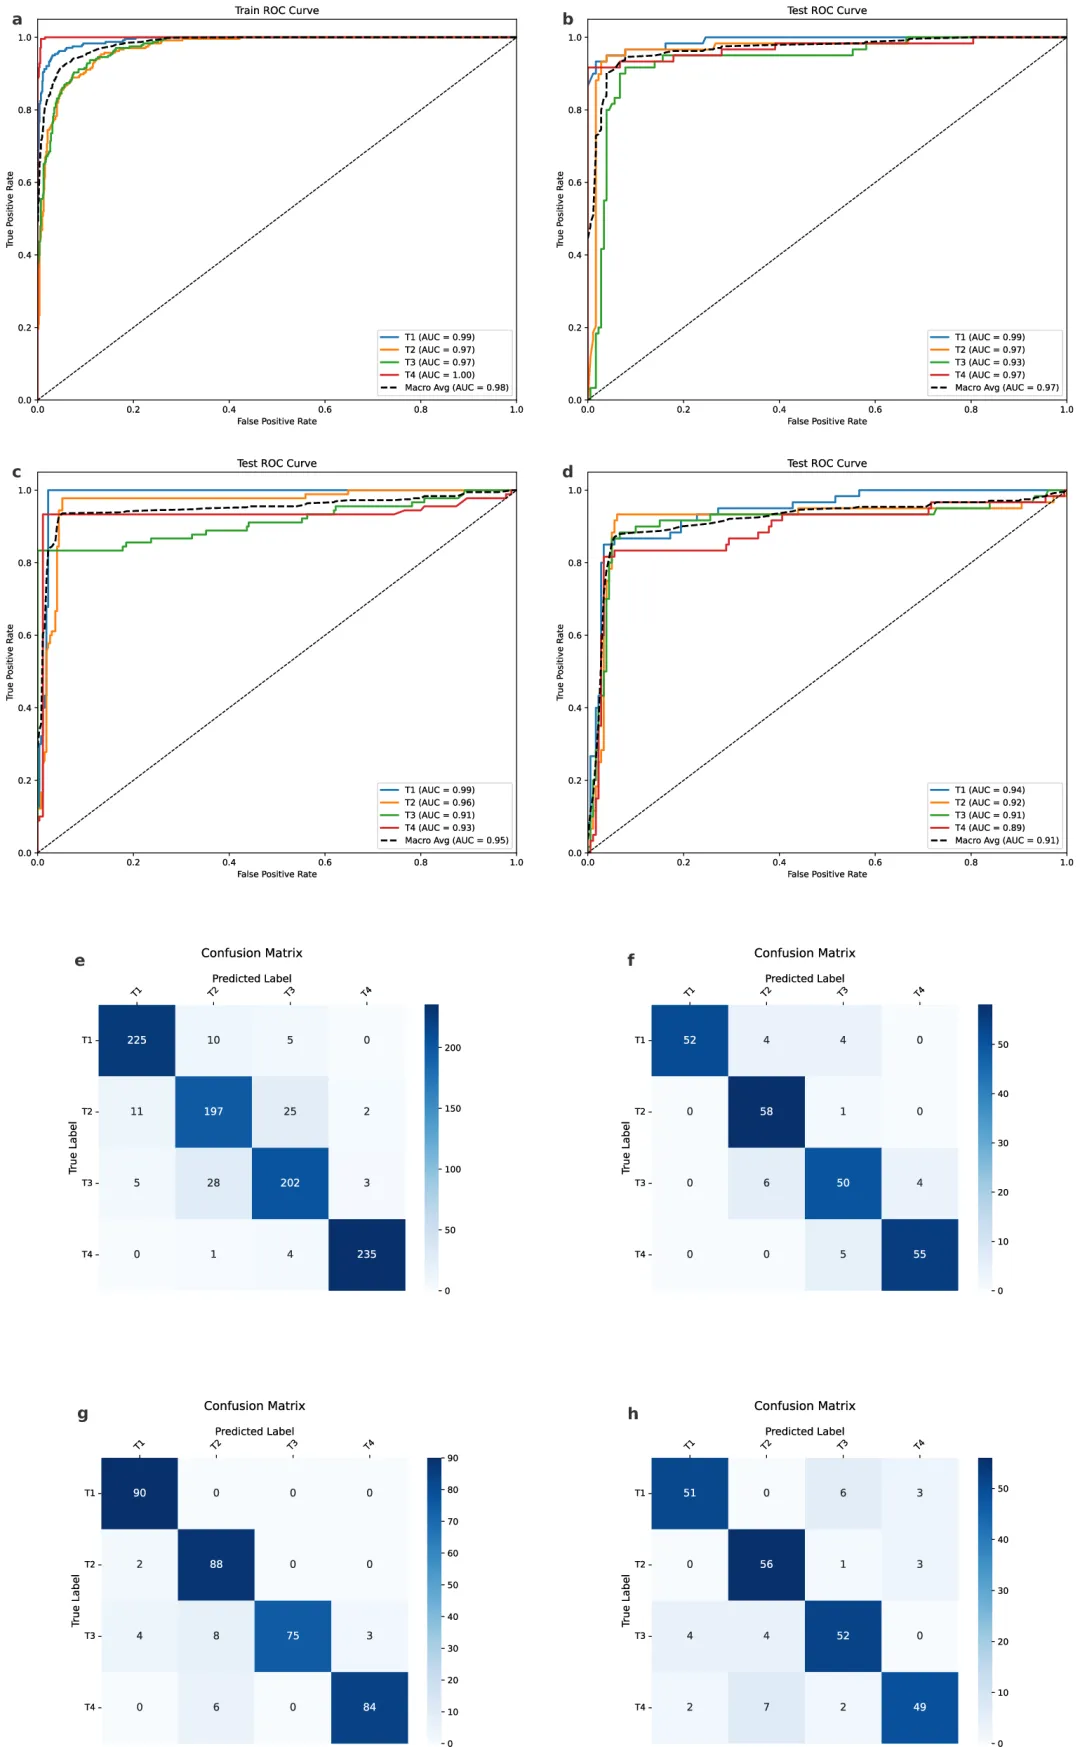 图3|GTRNet在训练集、内部测试集和外部测试集中的表现
图注:模型在训练集、内部测试集和两个外部测试集中均显示较高AUC和较好的四分类准确率。ROC曲线用于展示T1、T2、T3、T4各分期的一对多分类能力;混淆矩阵显示模型主要错误集中在相邻T分期之间。
读片研究:AI明显提高医生分期一致性
这篇文章一个比较实用的部分,是把模型和放射科医生做了比较。
研究邀请了来自多个中心的消化系统影像放射科医生进行T分期判断。
第一阶段,医生只根据增强CT独立判断;
第二阶段,间隔一个月后,医生在GTRNet辅助下重新判断。
结果差异很明显。
GTRNet单独判断的总体准确率为:
Hospital A:92.8%
Hospital B:93.6%
Hospital C:86.7%
医生单独判断的准确率为:
Hospital A:58.4%
Hospital B:59.7%
Hospital C:55.3%
AI辅助后,医生准确率提高到:
85.4%–91.5%
病理一致性也明显提高。
GTRNet与病理T分期的加权Kappa为:
0.87–0.91
医生单独判断的Kappa为:
0.41–0.45
AI辅助后,医生Kappa提高到:
0.83–0.88
这个结果说明,AI不只是自己判断得好,也能帮助医生减少分期差异。
对于真实临床来说,这一点比单纯模型AUC更重要。
因为胃癌T分期本身有主观性,不同医生对同一张CT可能判断不同。AI如果能把医生之间的判断拉到更一致,对治疗讨论和MDT决策会有实际价值。
Grad-CAM:模型到底看哪里?
影像AI最容易被医生质疑的一点,是黑箱。
模型给出一个T3或T4,但它到底看到了哪里?有没有盯着胃外的无关区域?有没有被扫描伪影误导?
这篇文章用了 Grad-CAM热图 来解释模型注意力。
结果显示,不同T分期下,模型关注区域和临床判断逻辑大体一致。
T1病例中,热图主要集中在胃壁内层区域,提示模型关注黏膜和黏膜下层相关改变;
T2病例中,注意力更多覆盖肌层区域;
T3病例中,模型关注浆膜面和胃壁外缘;
T4病例中,热图会延伸到肿瘤与邻近器官的界面,比如胰腺受侵相关区域。
作者还把热图二值化后,与放射科医生手工标注的病灶区域进行Dice比较。
不同T分期Dice系数约为:
T1:0.56
T2:0.59
T3:0.60
T4:0.63
这个数值不能说非常高,但至少说明模型注意力和真实病灶区域有中等程度空间重叠。
更重要的是,模型没有主要关注无关背景,而是集中在胃壁、浆膜面和周围侵犯相关区域。
这对临床接受度很有帮助。
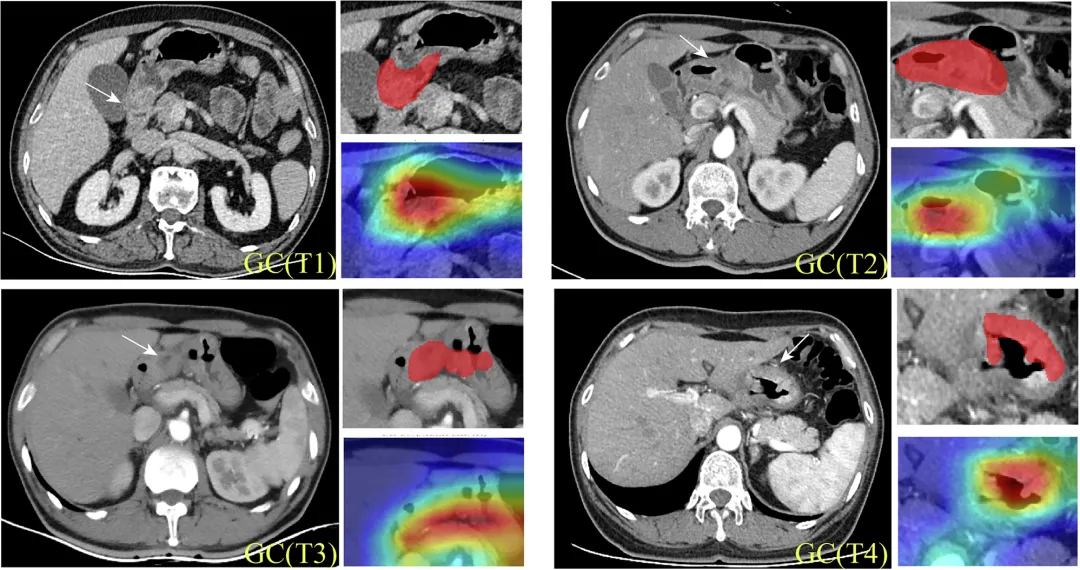 图4|Grad-CAM显示模型关注胃壁侵犯关键区域
图注:图中展示T1–T4代表病例的门静脉期CT图像和Grad-CAM热图。T1病例中模型主要关注胃壁内层;T2病例关注肌层区域;T3病例关注浆膜面;T4病例中注意力延伸至肿瘤与邻近器官界面,提示模型能够捕捉与胃癌侵犯深度相关的影像区域。
列线图:把AI分数和临床病理变量结合起来
GTRNet本身已经能做T分期,但作者又进一步构建了一个临床-影像列线图。
他们从深度学习模型倒数第二层提取特征,计算每例患者的 Rad-score。
然后把Rad-score和几个临床病理变量结合起来:
肿瘤大小 ≥5 cm
低分化
弥漫型Lauren分型
最终建立了一个有序logistic回归模型,用于预测T1、T2、T3、T4的概率。
多因素分析显示,几个变量都和更高T分期相关:
Rad-score每增加1个标准差,OR为 2.39
肿瘤大小 ≥5 cm,OR为 2.00
低分化,OR为 3.16
弥漫型Lauren分型,OR为 2.90
这些结果符合临床直觉。
肿瘤越大、分化越差、Lauren弥漫型,通常更容易提示局部侵犯更深、生物学行为更差。
列线图的意义在于,它不是只给一个AI分类结果,而是把影像特征和临床病理因素放在一起,生成一个更容易理解的概率化工具。
对医生来说,这种形式比单纯“AI判断T3”更容易用于术前讨论。
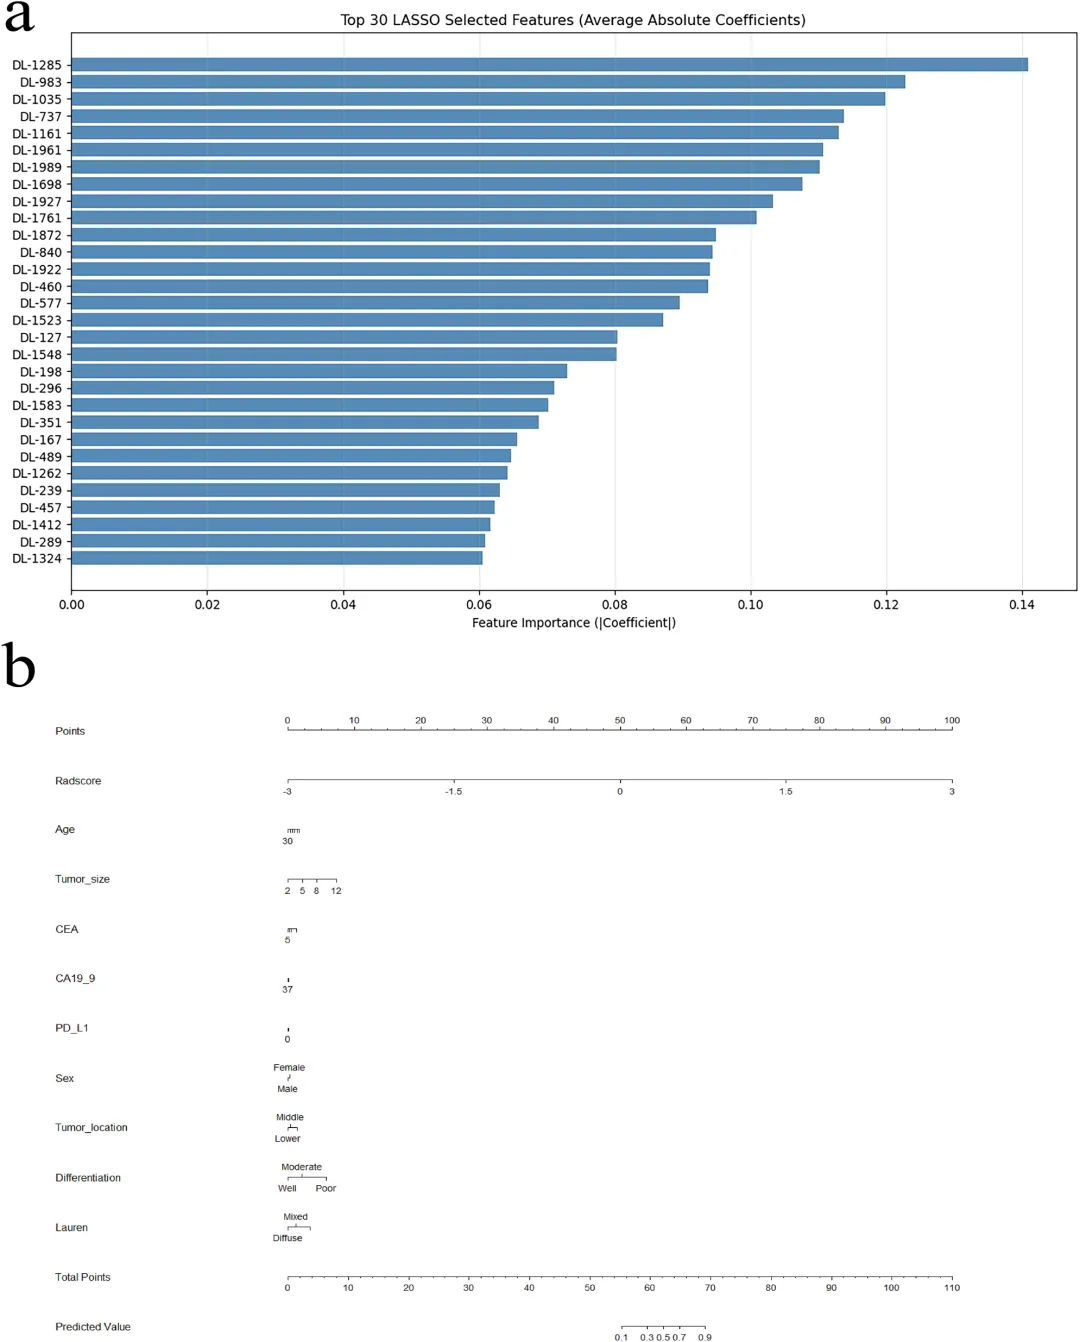 图5|临床-影像列线图
图注:研究提取GTRNet深度学习Rad-score,并结合肿瘤大小、分化程度和Lauren分型构建列线图。Rad-score、肿瘤≥5 cm、低分化和弥漫型Lauren分型均与更高T分期相关。列线图可输出患者属于不同T分期的预测概率。
决策曲线:AI模型比EUS有更高净获益
作者还做了决策曲线分析,用来比较AI模型和EUS分期在临床决策中的潜在价值。
结果显示,在大多数临床可接受的阈值范围内,AI模型的净获益高于EUS。
文章中还提到,在测试集里,AI模型的过度治疗率和治疗不足率都低于EUS:
AI模型过度治疗率:2.09%
EUS过度治疗率:12.97%
AI模型治疗不足率:2.51%
EUS治疗不足率:17.57%
NNT方面,AI模型为 2.19,优于EUS的 5.09。
这些结果要谨慎理解。
这不是说AI已经可以替代EUS,也不是说所有患者都可以只靠AI决定治疗。
更合理的理解是:
在这个回顾性队列里,GTRNet加列线图的分期结果,可能比传统EUS策略提供更高的临床决策净获益。
如果未来前瞻性验证成立,它可以作为术前MDT讨论中的一个辅助工具,帮助判断哪些患者更可能需要新辅助治疗,哪些患者可能直接手术更合适。
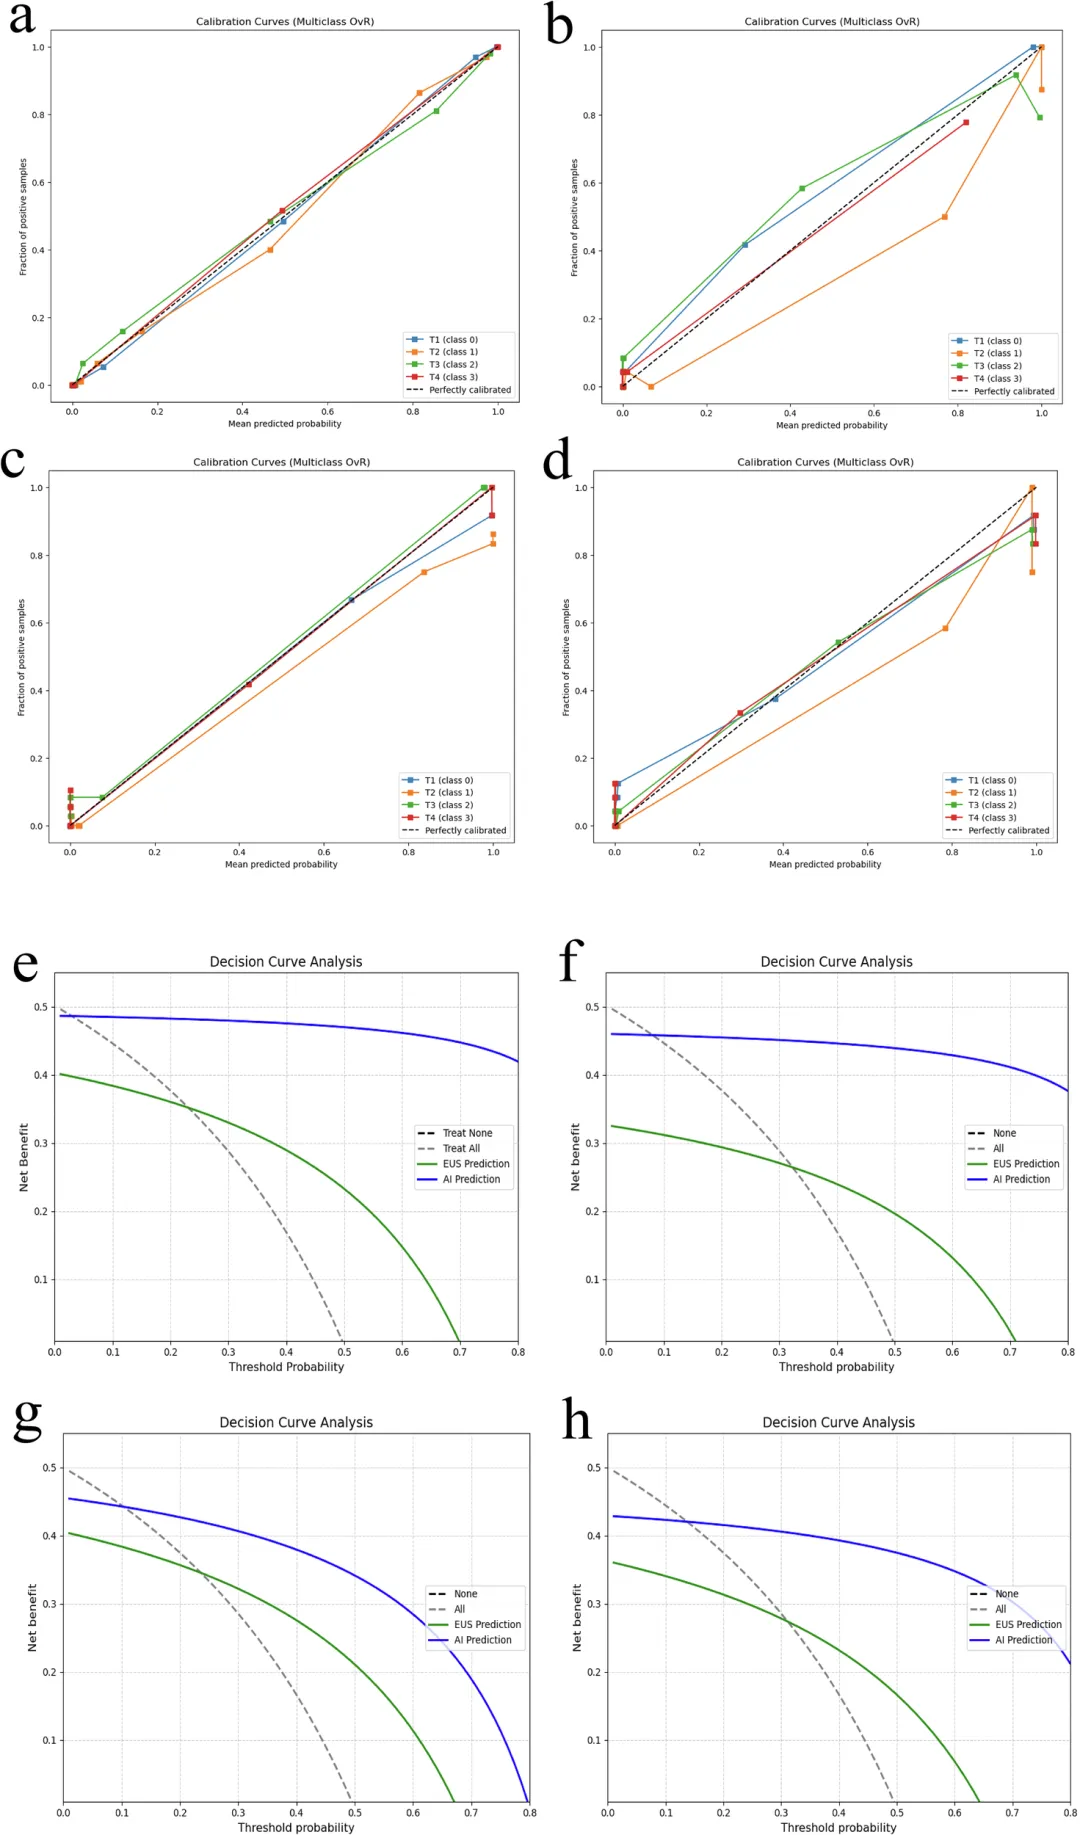 图6|校准曲线和决策曲线分析
图注:校准曲线显示模型预测概率与真实病理T分期之间具有较好一致性。决策曲线显示,在较宽阈值范围内,AI预测模型相比EUS分期具有更高净获益,提示其可能辅助新辅助治疗选择和手术决策。
这篇文章对临床有什么意义?
第一,它针对的是一个真实临床问题。
胃癌T分期不是学术上的分类游戏,而是直接关系到患者能不能做内镜治疗、是否需要新辅助治疗、手术范围如何设计。
第二,它不依赖手工分割。
很多影像组学研究需要医生先画ROI,这一步非常耗时,也会带来观察者差异。GTRNet使用端到端流程,不要求逐层勾画,更接近真实工作流。
第三,它做了多中心外部测试。
三个中心的CT设备和扫描参数不同,模型仍然保持较高表现。虽然还不能说已经充分泛化,但比单中心内部验证更可靠。
第四,它有可解释热图。
Grad-CAM显示模型关注胃壁、浆膜面和周围侵犯区域,这些正是医生判断T分期时会看的地方。
第五,它验证了人机协同。
AI辅助后,放射科医生准确率和Kappa明显提高。未来临床更可能采用这种模式:医生读片,AI提示风险和关注区域,最后由医生综合判断。
但这篇研究也不能过度解读
首先,这是回顾性研究。
虽然样本量较大,也有外部测试,但仍然需要前瞻性临床验证。
第二,研究对象主要是可手术患者。
部分T4b、腹膜转移或无法根治切除的晚期患者没有纳入。模型能否推广到更复杂的不可切除晚期胃癌,还不能确定。
第三,T4a和T4b被合并处理。
这对临床有影响。T4a是穿透浆膜,T4b是侵犯邻近结构,两者手术策略和预后意义并不完全一样。未来如果能进一步区分T4a和T4b,会更贴近临床。
第四,模型没有覆盖N分期和M分期。
胃癌治疗决策不只看T分期。淋巴结状态、远处转移、腹膜转移、HER2、MSI、EBV、PD-L1等因素都很重要。GTRNet目前只是T分期工具,不是完整TNM系统。
第五,外部验证都来自中国中心。
不同国家、不同体型患者、不同扫描协议和不同胃癌分布背景下,模型表现还需要更多国际验证。
第六,模型使用代表性轴位层面。
虽然外部测试加入了上下相邻切片多数投票,但本质上仍然没有完整利用整个三维CT体积。未来3D CNN或Transformer模型可能进一步提升对胃壁连续侵犯的判断能力。
写在最后
这篇文章最有意思的地方,不只是“AI准确率更高”。
它更接近胃癌术前分期的实际痛点。
CT是常规检查,但人工判断T分期容易受经验影响;
EUS有优势,但操作依赖性强,也不是所有场景都稳定;
影像组学方法常常要手工勾画,临床推广不方便。
GTRNet走的是另一条路线:
用常规门静脉期CT,选择肿瘤最大横截面,直接进行T1–T4四分类;
再用Grad-CAM解释模型关注的胃壁和周围侵犯区域;
最后把深度学习Rad-score和肿瘤大小、分化程度、Lauren分型结合起来,形成列线图辅助决策。
从结果看,模型在多中心数据中表现稳定,优于放射科医生单独判断,也能明显提高医生在AI辅助下的分期一致性。
当然,它还不能直接成为临床标准。
前瞻性部署、国际验证、T4a/T4b细分、N/M分期扩展,都是后续必须补上的部分。
但这篇文章给胃癌影像AI提供了一个比较清楚的方向:
不要只做“早期 vs 进展期”的二分类。
真正有临床价值的问题,是更细的T分期、更稳定的术前决策支持,以及医生能理解、能使用、能验证的模型输出。
对做胃癌AI的团队来说,这篇文章也有几个启发:
模型最好围绕真实治疗决策设计;
尽量减少手工勾画依赖;
一定要做多中心外部验证;
不能只报AUC,还要做医生对比、可解释性和决策曲线;
最终目标不是替代医生,而是让MDT前的术前分期更稳定。
清璟AI目前持续关注胃癌AI、消化道肿瘤影像、CT深度学习、可解释AI和术前治疗决策支持。对于已经积累胃癌增强CT、术后病理T/N分期、内镜资料和新辅助治疗数据的团队,课题设计时不建议只停留在“良恶性”或“早晚期”判断,更应该围绕T分期、N分期、新辅助治疗选择和手术策略这些真实临床问题展开。
文献信息
Zheng G, Wang H, Chai X, Xin X, Li F, Li H, et al.
Interpretable deep learning for multicenter gastric cancer T staging from CT images
npj Digital Medicine. 2026;9:2.
DOI: 10.1038/s41746-025-02002-5
关于我们
清璟AI由国内TOP2高校医工交叉博士联合创立,专注于医疗大模型科研、影像组学、病理组学、深度学习、AI智能体、生信分析、多组学、多模态和各类人工智能算法。致力打造一站式Al+医学科研生态圈,提供专业的AI智能体、高端科研资源及一对一定制化服务。我们的服务涵盖从科研方案设计、数据处理到AI模型训练及系统开发等各个领域,旨在为医学研究者和临床医生提供全方位的支持与创新解决方案。携手清璟AI,让科研更智能,让医学更精准。
科研合作请联系
长按二维码加微信