ARTICLE · 1165241
【AI落地】GPT 又降智了?先别骂官方,给你的项目洗个澡
大家在网上应该经常听到吐槽:GPT 又降智了,Claude 又变笨了。
我的判断很直接。官方模型确实会波动,那部分你管不了。但你遇到的“降智”,至少有一半不是模型的问题——是你那个项目太脏了。
我做过一个对比测试。
同一个需求,丢给刚建三天的干净项目,AI 一把过。
同一个需求,丢给改了两个月、跑了两百多轮的老项目,AI 开始兜圈子、漏需求,甚至把我没让它碰的文件改崩了。
Codex 和 Claude Code 表现一样。问题不在模型。
一、干净项目一把过,老项目死循环
这不是玄学。
老项目每改一轮,都会留下一堆不报错但没用的东西:没人调用的函数、过期的注释、复制粘贴出来的重复写法。
这些垃圾不会让程序崩溃,所以一直留着。但下一次 AI 干活,会先把它们全塞进上下文读一遍。
读进去的是垃圾,吐出来的自然就是灾难。
更要命的是“规矩包袱”。几乎所有 AI 编程工具都依赖一个规则文件(CLAUDE.md、AGENTS.md 这类),用来告诉 AI 这个项目有什么约定。
一项对 1,800 多个开源项目的统计发现,这类规则文件的平均体积膨胀了整整三倍。
加一条规则很容易,删一条怕崩,包袱就这么堆起来了。
研究者管这叫“灾难性记忆”——AI 把过时的约定当成必须遵守的真理,越改越错。
二、为什么会这样:上下文不是越大越好
很多人有个错觉:上下文窗口越大,AI 就越聪明。
于是把整个仓库、所有日志、全部聊天记录都喂进去。
真实情况相反。
一份 2026 年的基准测试,测了 18 个前沿模型,包括 GPT-4.1、Claude 4 系列、Gemini 2.5、Qwen3。
结论很干脆:输入越长,所有模型质量都在掉,有的掉 30% 到 50%,而且在远远没到标称上限时就开始掉。
不是某一个模型的问题,是全部。
另一组实验更细。当上下文里混入无关内容时,Sonnet 的方差直接翻三倍,变成“每跑一次像抛硬币”;Opus 反而更稳。
这说明什么?说明“降智”不是你的错觉。是输入里塞了太多噪声,模型被带偏了。
还有个更反直觉的数据。OpenRouter 统计了 100 多万亿 token 的真实交互,发现平均 prompt 长度在 2024 到 2025 之间涨了近四倍。
驱动它的正是 agent 编程:历史对话、工具输出、文件内容只进不出,越堆越肿。
三、脏的不只是上下文,还有技术债本身
上下文污染是“读错了”。还有一类是“写错了”,而且会留下来。
一份对 46 万多个 AI 引入问题的追踪研究显示:截至统计时,22.7% 的问题仍然残留在主分支上,其中有些是九个月前引入的。
到 2026 年 2 月,活着的 AI 技术债累计超过 10 万条。
更有意思的是这个对比:AI 提交的代码,修掉的“代码异味”和它引入的差不多;但在正确性和安全性问题上,它引入的比修掉的多。
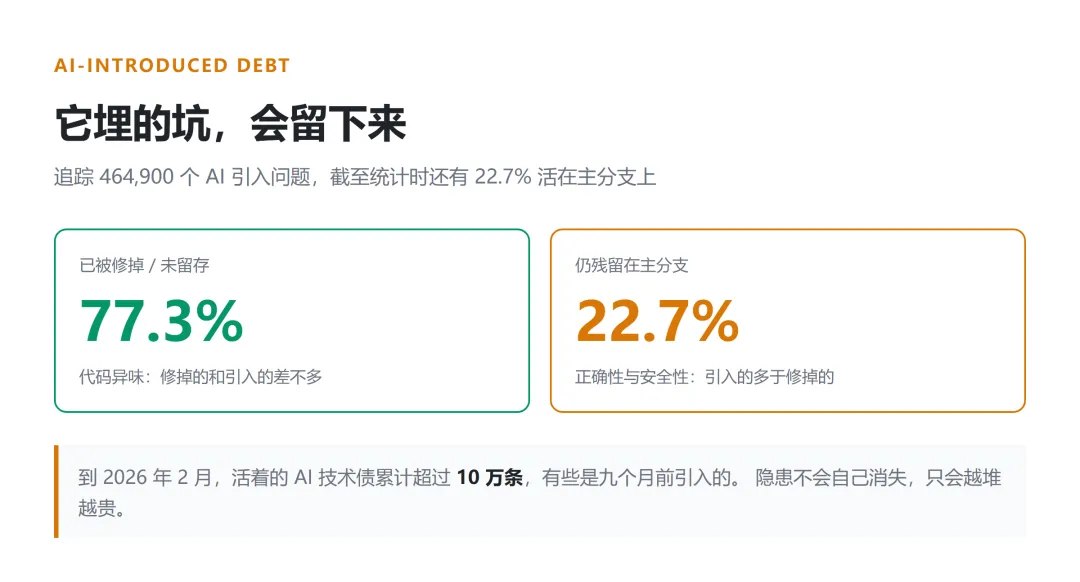
换句话说,AI 很擅长把格式调漂亮,也很擅长把隐蔽的 bug 和漏洞悄悄埋进去。
它还会顺手删掉那段“没人敢动”的旧逻辑——然后新需求就崩了。
一个真实案例:某次 AI 提交的代码调用了 requests.get() 却没设超时。这是已知的安全隐患,因为远程不响应就会无限阻塞。
这个隐患到今天还留在仓库里。
四、怎么破:给项目洗个澡
我的判断是,与其等官方“恢复智力”,不如自己动手做上下文卫生。三条,够用。
第一,定期做大扫除。
单独开一轮,明确告诉 AI:“这轮只做清理,不加任何功能。找出死代码、重复逻辑、过期的注释,先列清单,我确认后再改。”
关键在“先列清单”。让 AI 只输出待删项,你拍板,再执行。
这样既清了垃圾,又不会因为 AI 自作主张把活代码删了。
第二,严格限制它的活动范围。
告诉 AI 只读指定模块,别让它扫整个仓库。单个文件超过 800 行,先让它出拆分方案,不要碰代码。
这一步不只是为了质量,也为了你自己看得懂。
一个 3,000 行的文件被 AI 改完,你根本不知道它动了哪里。
第三,把规则当代码管。
把你的 CLAUDE.md 或 AGENTS.md 丢给 AI,让它找出“代码里已经不存在、但规则里还写着”的旧约定,删掉。
对于每一条留下的规则,强制补一句:“为什么需要它?”
那项统计 1,800 个项目的研究发现,就靠这一句话——每条规则必须写明保留理由——规则文件体积大幅缩水,AI 遵循指令的准确率也明显提升。
成本几乎为零。但你每写一条规则,就逼自己想清楚它到底还该不该在。
五、工具方其实早把答案写在了文档里
这件事,做 AI 编程工具的公司自己早就说过了,只是大多数人没当回事。
Anthropic 的 Claude Code 最佳实践里写得很直白:
不相关的任务之间,用 /clear 把上下文整个清空;长会话里每隔 8 到 10 轮就 /compact 一次;探索代码这种吃上下文的活,交给子代理去做,别污染主会话;CLAUDE.md 每条规则都占 token,所以控制在 200 行以内。
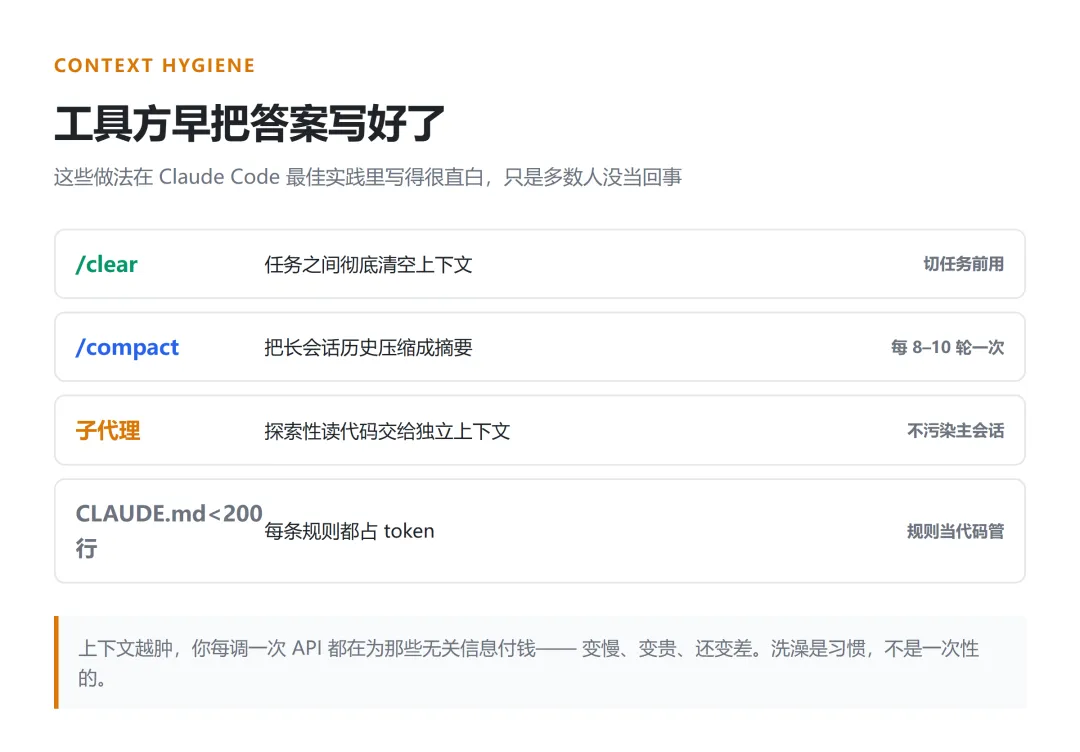
为什么强调 200 行?因为 AI 编程工具每发一条消息,都会把整个对话历史重新塞进上下文。
上下文越肿,你每调用一次 API 都在为那些无关信息付钱——变慢、变贵、还变差。
所以“洗澡”不是一次性的。它是个习惯:开新任务先清场,长会话勤压缩,规则文件当代码审。
结尾
模型一直在变强,这一点我从不怀疑。
下次你觉得 AI 又降智了,别急着骂。先开一个干净的新项目,把同样的需求丢进去试一下。
如果新项目跑得飞快,那就不是官方降智——是你的老项目该洗个澡了。