ARTICLE · 1165712
AI助手的理解边界
一、同一个窗口,怎么越聊越不主动了?
最近,我在用 Codex 改一款自己玩的小游戏。一直在同一个对话窗口里,我一轮轮提出修改意见,它也确实照着改。刚开始,它还会自己发现一些我没说到的地方,主动给出优化建议。
后来,对话越来越长,Codex 自动压缩了很多轮上下文。我慢慢发现它变了。它仍然会改,只是越来越像一只“死青蛙”,提醒一个才动一个。我不点出来的问题,它很少再像最初那样往前想。
我们明明已经聊了这么久,它怎么反而越来越需要我事事提醒?我不能把这个变化全算在压缩头上。游戏越改越复杂,后来的要求也可能改变了它的判断。可同一个聊天窗口开着,Codex 每一轮真的都能原样读到我们之前聊过的全部内容吗?
二、上下文窗口到底是什么?
对话界面里的聊天记录一直往下延伸。模型实际工作时,每次要根据这一轮送进来的内容生成回答。当前问题、先前的讨论、它读到的代码、工具返回的结果,都可能占据其中的位置。这次能处理的信息量有上限,这个上限就是“上下文窗口”。OpenAI 的开发文档用 token 来计算它。Token 不完全等于字数,输入和输出都会占用额度。
聊天记录能在界面里翻到,也不能保证它一字不落地出现在下一次模型输入里。开发类任务还会不断产生新的文件内容和工具输出。它们和前面已经说过的要求一起,占用这次的额度。
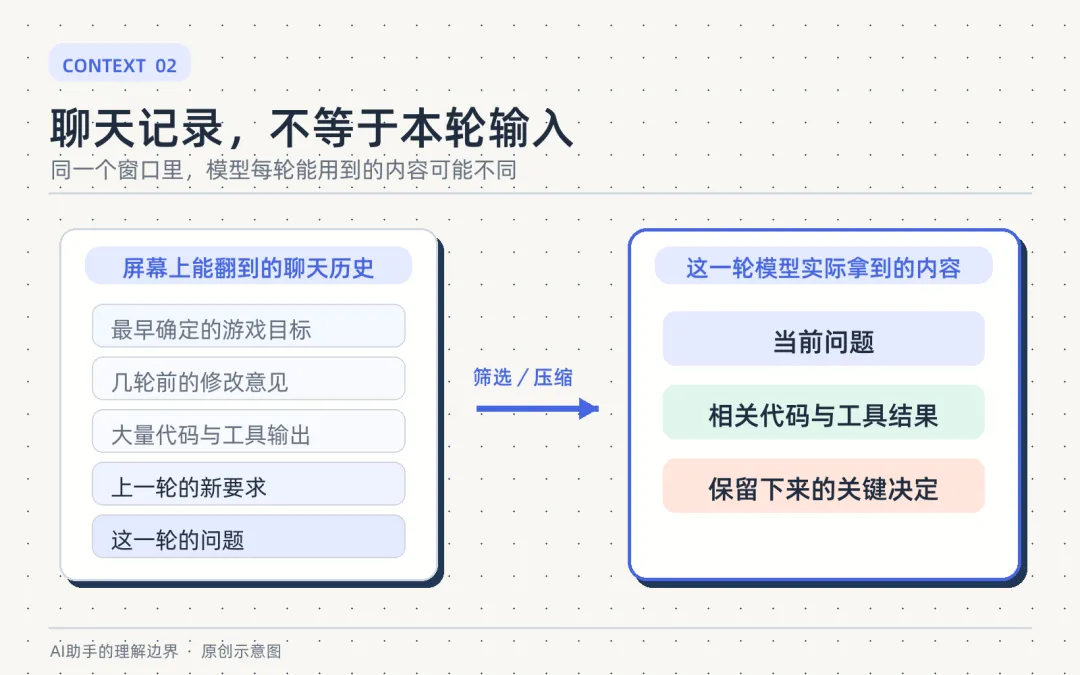
屏幕上看得到的历史,不等于模型这一轮都能读到。
为什么要有上限?处理更多内容需要计算资源,也会增加等待时间和使用成本。做小游戏时,这些内容尤其容易变长。一段需求描述可能只有几句话,相关代码和工具日志却可能有几千行。前面几十轮的修改记录再叠上去,就可能碰到上限。
这时,系统可以把一部分旧对话压成较短的状态,再让任务继续。OpenAI介绍 Codex 的文章提到,它会用压缩来延续长任务,同时保留部分高价值的旧信息。压缩帮助我们继续工作,也意味着旧讨论要做取舍。某个当时看着不起眼的偏好,后来可能恰好成了判断下一步的关键。
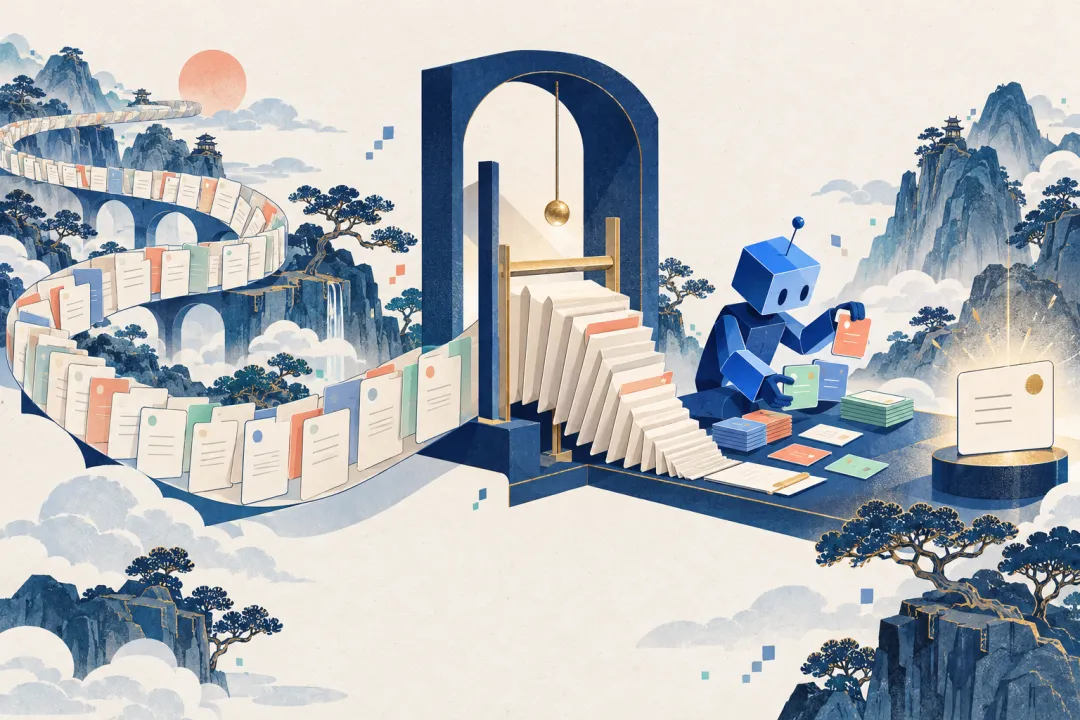
压缩让长任务继续,也要求对旧信息做取舍。
把窗口做得更长当然有用。它能容纳更多代码和资料,也能减少频繁压缩。不过,能放进去和能用好仍有距离。《Lost in the Middle》发现,在它测试的一些长文本任务里,关键信息放在中间时,模型更容易表现变差。Chroma 后来测试了 18 个模型,也观察到输入增长时表现并不总是稳定。这些研究不能解释我的那次 Codex 体验,却提醒我们,窗口的长度只是其中一个条件。
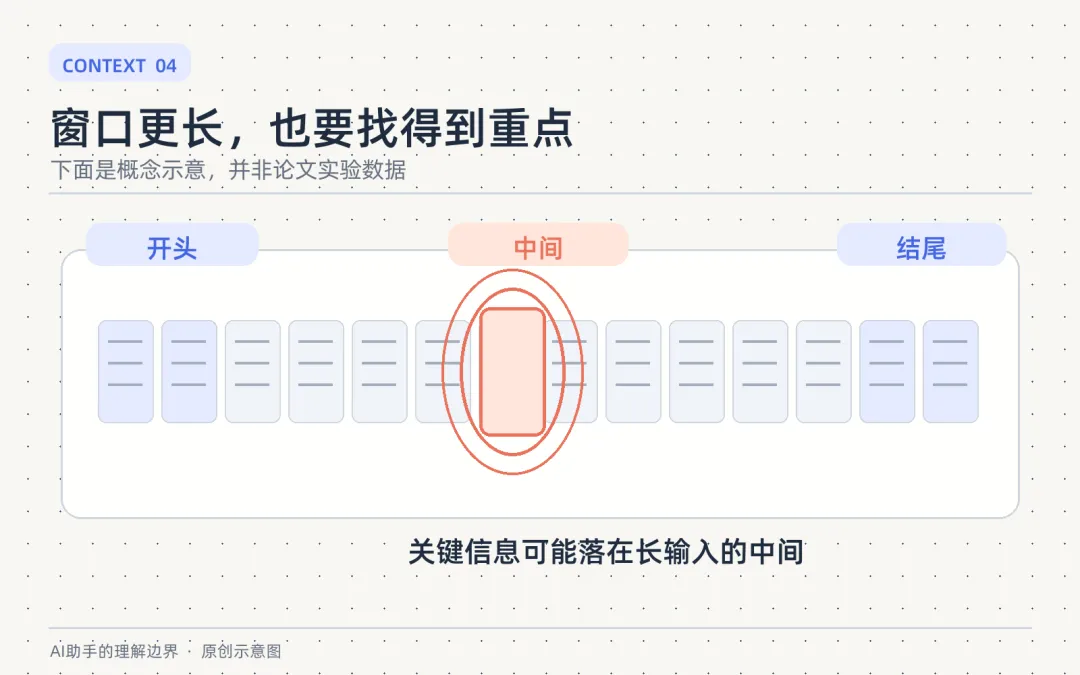
窗口更长,仍需要准确找到并使用信息。
三、上下文工程在解决什么问题?
我看过一份上下文工程课件,开头用辅导作业举例。同一道题,如果只看到题目,助手能讲解法;再知道学生已经学过什么、在哪一步常出错,它才能调整讲法。资料留在系统里还不够,答这一题时得拿来用。
改小游戏也是一样。我这一轮提了一个新意见,助手需要看当前要改的功能和相关代码,还要知道我们之前已经定下的玩法要求。上一轮改完后留下的问题,也不能随着对话变长就消失。把这些内容每次都重新贴一遍很累,全部依赖聊天记录又容易漏。上下文工程要做的,就是安排好这些信息怎样进入下一轮工作。
把当前任务需要的代码、要求和问题,放到助手眼前。
游戏的目标和已经定下的设计,适合写进项目说明。这次修改涉及的文件、刚跑出来的报错,只在眼下有用。助手需要时再读取这些材料,比每轮带着整个项目和全部日志走更合适。
工具输出也要挑。一次测试跑完,助手可能得到一长串日志。它要知道哪一步失败,失败前改了什么,才好继续查。把所有日志都带进下一轮,既占位置,也会让这次要解决的问题难找。
改动牵涉好几个地方时,还可以先分任务。查原因的一步看相关代码和报错,动手修改的一步接着看查到的结论。每一步拿到的信息更集中,回头也容易看出它在哪一步理解错了。
任务做久了,还得整理过程。已经改了什么、为什么这么改、还有什么没解决,可以在阶段结束时留下一份简短记录。压缩时尤其要保住这些决定。过于笼统的摘要会让后面的修改失去依据。如果跨了新对话,长期保存的说明也要在合适的时候被重新取出。资料存在某处,和模型这一轮用上了它,中间还隔着一步。
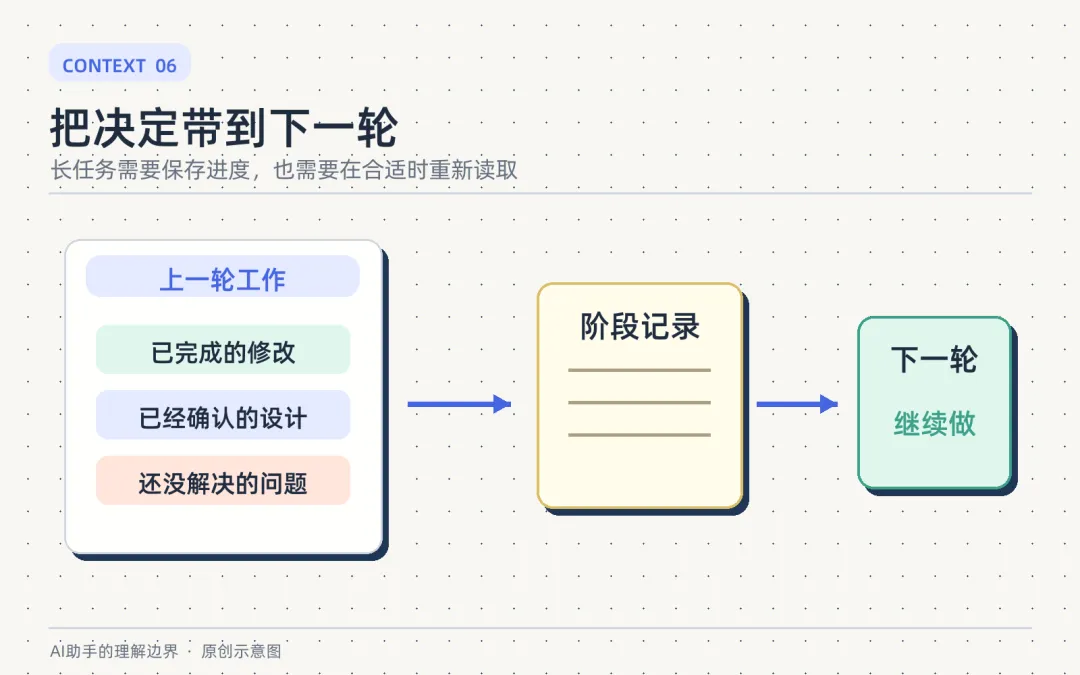
长任务要留下能继续使用的决定和进度。
Anthropic 在一篇工程文章里,把按需取资料、压缩历史和整理笔记都放进了上下文工程的工作范围。我觉得这个词可以理解得很朴素。AI 每次开始干活前,先让它拿到足够且相关的信息;任务变长时,及时整理哪些东西要继续带着。
四、为什么又出现了 Harness 工程?
提示词工程关注一次提问怎样说清楚。后来,AI 助手开始读文件、调用工具、连续做很多步。每一步该给它哪些信息,渐渐成了更难的问题,上下文工程因此受到更多关注。Anthropic 把它称为提示词工程的自然延伸。
在长任务里,上下文工程做到一定程度,继续调整资料的取舍,提升可能越来越有限。助手还得能访问文件、运行程序、看到报错,做完也要有办法检查结果。OpenAI 在一项让 Codex 开发软件的实践中发现,早期推进缓慢,原因是工作环境给得不够明确。团队随后把仓库文档、应用运行环境和验证反馈做成 Codex 可以直接使用的条件。这些都属于 Harness 工程关心的范围。
助手还需要能操作、能检查的工作环境。
Loop 工程继续讨论助手怎样循环执行、检查和重试,直到满足停止条件。Graph 工程则描述多个任务怎样分支、汇合,或在 Agent 之间交接。这些设计彼此交叠,没有一条整齐的换代时间线。
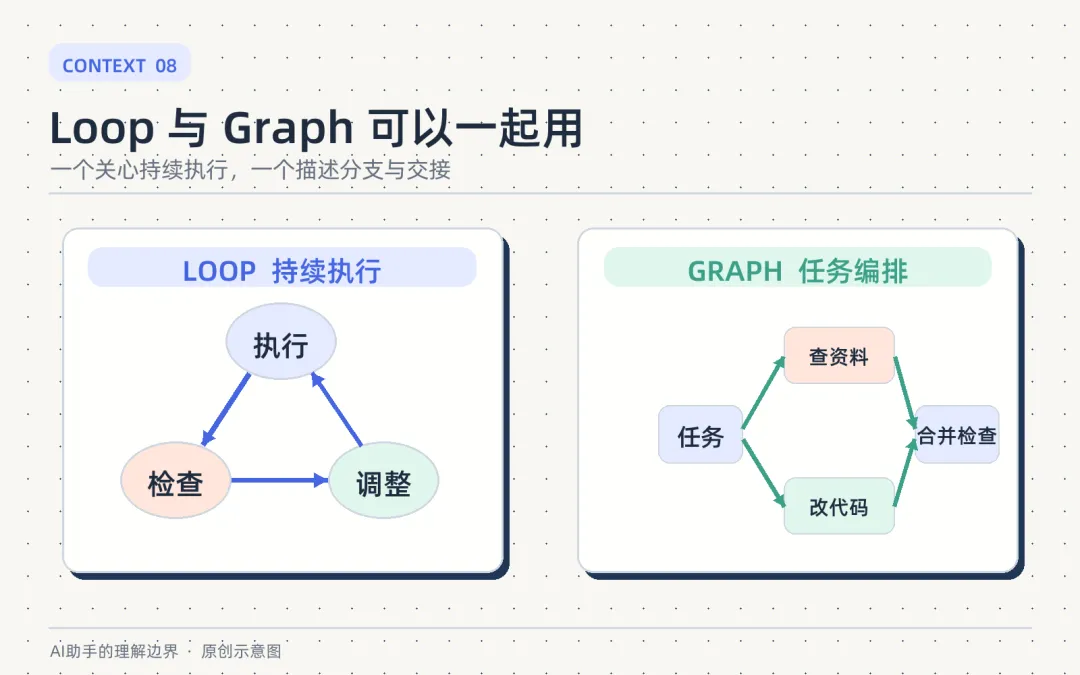
持续执行与任务编排,是可以交叠的两种设计视角。
离产品最近的例子,可能是 xAI 的Grok Bot 测试版。它的例程可以按时间或事件运行,官方也介绍了多 Bot 协作。至于内部怎么编排任务,公开资料还不够细,不能直接给它贴上 Graph 工程的标签。
五、回到那只“死青蛙”
如果我还想让 Codex 长时间帮我改游戏,单靠把聊天窗口一直开着并不稳妥。把项目目标和已经确认的要求留下来,每轮让它看相关代码,过一段时间整理一次做过的修改,这些动作更有机会让它接住前面的工作。至于它能不能像最初那样主动提出建议,还会受模型能力、任务复杂度和工具使用方式影响。
下一轮开始前,还可以让它先说说现在要改什么,哪些要求已经定过,再动手改。这样至少能及时发现它对任务的理解有没有偏离。改完以后,再看结果有没有违背先前的约定。
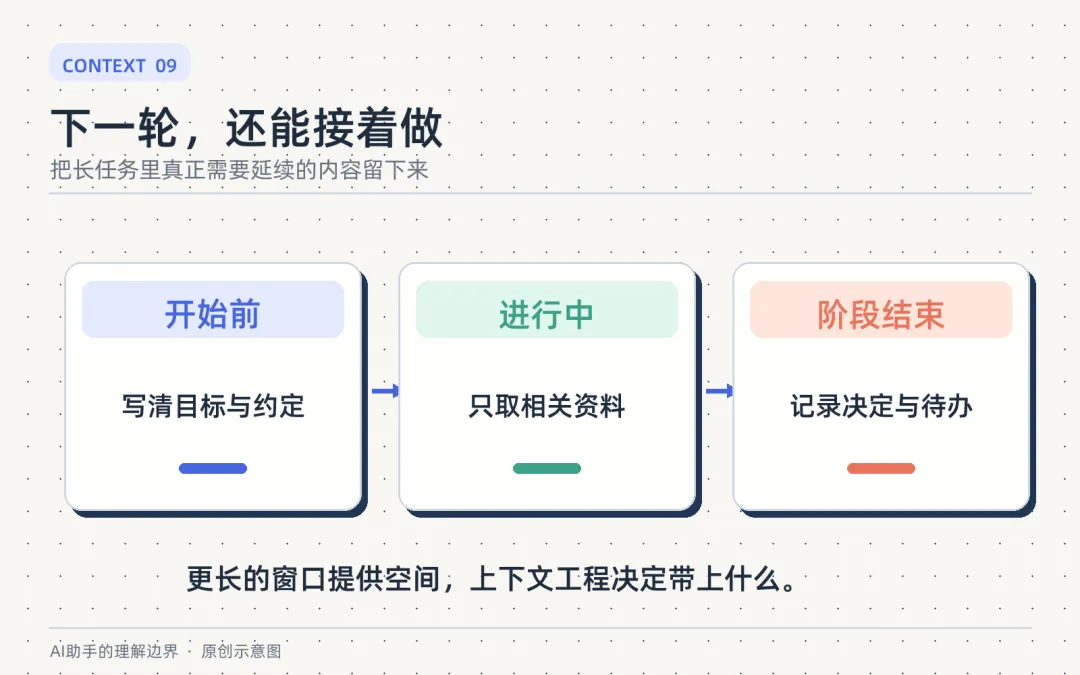
写清目标,按需取资料,阶段结束时记录决定和待办。
我没法回头精确指出,第几次压缩漏掉了哪句话。但这段经历让我记住了一点。一个助手曾经懂我想做什么,不代表这些理解会自动跟着它走到第几十轮。更长的上下文窗口,让它有机会带上更多东西;上下文工程,决定它这一轮先看到哪些。两件事都重要。下一次我再提出一个修改意见,希望它还能明白,我们一直想把这款小游戏做成什么样。