ARTICLE · 1175950
大学生的 AI 通识课⑭|注意力机制与 Transformer:改变一切的那篇论文
单击上方“图灵人工智能”,选择“星标”公众号
您想知道的人工智能干货,第一时间送达
上一篇《循环神经网络(RNN):让机器拥有“记忆”》讲清了机器怎样像接力赛一样,把“记忆”一个字一个字地传下去。可这条“接力”路线有两个天生的弱点:信息传得越远越容易衰减,而且必须排队、无法并行。这一篇,我们来看一个“换思路”的方案——不排队、不传话,让每个词直接看向所有词。它,最终催生了 ChatGPT。
📝 开头:这个“它”指的是谁?
请读下面两句话,并判断每句话中的“它”指的是什么:
① 奖杯放不进行李箱,因为它太大了。 ② 奖杯放不进行李箱,因为它太小了。
你一定能立刻答出:第①句的“它”是奖杯,第②句的“它”是行李箱。
两句话只差一个字,“它”指代的对象却完全不同。你之所以能判断正确,是因为在读到“它”的时候,你的注意力同时关联到了“奖杯”“行李箱”“大”“小”这几个关键词,并根据常识做出了推理。
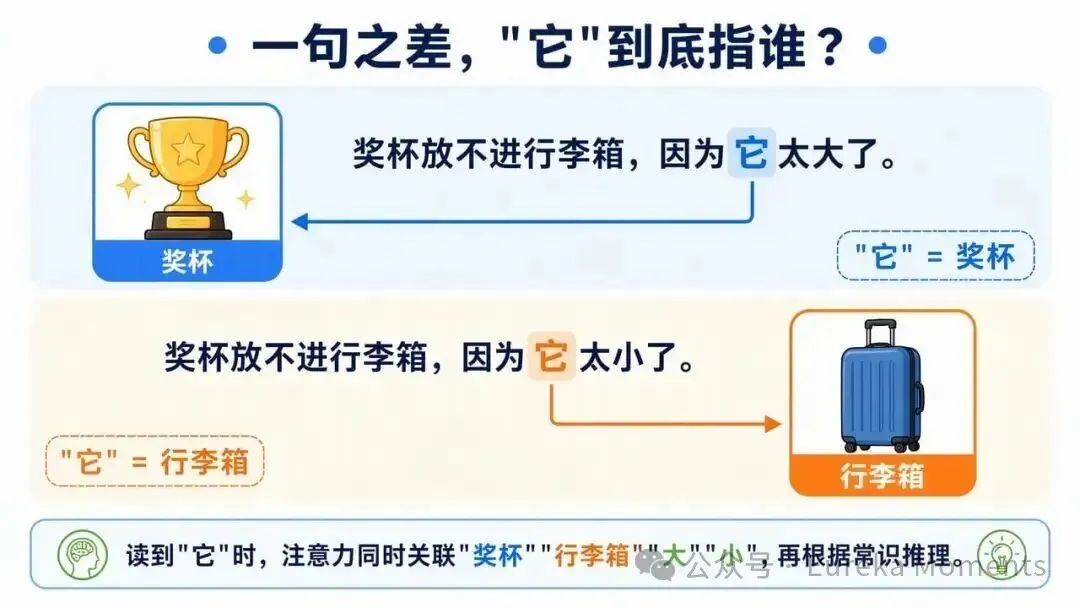
图 1 | 一句之差,“它”到底指谁?注意力同时关联“奖杯”“行李箱”“大”“小”,再根据常识推理。
这类“代词指代”问题,曾经是 AI 领域公认的难题,专门被用来测试机器是否真正“理解”了语言。对于上一篇介绍的 RNN 来说,它必须把前面的信息压缩进“记忆”里一步步往后传,很难灵活地在句子的不同部分之间建立联系。
那么,能不能让机器像人一样,在读到每一个词时,都能直接“看向”句子中所有相关的词?
这就是注意力机制(Attention Mechanism)的核心思想。而基于这一思想构建的 Transformer,彻底改变了人工智能的发展方向——今天的 ChatGPT、DeepSeek、文心一言、通义千问……几乎所有大模型,都建立在它的基础之上。
🎯 一、从人类的注意力说起
鸡尾酒会效应
想象你身处一个热闹的聚会,周围人声嘈杂、音乐震耳。但当你和朋友聊天时,你依然能听清对方说的每一句话,而自动“屏蔽”了周围的噪音。更神奇的是,如果远处有人喊了一声你的名字,你会立刻注意到。
心理学家把这种现象称为“鸡尾酒会效应“。它说明,人类的大脑并不会平等地处理所有信息,而是会有选择地把注意力集中在最相关的部分。
阅读中的注意力
阅读时也是如此。当你读到“它太大了”中的“它”时,你并不会平等地回顾前面每一个字,而是会重点关注“奖杯”和“行李箱”这两个可能的指代对象,对“放”“不”“进”这些字则几乎不在意。
💡 说人话:注意力就是“抓重点”——在大量信息中,找出与当前任务最相关的那部分,并给予更多的关注。
🔗 二、注意力机制:让每个词“看向”所有词
回顾:RNN 的困境
上一篇我们讲过,RNN 处理句子时,像接力赛一样把“记忆”从第一个词传到最后一个词。这带来两个问题:
注意力的思路:直接“打电话”
注意力机制换了一种思路:不再一站一站地传话,而是让每一个词都可以直接和句子中的任何一个词“打电话”。
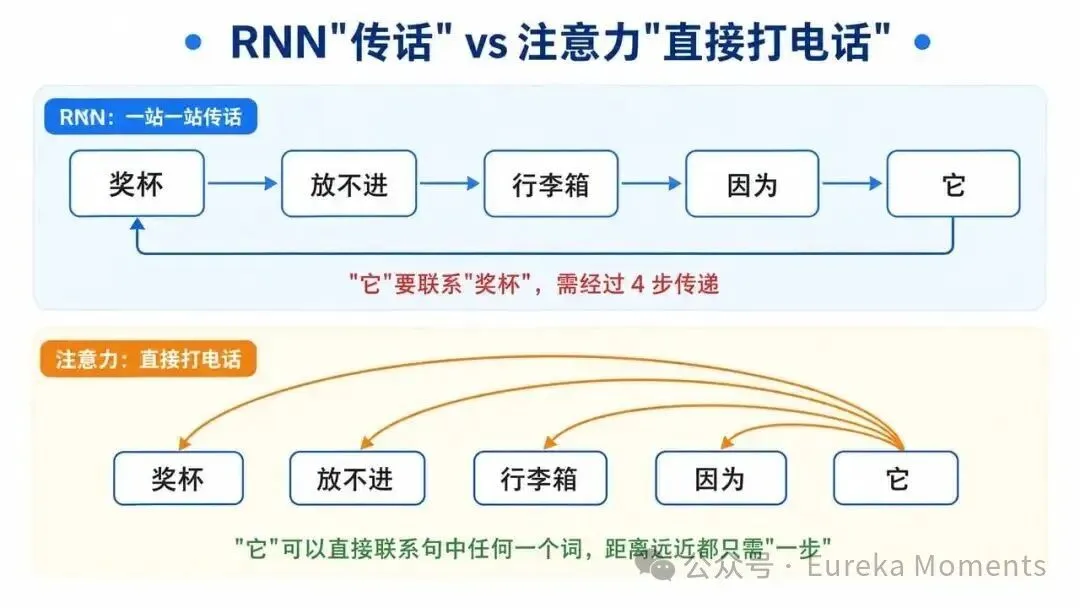
图 2 | RNN 的“传话”与注意力的“直接打电话”:无论两个词相隔多远,注意力的联系都只需“一步”。
无论两个词相隔多远,它们之间的联系都只需要“一步”就能建立。 这从根本上解决了长距离依赖的问题。
🔑 三、注意力是怎么计算的?Q、K、V 的故事
注意力机制中有三个核心概念:查询(Query,Q)、键(Key,K)、值(Value,V)。这三个词听起来很抽象,我们用一个“图书馆找书“的比喻来理解。
图书馆找书
假设你要写一篇关于“人工智能伦理”的课程论文,于是去图书馆找资料:
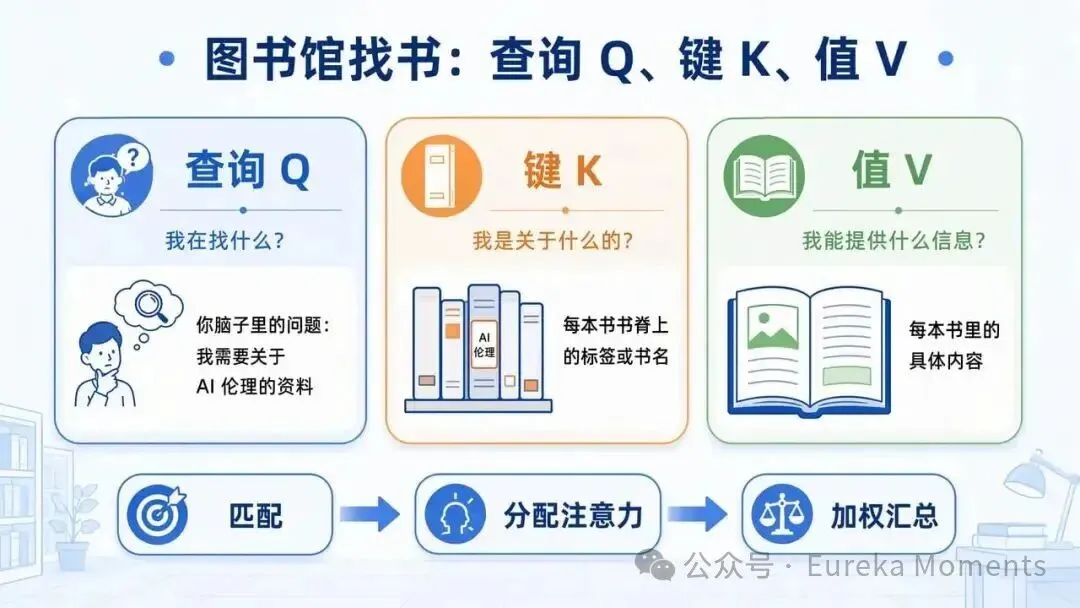
图 3 | 图书馆找书:查询 Q、键 K、值 V。
| 查询(Q) | ||
| 键(K) | ||
| 值(V) |
找书的过程是这样的:
放回句子里
在注意力机制中,句子里的每一个词都会同时扮演这三种角色,各自生成一个 Q、一个 K 和一个 V(它们都是通过训练学出来的)。
以“它”这个词为例:
动手算一算(示意)
假设“它”与三个词的相关度分数如下,经过 Softmax 转换后:
| 约 66% | ||
| 合计 | 100% |
(注:以上数字仅为便于理解的示意,真实模型中的数值由训练自动得出,而且会同时考虑句中的所有词。)
于是,“它”的新含义中,约三分之二来自“奖杯”。模型由此“理解”了:这里的“它”,很可能指的是奖杯。
如果把句子换成“它太小了“,由于”小“与”容器(行李箱)“的关联更强,注意力权重就会转向“行李箱”。
💡 说人话:注意力机制就是让每个词都“环顾四周”,看看句子里哪些词和自己最相关,然后有侧重地吸收它们的信息,从而更准确地理解自己在这句话中的含义。
👀 四、自注意力与多头注意力
自注意力:句子“自己看自己”
在上面的例子中,Q、K、V 都来自同一个句子,句子中的每个词都在关注同一句话中的其他词。这种注意力叫作自注意力(Self-Attention)。
它最大的优点是:所有词可以同时计算。 每个词“环顾四周”的过程互不依赖,不需要像 RNN 那样排队等待。这就像从“一个收银台排长队“变成了”所有顾客同时自助结账“,完美契合了 GPU 擅长并行计算的特点。
多头注意力:从多个角度理解
一句话中,词与词之间的关系是多种多样的。比如:
“小明在图书馆认真地读一本关于人工智能的书。”
只用一组注意力,很难同时捕捉这么多种关系。于是,Transformer 采用了多头注意力(Multi-Head Attention):同时使用多组独立的注意力(称为多个“头”),每个头可以关注不同类型的关系,最后再把它们的结果综合起来。
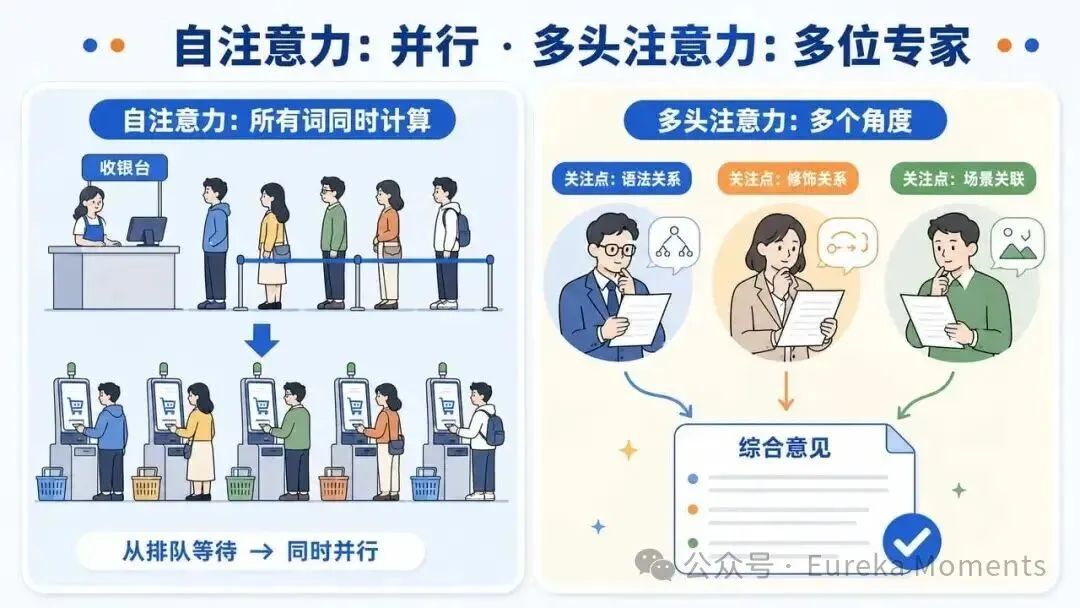
图 4 | 自注意力(并行)与多头注意力(多位专家):像从“排长队”变成“同时结账”,又像请多位专家从不同角度评审。
打个比方:这就像一篇论文请了多位审稿专家同时评审——一位关注语言表达,一位关注逻辑结构,一位关注研究方法。每位专家各有侧重,综合起来的意见就更加全面。
研究者在分析训练好的模型时发现,不同的“头”确实会自发地形成不同的“分工”,有的关注相邻的词,有的关注代词的指代对象,有的关注句法结构。这些分工同样不是人为设计的,而是模型自己学出来的。
🎟️ 五、一个小问题:谁先谁后?
自注意力有一个“副作用”:因为每个词都同时看向所有词,它本身并不知道词的先后顺序。
对于纯粹的自注意力来说,“狗咬人”和“人咬狗”包含的词完全一样,看起来没有区别。但第 13 篇说过,顺序对语言至关重要!
解决办法是位置编码(Positional Encoding):在把每个词送入模型之前,给它附加一个表示位置的信息,告诉模型“我是第 1 个词”“我是第 2 个词”……
打个比方:这就像给电影院的每位观众发一张带座位号的票。虽然大家同时入场,但每个人都知道自己坐在第几排第几号,彼此的相对位置也就清楚了。
🧱 六、Transformer 的整体结构
那篇改变一切的论文
2017 年,谷歌的八位研究者发表了一篇论文,标题只有五个英文单词:
《Attention Is All You Need》(注意力就是你所需要的一切)
这个标题化用了披头士乐队的名曲《All You Need Is Love》,它的核心主张是:完全抛弃 RNN 的循环结构,只用注意力机制来构建模型。 论文提出的新架构,被命名为 Transformer。
基本构件
Transformer 的结构看起来复杂,但它是由几种我们已经学过的“积木”搭成的:
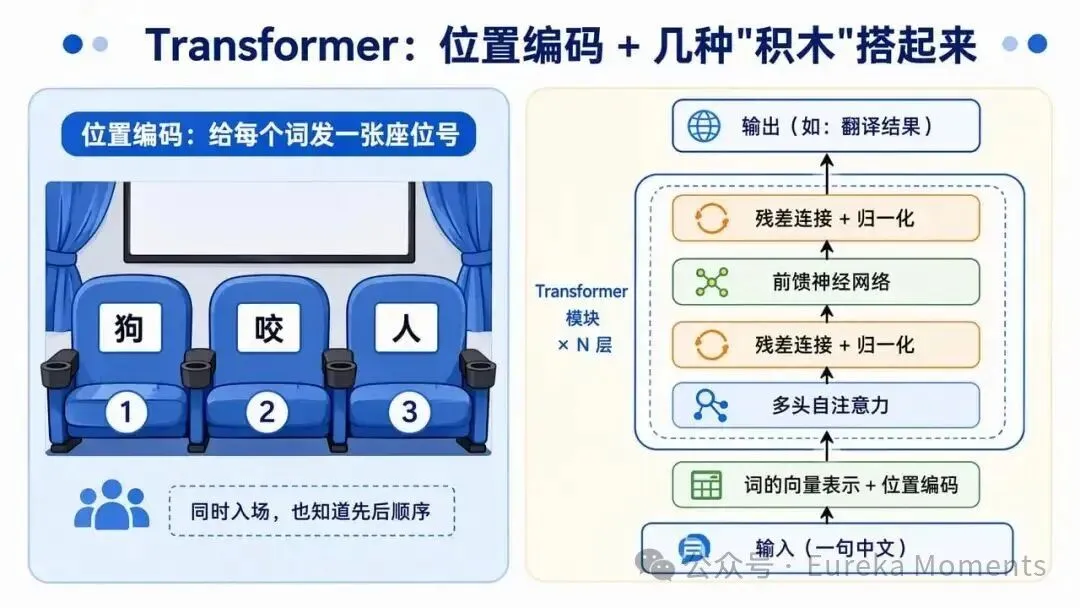
图 5 | Transformer:位置编码给每个词发“座位号”,再用多头自注意力、前馈网络、残差连接等“积木”一层层搭起来。
每一个 Transformer 模块包含:
把这样的模块一层层堆叠起来,就构成了完整的 Transformer。原始论文中堆叠了 6 层,而今天的大模型往往堆叠了几十层甚至上百层。
原始的 Transformer 是为机器翻译设计的,所以它和上一篇讲的 Seq2Seq 模型一样,分为编码器(读懂原文)和解码器(生成译文)两部分。
惊艳的效果
在论文中,Transformer 在英德、英法翻译任务上都刷新了当时的最好成绩,而训练所需的时间和计算成本却远远低于此前的最佳模型。其中较大的模型在 8 块 GPU 上训练了约 3.5 天——这在当时已经是非常高效的了。
🌍 七、为什么说 Transformer“改变了一切”?
1. 可以并行,可以“做大”
Transformer 能够充分利用 GPU 的并行计算能力,这意味着:可以用更多的数据、更多的算力,训练更大的模型。
这一点至关重要。后来人们发现,Transformer 模型的规模越大、训练数据越多,能力就越强,而且这种提升在很大范围内都相当稳定、可预测(这就是第 17 篇要讲的“Scaling Law”)。Transformer 为“大模型”时代铺平了道路。
2. 一种架构,通吃各种任务
Transformer 最初是为翻译设计的,但人们很快发现,它几乎可以处理任何能被表示为“序列”的数据:
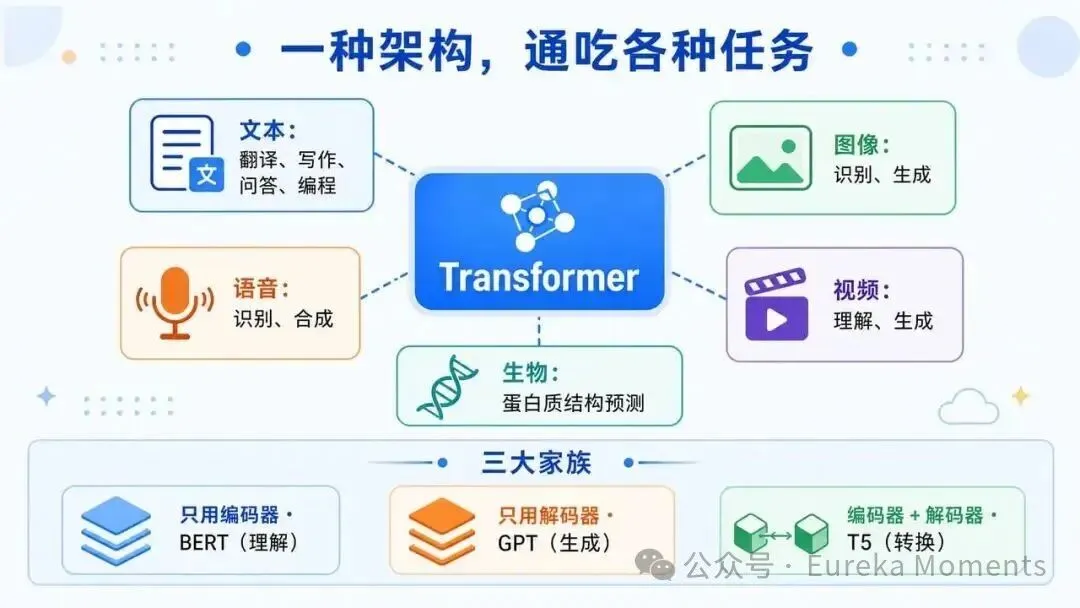
图 6 | 一种架构,通吃各种任务:从文本、图像、语音到视频、生物,并衍生出“只用编码器”“只用解码器”“编码器 + 解码器”三大家族。
在 Transformer 出现之前,处理图像用 CNN,处理语言用 RNN,各个领域“各自为政”。而 Transformer 让不同领域第一次有了一种通用的架构,这也为后来能够同时理解文字、图片、声音的多模态大模型奠定了基础。
3. 三大家族
在 Transformer 的基础上,衍生出了三类主要的模型:
| 只用编码器 | 理解 | ||
| 只用解码器 | GPT 系列 | 生成 | |
| 编码器 + 解码器 | 转换 |
其中,“只用解码器“的 GPT 路线后来大放异彩。今天绝大多数主流的大语言模型,采用的都是这种结构。
💡 小知识:ChatGPT 中的 GPT,全称是 Generative Pre-trained Transformer,即“生成式预训练 Transformer“。那个”T“,指的正是今天介绍的 Transformer。
4. 一篇论文的影响力
《Attention Is All You Need》已成为人工智能历史上被引用次数最多的论文之一,引用量超过十万次。有意思的是,这篇论文的八位作者后来全部离开了谷歌,其中多位创办了自己的人工智能公司。
⚠️ 八、Transformer 的“烦恼”
Transformer 并非完美无缺。它最大的问题是:输入越长,计算量增长得越快。
原因在于自注意力的工作方式:每个词都要和所有词计算一次相关度。
长度增加 10 倍,计算量增加约 100 倍。 这就是为什么大模型都有一个“上下文窗口“(Context Window)的限制——一次能处理的文本长度是有上限的(第 15 篇会进一步讨论)。
为了突破这个限制,研究者们想出了各种办法:优化注意力的计算方式以节省显存和时间、只让每个词关注一部分最相关的词、借鉴 RNN 思想设计新的架构(上一篇提到的 Mamba、RWKV 等)。今天主流大模型的上下文窗口,已经从最初的几千个词扩展到了数十万甚至上百万个词。
🎒 九、第三单元回顾:从神经元到 Transformer
到这里,我们的第三单元“神经网络与深度学习”就全部结束了。让我们把这五篇的内容串起来:
PLAINTEXT 第 10 篇 神经元与神经网络 → 基本积木:加权求和 + 激活函数 ↓ 第 11 篇 反向传播 → 学习引擎:高效计算每个参数的梯度 ↓ 第 12 篇 卷积神经网络 CNN → 学会"看":局部扫描、层层抽象 ↓ 第 13 篇 循环神经网络 RNN → 学会"记":按顺序处理、传递记忆 ↓ 第 14 篇 注意力与 Transformer → 学会"关注":全局关联、并行计算 ↓ 大模型时代
🎒 一句话总结
注意力机制让每个词都能直接“看向”句子中所有相关的词,并有侧重地吸收信息;完全基于注意力构建的 Transformer 既能捕捉长距离关系,又能并行计算,成为了今天几乎所有大模型的基石。
🤔 思考题
欢迎在留言区分享你的答案!
📚 延伸阅读
下期预告:从下一篇开始,我们正式进入第四单元“大模型时代”。第 15 篇《Token 与 Embedding:AI 眼中的文字》将带你了解:计算机只认识数字,它是如何“读懂”文字的?为什么“国王 − 男人 + 女人 ≈ 女王”?大模型按“Token”收费,Token 到底是什么?
文章精选: