ARTICLE · 1179215
Codex 源码-Parallel 工具并行执行与编排
Codex 源码解析系列
第 20 讲:Parallel 工具并行执行与编排
基于 OpenAI Codex 源码 · 2026-10-14
💡 本讲一句话:Codex 用一把 RwLock 当"并发门控"——只读工具拿读锁一起跑,写工具拿写锁排队;再用 FuturesOrdered 保证结果按模型发出顺序回来。读完你能看懂 parallel.rs / orchestrator.rs / executed_tool_calls.rs 三个文件如何拼出"并行但不乱序、可中止、可计时"的工具执行层。
一、为什么需要"并行 + 保序"
模型一次响应里可以同时发出多个工具调用:查两个文件、读一个 MCP 资源、搜一下插件列表——彼此毫无依赖。如果串行执行,总耗时就是所有调用之和;并行则接近最慢的那个。但"并行"立刻带来三个工程问题:
🔹 写冲突:两个工具同时改同一个文件,结果不可预测——必须串行;🔹 乱序:任务完成顺序是随机的,但模型看到的工具输出顺序必须和它发出调用的顺序一致,否则下一轮推理会错乱;🔹 中止竞态:用户按 Esc 的那一刻,有的任务可能刚好跑完——不能把"其实成功了"误报成"被中止"。
Codex 的答案是三个机制的组合:RwLock 门控(parallel.rs)、FuturesOrdered 保序收集(turn.rs)、按工具声明的并发能力(registry.rs + 各 handler)。下面逐个拆。
二、ToolCallRuntime:每个 step 一把并发门控锁
先看承载一切的结构体(codex-rs/core/src/tools/parallel.rs):
📄 codex-rs/core/src/tools/parallel.rs (第 43-63 行)
#[derive(Clone)] // 派生 Clone:Arc 字段都是引用计数,克隆廉价——每个工具调用任务都要持有一份pub(crate) struct ToolCallRuntime { // 工具调用的运行时上下文,绑定到某一个 step(模型的一次响应) session: Arc<Session>, // 会话句柄:审批、遥测、历史写入都挂在它上面 // Tool calls may run later, so retain the step whose tool list advertised them. // 注释原文:工具调用可能稍后才执行,所以必须保留"宣布过这批工具的那个 step"——防止 step 被回收后悬空引用 step_context: Arc<StepContext>, // step 上下文:持有 tool_router、turn、settings,是分发时的唯一事实来源 tracker: SharedTurnDiffTracker, // turn 级 diff 追踪器:多个并行工具共享同一份文件变更账本 parallel_execution: Arc<RwLock<()>>, // ★并发门控锁:锁住的是空值,纯粹当"读=可并行 / 写=独占"的信号量用}impl ToolCallRuntime { // 实现块开始 pub(crate) fn new( // 构造函数 session: Arc<Session>, // 会话 step_context: Arc<StepContext>, // step 上下文 tracker: SharedTurnDiffTracker, // diff 追踪器 ) -> Self { // 返回自身 Self { // 字面量构造 session, // 原样放入 step_context, // 原样放入 tracker, // 原样放入 parallel_execution: Arc::new(RwLock::new(())), // ★每个 step 新建一把读写锁——并发域被限定在"同一次模型响应内",跨 turn 互不干扰 } // 构造结束 } // new 结束为什么这样设计:锁的粒度是 step(一次模型响应),不是全局。同一批工具调用共享一把 RwLock,天然表达"这批里只读可以并发、写必须独占";而不同 turn 的工具互不阻塞——这是比全局信号量更精确的并发域划分。另外注意注释特意强调 step_context 要"保留住":因为工具任务是在流式接收过程中被 spawn 出去的,执行时原 step 的作用域早已结束,Arc 延长了它的生命周期。
三、核心:RwLock 门控 + 任务化分发
📄 codex-rs/core/src/tools/parallel.rs (第 95-127 行)
pub(crate) fn handle_tool_call_with_source( // 带来源信息的分发入口:source 区分"模型直接调用"和"code-mode 嵌套调用" self, // 按值消费 runtime(Clone 出来的副本),任务拿走后不共享可变状态 call: ToolCall, // 工具调用本体:名字 + call_id + payload source: ToolCallSource, // 来源标记,决定遥测口径和计时守卫是否生效 cancellation_token: CancellationToken, // 取消令牌:用户中止 turn 时从这里广播) -> impl std::future::Future<Output = Result<AnyToolResult, FunctionCallError>> { // 返回一个 future——调用方决定何时 await,这正是"先 spawn 后收集"的基础 self.session.services.executed_tool_calls.record_tool_call( // ★分发前先把这次调用记进"已执行工具账本"(第36讲 Memories/Code Mode 会消费它) &call, // 调用本体 &source, // 来源 &self.step_context, // step 上下文:用于取 tool_mode ); // 记账完成——即使后面工具失败/被中止,"尝试过"这个事实也留下了证据 let router = &self.step_context.tool_router; // 从 step 里拿路由器(注册表 + spec) let supports_parallel = router.tool_supports_parallel(&call); // ★查该工具的并发声明:true=可与其他调用并行,false=必须独占 let tool_runtime = router.tool_runtime(&call.tool_name); // 取工具运行时句柄(可能为 None,后面会判空) let router = Arc::clone(router); // 克隆 Arc 进任务——spawn 出去的 future 不能借用栈上的东西 let session = Arc::clone(&self.session); // 同上:会话句柄进任务 let step_context = Arc::clone(&self.step_context); // step 上下文进任务(生命周期延长,见第二节注释) let turn = Arc::clone(&step_context.turn); // turn 句柄:中止通知和遥测都要用 let tracker = Arc::clone(&self.tracker); // diff 追踪器进任务 let lock = Arc::clone(&self.parallel_execution); // ★门控锁进任务——所有并发控制都靠它 let invocation_cancellation_token = cancellation_token.clone(); // 每个调用持有同一个令牌的克隆,中止时一起触发 let started = Instant::now(); // 记录分发起点:计时守卫的基准时刻 let tool_call_timing_guard = // RAII 计时守卫:drop 时自动打一条带三段耗时的日志(第六节细讲) ToolCallTimingGuard::capture(started, &session.thread_id, &turn.sub_id, &call, &source); // capture 可能返回 None——code-mode 嵌套调用不单独计时,避免重复计数 let execution_started_at = tool_call_timing_guard // 从守卫里取出"执行开始时刻"的共享槽位 .as_ref() // Option 引用 .map(|timing| Arc::clone(&timing.execution_started_at)); // 克隆 OnceLock:任务通过它回填"真正开跑"的时刻 let abort_session = Arc::clone(&session); // 中止分支要用的会话句柄(提前克隆,避免 move 冲突) let abort_source = source.clone(); // 中止通知需要来源信息 let abort_turn = Arc::clone(&turn); // 中止通知需要 turn let terminal_outcome_reached = Arc::new(AtomicBool::new(false)); // ★终态标志:任务一旦产出最终结果就置 true——用来解决"用户中止 vs 任务刚好完成"的竞态(第五节) let dispatch_terminal_outcome_reached = Arc::clone(&terminal_outcome_reached); // 克隆一份给任务侧使用为什么这样设计:这段代码最值得注意的是 record_tool_call 放在分发之前——账本记录的是"尝试过",与成败无关。这是给 Code Mode / Memories 留的证据链:模型需要知道哪些调用真的发生过、参数是什么(截断到 8KB),哪怕工具后来被中止了。
📄 codex-rs/core/src/tools/parallel.rs (第 149-197 行)
let mut dispatch_handle = AbortOnDropHandle::new(tokio::spawn( // ★把整个工具执行 spawn 成独立任务;AbortOnDropHandle:句柄被 drop 时自动 abort——外层取消路径靠它杀任务 async move { // 异步闭包,move 语义拿走上面克隆的所有 Arc if let Some(tool_runtime) = tool_runtime // 运行时存在才需要等就绪(MCP 工具要先连上服务器) && let Some(readiness) = tool_runtime.wait_until_ready(&session) // wait_until_ready 返回 Option:None=已就绪,Some(future)=要等它完成 { // let-chains 两条件都成立才进入 readiness.await; // ★阻塞到工具真正可用——MCP 连接建立、扩展初始化都在这里完成,避免"调用发出但服务器没连上"的竞态 } // 就绪等待结束 let guard = if supports_parallel { // ★★并发门控核心:按工具的并发声明选锁模式 Either::Left(lock.read().await) // 支持并行 → 拿读锁:多个只读调用可以同时持有,真正并发执行 } else { // 不支持并行(默认值就是 false) Either::Right(lock.write().await) // 拿写锁:独占——所有写操作、以及未声明并发的工具都在这排队 }; // guard 存活到任务结束才释放锁;Either 包装是为了让两个分支类型统一 if let Some(execution_started_at) = execution_started_at { // 计时槽位存在(直接调用才有) let _ = execution_started_at.set(Instant::now()); // ★回填"执行开始时刻"=通过门控的时刻——dispatch 耗时与 handler 耗时的分界线就在这一下 set() } // OnceLock 只能写一次,重复 set 被忽略 let result = router // 真正分发到具体工具处理器 .dispatch_tool_call_with_terminal_outcome( // 带终态标志的分发:审批→沙箱→执行全在这条链里(第七节) session, // 会话 step_context, // step 上下文 invocation_cancellation_token, // 取消令牌透传进 handler tracker, // diff 追踪器 dispatch_call, // 调用本体 source, // 来源 dispatch_terminal_outcome_reached, // ★终态标志:handler 产出最终结果时置 true,中止分支靠它判断"是否已完成" ) .instrument(dispatch_span.clone()) // 挂上分布式追踪 span(otel.name/tool_name/thread.id/call_id) .await; // 等工具执行完——这是整个任务里最耗时的一步 drop(guard); // ★显式释放锁:不等任务收尾,结果一拿到就让出并发位,后面的调用能立刻进来 if !matches!(&result, Err(FunctionCallError::Fatal(_))) { // fatal 错误会直接抛给上层、不产生工具输出——它没有"就绪事件" call_trace::result_ready( // ★记录"结果已就绪":call_trace 用它算端到端延迟(received→ready) thread_id, // 线程 id &turn.sub_id, // turn id &dispatch_tool_name, // 工具名 &dispatch_call_id, // call_id trace_source, // direct / code-mode 口径 ); // 就绪事件落账 } // fatal 分支跳过:它走 Err 通道,由调用方处理 result // 把结果(Ok=工具输出 / Err=可回复给模型的业务错误)交回外层 select! } .in_current_span(), // 任务继承当前 span——日志和 trace 能串成一条链)); // spawn 结束,拿到 AbortOnDropHandleasync move { // ★外层 future:select! 在"任务完成"与"用户取消"之间赛跑 let _tool_call_timing_guard = tool_call_timing_guard; // 守卫放进作用域——无论哪条分支退出,drop 时都会打计时日志(RAII) tokio::select! { // 两个分支谁先就绪走谁 res = &mut dispatch_handle => res.map_err(Self::tool_task_join_error)?, // 任务正常完成:JoinError(panic/被abort)转成 Fatal 错误上抛 _ = cancellation_token.cancelled() => { // ★用户中止分支:Esc / turn 取消都走这里 if terminal_outcome_reached.load(Ordering::Acquire) || dispatch_handle.is_finished() { // ★竞态裁决:任务已产出终态结果、或已经跑完—— dispatch_handle.await.map_err(Self::tool_task_join_error)? // 那就老老实实取真实结果,绝不伪造"aborted"(见第五节) } else { // 否则才走真正的中止路径 let secs = started.elapsed().as_secs_f32().max(0.1); // 计算已耗时(秒),下限 0.1——避免日志里出现 0.0s 的误导值 abort_dispatch_span.record("aborted", true); // 在 trace span 上打 aborted=true:排查时一眼看出这次调用被中止了 dispatch_handle.abort(); // ★杀任务:AbortOnDropHandle 保证 handler 里的 await 立刻收到取消 match dispatch_handle.await { // 等它死透,顺便看最后状态 Ok(result) => return result, // 极端竞态:abort 前刚好跑完——取真实结果(宁可成功也不谎报中止) Err(err) if err.is_cancelled() => {} // 被我们 abort 的:预期内,继续走中止响应 Err(err) => return Err(Self::tool_task_join_error(err)), // 其他 panic:转 Fatal 上抛 } // await 结束 let response = Self::aborted_response(&call, secs); // 构造"被用户中止"的工具输出(消息里带耗时,见第五节) call_trace::result_ready( // 中止也算一种终态:同样记就绪事件,延迟统计不断链 thread_id, &abort_turn.sub_id, &call.tool_name, &call.call_id, trace_source, // 参数同上 ); // 落账 notify_tool_aborted( // ★通知生命周期钩子(hooks 系统):on_tool_finish(outcome=Aborted)——扩展可以据此清理资源 abort_session.as_ref(), // 会话 abort_turn.as_ref(), // turn call.call_id.as_str(), // call_id &call.tool_name, // 工具名 abort_source, // 来源 ) .await; // 等钩子执行完(它们可能做异步清理) Ok(response) // 把"aborted by user after Xs"作为正常结果返回——模型会看到这条输出并自行调整策略 } // 中止分支结束 }, // select! 第二分支结束 } // select! 结束}.in_current_span() // 外层 future 也挂上当前 span,保持 trace 连续为什么这样设计:这是全文最核心的一段。三个决策值得记住:① RwLock 而不是 Semaphore(N)——读/写两种模式天然对应"只读并发 / 写独占",不需要人为定并发数;② 锁在 dispatch 之前获取、结果拿到就释放(drop(guard) 紧跟 await)——临界区覆盖整个 handler 执行期,保证写操作真的互斥,而不是只在入口排队;③ select! + terminal_outcome_reached 把"用户中止"和"任务完成"的竞态显式裁决:先查终态标志再决定要不要伪造 aborted——顺序反了就会把成功误报成失败。
🔑 关键洞察:"并行"不是全局开关,而是每个工具自己声明的。CoreToolRuntime trait 里 supports_parallel_tool_calls() 默认返回 false——没声明者一律走写锁串行。这是 fail-safe:新工具接入时忘了声明,代价只是慢一点,而不是数据错乱。
四、FuturesOrdered:并行执行,顺序收集
任务被 spawn 出去之后,谁来收结果?答案在采样循环里(codex-rs/core/src/session/turn.rs):
📄 codex-rs/core/src/session/turn.rs (第 2458-2461 行)
let mut in_flight: FuturesOrdered<InFlightFuture<'static>> = FuturesOrdered::new(); // ★保序队列:futures 按 push_back 的顺序产出结果,与完成先后无关let mut needs_follow_up = false; // 本轮结束后是否需要再发起一次模型请求(工具调用都会置 true)let mut last_agent_message: Option<String> = None; // 记录最后一条 agent 消息:turn 结束时用于总结/展示let mut active_item: Option<TurnItem> = None; // 当前正在流式输出的条目(TUI 渲染用)📄 codex-rs/core/src/session/turn.rs (第 2635-2641 行)
if let Some(tool_future) = output_result.tool_future { // 流式事件里解析出一个工具调用(handle_output_item_done 已 spawn 了任务) in_flight.push_back(tool_future); // ★按模型发出顺序入队——第1个调用的 future 永远排在第2个前面,不管谁先跑完} // 没有工具调用则跳过if let Some(agent_message) = output_result.last_agent_message { // 顺带记录 agent 消息(非工具条目) last_agent_message = Some(agent_message); // 覆盖保存最后一条} // 消息记录结束needs_follow_up |= output_result.needs_follow_up; // ★只要出现过工具调用,本轮结束后必须再请求一次模型——把工具输出喂回去让它继续推理📄 codex-rs/core/src/session/turn.rs (第 2356-2384 行)
async fn drain_in_flight( // 排空所有在途工具任务——流结束(Completed 事件)后调用 in_flight: &mut FuturesOrdered<InFlightFuture<'static>>, // 保序队列 sess: Arc<Session>, // 会话:写历史用 step_context: &StepContext, // step 上下文:取 turn 和 model_info) -> CodexResult<()> { // 返回结果,错误上抛终止 turn let turn_context = &step_context.turn; // 取出 turn 引用 while let Some(res) = in_flight.next().await { // ★按入队顺序逐个取:即使第3个任务先完成,也要等第1、2个的结果先被消费 match res { // 每个 future 的产出是 Result<ResponseItemEnvelope, CodexErr> Ok(envelope) => { // 工具输出(含 aborted 响应——它也是正常 envelope) mark_thread_memory_mode_polluted_if_external_context( // 若工具引入了外部上下文,标记记忆模式"被污染"(Memories 系统的安全边界) sess.as_ref(), turn_context.as_ref(), &envelope.item, // 会话 / turn / 具体条目 ) .await; // 等标记完成 sess.record_annotated_conversation_items( // ★把工具输出按序写入对话历史——下一轮模型请求会带上它 turn_context, // turn &step_context.settings.model_info, // 模型信息:决定注解格式(不同模型的 history schema 有差异) vec![envelope], // 单条包装成批 ) .await; // 落盘完成 } // Ok 分支结束 Err(err) => { // fatal 错误(任务 panic / JoinError):没有可写入的输出 error_or_panic(format!("in-flight tool future failed during drain: {err}")); // 记日志并按配置决定是否 panic——fatal 意味着系统状态不可信,宁可炸掉 } // Err 分支结束 } // match 结束 } // 队列排空 Ok(()) // 全部落账成功为什么这样设计:FuturesOrdered 是"并行执行 + 顺序语义"的标准解法:所有任务同时跑(性能),但结果按 push_back 的顺序产出(正确性)。模型看到的工具输出序列 = 它发出调用的序列,历史因此确定、可重放。对比一下如果用 FuturesUnordered:快是快了,但两个写操作的结果顺序随机,模型下一轮推理的输入就不确定了——对 agent 来说这是不可接受的。
五、中止语义:宁可取真实结果,也不谎报"被中止"
📄 codex-rs/core/src/tools/parallel.rs (第 272-290 行)
fn aborted_response(call: &ToolCall, secs: f32) -> AnyToolResult { // 构造"被中止"的工具输出 AnyToolResult { // 统一结果包装:call_id + payload + 具体输出 call_id: call.call_id.clone(), // 回显原调用的 id——模型靠它把输出对回调用 payload: call.payload.clone(), // 保留原始 payload 类型(Function/Custom/ToolSearch),决定输出走哪个 ResponseItem 变体 result: Box::new(AbortedToolOutput { // ★专用输出类型:lifecycle 钩子和历史渲染都能识别"这是中止,不是失败" message: Self::abort_message(call, secs), // 人类可读的中止消息(见下) }), // 输出构造完 post_tool_use_payload: None, // 没有 post-tool-use 附加数据 } // AnyToolResult 结束}fn abort_message(call: &ToolCall, secs: f32) -> String { // 生成中止文案——按工具定制措辞 if call.tool_name.is_default_namespace() && call.tool_name.name == "exec_command" { // exec_command 是用户最熟悉的长任务,给更详细的反馈 format!("Wall time: {secs:.1} seconds\naborted by user") // 带墙钟时间:用户能判断"跑了多久被掐的"——决定要不要换个方式重试 } else { // 其他工具用统一短文案 format!("aborted by user after {secs:.1}s") // 同样带上耗时,模型据此调整策略(比如拆小任务) } // match 结束}为什么这样设计:注意中止响应走的是 Ok(response) 而不是 Err——对模型来说"工具被用户中止"是一条正常的工具输出,它会读到 "aborted by user after 12.3s" 并自行决定下一步(换命令、拆任务、或询问用户)。只有 Fatal 错误才走 Err 通道终止整个 turn。这个区分很关键:中止是用户的意图,不是系统故障。
六、计时守卫:dispatch 耗时 vs handler 耗时
📄 codex-rs/core/src/tools/parallel.rs (第 293-319 行)
impl ToolCallTimingGuard { // RAII 计时守卫:构造时记起点,drop 时打日志——不依赖调用方记得"收尾" fn capture( // 工厂方法:返回 Option——不满足条件就不创建守卫(零开销) started_at: Instant, // 分发起点 conversation_id: &impl std::fmt::Display, // 会话 id(泛型 Display,避免强制 String) turn_id: &str, // turn id call: &ToolCall, // 调用本体:取 call_id / tool_name source: &ToolCallSource, // 来源:决定是否计时 ) -> Option<Self> { // None=不计时 if !matches!( // ★两个条件任一不满足就放弃计时: source, // ① code-mode 嵌套调用不单独计——它的外层 direct 调用耗时已经包含了它,重复计会让延迟统计虚高 ToolCallSource::Direct | ToolCallSource::DirectPlaintextMessage ) || !tracing::enabled!(tracing::Level::INFO) { // ② INFO 级别没开就别白建对象——守卫的唯一用途就是打日志 return None; // 零开销退出 } // 条件检查结束 Some(Self { // 创建守卫 started_at, // 起点时刻 execution_started_at: Arc::new(OnceLock::new()), // ★共享槽位:任务通过门控后回填"真正开跑"的时刻——dispatch/handler 的分界线 conversation_id: conversation_id.to_string(), // 落盘成 String(Display 借用不能跨 await) turn_id: turn_id.to_string(), // 同上 call_id: call.call_id.clone(), // 调用 id:日志关联键 tool_name: call.tool_name.clone(), // 工具名:按工具聚合延迟分布 }) // 守卫构造完 } // capture 结束📄 codex-rs/core/src/tools/parallel.rs (第 322-342 行)
impl Drop for ToolCallTimingGuard { // drop 时自动结算——无论正常完成、中止还是 panic,日志都打得出 fn drop(&mut self) { // RAII 入口 let completed_at = Instant::now(); // 终点时刻 let execution_started_at = self // ★一次性快照执行开始时刻:防止"并发中另一个 dispatch 正在 set()"导致同一条日志内部不一致 .execution_started_at // OnceLock 引用 .get() // Option<&Instant> .copied() // 拷出 Instant(Copy) .filter(|execution_started_at| *execution_started_at <= completed_at); // 防御:时刻异常(晚于终点)就丢弃,宁缺毋错 let duration_ms = |duration: std::time::Duration| u64::try_from(duration.as_millis()).ok(); // Duration→毫秒的转换闭包:溢出返回 None 而不是 panic let total_duration_ms = duration_ms(completed_at.duration_since(self.started_at)); // ★总耗时 = 终点 - 分发起点(含排队等待) let dispatch_duration_ms = execution_started_at.map_or_else( // ★dispatch 耗时 = 从发起到通过门控的"排队时间" || total_duration_ms, // 没拿到执行时刻(任务还没进门控就被中止)→ 用总耗时兜底:这段时间全算等待 |execution_started_at| { // 拿到了 → duration_ms(execution_started_at.duration_since(self.started_at)) // 起点到开跑 = 纯排队/就绪等待 }, // map_or_else 结束 ); let handler_duration_ms = execution_started_at.map_or(Some(0), |execution_started_at| { // ★handler 耗时 = 从开跑到完成 duration_ms(completed_at.duration_since(execution_started_at)) // 没拿到执行时刻 → 记 0(任务根本没跑起来) }); // 三段耗时齐了:total = dispatch + handler,运维一眼看出是"排队慢"还是"工具本身慢"为什么这样设计:把一次工具调用拆成 dispatch(排队+就绪等待)和 handler(真正执行)两段,是排障的关键:如果 dispatch 高,说明并发门控在排队(写锁竞争或 MCP 连接慢);如果 handler 高,那是工具本身的问题。OnceLock + 快照的写法保证了"一条日志内部自洽"——这在多任务并发下不是小事。
七、编排层:审批 → 沙箱 → 失败升级重试
门控锁放行之后,任务进入 ToolOrchestrator::run(codex-rs/core/src/tools/orchestrator.rs)——这是第 19 讲审批流的"执行侧"。核心是两次尝试:先按策略进沙箱跑,被拒且允许升级时再裸跑一次。
📄 codex-rs/core/src/tools/orchestrator.rs (第 175-235 行)
let requirement = tool.exec_approval_requirement(req).unwrap_or_else(|| { // 工具自己声明审批需求;没声明者用默认策略推导 default_exec_approval_requirement(approval_policy, &file_system_sandbox_policy) // 按 approval_policy + 文件系统沙箱策略算出 Skip / Forbidden / NeedsApproval});match &requirement { // ★审批三态分派——这是编排的第一步,先于任何执行 ExecApprovalRequirement::Skip { .. } => { // 免审批(如只读工具、已放行的命令) if strict_auto_review { // 但"严格自动审查"模式下,连 Skip 也要过 Guardian 复核——安全策略压过便利配置 let action = tool.approval_action(req, &tool_ctx.call_id) // 构造审批动作(描述这次要做什么) .map_err(|err| { ToolError::Rejected(format!("could not prepare approval action: {err}")) })?; // 构造失败=拒绝执行,fail loud let approval_ctx = ApprovalContext { // 审批上下文:Guardian 审查需要的全部信息 review_context: GuardianReviewContext::from(&tool_ctx.step_context), // 从 step 推导审查视角(第26讲细讲) cancellation_token: Some(tool_ctx.cancellation_token.clone()), // 用户可以在审批等待期间取消 call_id: tool_ctx.call_id.clone(), // 关联调用 tool_name: tool_ctx.tool_name.clone(), // 工具名 strict_auto_review, // 标记这是严格模式触发的审查 approval_reason: None, // Skip 场景没有"需要审批的原因" retry_reason: None, // 首次尝试,无重试原因 network_approval_context: None, // 不涉及网络审批 }; tool_ctx.session.request_approval(action, approval_ctx).await?; // ★阻塞等 Guardian/用户裁决——拒绝则 Err 上抛,整个调用终止 already_approved = true; // 标记已批准:后面沙箱失败重试时可能复用(见下) } else { // 普通 Skip:直接放行 otel.tool_decision(&tool_ctx.tool_name, otel_ci, &ReviewDecision::Approved, Some(ToolDecisionSource::Config)); // 遥测记一笔"配置自动批准"——审计链完整 } // Skip 分支结束 } ExecApprovalRequirement::Forbidden { reason } => { // 明确禁止(策略黑名单):不执行、不询问,直接拒绝 return Err(ToolError::Rejected(reason.clone())); // 错误信息原样回给模型——它会据此换方案 } ExecApprovalRequirement::NeedsApproval { reason, .. } => { // 需要审批(写操作、网络访问等) let action = tool.approval_action(req, &tool_ctx.call_id) // 构造审批动作 .map_err(|err| { ToolError::Rejected(format!("could not prepare approval action: {err}")) })?; // fail loud let approval_ctx = ApprovalContext { // 上下文同 Skip 分支,但带上原因 review_context: GuardianReviewContext::from(&tool_ctx.step_context), // 审查视角 cancellation_token: Some(tool_ctx.cancellation_token.clone()), // 可取消 call_id: tool_ctx.call_id.clone(), // 关联调用 tool_name: tool_ctx.tool_name.clone(), // 工具名 strict_auto_review, // 严格模式标记 approval_reason: reason.clone(), // ★为什么需要审批——展示给用户/Guardian 的核心理由 retry_reason: None, // 首次尝试 network_approval_context: None, // 网络审批上下文稍后在失败路径里补(见下) }; tool_ctx.session.request_approval(action, approval_ctx).await?; // ★等裁决:用户点"允许"或 Guardian 自动批准才继续 already_approved = true; // 标记已批准 } // NeedsApproval 分支结束} // match 结束——到这里,审批关卡全部通过(或被拒绝)📄 codex-rs/core/src/tools/orchestrator.rs (第 357-443 行)
if !tool.escalate_on_failure() { // ★工具声明"失败不升级"(如某些只读 MCP 工具)→ 沙箱拒绝就是最终结果 otel.sandbox_outcome(&otel_tn, otel_ci, "denied", initial_duration, /*escalated_duration*/ None); // 遥测记 denied:第一次尝试的耗时留档,无升级段 return Err(ToolError::Codex(err)); // 原样上抛——模型看到沙箱拒绝信息并自行调整}if !tool.wants_no_sandbox_approval(approval_policy) { // 审批策略不允许"无沙箱重试"(如 Never)→ 同样直接失败 let allow_on_request_network_prompt = matches!(approval_policy, AskForApproval::OnRequest) // OnRequest 策略 + && network_approval_context.is_some() // 且这次拒绝是网络策略触发的 → 允许弹一次"放行该域名"的询问 && matches!(default_exec_approval_requirement(approval_policy, &file_system_sandbox_policy), ExecApprovalRequirement::NeedsApproval { .. }); // 且默认需求就是 NeedsApproval(避免绕过审批) if !allow_on_request_network_prompt { // 不满足豁免条件 → otel.sandbox_outcome(&otel_tn, otel_ci, "denied", initial_duration, /*escalated_duration*/ None); // 记 denied return Err(ToolError::Codex(err)); // 上抛 } // 否则落入下面的升级路径(网络审批场景)}let retry_reason = if let Some(network_approval_context) = network_approval_context.as_ref() { // ★构造重试理由:优先用具体的域名信息 format!("Network access to \"{}\" is blocked by policy.", network_approval_context.host) // 告诉用户"访问 X 被策略拦了,要放行吗?"——比泛泛的"命令失败"可决策得多} else { // 非网络类拒绝 → build_denial_reason_from_output(output.as_ref()) // 从沙箱输出推导原因(当前实现是稳定短文案,预留启发式演进空间)};let bypass_retry_approval = !strict_auto_review // ★严格自动审查下:第一次的批准只覆盖"有沙箱的那次尝试"——裸跑必须重新过 Guardian && tool.should_bypass_approval(approval_policy, already_approved) // 工具允许复用已有批准(如 OnRequest + 已批过一次) && network_approval_context.is_none(); // 且不是网络审批场景(网络放行是独立决策,不能搭便车)if !bypass_retry_approval { // 需要重新审批 → let approval_reason = match &requirement { // 从原始需求里取原因文案 ExecApprovalRequirement::NeedsApproval { reason, .. } => reason.clone(), // 有原因就带上 ExecApprovalRequirement::Skip { .. } | ExecApprovalRequirement::Forbidden { .. } => None, // 否则留空(重试理由 retry_reason 已经说明了情况) }; let action = tool.approval_action(req, &tool_ctx.call_id) // 重新构造审批动作 .map_err(|err| { ToolError::Rejected(format!("could not prepare approval action: {err}")) })?; // fail loud let approval_ctx = ApprovalContext { // 第二次审批的上下文——比第一次多了两个关键字段 review_context: GuardianReviewContext::from(&tool_ctx.step_context), // 审查视角不变 cancellation_token: Some(tool_ctx.cancellation_token.clone()), // 可取消 call_id: tool_ctx.call_id.clone(), // 同一个调用 id:两次尝试在审计上是一条链 tool_name: tool_ctx.tool_name.clone(), // 工具名 strict_auto_review, // 严格模式标记 approval_reason, // 原始审批原因 retry_reason: Some(retry_reason), // ★"为什么这次要重新问你"——沙箱拒绝的具体理由 network_approval_context: network_approval_context.clone(), // ★网络放行上下文:UI 据此渲染"允许访问该域名"按钮(第27讲细讲) }; tool_ctx.session.request_approval(action, approval_ctx).await?; // ★等第二次裁决——用户明确点头才裸跑}let retry_sandbox_requested = !unsandboxed_allowed && sandbox_manager.should_sandbox(&permissions, sandbox_preference, managed_network_active); // 重试是否还要沙箱:策略不允许裸跑时,重试也进沙箱(只是换了参数)let retry_sandbox = if retry_sandbox_requested && !executor_managed_process_sandbox { // 需要且不是执行器自管沙箱 → sandbox_manager.select_initial(&permissions, sandbox_preference, sandbox_config.windows_sandbox_level, managed_network_active) // 重新选沙箱类型(bwrap / landlock / seatbelt,第21-23讲细讲)} else { // 否则 SandboxType::None // ★裸跑:无沙箱——这是"升级"的实质};let retry_attempt = SandboxAttempt { sandbox: retry_sandbox, sandbox_requested: retry_sandbox_requested, /*…其余字段同 initial_attempt,略…*/ network_denial_cancellation_token: None, network_proxy: None }; // 组装第二次尝试的参数:网络审批状态重置(重新走 begin_network_approval)let (retry_result, retry_deferred_network_approval) = Self::run_attempt(tool, req, tool_ctx, &retry_attempt, network_approval_spec).await; // ★★第二次执行——与第一次同一条 run_attempt 路径,只是沙箱参数不同match retry_result { // 裁决第二次结果 Ok(output) => { // 裸跑成功 → otel.sandbox_outcome(&otel_tn, otel_ci, "escalated", initial_duration, Some(escalated_duration)); // ★遥测记 escalated:两段耗时都留档——分析"多少次需要升级、升级后多快" Ok(OrchestratorRunResult { output, deferred_network_approval: retry_deferred_network_approval }) // 返回成功 + 可能挂起的网络审批(第27讲) } Err(err) => { // 裸跑也失败 → 最终失败 if let Some(outcome) = sandbox_outcome_from_tool_error(&err) { // 能归类出结果类型(denied/timed_out/signal)→ otel.sandbox_outcome(&otel_tn, otel_ci, outcome, initial_duration, Some(escalated_duration)); // 遥测记真实原因 + 两段耗时 } // 否则不重复记录 Err(err) // 上抛——模型看到最终错误,turn 继续(非 fatal) }}为什么这样设计:"两次尝试"是 Codex 沙箱哲学的执行体现:默认最严,失败再谈。第一次永远在策略允许的沙箱里跑;只有被明确拒绝、且工具声明可升级、且审批策略允许时,才请求第二次(更宽松)的批准——而且严格自动审查模式下,第二次的 Guardian 复核不可跳过。注意 retry_reason 和 network_approval_context 这两个字段:它们把"为什么失败"精确传递到 UI 层,用户看到的是 "Network access to \"api.example.com\" is blocked by policy" 而不是干巴巴的 "command failed"。
八、并发声明:谁允许并行?
📄 codex-rs/tools/src/tool_executor.rs (第 122-124 行)
fn supports_parallel_tool_calls(&self) -> bool { // trait 默认实现 false // ★默认串行:新工具不声明就排队——fail-safe,宁可慢不可错}📄 codex-rs/core/src/tools/handlers/view_image.rs (第 80-82 行)
fn supports_parallel_tool_calls(&self) -> bool { // view_image 覆写默认值 true // ★纯读取(解码图片给模型看),无副作用 → 安全并行}📄 codex-rs/core/src/tools/handlers/mcp.rs (第 128-131 行)
fn supports_parallel_tool_calls(&self) -> bool { // MCP 工具:自己不拍板 self.tool_info.supports_parallel_tool_calls // ★转发给 MCP server 的声明——服务器最清楚自己的工具是否线程安全(如只读查询类)}📄 codex-rs/core/src/tools/registry.rs (第 486-490 行)
pub(crate) fn supports_parallel_tool_calls(&self, name: &ToolName) -> Option<bool> { // 注册表查询入口(router.tool_supports_parallel 的底层) let tool = self.tools.get(&name.clone().with_default_namespace())?; // 按名字找工具;找不到返回 None → 上层 unwrap_or(false) 兜底为串行 Some(tool.exposure != ToolExposure::Hidden && tool.runtime.supports_parallel_tool_calls()) // ★双重条件:隐藏工具(内部机制)一律不并行 + 运行时自己的声明}为什么这样设计:并发能力是工具的属性而不是全局配置——view_image、tool_search 这类纯读操作声明 true;exec_command(写文件系统)、apply_patch(改代码)保持默认 false。MCP 工具则把决定权交给服务器:Codex 不替第三方判断线程安全。查询链路上还有两道保险:隐藏工具强制串行、未注册名字兜底串行。
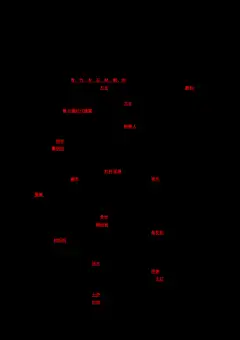
九、对比表:并发能力与执行语义
为什么这样设计:这张表浓缩了本讲的分工:声明层(谁可并行)在 trait + registry,调度层(怎么并发)在 parallel.rs 的 RwLock,收集层(顺序保证)在 turn.rs 的 FuturesOrdered,策略层(审批/沙箱/升级)在 orchestrator.rs。四层各管一段,互不越权。
十、数据流:一次并行工具调用的完整生命周期
并行执行 + 保序收集(handle_tool_call_with_source → drain_in_flight)
① 接收:流式事件 → handle_output_item_done
模型每发出一个工具调用,立即 spawn 任务并入 in_flight 队列——不等其他调用。
▼
② 记账:record_tool_call(分发前)
调用证据先落账本(参数截断 8KB),成败中止都不影响"尝试过"的事实。
▼
③ 门控:RwLock 读/写锁
supports_parallel=true → 读锁并发;false(默认)→ 写锁独占排队。
▼
④ 编排:ToolOrchestrator::run
审批三态分派 → 沙箱首试;被拒且可升级 → 二次审批 + 裸跑重试。
▼
⑤ 竞态裁决:select! + terminal_outcome_reached
用户中止 vs 任务完成赛跑:已出终态取真实结果,否则 abort + "aborted by user"。
▼
⑥ 收集:FuturesOrdered → drain_in_flight
流结束后按模型发出顺序逐个落历史,needs_follow_up=true 触发下一轮请求。
为什么这样设计:整条链路里没有任何"全局锁"或"单线程工具池"——并发域被精确限定在 step 内,顺序性由队列而非执行顺序保证。这正是 Rust + tokio 的强项:用类型(RwLock、FuturesOrdered)和 RAII(计时守卫、AbortOnDropHandle)把并发正确性写进结构里,而不是靠约定。
十一、小结与下一讲预告
本讲拆完了工具执行层的"并行三件套":RwLock 门控(parallel.rs)、FuturesOrdered 保序(turn.rs)、按工具声明的并发能力(registry.rs + handlers)。三个容易忽略的细节值得记住:① 中止竞态用 terminal_outcome_reached 显式裁决,宁可取真实结果也不谎报 aborted;② 计时守卫把一次调用拆成 dispatch/handler 两段,排队慢和工具慢一眼可分;③ orchestrator 的"两次尝试"里,严格自动审查模式下裸跑重试必须重新过 Guardian——安全策略压过便利。
下一讲(第 21 讲)进入沙箱本体:Sandbox Manager 与策略转换——看 Codex 如何把"权限声明"翻译成 bwrap / Landlock / Seatbelt 的具体参数。
📚 系列导航
← 第 19 讲:Tool Approvals 审批流 + 网络策略
→ 第 21 讲:Sandbox Manager 与策略转换
关注公众号「AI技术推荐官」获取更多源码解析内容