ARTICLE · 1179211
multica 源码 18:几百个迁移文件怎么安全地跑——数据库变更管理与版本兼容
跟着一次升级,从镜像拉起到老客户端对话,把每个时刻的守门机制走一遍(系列第 18 篇)
docker pull 拉下新镜像的这一秒,Multica 的数据库里躺着几百条已经记账的迁移,镜像里装着下一批要跑的。
从这里到流量重新进来,没有运维敲命令,没有人盯进度条,但每个时刻都有机制守着。
这是 multica 源码系列第 18 篇。素材还是那份数据库变更管理的研究报告(基于 main 分支 09a2410),这次换个走法:不按机制分类讲,跟着一次升级从头跑到尾。
先对个数。迁移版本号排到了 432,最新一个叫 432_agent_conversation_starters_rename。因为 148 之前的历史版本号有重复,实际的 up 迁移文件是 465 个,down 方向还有成对的另一份。
发布之前,门禁先跑完
升级的第一站不在生产,在 CI。每次合并前,流水线起一个全新的 pg17 容器,把 465 个迁移从头到尾跑一遍,跑不干净就合不进去。
查询代码用 sqlc 生成,生成物必须和迁移同步提交,diff 不干净同样过不了门禁。两道检查盯的都是同一件事:/schema 和代码,不允许漂移。
发布由 git tag 驱动。一个镜像等于一份迁移集,等于一个确定性检查,不存在独立的 schema 版本号。
后面所有环节都不需要回答「数据库现在是什么版本」:镜像自己知道答案。
容器启动:先迁移,后起服务
新镜像的 entrypoint 只做两件事:先跑 migrate up,失败就以迁移的退出码终止容器;成功才启动服务进程。文档写得很直白:拉起新镜像就是迁移步骤,没有独立的升级命令。
数据库暂时不可达怎么办?entrypoint 在启动时写下一个时间戳,迁移器和服务进程共享同一个三分钟重试预算,退避从 1 秒涨到 30 秒,带抖动。
预算烧完还没连上,容器带着明确的原因退出。
这里有个我很欣赏的细节:只有瞬时错误才重试。连接类错误重试,SQL 错误立刻失败——把环境问题和代码问题分开处理,重试才不会变成灾难放大器。
一把咨询锁,把并发排成队
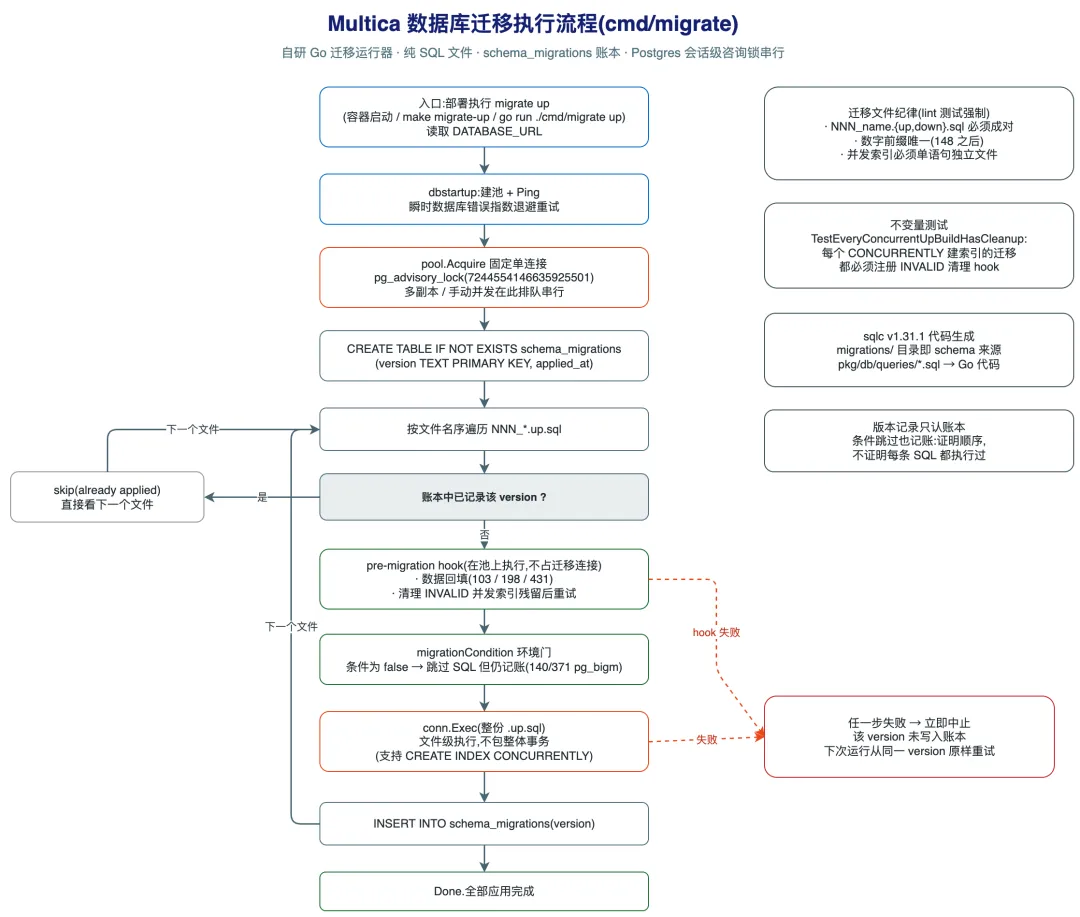
多副本同时扩容,两个 pod 同时跑迁移怎么办?整个迁移循环在一条固定连接上,先拿 Postgres 的会话级咨询锁 pg_advisory_lock,拿不到就排队。
后到的 pod 排队等前面的跑完,轮到自己时逐条对账,发现全部记过账,空转退出。Helm 的注释里专门写了这句:late-arriving pods queue and then no-op。
对着账本,一个文件一个文件过
账本是一张极简表:schema_migrations,只有 version 和 applied_at 两列。每个文件执行前查一次,记过就跳过;执行成功才写入。判断「哪些跑过」的标准,简单到不容易出错。
迁移循环刻意不包事务。代码注释给了原因:仓库大量使用 CREATE INDEX CONCURRENTLY,而 Postgres 不允许这条语句出现在事务块里。代价是一个文件失败后,从没记账的那个版本干净重试。
失败恢复有个不变量:150 多个用 CONCURRENTLY 建索引的迁移,全部登记在清理表里。重试前先 DROP 掉可能残留的 INVALID 索引,防止 IF NOT EXISTS 把半成品当成功。
漏登记会直接挂 CI,有专门的测试盯着。
数据回填不走迁移文件。103 前播种汇总数据、198 前回填 attribution 残留,都挂在 pre-hook 里,分批、幂等、可重跑。自托管实例卡在旧版本,migrate up 跑一遍就自愈。
还有一条容易踩的隐性契约:按条件跳过的迁移也记账。账本证明顺序,不证明每条 SQL 都执行过,所以后续迁移必须写幂等 DDL。在我看来,这是整个设计里最需要新人警惕的一条。
最危险的一段,拆成四步走
真正的硬骨头是收紧约束:既要老数据合规,又不能锁表。Multica 的做法是一套四部曲,以 attribution 约束为例,跨迁移 190 到 199。
190 先加一条带 NOT VALID 的过渡 CHECK:只改元数据、不扫表,但立即约束新写入。存量数据由带外任务回填。
197 以临时名加严格影子约束。198 执行 VALIDATE,这个锁级别不阻塞增删改。199 在同一次执行里删过渡、转正影子。
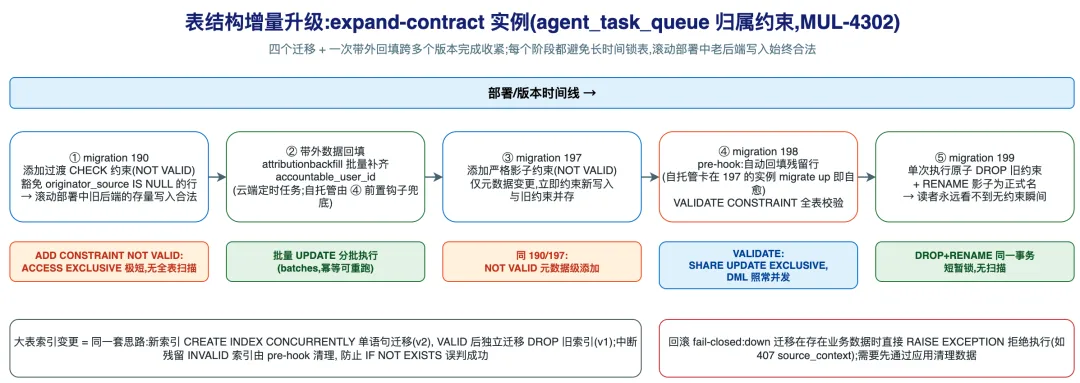
走完这四步,读者任何时候去读这张表,都不会观察到「没有约束」的瞬间。190 的迁移注释还逐一分析了滚动窗口里三类旧写入者为什么恰好被豁免条件覆盖——这种注释本身就是文档。
数数,然后放流量
迁移跑完,服务起来,流量什么时候放?/readyz 不看最大版本号,而是数账本里的记录数,和二进制内嵌的迁移清单对照,数量不够返回 503。
防的是一种阴险情况:乱序混进来的低版本迁移,被高版本号掩盖,数数才能发现。liveness 探针则完全不依赖数据库,注释写明数据库抖动不应该导致容器被杀。
有个坦率的现实:not_ready 时服务仍然处理流量,没有拦截中间件。把坏 schema 挡在负载均衡后面是探针的职责。这层依赖关系,读部署文档时值得画个圈。
新代码、老代码,共用一个新 schema
滚动窗口期,新旧 pod 同时在跑,数据库已经是最新 schema。老代码为什么不炸?加列规则很朴素:新列要么可空,要么带默认值,旧版本 INSERT 不写这些列也不会失败。
仓库宪法还有两条:禁止外键和级联删除,关系校验全放应用层;所有索引必须 CONCURRENTLY,且单语句独立成文件。三条全部指向同一个目标:滚动升级期间新旧代码共存。
「禁止外键」第一次看是反直觉的,看完动机才通:没有外键,删父行不会因锁级联拖垮大表。代价是 join 完整性和孤儿清理全靠应用层自觉,写数据路径时不能假设数据库会兜底。
半年前装的客户端,还在对话
服务端天天发版,桌面上装着的客户端可能是半年前的版本。Multica 的选择:全仓库不设硬性最低版本门禁。
请求头里的 X-Client-Version 每次都带,服务端读取但明确不做决策依据,注释写着 best-effort、可被伪造。版本信息只观测,不拦截。
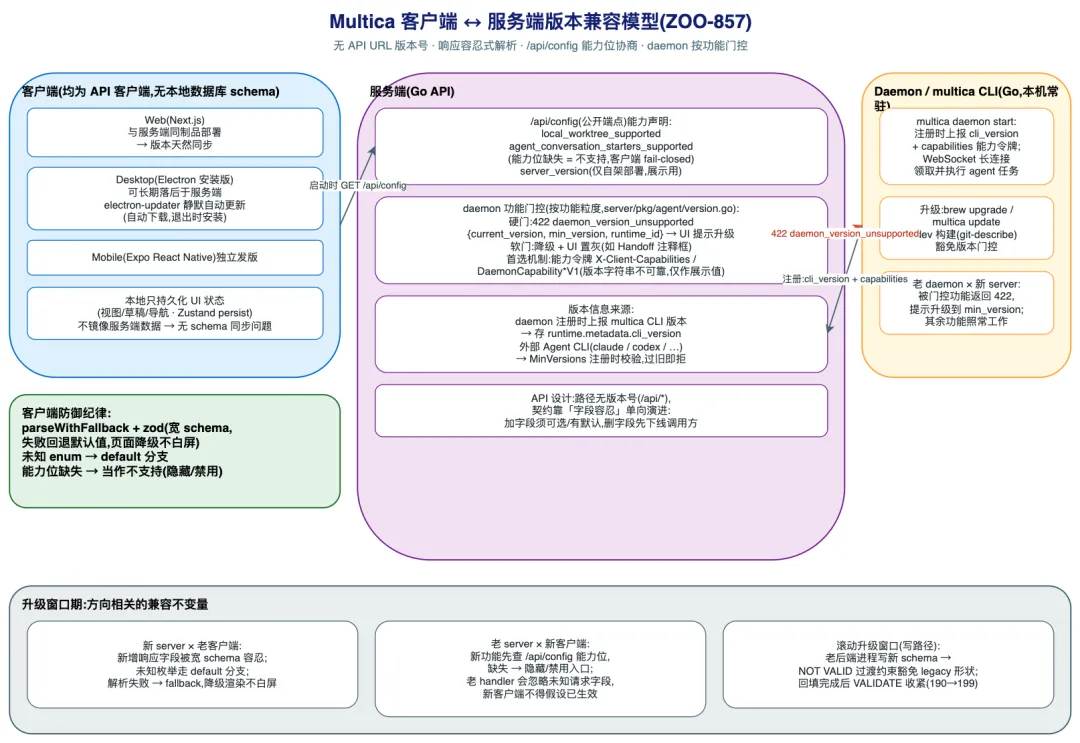
真正干活的是能力令牌。daemon 在每个请求里播报支持的 capability 列表,服务端解析时缺失即视为不支持,然后降级。
runtime 太老不支持 worktree 模式,任务在认领前取消并记录原因,不让老 daemon 用错误方式执行。
客户端这侧是另一套防御:所有进 UI 的响应先过 zod schema,解析失败走 parseWithFallback——记日志、返回兜底值、永不抛异常。全仓库 214 个非测试调用点,每个配一个刻意挑选的兜底形状。
兜底是逐端点定的:列表接口坏响应给空列表;单条 issue 的畸形响应反而抛错,因为单条数据没有安全的空形状。1075 行畸形响应测试,覆盖了历史上五类让桌面白屏的事故。
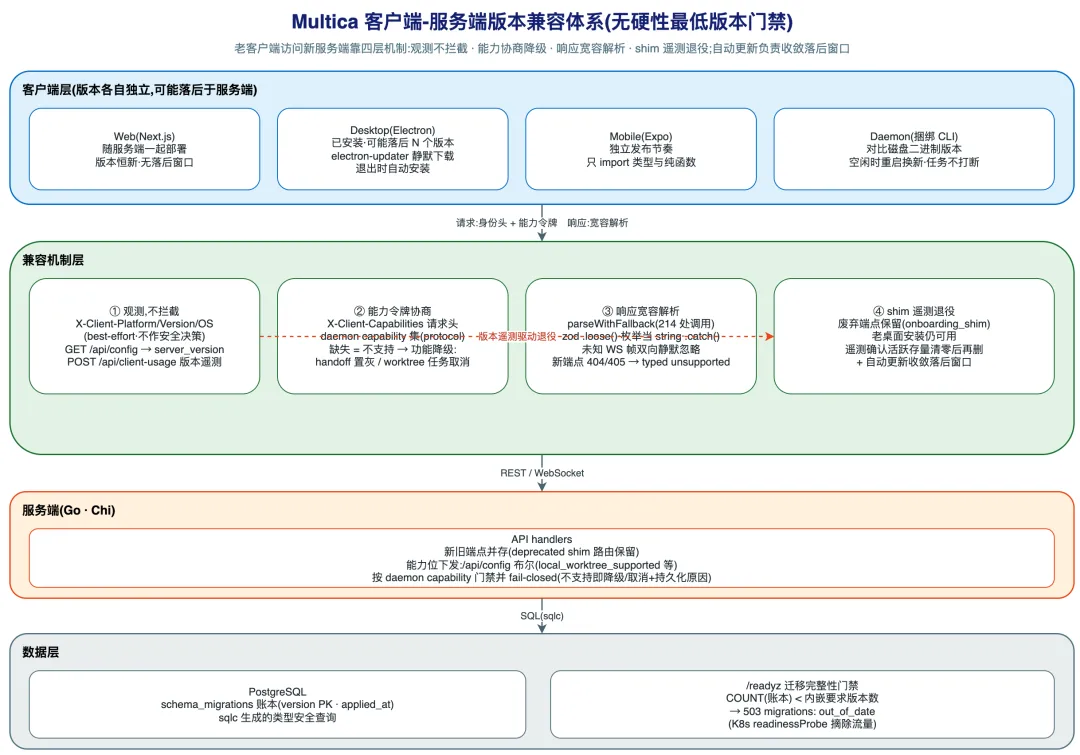
废弃端点的退役靠遥测:双轨保留,每日上报观察存量,活跃安装换代完成后才删代码。
桌面端没有本地数据库,单一事实源是服务端 Postgres,「客户端 schema 同步演进」这个问题被架构性消解了。
客户端要做的只剩跟上:electron-updater 静默下载、退出时安装;daemon 等任务跑完再换新二进制,运行中的任务绝不打断。
这条时间线的代价
把机制列完,也要把账单列出来。
账本证明顺序、不证明执行,幂等是隐性契约,没有工具兜底。迁移不包事务,多语句文件可能应用一半,危险操作必须拆成单语句。
没有 dry-run 和 schema diff。回滚完全依赖升级前的 pg_dump,down 迁移 fail-closed:407 的 down 在仍有业务数据时直接抛异常,拒绝执行。
我的整体判断:这套设计的安全感不来自那 875 行迁移器代码,来自配套纪律——lint 强制 up/down 成对,并发索引清理有全覆盖测试,CI 在全新库上复验。抽掉这些,自研迁移器只是个玩具。
适合谁参考?有耐心维护工程纪律的小团队。四部曲和并发索引清理的注释先例都在仓库里,值得对着迁移文件亲手读一遍。
你在升级窗口期踩过什么坑,留言区聊聊。