ARTICLE · 1181549
AI让代码产出增长240%,软件发布量只增长30%:中间卡在哪?
AI 帮程序员写出更多代码,这已经不太令人意外。
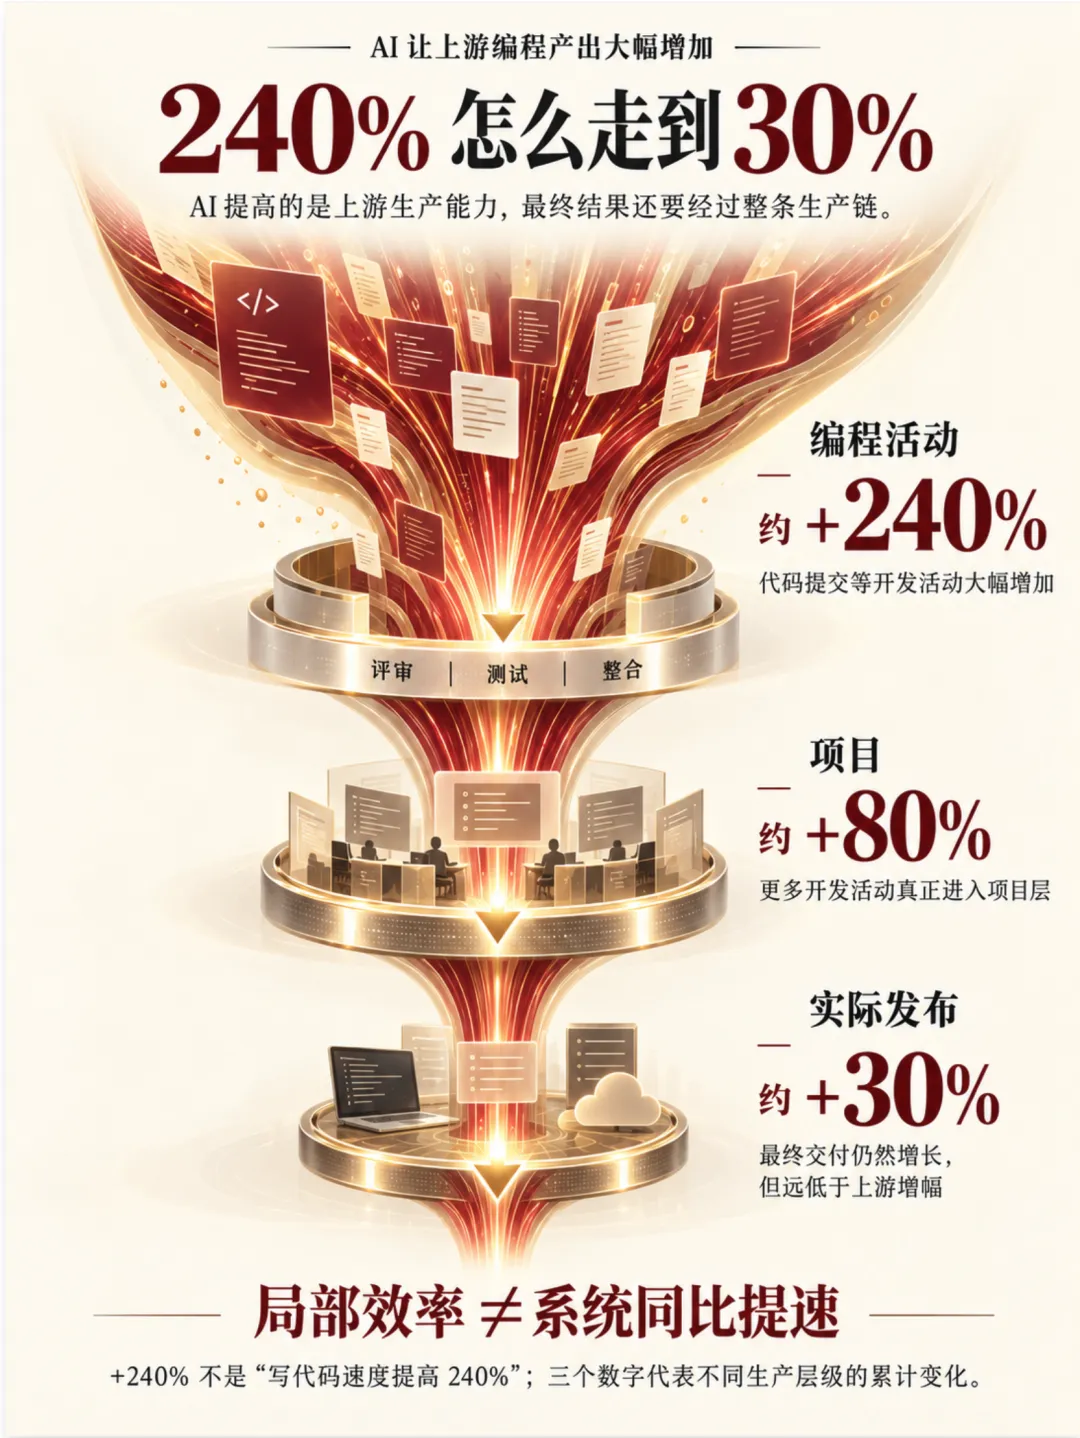
真正意外的是另一组数字:一项覆盖 50 万多名 GitHub 开发者的研究发现,随着 AI 编程工具从自动补全走向更强的 Agent,论文用代码提交次数(commits)衡量的编程活动,累计提升大约 240%;到了项目层,增幅约 80%;真正的软件发布,只增加了约 30%。
这里先把口径说清:+240% 不是“写代码速度提高 240%”,而是三代工具累计对应的代码提交活动变化;+30% 也不是“AI 生产力只有 30%”,而是实际发布这一层的增幅。
这篇 NBER 论文真正有意思的地方,不是再次证明“AI 能提效”,而是把问题往后追了一层:AI 把某一步做快以后,这部分生产力到底有多少能穿过整条生产链,最后变成真正交付和使用的东西?
一、AI Coding +240%,为什么走到发布只剩 +30%
我们平时谈 AI 生产力,很容易盯着最显眼的那一步。
写代码更快、生成文档更快、做图更快、写方案更快。这些都可能是真的,但它们测量的是一个局部任务。
软件开发却不是“代码写出来,工作就结束了”。
一段代码要真正变成用户能用的软件,后面还有评审、整合、测试、项目管理和发布。论文沿着这条链往后看,就看到一个清楚的现象:
编程环节的产出增长很大,但越接近最终交付,增幅越小。
这并不说明前面的 240% 是假的,也不能简单理解成其中大部分都“浪费了”。它说明的是另一件事:
一个环节突然快很多,整个系统不会自动按同样比例变快。
就像一家餐厅里,厨师切菜突然快了十倍,但烤箱、摆盘和出餐速度都没有变化,餐厅不可能因此多卖十倍的菜。
局部效率和系统吞吐量,本来就是两件事。
二、软件不是“写完代码就结束”
这也是这篇论文最值得带走的机制。
软件开发是一条相互依赖的生产链。前一道工序的产出,必须被后一道工序接住,才会继续向最终结果传递。
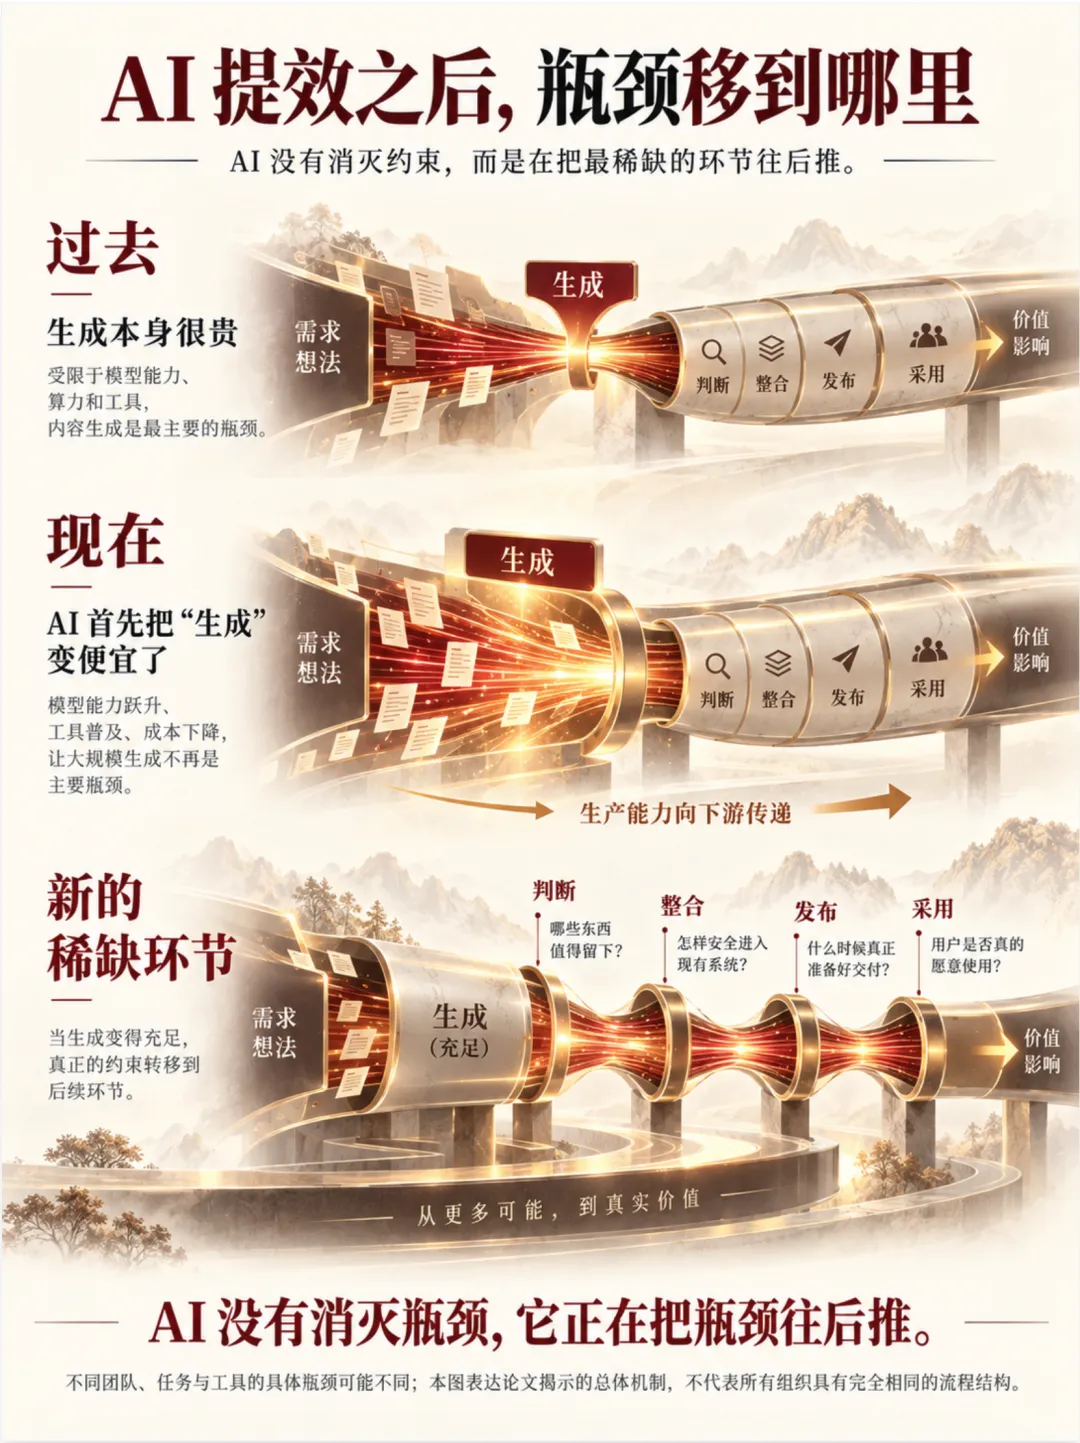
AI 最先大幅压低的是“生成”的成本。代码可以更快写出来,更多方案也可以更快被尝试。
但评审一段代码是否可靠,把它并入已有系统,处理冲突,确认测试结果,再把它真正发布出去,这些环节并没有因为代码生成快了 240% 就自动快 240%。
于是瓶颈开始移动。
过去最稀缺的可能是“把第一版写出来”;当这一步越来越便宜,真正限制系统速度的,就更可能变成
判断什么值得留下、什么能够安全合并、什么已经准备好交付。
AI 没有消灭瓶颈,只是把瓶颈往后推了。
三|生成变便宜以后,试错也会暴涨
如果只看到“240% 最后变成 30%”,很容易得出另一个错误结论:AI 生成了大量没用的代码。
论文里的行为数据反而给出了更有意思的解释。
开发者使用更强的 AI 工具后,不只是写得更多,也删得更多;创建更多分支,也删除更多分支。也就是说,AI 降低的不只是“写出一个答案”的成本,还降低了“先试一下,错了就扔掉”的成本。
以前一个想法如果实现成本很高,开发者可能根本不会去试。现在第一次实现变得便宜,团队可以同时探索更多路径,然后留下其中少数真正可用的方案。
所以,
没有进入最终发布的工作,不一定等于浪费。它也可能是更便宜的探索。
问题只是在于:当试错速度暴涨以后,筛选、判断和整合这些能力也必须跟上。否则,AI 带来的上游增量会越来越多地堆积在生产链中间。
四|AI 没有消灭瓶颈,只是把它往后推
论文还把这条链继续往用户端追了一步。
作者观察了多个软件市场,发现新应用的供给明显增加,但总的用户使用并没有同步增加。
这也不能简单解释成“AI 做出来的软件质量更差”。原因可能至少有两种:新增应用的平均吸引力确实有限,也可能只是应用变多以后,用户的发现、注意力和采用速度成为新的瓶颈。现有数据还不能把两种情况完全区分开。
但它再次提醒我们:
“做出来”仍然不是价值链的终点,“有人真正采用”才更接近最终结果。
这也是这篇研究最值得长期保留的一套判断方法。以后看到任何“AI 提效 30%、50%、200%”的数字,都可以先问三个问题:
它到底让哪一步变快了? 这部分增益传到下一步以后还剩多少? 最终交付和真实使用有没有一起增长?
这三问比单独争论“AI 到底有没有生产力”更有用。
当前证据已经足以说明,AI 在一些局部任务上的生产力提升可以非常大;但系统最终能获得多少,取决于后续环节是否一起变化。
所以,真正值得追踪的,不再只是 AI 能多快地产生东西,而是\
整个系统能多快地把这些产出变成真正被交付、被采用的结果。