ARTICLE · 1192308
UniAD 源码精读:一条查询链从跟踪串到规划,CVPR 2023 最佳论文怎么把碰撞率压下来
UniAD 源码精读:一条查询链从跟踪串到规划,CVPR 2023 最佳论文怎么把碰撞率压下来环视相机的自动驾驶车在路上跑,感知、预测、规划原本是三拨人三套系统:检测跟踪出框、预测模块接框算轨迹、规划器再消费轨迹——每一层接口都在丢信息,误差逐层放大。2022 年 12 月挂 arXiv、2023 年 6 月在温哥华拿下 CVPR 2023 最佳论文奖(IEEE 计算机学会官方新闻稿可查,与 Visual Programming 同届共获)的 UniAD 给出一份完整答案:五个任务共用一套查询表示,从多目标跟踪、在线建图、运动预测、占用预测一路可微地接到规划,单网络一次前向出全部结果。规划的平均 L2 误差与碰撞率对比 ST-P3 降了 51.2% 与 56.3%,平均碰撞率 0.31%。代码由 OpenDriveLab 开源至今仍在维护,2025 年 10 月底刚发过 2.0 版。我没有跑训练,下面把论文与代码放在一起读。 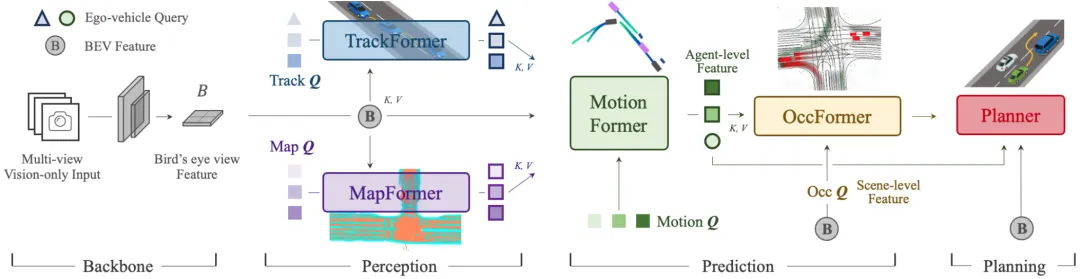
UniAD 解决的是「任务之间怎么接」:模块化管线的接口不可微、级联丢信息,而朴素的端到端规划(跳过中间任务直接出轨迹)与朴素多任务学习(各任务独立头)在论文的对照实验里都不安全也不准。改法是把所有任务的输入输出统一成查询:跟踪查询代表代理、地图查询代表道路元素、运动查询在两者间交互、占用预测把代理知识写回稠密场景特征,最后规划器拿自车查询解码轨迹。全链路可微,感知的误差能被预测与规划层部分吸收。停在哪:跟踪指标仍低于依赖复杂关联的 tracking-by-detection 方法,建图在个别类别上不及专用感知模型——作者明说这套系统的目标是服务规划而不是把感知刷到头。只想看一处代码,看 projects/mmdet3d_plugin/uniad/dense_heads/planning_head.py,248 行,论文 2.4 节的每个部件都在里面。 模块化方案的问题文献里讲了很多年:检测里的 NMS 与跨帧关联都是不可微操作,信息在后传时变成硬边界;某一环错了,下游无从补救。直接端到端出轨迹的研究(ST-P3 一类)则缺了中间表示,对动态场景的理解不足。第三条路是联合训练多个任务头——但论文的对照实验(Exp.0)显示,把各任务头简单拼在一起,规划指标反而全面落后于把任务按规划的需要组织起来的完整版(Exp.12):minADE 差 15.2%,平均碰撞率差 0.51 个百分点。问题从「要不要联起来」变成「按什么原则联」——UniAD 的答案是 planning-oriented:所有上游任务为规划服务,接口全部走查询。 主线是一次前向的四级流水线。环视图像先过 BEVFormer 得到 BEV 特征 B。第一级 TrackFormer 用检测查询加跟踪查询联合做检测与跟踪,其中专门加一个自车查询显式建模本车;MapFormer 用地图查询做道路元素的语义抽象。第二级 MotionFormer 拿代理查询与地图查询做交互,一次性为全部代理预测多模态未来轨迹,自车查询也参与其中。第三级 OccFormer 把 BEV 特征当查询、代理特征当键值,滚动预测带身份的未来占用。第四级规划器用自车查询出轨迹,并躲开预测占用。 设计一:自车查询贯穿全链。跟踪里引入的自车查询经 MotionFormer 与其他代理交互后进入规划器,与三个可学习的指令嵌入(左转、右转、直行)拼成规划查询——规划模块因此有了一个「自己」的表征,而不是从场景特征里硬猜。 设计二:实例级占用免后处理。占用预测的老办法用 RNN 展开整块 BEV 特征,再用手工聚类后处理拆出每个代理的占用图;OccFormer 反过来让稠密场景特征按注意力吸收代理知识,实例占用直接用代理特征与解码特征的矩阵乘得到。 一个必要公式(论文式 10–11):f(τ, τ̂, Ô) = λ_coord·‖τ, τ̂‖₂ + λ_obs·Σ_t D(τ_t, Ô^t)。三个量:τ̂ 是网络预测的原始轨迹;τ 是多重打靶生成的候选轨迹,优化在推理期进行;D 是把每个占用格当作高斯凸包的碰撞项,把 τ 推离占用区。λ_coord=1.0、λ_obs=5.0、σ=1.0,只在 5 米范围内取占用格。 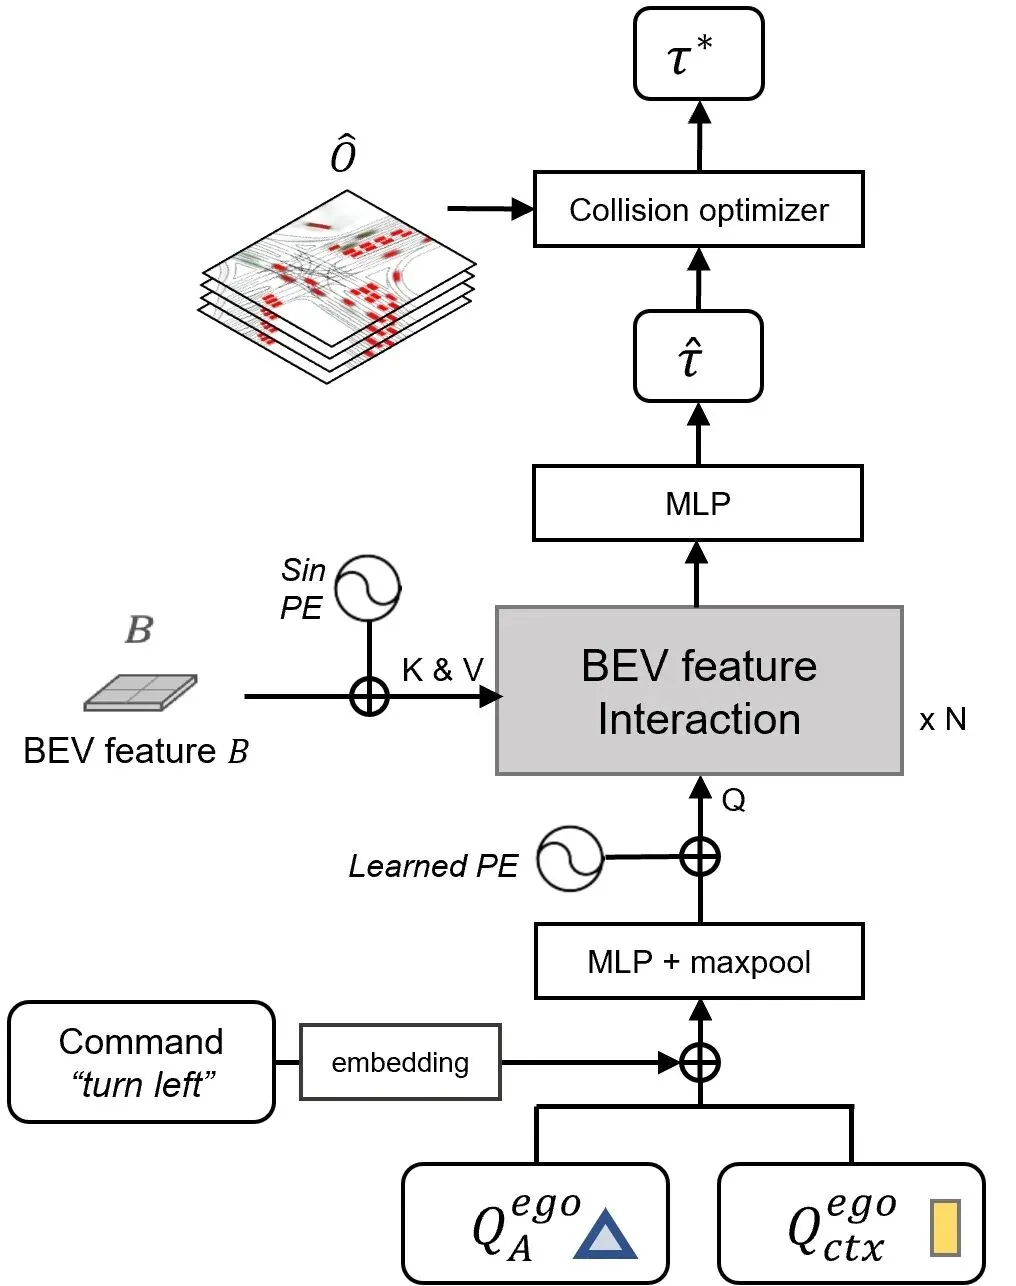
入口链:tools/test.py 按 mmdet3d 惯例加载 stage2 配置,进入 detectors/uniad_e2e.py 的 forward_test——跟踪头与建图头先跑,随后 L303 的 motion_head(运动预测)、L309 的 occ_head(占用)、L326 的 planning_head(规划)依次接上,每级把输出查询传给下一级,与论文图 2 的顺序一致。 对照一:论文 2.4 节的规划查询构造,planning_head.py 的 forward: ```python self.navi_embed = nn.Embedding(3, embed_dims) ... navi_embed = self.navi_embed.weight[command] plan_query = torch.cat([sdc_traj_query, sdc_track_query, navi_embed], dim=-1) plan_query = self.mlp_fuser(plan_query).max(1, keepdim=True)[0] ... self.attn_module = nn.TransformerDecoder(attn_module_layer, 3) ... plan_query = self.attn_module(plan_query, bev_feat) sdc_traj_all = self.reg_branch(plan_query).view((-1, self.planning_steps, 2)) sdc_traj_all[...,:2] = torch.cumsum(sdc_traj_all[...,:2], dim=1) ``` 对应关系:nn.Embedding(3, embed_dims) 就是三个指令嵌入;拼接的三路是运动模块传来的自车轨迹查询(多模态)、跟踪的自车查询与指令嵌入;max(1) 在模态维取最大池化,对应附录 E.5 的「选最显著模态」;TransformerDecoder 堆 3 层,规划查询交叉注意 BEV 特征;回归分支输出 6×2(3 秒 6 步),cumsum 把增量转成路点序列。 对照二:式 10–11 的碰撞优化,planning_head.py 的 collision_optimization 与 planning_head_plugin/collision_optimization.py: ```python alpha_xy = 1.0 cost_stage = (alpha_xy * sumsqr(self.ref_traj[:2, :] - vertcat(self.position_x, self.position_y))) ... normalizer = 1/(2.507*self.sigma) ... cost_collision += alpha_collision * normalizer * exp(-((x - col_x)2 + (y - col_y)2)/2/self.sigma**2) self._optimizer.minimize(cost_stage + cost_collision) ``` 对应关系:CasADi 的 Opti 栈配 IPOPT 求解器,直接多重打靶——文件头注明改自 nuplan-devkit;cost_stage 是 λ_coord 的轨迹贴合项,cost_collision 是 λ_obs 的高斯碰撞项,normalizer 的 2.507 即 σ√(2π) 的数值,与式 11 的 1/(σ√2π) 一致。调用侧(planning_head.py)只在推理期触发:`if self.use_col_optim and not self.training`;占用像素先按 (pos − bev_h//2)×0.5+0.25 换算成米制坐标,再按 5 米半径过滤——超参 occ_filter_range=5.0、sigma=1.0、alpha_collision=5.0 与论文附录 E.5 逐字对应。占用时域只有 5 步而规划 6 步,代码用 cur_t = min(t+1, occ_horizon−1) 把最后一步占用复用一步。 数据与流程:nuScenes,训练序列长 5(消融实验压到 3)。两阶段训练:第一阶段 6 个 epoch 只训跟踪加建图(式 13 的 L1),加载 BEVFormer 预训练权重(图像骨干、FPN、BEV 编码器、检测解码器,唯独不含查询嵌入——因为多了一个自车查询),图像骨干停梯度;第二阶段 20 个 epoch 全任务联训(式 14 的 L2),额外冻结 BEV 编码器省显存,主文消融实验为效率只跑 8 个 epoch。优化:lr 2e-4、权重衰减 0.01、梯度裁剪 max_norm 35(stage2 配置 base_e2e.py 原值)。硬件:官方建议至少 8 卡,第一阶段约 50GB 显存、8 张 A100 两天跑完 6 个 epoch。规划侧超参:T_p=6(3 秒)、d=5、σ=1.0、λ_coord=1.0、λ_obs=5.0,占用时域 5 步。以上出自论文附录 E 与仓库配置,我按 v2.0 分支(2025-10-29,mmdet3d 1.x、torch 2.x)核对,planning_head.py 与 main 分支逐字一致。 联合消融表(论文表 2)单独读:从朴素多任务(Exp.0)到完整版(Exp.12),minADE 降 15.2%、minFDE 降 17.0%、未命中率降 3.2 个百分点、占用 IoU-f 涨 4.9、VPQ-f 涨 5.9,规划平均 L2 少 0.15 米、平均碰撞率少 0.51 个百分点。路线图另一端:只有感知没有预测的版本(Exp.4–6)运动预测明显更差,两类预测任务(运动加占用)同时引入才拿到最好的规划指标(Exp.10–12)。 分任务表再分开读:跟踪比 MUTR3D、ViP3D 高 6.5 与 14.2 个 AMOTA,ID 切换最低;建图车道线 IoU 比 BEVFormer 高 7.4;运动预测 minADE 比 PnPNet-vision、ViP3D 低 38.3% 与 65.4%;占用在近处区域比 FIERY、BEVerse 高 4.0 与 2.0 个 IoU-near;规划对 ST-P3 平均 L2 与碰撞率降 51.2% 与 56.3%,还超过了部分 LiDAR 方案。设计消融(表 8–10):旋转的场景级锚点让 minADE 降 15.8%;目标轨迹的非线性平滑在训练期修正感知误差带来的不可行轨迹,minADE 再降 5.0%;占用引导的注意力掩码与规划端的碰撞损失各自有效。这些数字全部出自论文表 2–10,我没有跑。 对得上的:规划查询构造、三层解码器、碰撞优化器的代价函数与超参,前文逐条对过。代码比论文多交代的三件事:其一,碰撞优化器文件头写明改自 nuplan-devkit,论文只在式 10 附近提了多重打靶,出处要看代码;其二,stage1 配置里 freeze_img_neck=False、freeze_bn=False 是 2023 年 6 月的复现修复——最初版本误加了 loss_past_traj 并冻结了 neck 与 BN,导致从零训不出报告值,修复后官方日志复现 AMOTA 0.393,README 的 News 区有全程记录;其三,占用时域 5 步对规划 6 步的错位是任务设定(占用因计算成本时域更短),代码里 min(t+1, occ_horizon−1) 的衔接是刻意设计,不是 bug。v2.0 分支(2025-10-29)把框架迁到 mmdet3d 1.x 与 torch 2.x、接入 nuPlan 与 NAVSIM 数据集,规划头代码一字未动——算法主体三年没改过。另外两段历史要看 README 才知道:2023 年 8 月修过一处可视化 x 轴反向的 bug;开环规划指标的对比口径在 issue #29 有官方澄清,引用这些数字时要带着这个背景。 按仓库 docs/:INSTALL.md 配 mmdet3d 1.x 环境(v2.0 分支,torch 2.0.1+cu118);DATA_PREP.md 准备 nuScenes 完整数据与 infos 的 pkl;README 的 Results and Models 一节下载官方 stage1/stage2 检查点。评测一条命令:tools/test.py 指定 projects/configs/stage2_e2e/base_e2e.py 与检查点路径,跑完输出各任务指标,规划部分看 L2 与碰撞率两列。推理单卡可跑,训练 8 卡起步(想省显存把 queue_length 从 5 降到 3,跟踪会略降)。成功标志:评测日志里五个任务的指标行都出数、无 NaN。容易看错的三处:碰撞优化只在评测期生效,训练期靠的是碰撞损失;表 2 的消融数字是 8 epoch 的设置,别拿它对 20 epoch 的主表数字;开环规划指标的可比性问题(issue #29)意味着 L2 的跨论文比较要谨慎,碰撞率相对更可信。 有证据的价值:把「任务间接口设计」这个工程问题变成了一个可检验的学术问题,并用 12 组对照实验(表 2)给出答案——按规划的需要组织任务、接口全部走查询,比模块化与朴素多任务都强;自车查询让规划端有了明确的自我表征,实例级占用免掉了手工后处理,这两处设计后来的端到端工作反复引用。限制论文写得坦率:感知指标不追求 SOTA,是刻意把容量让给规划;失败案例集中在长尾(大卡车、挂车);开环指标本身有争议,官方在 issue 里自己澄清过口径。我的看法:这份代码最值得学的不是哪个模块,而是「每个设计都配一组消融」的写法——表 2 到表 10 每一行都对应一个可单独关掉的开关,配置文件里的布尔项与论文表格几乎一一对应,改一个配置就能复现一组论文数字,这在 2023 年的自动驾驶仓库里是稀有品质。想在它上面做研究的人,先跑通 stage2 评测再读 uniad_e2e.py 的 forward_test,那两百行就是论文图 2 的展开。 论文:Planning-oriented Autonomous Driving,arXiv 2212.10156(CVPR 2023),https://arxiv.org/abs/2212.10156 获奖身份:IEEE Computer Society 新闻稿 CVPR 2023 Best Paper Award Winners Announced,https://www.computer.org/press-room/cvpr2023-best-paper-winners/(2023-06-21,UniAD 与 Visual Programming 同届共获最佳论文奖) 仓库:https://github.com/OpenDriveLab/UniAD(默认分支 v2.0,commit 609ee08,2025-10-29 的 UniAD 2.0 发布;main 分支 commit 532fc33,2025-04-08;Apache-2.0。精读依据 v2.0 分支 tarball,planning_head.py 两分支一致) 精读所依据的源码文件:projects/mmdet3d_plugin/uniad/dense_heads/planning_head.py、planning_head_plugin/collision_optimization.py、detectors/uniad_e2e.py、projects/configs/stage2_e2e/base_e2e.py、projects/configs/stage1_track_map/base_track_map.py、docs/TRAIN_EVAL.md、README.md(News 区的复现修复记录与 issue #29 说明) 生态:Bench2Drive(CARLA Leaderboard 2.0 闭环评测的 UniAD 接入,2024-08-27 README News 收录)
01 先看结论
02 问题背景
03 方法拆解