ARTICLE · 1207587
手把手教你用 AI 写数学论文
既然在用 AI 做结果,AI 读论文了,为什么不用 AI 写论文呢?
今年 8 月 26 日,我写过一篇手把手教你怎么用 AI 做数学研究,讲如何与云端的 AI 合作,尤其是如何利用 ChatGPT 不同的推理强度推进数学问题。那篇文章的第五步提到了用本地 Codex 写论文,但讲得太粗。后来依然有朋友来问:结果已经做出来了,到底怎样才能迅速写成论文?
这篇文章就来补上这一步。它写给需要写论文的数学工作者。你可以完全不会编程,也可以从来没有让 AI 修改过电脑上的文件。只要你已经有了准备写成论文的数学结果,就可以照着做。
不过,在动手之前,我还是想说说:为什么到了今天,大家依然如此急切地想要出产论文?
核爆之后,大家还在抢什么?
写上一篇「手把手教你用 AI 做数学研究」时,我判断数学已经进入了「证明丰富」的状态,也进入了黑暗森林。用 AI 做问题的人不断得到结果,却出于种种原因不愿放出来。旁人不知道他们做到了哪里,也不知道自己正在研究的问题,是否已经躺在别人的对话记录中。
很多人是从 8 月那篇关于六维球面 S⁶ 上复结构的论文开始,才认真考虑用 AI 做数学的。到了 9 月,OpenAI 公布了 Navier–Stokes 存在性与光滑性问题的解答及 Lean 形式化,即使消息再不灵通的人,也很难继续对 AI 的数学能力视而不见。
我们暂时用不上做出那些结果的内部模型,但手头的模型,难道还不能拿来试试自己一直想做的问题吗?各路人马、各路抽卡仙人,已经抢先行动起来。挂出预印本的、投给期刊的、甚至已经被顶刊接收的,一条条消息传来,很难让人平静。
10 月,OpenAI 又一次性公开了七百多篇数学稿件,涉及大量长期悬而未决的问题。这些稿件覆盖的范围、触及的问题,已经足以让我把这次冲击称为整个数学的核爆。黑暗森林中的成果突然被大规模广播出来,许多被波及或者震惊到的人终于开始问:接下来还做什么?
有意思的是,问完这个问题,大家又回去写论文了。
这段时间,一些大佬正在做的事,以及他们说的话,依然指向同一个目标:尽可能快地抢占结果。理由也很直接:评价不看论文,那看什么?
这句话恰恰暴露了问题。过去,率先证明一个困难问题,通常意味着一个人投入了稀缺的智力劳动。优先权、论文、声誉和职业回报,围绕这件事组织起来。现在,证明可以被模型大量生产,抢先发布与个人数学能力之间的关系正在断裂,评价制度却还在沿用原来的尺子。
那么,最后到底比什么?谁能用上最高级的模型?谁有几十、上百、上千个账号同时抽卡?谁的 token 更多?如果论文如海一般涌来,期刊又该给谁发表?让某位权威规定哪个方向更重要,让某些人分配有限的版面,最后把机会留给熟人?
我在之前的系列文章中反复论证过:靠证明的稀缺性、优先权和论文数量维持的这套评价体系,没有未来。更早开始使用 Pro 模型做问题的人,早就有机会意识到这一点。只是,预见一种制度会失效,与承认它正在自己身上失效,是两回事。
铁锤只有砸到自己身上,才知道痛。
被这次核爆直接扫到的人,开始组织讨论班,读那些 AI 生成的论文,试图理解证明,看看还能不能继续推进。即使做不出新结果,把已有的证明写成一份人能理解的稿子,也算是不负自己过去多年的努力。他们不需要着急了,因为论文已经被 OpenAI 发出来了。
但还有很多方向,没有被这一轮结果直接覆盖。那里依然有数不尽的问题,有悬而未决几十年的猜想,也有足够让人继续做下去的研究计划。于是,人们又找到了理由:OpenAI 还没有做我们的方向。既然它没做,我们能不能先用它的模型把结果做出来?
核爆还没有炸到自己头上,游戏就可以继续。
在我看来,这次冲击已经动摇了这些方向原有的职业前景。某个问题暂时没有出现在那七百多篇稿件中,并不能让围绕它的评价制度重新获得根基。OpenAI 已经表示正在推动发布产生这些结果的模型,具体还要多久尚未确定。而且,我们根本不必等它。
至少在我的实践中,现有的 Astra 已经能够做出我这个领域里悬了几十年的猜想,我的领域却并没有被这一轮公开结果覆盖多少。
真正耐人寻味的地方就在这里。有人相信旧制度还能维持,有人已经不信,却仍然需要其中的回报。过去的惯性、对未来的迷茫,或者「混乱之中再多捞一点」的想法,把人推向同一个选择:继续抽卡,迅速挂出,攻城略地。先拿到优先权,再说它将来还有没有用。
所以,很多人现在的卡点已经变了。他们手里有了一堆结果,却来不及把这些结果写成论文。别人手里很可能也有同样的东西,谁能先整理出来,谁就先占一个位置。
这就是我要写这篇教程的原因。就像核武器不能只掌握在一个超级大国手里一样,用 AI 快速产出高质量论文的能力,也不应只掌握在少数善于使用 AI 的数学工作者手里。
只有大部分人都掌握了这种能力,并用它把核爆继续扩散下去,才能迫使人们真正思考并构建新的评价体系。
既然还要写,为什么不把写作也交给 AI?
先说说我的一个判断:可能真的已经没有人在读论文了。
看看大家在 arXiv 上挂出的论文数量。写论文的速度早已超过了读论文的速度,AI 又在继续拉大这个差距。即使每个人都愿意认真读,人类有限的阅读时间也接不住这样的产量。如果编辑把初步判断交给 AI,审稿人让 AI 梳理论证,研究者让 AI 解释自己需要的结果,那么一篇论文从写成、投稿到被引用,究竟还有几个环节需要一个人从头到尾亲自读完?
我说「没有人在读」,指的就是这种正在形成的处境:论文仍然不断被生产、筛选、使用,但完整阅读越来越多地发生在模型那里。人得到的是 AI 提供的解释、核查和判断。生产论文的人越来越多,每篇论文能够分到的人的注意力却越来越少。
那么,为什么写作者还必须亲自逐句打磨这份最终主要交给 AI 阅读的文本?为什么他不能也通过 AI 的解释来理解结果,把论文的组织和写作交给 AI?
这里说说我的三个前提:
你已经用 AI 得到了自己想要的结果,并且认为它值得写成论文,至少按前 AI 时代的标准值得发表。 你已经通过 Lean 形式化或其他可靠的方法验证了结果的正确性。如果采用形式化验证,检查通过的定理还应准确对应你准备写进论文的结论和假设。 你已经理解核心结果,以及所有你认为自己需要理解的细节。理解到什么程度,由你自己决定。
在这些前提下,还要不要亲自花大量时间调整英文、统一符号、安排章节、整理引用、处理排版?你手里还有几十个结果等着写,别人也在等着抢先发布。继续用过去的速度打磨,究竟是在坚持什么?
把这些工作交给 AI,依然可以要求陈述准确、证明完整、引用可靠。数学内容需要检查,写成论文时也不能漏掉假设。但这些要求完全可以进入写作系统,让 AI 在写作和修改时执行。你有必要理解、判断和追问的地方,同样可以让它展开解释。
我个人非常不赞同把时间继续投入这种优先权竞赛。真的需要在一个已经失去根基、却仍靠惯性运转的体系里,再夺取最后一份利益吗?
但你完全可以不同意我。你可以继续相信论文与优先权的价值,也可以明知如此,却仍然不得不写。没有关系,只要你还要做这件事,就该学会更高效的工具。
你不学,别人也会学。
接下来,我们就把从结果到论文的过程尽可能加速。在结果和验证已经完成的前提下,一天整理出一篇,甚至几篇可供检查、修改的英文稿件,是可以追求的目标。
如果你也已经厌烦这场竞赛,那么让更多人掌握这种生产能力,或许正好能加速那个幻想的破灭。
为什么要把写作放到本地?
有人问我:已经开了 ChatGPT Pro,做数学问题确实很好用,为什么写论文总是磕磕绊绊?
一个重要原因是,论文写作包含大量需要反复遵守的具体要求。哪个空间用什么字母,定义放在哪里,证明展开到什么程度,哪些英文表达你不喜欢。这些要求散落在长长的对话中,换一次对话、换一篇论文,就容易漏掉,又得重新解释。
我的做法是把它们保存到本地文件中,让 Codex 在项目里直接读取研究资料、修改 TeX、编译 PDF,并按照已经保存的规则完成工作。规则有明确的位置,你也能查看和修改。至于如何让规则被正确加载,我们会让 Codex 自己配置并验证。
更重要的是,第一篇论文中发生的修改,可以成为第二篇论文的经验。你纠正一次措辞、调整一次证明的组织方式,AI 就有机会从中提炼出适用的写作偏好。这样,下一篇论文会从已经积累的要求出发。
这套流程只需要你先记住两个工具:Codex 负责操作文件和完成任务,VS Code 负责让你看见这些文件,并随时亲手修改。 其他的繁琐配置,都可以交给 Codex 处理。
即使你一直在用 TeXworks、WinEdt、Overleaf,或者别人搭好的环境写论文,从来没有写过程序,也不需要先学命令行或 Git。
你需要知道文件放在哪里、自己想做什么,然后把任务向 Codex 说清楚。
我在下面的操作指南中,尽量省去具体的配置细节,用大白话说明操作和原理。但由于知识的诅咒,仍可能有讲得不够清楚的地方。遇到不理解的内容,完全可以把相应段落复制给 AI,让它给你详细讲解。
操作指南:先把系统建立起来
1. 安装 Codex,选定论文文件夹
先按官方安装指引下载桌面应用,登录自己的 ChatGPT 账号。如果下载页显示的是 ChatGPT 桌面应用,安装后从应用里的 ChatGPT 下拉菜单切换到 Codex 即可。
我建议使用 Mac。目前,Mac 上的 Computer Use 可以在后台操作应用;Windows 上的图形界面操作会占用前台,鼠标和键盘也会跟着动作,容易打断你自己的工作。对我这样经常让 AI 操作电脑的人来说,Mac 更合适。
当然,Windows 同样可以完成下面的流程。直接修改文件、运行命令、编译论文,本来也不需要每一步都去点击图形界面。你已经有 Windows 电脑,就先用起来。
接着,在电脑上找一个自己日后也能找到的位置,新建一个叫 Papers 的文件夹。以后所有论文都放在这里。在 Codex 的 Projects(项目)中添加这个文件夹,然后在这个项目里新建对话,确认工作环境选的是 This computer(这台电脑)。
权限可以选择 Approve for me,也就是「由 AI 代为审批」。它会把符合条件的额外权限请求交给自动审核,仍然保留工作区的访问边界,个别操作也可能需要你确认。具体说明见权限设置。模型选择当前账号可用的较强模型;整理整篇论文、检查复杂论证时,可以把推理强度调到 Extra High(超高)等较高档位。
到这里,你已经给了 Codex 一个明确的工作地点。后面说「让 Codex 做」,就是在这个项目的对话里直接给它发消息。
2. 让 Codex 配好 VS Code 和编译环境
直接告诉它:
请帮我安装并配置 VS Code、LaTeX Workshop 和本地 LaTeX 编译环境,实际编译一份示例论文,并打开 PDF 给我看。需要我操作的地方,请一步一步告诉我。
如果你已经有一份可以使用的论文,就把它的完整 TeX 项目放进 Papers,告诉 Codex 用它来测试。从 Overleaf 转过来,也可以先下载项目源码,再交给 Codex 接手。
VS Code 可以在同一个窗口里打开 TeX、Markdown 和各种规则文件。让 Codex 帮你在 VS Code 中打开 Papers,你就能看见左侧的文件夹和文件。之后,大量修改交给 Codex,少量手动微调就在这里做。
当然,如果你打开 TeX 文件后,不知道怎么编译、查看 PDF,或者从 PDF 跳转回 TeX 文件,都可以直接问 Codex。它会根据你的环境告诉你怎么做,并帮你完成配置。
如果某一步需要它直接查看窗口、点击按钮,再按提示启用 Computer Use 并给予相应权限。读写论文文件通常可以直接完成;让 AI 看见并操作桌面应用,需要对应的功能已经启用。
你无需为了写论文,先把这些软件的配置细节全部学一遍。遇到问题,就把卡住的那一步告诉 Codex,让它解决。
3. 把研究资料和写作规则放到合适的位置
接下来,在 Papers 里为第一篇论文建立一个子文件夹,比如 Paper-Title。里面再建一个 MarkdownNotes,用来放研究资料。上一篇教程里从云端整理出来的 Markdown 文件、讨论记录,都可以放进去。有现成的 Lean 验证项目,也把它的位置告诉 Codex。
然后,在 Papers 下建立一个与 Paper-Title 并列的 Writing Rules 文件夹,用来保存所有论文共享的写作要求。它现在可以是空的,你不需要提前写好一份规范。
整个目录大致会长这样:
这是用来说明关系的示意。AGENTS.md、规则文件、TeX 和参考文献文件,后面让 Codex 建立即可。文件夹也可以让它代建;我建议你至少亲手找到并打开一次 Papers,知道自己的资料究竟存在哪里。
每篇论文的特殊约定留在自己的项目中,能跨论文复用的要求放进 Writing Rules。以后在云端又讨论出了新结果,就继续把整理好的资料放进对应论文的 MarkdownNotes。
文件放好了,还要让 Codex 知道何时读取。Codex 可以通过 AGENTS.md 等项目指令加载规则;具体怎样组织、从哪个项目入口能够找到,交给它配置。它也不需要每改一个单词就重读所有文件,只需在执行任务时加载适用的要求,并据此工作。
4. 把这段原则交给 Codex
下面这段原则,是 AI 读过我本地的论文写作框架后,自己提炼出来的。它说明了这套系统应该做到什么。你可以直接复制给 Codex,让它在刚才的 Papers 文件夹里实现。
如果你有过去写过的论文,或想模仿写法的论文,也可以把它们放进 Papers 中,告诉 Codex 哪些写法是你希望保留或学习的,让它据此建立初始规则。优先提供 TeX 源文件,只有 PDF 也可以。没有旧稿,就从这次写作中的反馈开始积累。
你不需要把整篇文章复制过去。把上面这段原则、Papers 的位置,以及用来参考的旧稿位置告诉它,就足够开始。至于需要哪些配置、哪些 Skills、怎样做版本管理,让它自己设计和完成。
5. 实际试一次,确认系统能用
Codex 说「已经建立好了」之后,再开一个仍然位于 Papers 项目里的新对话,告诉它:
请检查这个项目会自动加载哪些写作规则,并用示例论文验证修改、编译和版本记录都能正常工作。
然后,在它已经保存版本的示例稿里手动改一句话、保存,再告诉它:
请找出我刚才的修改,判断其中有没有值得记住的写作偏好。
它能找到规则、完成修改和编译,也能通过版本记录识别你的修订,这套系统才算真正开始运转。哪里失败,就让它继续修好,再试一次。你需要看到实际结果。
完成第一篇论文
先整理结果,再写初稿
研究记录里往往混着旧证明、失败的尝试和最后确认的版本。资料可以一股脑放进去,写成论文时需要先分清楚。
告诉 Codex:
请整理并复核
Paper-Title/MarkdownNotes中的数学结果,区分已经确认的结论、旧版本和未完成的尝试,再写成英文论文,保存为Paper-Title/main.tex,编译 PDF 给我看。有疑点的地方请单独列出来。
如果已经有 Lean 形式化,再补一句:
请核对论文的结论和假设是否与对应的 Lean 定理一致。
这样,Codex 就会把研究资料整理成论文结构,再生成 TeX。复核中没有解决的疑点,需要继续处理;编译成功,只说明文件能够生成 PDF。整理资料、核对数学陈述的要求,也可以让它保存到适用的写作规则里,下次自动执行。
等它完成,你应当能在论文目录中找到 main.tex 和相应的参考文献等文件,并打开生成的 PDF。让 Codex 直接展示 PDF,或者在 VS Code 中预览,都可以。
大改直接说,小改亲手做
第一稿通常还需要调整。接下来,我建议把修改分成两种。
如果是大改,比如重排章节、展开证明、换一种方式介绍结果,就直接在 Codex 对话中说。你也可以用语音输入,把自己的想法一口气讲出来,让它整理并落实到文件中。
比如:
请把第三节的证明展开,让读者能看清每一步为什么成立。
或者:
请重新组织引言,先把主要结果讲清楚,再介绍背景。
如果只是改一个词、一句话或者一个公式,你可以直接在 VS Code 中打开 main.tex,修改后保存。两个工具处理的是同一份文件。你改完了,就让 Codex 接着看;它改完了,你也能在编辑器里看到。
需要批量修改时,可以先亲手改一个地方,再告诉它:
请看看我刚才的修改,把文中适用的同类写法一起改好。
看到 PDF 中某段证明太简略,就把那段文字、所在章节,或者 TeX 的位置告诉 Codex,让它展开。保持上下文符号一致这类要求,应该由写作规则负责。如果它漏掉了,就指出问题,让它修正,并补进适用的规则。
这一来一回,比在网页对话中不断上传、下载、复制全文方便得多。你只需要把注意力放在当前想改的地方,文件管理、全文一致性和重新编译交给 Codex。
写完之后,再做一次检查
当你觉得稿件已经达到要求,就告诉它:
请按写作规则完整检查这篇论文,核对数学陈述、引用和前后修改的一致性,重新编译,并告诉我还有哪些问题没有解决。
让它把能修的问题修好,把暂时不能确认的问题明确列出来。你需要进一步理解哪一段,就继续问它。最后得到的是一套能够继续修改、检查和用于投稿准备的论文文件。
让第二篇论文继承第一篇的经验
第一篇写完,别急着把这次对话扔掉。告诉 Codex:
请回顾这篇论文中我的修改和反馈,把可以跨论文复用的偏好更新到
Writing Rules,告诉我记住了什么。
比如,你总觉得 AI 把证明写得太省略,多次要求它把中间步骤展开。这就可能成为后续论文的写作偏好。你纠正了一个错误证明,或者给当前论文换了一个特殊记号,则应当留在这篇论文的范围里。前面的原则已经要求 Codex 区分这些情况,它应当自己完成提炼。
这套系统的价值就在这里。你在 VS Code 中改过的内容、在对话里指出的问题,都有机会成为下一次写作的起点。过去你需要反复解释的要求,现在有了可以持续更新的位置。
接着,让它新建下一篇论文的文件夹,把新资料放进去:
请根据
Another-Paper/MarkdownNotes写下一篇论文,沿用我们已经积累的写作规则。如果内容相近,也参考上一篇论文的组织方式。
它可以直接读取这些文件。你不必重新上传全部旧稿,也不必从头解释自己的每一个习惯。之后的每一篇,都继续经过写作、修改、总结偏好的过程。规则也应该不断去重、修正,保持简洁。
当第一篇论文写得磕磕绊绊时,你正在把自己的要求教给这套系统。第二篇继承这些要求,第三篇又继承前两篇的经验。写得越多,你需要重复说的话就越少。
然后呢?
基于同样的思路,你还可以继续向前推。让 AI 阅读电脑上存着的论文和研究笔记,整理你想做的问题,生成任务单,再交给云端模型去跑。在相应功能和权限具备时,也可以让 Codex 操作浏览器,衔接这些工作。自动抽卡、整理结果、写成论文,这些环节都可以继续连接起来。
当你用熟了这套工具,随着模型能力继续提升,出产论文会越来越容易。连那些模糊、不完整的要求,AI 也越来越有能力替你理清。你不必再猜别人到底用了什么秘密武器,为什么能如此迅速地交出一篇又一篇论文。你也可以这样做。
但读到这里,应该已经能看见另一件事:读过这篇文章的人,或者自己摸索出同样方法的人,也可以这样做。
在结果和验证已经完成之后,你每天愿意整理出多少篇稿件,越来越取决于你对论文的要求,以及你愿意投入多少 token。当这种生产能力变得普遍,今天靠速度抢到的优先权,究竟还能给你带来什么?一个必须不断加速才能维持的位置,值得你继续追逐多久?
我写这篇文章,当然可以帮你把论文写得更快。但我更希望,当你真的具备这种能力之后,能重新面对开头的问题。你还需要以多快的速度出产论文?你希望从数学研究中得到什么?如果仍然用论文的数量、发表的速度和抢占的问题来评价一个人,这套制度究竟在奖励什么?
如果大家依然不愿意回答,那就继续加速。让每一个想要攻城略地的人,都学会同样的工具。
直到现实再也撑不起那个幻想。
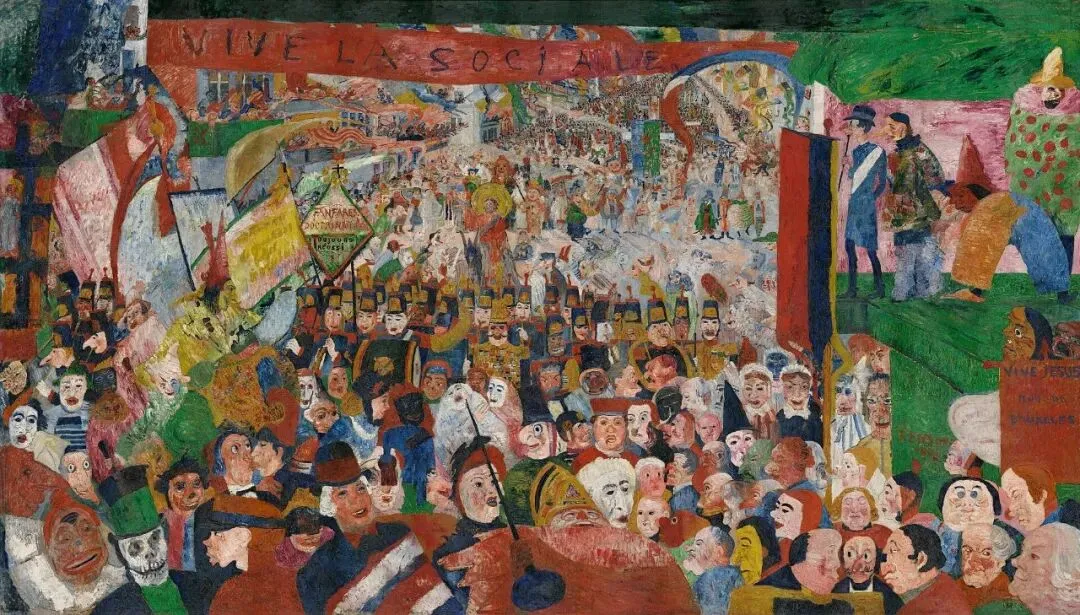
1888年,比利时画家詹姆斯·恩索尔(James Ensor)创作了《1889年基督进入布鲁塞尔》(Christ's Entry into Brussels in 1889)。这幅巨大的油画描绘了一场荒诞而喧嚣的城市游行:旗帜招展,乐队奏乐,成千上万戴着怪诞面具的人物涌向街头,政治口号、宗教仪式与民间狂欢混杂在一起。画面以近乎失控的色彩、拥挤的构图和扭曲的人物形象,彻底背离了传统宗教绘画庄严、和谐的视觉秩序。基督本应是这场盛大游行的中心,却骑着一头驴,几乎被淹没在无边无际的人群之中。所有人都在庆祝他的到来,真正的主角反而成了最不引人注目的存在。
恩索尔借用了基督进入耶路撒冷这一经典宗教题材,却将场景移植到十九世纪末的布鲁塞尔,完成了一次尖锐的现代社会讽刺。画中的面具不仅制造了狂欢的气氛,更消解了人物的真实身份:政治家、宗教人士、普通市民彼此混杂,每个人都仿佛在扮演某种角色,以夸张的姿态争夺注意力。游行看似拥有共同的目标,实际上却充满虚荣、喧哗与自我表演。画面中鲜艳而刺目的红色、黄色与绿色进一步强化了这种视觉上的骚动,使整幅作品呈现出一种令人不安的喜剧性。恩索尔真正讽刺的并不是狂欢本身,而是一个社会如何将原本具有崇高意义的事件,转化为权力、利益与虚荣的公共表演。
这幅画最深刻的反讽,在于它所描绘的并非一个无人知晓真理的世界,而是一个真理已经来到、却无人真正关心的世界。人群并没有拒绝基督,恰恰相反,他们以最热烈的方式迎接他;然而,这场迎接最终成为一种自我陶醉的集体仪式。每个人都在奔走、呼喊、争先恐后,仿佛参与了一场决定历史命运的盛事,却没有人停下来追问这场游行究竟意味着什么。恩索尔由此揭示了一种比无知更加深刻的荒诞:当真正重要的事物已经发生,旧世界的人们仍然可以按照熟悉的规则继续竞争,甚至比过去更加狂热。历史或许已经转向,而游行仍在继续。