ARTICLE · 1215183
90%的人不知道!PDF表格导入大模型秒变乱码的真正原因!3分钟教你搞定!
我是老九,一个一直在一线折腾技术和AI的人。AI难的不是跑通Demo,而是上线以后。记录一个个真实小问题:出现了什么、怎么排查、原因在哪、怎么解决。欢迎关注我!
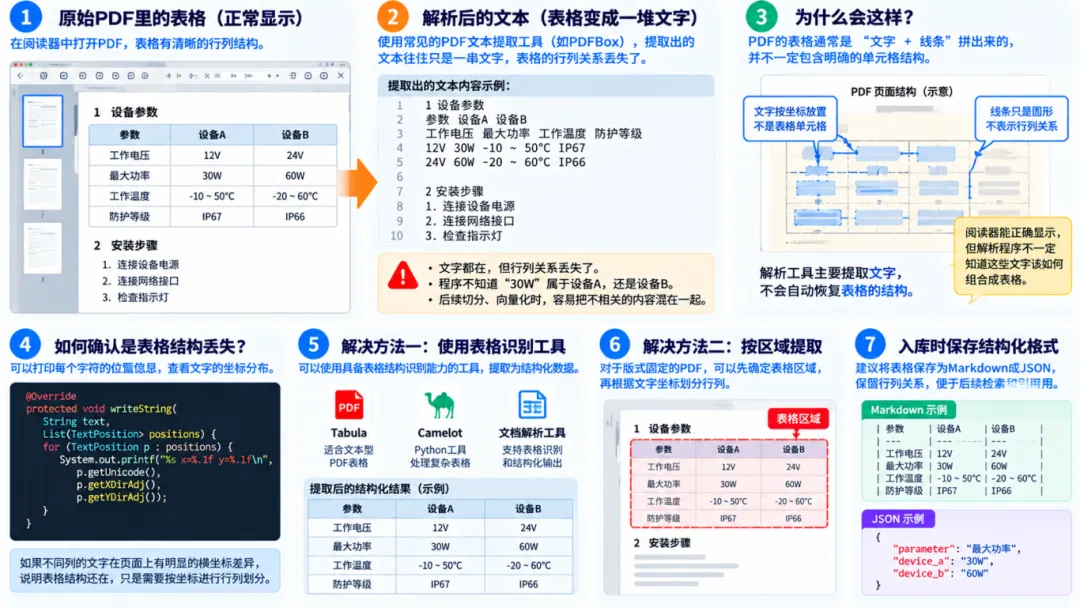
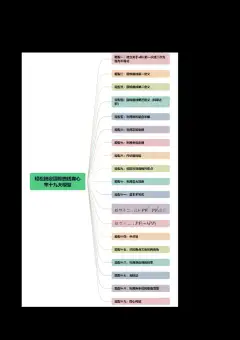
不要错过文章最后的总结图呦!
当前章节:第五章|知识库文件进去以后
当前小节:第一节|文档解析
本篇问题:表格丢结构
知识库里有份设备参数说明书,PDF打开正常,表格很清楚。可问AI“设备A的最大功率是多少”,它有时回答30W,有时却回答60W。原始文件明明写得很清楚,为什么会答错?
把PDF解析出来的文字打印出来看看,用一张参数表做复现。
正常情况下,设备A对应30W,设备B对应60W。用PDFBox提取文本时,有些得到这样的结果:
参数 设备A 设备B
工作电压 最大功率 工作温度
12V 30W -10~50℃
24V 60W -20~60℃
文字都在,表格没了。表格里最重要的不是那些字,而是谁和谁对应。
PDF为什么会这样?PDF里的表格不一定保存着明确的行列和单元格结构。很多PDF是把文字放到指定坐标,再画几条横线、竖线。
PDFBox这类提取工具负责提取文字,并不保证自动恢复表格结构。
先做检查:把PDF中每个字符的坐标打印出来,PDFBox通过继承PDFTextStripper获取文字位置信息。
如果设备A、B位于不同的横坐标,30W、60W也落在对应列下面,说明文字的位置关系还在,普通文本提取没把它恢复成表格。继续调整 setSortByPosition(true)不一定能解决,它能改善部分文字顺序问题,不会自动判断哪几个字符属于同一个单元格。
换一种处理方式,对版式固定的设备说明书,先确定表格区域,再根据文字坐标划分行列。
如果知识库需要接收不同厂家、不同排版的PDF,手工配置坐标很难维护。这种考虑使用Tabula、Camelot,或者带表格结构识别能力的文档解析工具。
Tabula适合处理部分文本型PDF表格;Camelot是Python工具,对表格边框、文字排列等也有一定要求。扫描件则通常需要OCR配合表格结构识别。
解析完后保存成什么格式?思考过没?
先保存成Markdown表格,或者结构化JSON,至少保留了字段和数值之间的关系。
这里有个坑:有些表格合并单元格、多级表头,甚至跨页续表。不能只检查是否生成了Markdown或者JSON,还要核对表格内容。
选几条明确的参数做验证,比如设备A最大功率30W、设备B工作电压24V,找一条跨页或合并单元格的数据。
先看结构化结果是否正确,再看最终Chunk有没有把表头和数据拆开。
参数表可以按行组织成独立记录,或者每个Chunk包含必要的表头信息。这一步要在确认解析结果正确之后再做。
在入库时保存PDF页码和表格编号,方便以后核对原文。
PDF上传成功,文字也提取出来了,为什么AI还是把设备参数答错?可能在进入向量数据库前,表格的行列关系就丢了,这种把Chunk调小解决不了。先把原始PDF和解析结果并排打开,找到30W、60W对应的那一行。如果解析阶段已经分不清它们分别属于哪台设备,就先停在这里。
如果你读着还行,欢迎点赞收藏关注;如果有不同的观点,也欢迎大家留言讨论。