ARTICLE · 1218498
RAG 深度技术文档:从范式演进到企业级工程化实战
RAG 深度技术文档:从范式演进到企业级工程化实战
优化策略总览
评估结果解读
目录
为什么是 RAG:问题与价值定位 RAG 技术发展历程(2017—2026) 核心技术范式剖析 挑战与重难点 企业级 RAG 工程化实战 前沿方向与趋势展望(2025—2026+) 学习资源清单 结语 参考资料
1. 为什么是 RAG:问题与价值定位
大语言模型(LLM)三个结构性缺陷:
- 知识时效性差
- 领域深度不足
- 幻觉风险高
——让模型"回答有依据、更新零成本、知识可控制":
2. RAG 技术发展历程(2017—2026)
2.1 前史:从稀疏检索到稠密检索(2017—2020)
RAG 并非凭空出现,它建立在开放域问答(Open-domain QA)的"先检索、后回答"范式之上:
- DrQA(2017,Chen et al.)
- DPR(2020,Karpukhin et al.)
2.2 诞生:REALM 与 RAG(2020)
2020 年是 RAG 元年,两条几乎同时出现的路线奠定了命名与范式:
- REALM(2020.02,Google)
:首个真正意义上的检索增强语言模型,把可学习的检索器嵌入 BERT 的预训练过程,通过掩码语言建模让检索器可微分。计算代价高(需要周期性地重编码整个语料库),但证明了"检索与生成可联合训练"。 - RAG(2020.05,Facebook AI Research,Lewis et al.,NeurIPS)
:正式提出 RAG 概念并给出了通用架构——用 DPR 做检索器、BART 做生成器,提出了两种解码方式: RAG-Sequence:同一篇文档用于生成整个输出序列; RAG-Token:每个 token 可以依赖不同文档。 它在开放域问答(Natural Questions、WebQuestions 等)上刷新了 SOTA。相比 REALM,RAG 使用冻结检索器、实现简单、可生成式输出,加上"RAG"这个简短的名字被广泛接受,成为行业通用术语——甚至今天很多与原始论文形态完全不同的系统也被统称为 RAG。
2.3 框架化与生态爆发(2022—2023)
- FiD(2021)
:将每个检索段落独立编码,在解码器的交叉注意力层融合,可扩展到 100+ 段落。 - RETRO(2022,DeepMind)
:构建大规模检索语料,在生成过程中动态检索片段,把检索增强引入预训练阶段。 - Atlas(2022—2023)
:FiD + 对比式检索器训练,11B 参数模型仅用 64 个样本就在 Natural Questions 上追平 540B 的 PaLM,验证了"检索即参数"的少样本能力。 - ChatGPT 引爆(2022.11)
:企业强烈渴望把大模型接入私有数据,"RAG"一夜之间从学术名词变成创业 BP 上的热词,向量数据库进入爆发期——Pinecone、Weaviate、Chroma、Qdrant、pgvector、Milvus、FAISS 相继成为基础设施;LangChain、LlamaIndex 等编排框架出现,把"检索→生成"抽象成几行 API。到 2023 年年中,arXiv 上包含 RAG 的论文超过 2000 篇,各大云厂商都推出了托管 RAG 产品。
2.4 从 Naive 到 Advanced 再到 Modular(2023—2024)
Gao et al. 的 RAG 综述(arXiv:2312.10997,2023.12) 系统梳理了 RAG 的三个范式演进:
- Naive RAG(朴素 RAG)
:索引→检索→生成三步线性管线,检索一次、生成一次,无反馈机制。典型缺陷:对复杂问题召回质量差、噪声多、无自我纠错。 - Advanced RAG(高级 RAG)
:围绕"检索前、检索中、检索后"三个环节做增强:
- 检索前(Pre-retrieval)
:查询改写(Rewrite-Retrieve-Read)、查询扩展、HyDE(假设性文档嵌入,2022)、路由; - 检索中(Retrieval)
:混合检索(稠密+稀疏)、多路召回、迭代检索(IRCoT); - 检索后(Post-retrieval)
:重排(Rerank)、上下文压缩(RECOMP)、去噪。
- Modular RAG(模块化 RAG)
:把管线拆成可独立替换、可组合的模块(查询规划、检索、排序、融合、生成、记忆、路由),并支持与外部工具/API 集成,成为 Agentic RAG 的前身。
同期出现的几个标志性方法(2023—2024):
2.5 结构化知识:GraphRAG 与 LightRAG(2024)
2024 年,RAG 的另一条主线是"用显式结构补足向量检索看不到的关系":
- GraphRAG(2024.04,Microsoft Research)
:对文档语料先做实体—关系抽取构建知识图谱,再用社区检测生成分层社区摘要;查询时支持 Local Search(检索实体及其邻域)与 Global Search(基于社区摘要回答全库级问题)。微软基准显示,在跨文档推理类问题上 GraphRAG 准确率约 80%,而传统向量检索约 50%。代价是索引成本极高——需要 LLM 逐文档抽取实体与关系。 - LightRAG(2024.10)
:在保持图语义的同时显著降低索引成本,通过"图增强文本检索 + 双层级检索"适配动态语料,成为开源社区 GraphRAG 的轻量替代。 - HippoRAG(2024.05)
:把 PageRank 与 LLM 知识结合做实体级图检索,强化多跳推理。
2.6 智能体化:Agentic RAG(2024—2026)
Agentic RAG(智能体检索增强生成) 是 2024 年底到 2026 年最热的方向,由 Singh et al. 的综述(arXiv:2501.09136,2025.01) 正式命名。核心变化:把传统"单次检索→生成"的线性管线,替换为智能体自主控制的检索闭环——智能体决定何时检索、检索什么、结果是否充分、是否迭代。
其演进可归纳为"预定义推理"与"智能体推理"两条路径:
- 预定义推理(Predefined Reasoning)
: 路由式:RAGate、Self-Route——按置信度/上下文决定是否进入 RAG 或直接生成; 循环式:Self-RAG、CRAG——带反思与纠错反馈环; 树式:RAPTOR、MCTS-RAG——用树搜索组织多跳检索与推理; 混合模块式:Adaptive-RAG、Modular-RAG。 - 智能体推理(Agentic Reasoning)
: 提示式(Prompt-based):ReAct(2023)交替推理与工具调用、Self-Ask(2023)拆分子问题、Search-o1(2025)在生成中触发检索、函数调用(Function Calling); 训练式(Training-based):DeepRetrieval(2025)、Search-R1(2025)、R1-Searcher(2025)、ReZero(2025)——用强化学习(RL)训练模型在推理中自主决定检索动作,代表"推理-检索一体化"的模型侧路线。
2026 年的新进展还包括:RAGSearch 基准(arXiv:2604.09666) 系统对比了稠密 RAG 与各类 GraphRAG 在智能体检索中的表现,结论是——图结构检索在多跳推理上依然显著更优且更稳定,而稠密 RAG 在一般问答上仍是高性价比选择;Youtu-GraphRAG(ICLR 2026) 用"图模式"纵向统一图构建与检索,最多节省 33.6% token 并提升 16.62% 准确率;GraphRAG-Bench(ICLR 2026) 为 GraphRAG 提供了首个可复现的系统化评估坐标,明确"什么时候该用图"的量化边界。
2.7 时间线总览
3. 核心技术范式剖析
3.1 Naive RAG
最简单的形态,也是所有 RAG 系统的基础骨架:
- 索引
:文档 → 解析 → 分块(Chunking)→ Embedding → 写入向量库; - 检索
:query → Embedding → 向量相似度检索 Top-K; - 生成
:检索片段拼入 Prompt → LLM 生成答案。
瓶颈:检索一次、生成一次、无反馈;对同义改写与专有名词不敏感;噪声段落直接进上下文;无法处理需要多文档综合的问题。
3.2 Advanced RAG
在 Naive 的三步上分别加工程化增强:
- Pre-retrieval
:查询改写(把口语化问题改写为检索友好形式)、查询扩展(同义词、相关实体)、HyDE、查询路由(向量库/全文库/图库/SQL); - Retrieval
:混合检索(BM25 + 向量,必要时加权融合)、多路召回、基于权限的元数据过滤; - Post-retrieval
:Cross-Encoder 重排(如 bge-reranker、Cohere Rerank)、上下文压缩与去重、Parent-Child 召回(检小片段、喂大上下文)。
3.3 Modular RAG
把 RAG 拆成可插拔模块,每个模块可以独立替换、调优、编排:
[查询规划] → [路由] → [检索器A/B/C] → [融合/重排] → [上下文压缩] → [生成] → [评估/记忆]模块间通过工作流编排(LangGraph、LlamaIndex Workflows、Dify 工作流等)组合,是 Agentic RAG 的工程基础。
3.4 GraphRAG
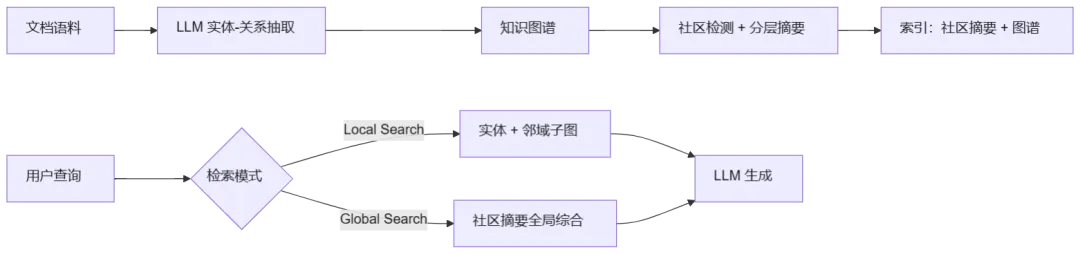
适用边界(GraphRAG-Bench 量化结论):基础事实检索用普通 RAG 足够;图结构在多跳推理、上下文摘要、全局性问题(“全书讲了什么主题”)上带来实质性增益,代价是显著更高的 Token 消耗与构建成本。简单问题用图 = 杀鸡用牛刀。
3.5 Agentic RAG
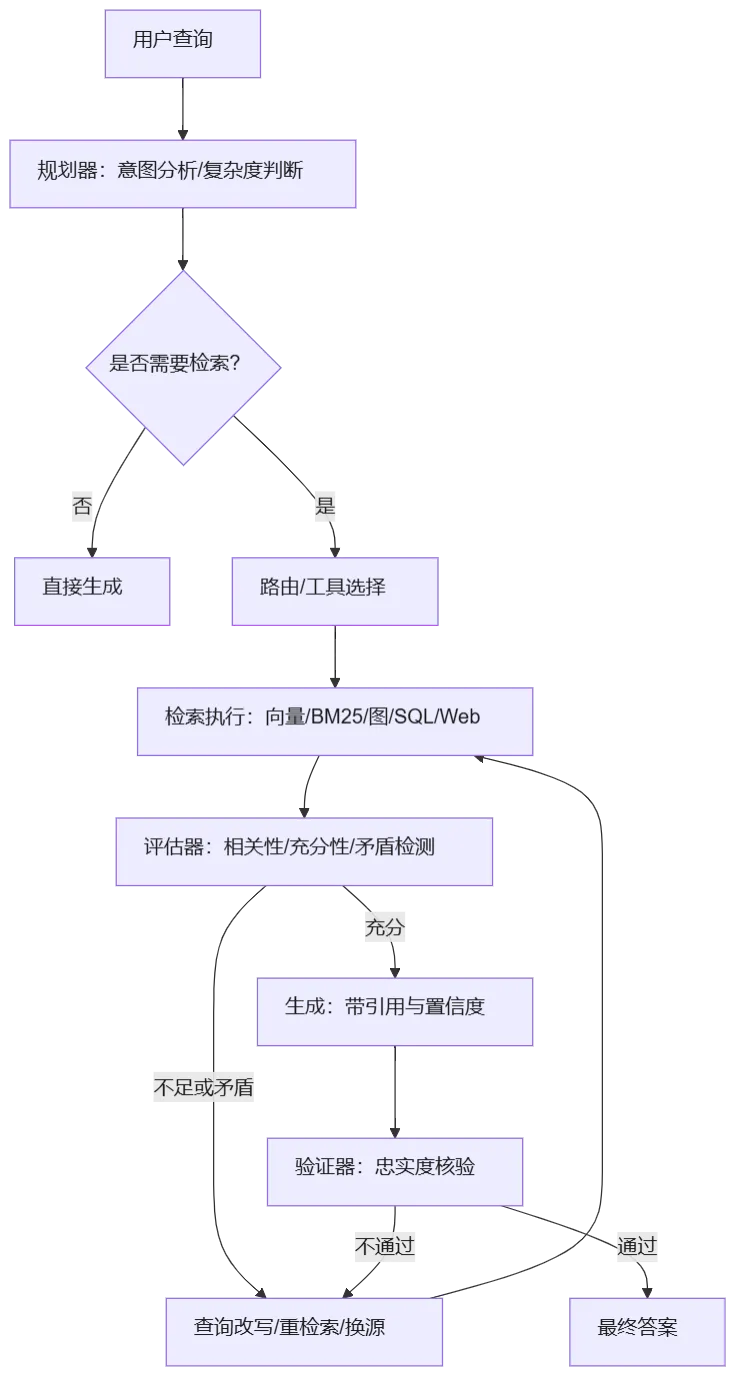
关键设计约束(生产环境尤其重要):
- 迭代上限
:通常 3—5 轮,防失控检索循环; - 成本/Token 预算
:单查询 LLM 调用次数上限; - 显式退出条件
:“检索不到就说不知道”,而不是无限检索或硬编; - 延迟分层
:简单查询走单次检索路径(毫秒级),复杂查询才进入 Agentic 循环。
3.6 范式对比表
| 极高 | |||||
| 优 | 优 | ||||
| 优 | |||||
| 优 | |||||
| 高 |
实践判断:约 70% 的真实项目最佳答案是混合架构——入口用路由/自适应策略,简单问题走快速单检索,复杂问题进 Agentic 循环,关系密集的知识域叠加图检索,而不是选一个范式走到黑。
4. 挑战与重难点
4.1 检索质量是天花板
- 语义鸿沟
:用户问法与企业文档措辞不一致,纯向量检索召回不足。HyDE、查询改写只能部分缓解。 - 专名/术语/精确匹配失效
:法律案号(“12 CFR 1026.2”)、产品 SKU、法条编号等精确字符串是向量检索的天然弱点。有案例显示,纯向量检索在含案号引用的法律查询中漏掉 31% 的查询。 - Embedding 漂移(Embedding Drift)
:更换 Embedding 模型或重新分块后,新旧向量空间不一致,导致检索质量静默退化。有团队报告重新分块后幻觉率上升 15%。 - 召回率与精确率的权衡
:Top-K 太小漏证据(“答案在第 6 位,只取了前 5”),太大引入噪声。
4.2 分块(Chunking)是"最被低估的工程决策"
固定 512 token 分块对真实文档是灾难:表格被拦腰截断、代码函数被劈成两半、PDF 复杂版式变成乱码。业界实践:
重难点:表格要保留行列关系,代码按函数/方法切,PDF 要处理多栏、页眉页脚、图表,图片要 OCR——RAG 是"Garbage In, Garbage Out"最典型的系统,数据管线的质量直接决定上层全部效果。
4.3 幻觉与"检索—生成"鸿沟
检索到了 ≠ 生成用对了。三类典型失败:
- Not in Context
:检索对了但上下文窗口装不下/优先级错误; - Not Extracted
:上下文里有答案,但 LLM 被噪声淹没没有正确抽取; - Noise/Contradiction
:检索结果含噪声或互相矛盾的信息。
U-NIAH 基准的实证数据(2025):噪声比例 >44% 时信息遗漏 +33.53%;长上下文 + 噪声比 >97% 时幻觉激增 +355.82%;答案逆序排列时信息遗漏 +59.64%。结论:检索质量、上下文信噪比与答案位置,是幻觉的三大放大器。
4.4 多跳推理与全局问题
多跳问题(“A 的供应商 B 的合同条款是什么”)信息分散在不同文档,单次检索无法覆盖——需要查询分解、迭代检索; 全局问题(“这个知识库覆盖了哪些主题”)需要全库级理解——向量检索力不从心,GraphRAG 社区摘要擅长此场景; - 知识泄漏(Knowledge Leaking)
:很多评测集(如 HotpotQA)的实体在 LLM 预训练中已见过,模型靠参数记忆作答,导致评测虚高、无法真实反映检索能力(AnonyRAG/匿名反转评测开始专门应对此问题)。
4.5 评估是"最难也最必要"的一环
RAG 是流水线系统,任何一环劣化都会传导到最终答案,且往往静默劣化。评估分三个层面:
- 检索质量
:Context Recall(关键证据是否都被召回)、Context Precision(召回的上下文是否真的有用)、Hit@k、MRR; - 生成质量
:Faithfulness(答案是否严格忠于上下文)、Answer Relevance(答案是否针对问题); - 系统指标
:延迟分拆、每查询成本、幻觉率、端到端成功率。
工具:RAGAS、TruLens、LangSmith 等。重难点:golden set 的建设(真实问题 + 专家答案)需要业务投入;LLM-as-Judge 本身可能偏差,需要人工抽样校准。
4.6 RAG vs 长上下文之争
2024 年起,Gemini 1.5(1M→2M token)、Claude(200K→1M token)等长上下文模型让"把整个文档库塞进上下文"成为可能,"RAG 已死?"成为年度话题。理性结论是互补而非替代:
- 长上下文优势
:对结构良好、信息密集的文档(维基文章、书籍)整体理解更好;简单抽取类问题表现佳; - 长上下文劣势
:Lost in the Middle 效应(LLM 偏向使用上下文头尾信息,忽略中间部分)不会随窗口增大消失;成本随 token 数指数上升;无法解决"知识库远超上下文上限"的问题;对碎片化、跨库问题不敏感; - RAG 优势
:只注入相关片段,信噪比高;计算成本低;支持超大规模知识库;天然支持权限过滤与引用溯源。
U-NIAH 实证(2025):统一基准下 RAG 相对直接长上下文整体胜率 82.58%,且上下文越长 RAG 优势越大([1–16k] 57.4% → [64–128k] 92.7%);小模型通过 RAG 提升最明显,能显著缓解 Lost-in-the-Middle。也有研究(RAG Scaling Law,2025)显示:在推理算力最优分配下,RAG 性能几乎随推理计算线性增长——长上下文模型是 RAG 的加速器,不是替代品。
最优策略是"混合路由":简单事实问题直接生成或轻量检索;需要全文档理解时直接把文档喂给长上下文模型;复杂多跳问题用 Agentic RAG + 图检索选材,再用长上下文模型做综合。
4.7 企业落地的失败模式(工程视角)
行业复盘(Rag About It 等)总结的七大失败点,几乎全部是工程问题而非模型问题:
- Missing Content
:知识库根本没有答案,系统不承认反而编造; - Missed Top-Ranked Documents
:答案排第 6,Top-5 截断导致错失; - Not in Context
:检对了但没进上下文(窗口/优先级/分块问题); - Not Extracted
:上下文有答案但模型没抽取出来(噪声/提示问题); - Wrong Format
:要求表格输出散文,格式不达标; - Incorrect Specificity
:回答粒度不对(过于泛化或过于冗长); - Incomplete Answers
:上下文管理导致部分回答。
再加上静默数据漂移(新文档格式变化、术语迁移、索引未触发更新——约 40% 的生产退化属于此类无声劣化)、文档管线不可扩展(5 千文档能跑、5 万文档就崩)、权限与合规(检索到无权限文档必须拦截)——RAG 本质上是一个分布式数据工程系统,需要与传统核心交易系统同等的运维成熟度。
4.8 成本与延迟陷阱
- Agentic 循环放大成本
:一次失控的迭代检索可触发 5—10 次 LLM 调用;单查询成本可从传统 RAG 的 $0.02 膨胀到 $0.50+; - 全量塞上下文
:把检索结果无脑塞满上下文窗口,成本指数上升且质量常下降(有案例把平均 prompt 从 45K token 压到 8K,准确率不变、成本降 82%); - Embedding 重复计算
:高频文档不缓存 embedding,成本白白流失(有案例通过语义缓存降低 73% embedding 成本); - GraphRAG 索引成本
:标准 GraphRAG 构建一个中型知识库曾消耗近 8000 万 token、耗时超 3 小时,动态更新场景不可持续。
5. 企业级 RAG 工程化实战
5.1 总体架构
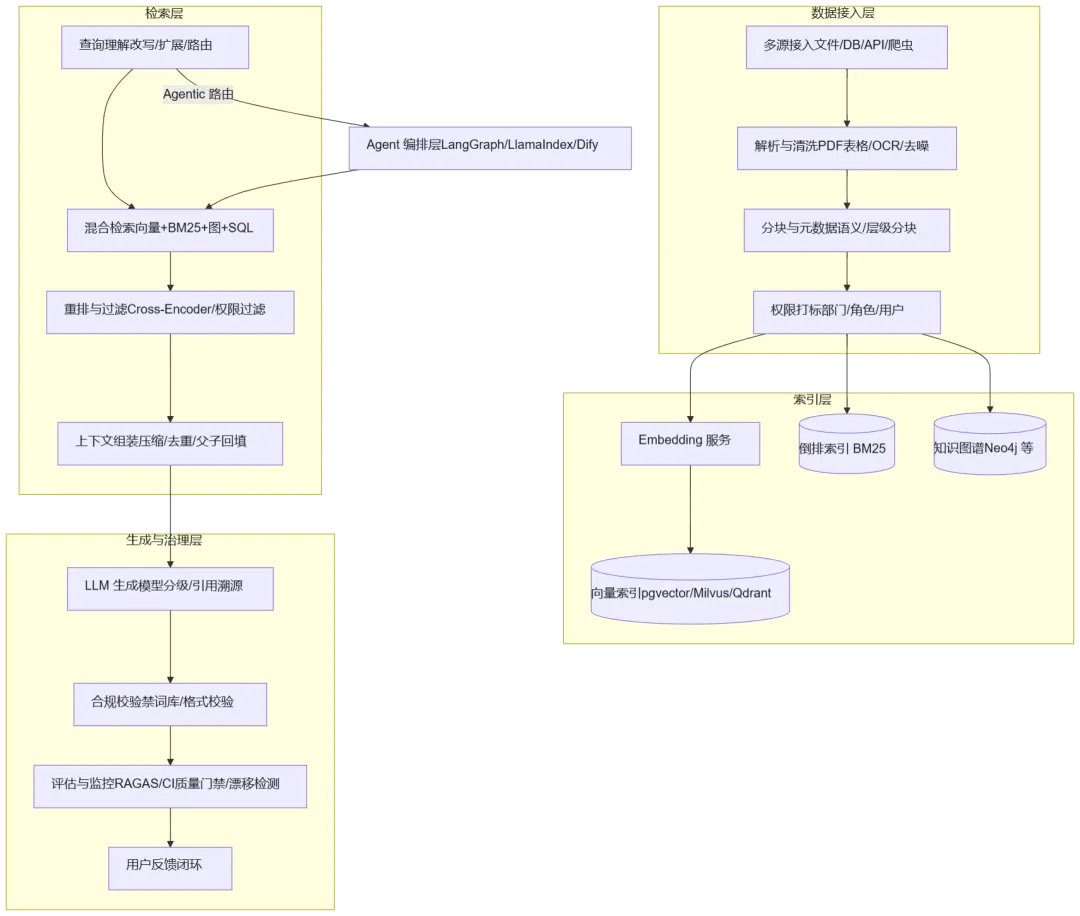
5.2 数据接入与治理(成功的起点)
- 多源适配
:PDF/Word/Excel/图片(OCR)/CAD/数据库表/API 都要有独立处理路径,而不是一个"万能解析器"; - 模块化处理链
:按文档类型分流(法律文档按条款、代码按函数、表格保留行列结构); - 增量索引
:新文档到达不重处理全量语料,支持增量入库与删除; - 文档血缘(Lineage)
:记录每个 chunk 来自哪个文档、哪一页、哪一节,谁上传、何时索引——这是审计与问题定位的基础; - 版本化
:文档、Embedding 模型、分块参数、Prompt 全部版本化,保证可复现、可回滚。
5.3 分块策略(按文档类型定制)
- 法律/合同
:按条款、章节切分,保留层级上下文;Parent-Child 策略(检子块、喂父块)效果显著——有医疗客户用层级分块把准确率从 73% 提升到 89%; - 技术文档/代码
:按函数、方法、代码块切分,维护函数间语义链接; - 表格
:用 LLM 转换保留行列关系,或把表格单元格作为独立图节点参与建模(AtlasGraphRAG 的做法); - PDF 复杂版式
:用 LlamaParse 等专业解析器处理多栏、内嵌表格与图表,普通文本提取器会毁掉结构信息。
5.4 Embedding 模型选型与微调
- 通用场景
:text-embedding-3-small/large、bge 系列、jina-embeddings-v3 等足够;实现混合检索 + 评估基线即可; - 领域术语敏感场景
:微调收益显著。案例:金融客户微调 jina-embeddings-v3(5 万条 query-doc 标注对),领域检索精确率 68%→84%,微调投入约 3 个月回本; - 成本与主权
:高吞吐场景自托管开源 Embedding 可降 85% 成本,且数据不出域(对政务、金融尤为重要); - 必须做基线
:建 50+ 条评测 query,先量化当前检索指标,再谈优化——没有基线的优化是盲人摸象。
5.5 向量数据库选型
| pgvector | ||
| Qdrant / Milvus | ||
关键:向量库不是越大越好,与业务数据同库(co-location) 往往比性能参数更重要——它让"向量 + 全文 + 结构化过滤 + 权限"一次查询完成,避免跨系统拼接。
5.6 混合检索与重排
- 混合检索是标配而非可选项
:纯向量在专名、缩写、精确条款上必然漏检。实践配比示例:稠密向量 70% + BM25 30%(权重需按业务 query 分布调);法律客户加混合检索后,伪造案号引用减少 94%; - 两阶段"召回-精排"
:向量库/BM25 宽召回(Top 50-100)→ Cross-Encoder 精排(Top 5-10)→ 权限过滤 → 进上下文; - RRF(Reciprocal Rank Fusion)
:多路召回结果按排名倒数融合,简单稳定; - 元数据过滤
:部门、文档类型、时间范围等结构化条件在检索阶段就过滤,而不是生成阶段补救。
5.7 生成层设计与引用溯源
- 结构化输出
:JSON Schema / Function Calling 约束输出字段(如 clause_type, risk_level, suggested_action),下游解析错误率降 96%; - 强制引用
:Prompt 要求"每个论断必须标注来源 chunk ID",生成端到端的引用链接; - 不确定拒绝
:低于置信度阈值时明确说"不知道",并给出触发阈值——合规级系统必须如此; - 模型分级路由
:简单查询用轻量模型(如 mini 级),复杂分析用旗舰模型,高安全负载用私有模型——有案例路由后 LLM 成本降 58%,70% 查询走了小模型; - 上下文瘦身
:重排保 Top-5 + 压缩去重 + 背景信息摘要化,而非无脑塞满窗口。
5.8 评估体系与 CI/CD 质量门禁
把"感觉不错"变成"可量化、可回归、可阻断":
- Golden Set
:真实业务查询 + 专家标注答案 + 期望引用的文档集合,覆盖核心用例与对抗用例(歧义查询、矛盾来源); - 自动化评估
:RAGAS(faithfulness/context recall/context precision/answer relevance)+ LLM-as-Judge + 少量人工抽样校准; - CI 质量门禁
:每次 PR/发版跑评估集,faithfulness、recall、延迟 SLO 跌破阈值即阻断合并; - 回归与回滚
:Embedding 模型、分块参数、Prompt 变更必须过回归;线上指标异常自动回滚/灰度; - 数据版本化
:用 DVC 等管理数据集与索引版本,防止"神秘回归"。
5.9 可观测性与监控
- 指标
:检索延迟分拆(embedding/检索/重排/生成)、每查询成本、检索精确率@k、幻觉率(抽样 LLM 判分)、用户反馈分数、漂移检测(query 分布/来源数据变化); - 链路追踪
:记录 query→检索结果→重排→Prompt→答案 全链路快照,出问题可复现历史查询(LangSmith、Arize、OpenTelemetry + Grafana 等); - 周期性体检
:每小时/每天跑一组合成查询,质量跌破阈值即告警——有法律客户借此抓住"文档更新未触发重索引"的静默 bug; - 反馈闭环
:100% 收集用户 thumbs up/down,人工重点审阅负面反馈的 5%,沉淀为微调与 golden set 的新样本。
5.10 安全、权限与合规
- 文档级/片段级 RBAC
:每个 chunk 绑定"部门/角色/用户"权限标签,检索结果按当前用户权限过滤——检索到不代表能返回; - PII 扫描
:知识库入库前与用户 query 都做敏感信息扫描; - 合规校验
:金融等强监管场景内置"禁词库"(如"保本"“无风险”),违规内容自动拦截/修正; - 数据主权
:私有化部署或混合云(敏感数据本地、非敏感上云),数据不出域; - 审计
:谁上传、谁访问、检索了什么、答案引用了什么,全链路可审计; - 来源可溯
:答案必须能追溯到"文档名 + 页码 + 段落",而非泛泛的"来自客服手册"。
5.11 成本优化清单
语义缓存(Redis/向量缓存):高频 query 与文档 embedding 缓存,可降 73% embedding 成本; Prompt 缓存 + 上下文压缩:有案例 prompt 45K→8K token,成本降 82% 不失准确率; 模型分级路由:小模型处理 70% 简单请求,成本降 40—60%; Agentic 预算:硬性迭代上限(3—5 轮)+ 每查询 token 预算 + 明确退出条件; 自托管 Embedding/开源模型:高吞吐场景成本降 85%。
5.12 典型落地案例(企业实践)
5.13 落地路线图与决策框架
不要一上来就上 Agentic RAG。 行业共识的四步走:
- 先做传统 RAG,量化基线
:测量幻觉率、检索精确率、用户满意度。幻觉率 <5% 且用户满意 → 不需要 Agentic;>10% → 控制环路会带来实质提升; - 定位失败模式
:检索排序问题 → 重排;答案跨文档 → CRAG/查询分解;多源综合 → Adaptive RAG + 查询分解; - 先加轻量评估器(Corrective RAG)
:在检索与生成之间加一个检索质量评估器,拦截大部分检索失败,延迟开销极小;评估器持续报警再升级到全 Agentic; - 预算与监控从第一天建
:迭代上限、token 预算、延迟上限、检索健康度监控,而不是上线后补。
时间预期:原型 1—2 周,生产级系统(含安全加固、监控、评估)约 3—6 个月。RAG 是"数据工程 + 分布式系统 + LLM"三者的交集,工程严谨度决定生死。
6. 前沿方向与趋势展望(2025—2026+)
- Agentic RAG 成为默认形态
:从"检索一次"走向"检索即控制循环",提示式(ReAct/Search-o1)与训练式(Search-R1/DeepRetrieval/ReZero)双轨并行;训练式把"何时检索"内化为模型能力,是推理模型之后的下一个模型侧方向。 - GraphRAG 从实验室走向工程化
:GraphRAG-Bench 等基准让"何时用图"有了量化答案;Youtu-GraphRAG 用"图模式"统一构建与检索;AtlasGraphRAG 的"图模融合"把图谱推理深度介入生成。神经符号融合(大模型泛化 + 图谱确定性)被列为知识图谱与大模型交叉领域最重要的方向之一。瓶颈仍是构建成本与增量更新。 - RAG vs 长上下文 → 融合
:长上下文模型成为 RAG 的"阅读理解增强器",两者按查询复杂度混合路由;RAG Scaling Law 表明推理算力与检索可协同扩展。 - 多模态 RAG
:表格、图片、音视频纳入检索(OCR + 视觉理解 + 向量对齐),文档理解从纯文本走向版式与图表级。 - 记忆增强 RAG
:持久化向量记忆 + 对话记忆,让系统跨会话积累"已知/未知",解决"每轮从零开始"的问题。 - 评估与基准科学化
:AnonyRAG(匿名反转)对抗知识泄漏;GraphRAG-Bench、RAGSearch 等统一基准上线——评测正在从"论文玄学"走向"可复现坐标"。 - 上下文工程(Context Engineering)
:检索、压缩、路由、注入的工程化被视为与大模型能力同等重要的"第四要素"——RAG 是其核心载体。
7. 学习资源清单
7.1 必读论文(按阅读顺序)
| 必读综述 | ||
| Agentic RAG 权威综述 | ||
7.2 课程与教程
- 吴恩达 DeepLearning.AI 系列短课程
(实战导向,适合工程落地): Building and Evaluating Advanced RAG:https://www.deeplearning.ai/short-courses/advanced-retrieval-for-ai/ Knowledge Graphs for RAG:https://www.deeplearning.ai/short-courses/knowledge-graphs-rag/ Multimodal RAG: Chat with Videos:https://www.deeplearning.ai/short-courses/multimodal-rag-chat-with-videos/ - ACL 2023 Tutorial: Retrieval-based Language Models
:https://acl2023-retrieval-lm.github.io/ - Stanford CS25 V3 - Douwe Kiela: Retrieval Augmented Language Models
(系统讲解 RAG,YouTube 可搜) - W&B RAG++: From POC to Production
:https://www.wandb.courses/courses/rag-in-production - Hugging Face NLP Course(检索部分)
:https://huggingface.co/learn/nlp-course - 清华大学 NLP 公开课(刘知远团队,B 站)
:中文语境下的模型与知识增强
7.3 开源框架与项目
7.4 高质量博客与社区
- LangChain Blog
:https://blog.langchain.com/(RAG/Agent 实战剖析) - LlamaIndex Docs
:https://docs.llamaindex.ai/(分块、检索、评估方法论) - Pinecone Learning Center
:https://www.pinecone.io/learn/(向量检索系统教程,经典入门) - Weaviate Blog
:https://weaviate.io/blog(混合检索、向量库对比) - Microsoft Research GraphRAG 博客
:https://www.microsoft.com/en-us/research/blog/ - arXiv(cs.CL / cs.IR 栏目)
:https://arxiv.org/list/cs.CL/recent(跟踪前沿) - 中文社区
:知乎"检索增强生成"话题、CSDN、InfoQ 中国(RAGFlow/Agent 深度文章)、B 站清华大学 NLP 公开课
8. 结语
RAG 用六年时间走完了"论文概念 → 生态爆发 → 范式分化 → 工程成熟"的完整周期。2026 年的行业图景已经清晰:RAG 不再是单一技术,而是一个"数据工程 + 检索系统 + 生成模型 + 智能体编排 + 评估治理"的复合工程。长上下文没有杀死 RAG,反而成为它的增强器;Agentic 化没有推翻 RAG,而是把"检索"从一次动作升级为可控的决策循环;图结构没有替代向量检索,而是为多跳推理补上了确定性的一环。
对工程师而言,最重要的判断力在于:知道每个范式的能力边界与成本结构,用混合架构和分层路由去匹配真实业务,用评估与可观测性守住质量底线。RAG 的成败不在论文里的 SOTA,而在数据管线的严谨、评估体系的完备与生产环境的纪律——这才是"从 Demo 到生产"真正的分水岭。
9. 参考资料
Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 2020. https://arxiv.org/abs/2005.11401 Gao et al., Retrieval-Augmented Generation for Large Language Models: A Survey, 2023. https://arxiv.org/abs/2312.10997 Singh et al., Agentic Retrieval-Augmented Generation: A Survey, 2025. https://arxiv.org/abs/2501.09136 Edge et al., From Local to Global: A Graph RAG Approach to Query-Focused Summarization, 2024. https://arxiv.org/abs/2404.16130 Asai et al., Self-RAG, ICLR 2024. https://arxiv.org/abs/2310.11511 Yan et al., Corrective Retrieval Augmented Generation, 2024. https://arxiv.org/abs/2401.15884 Sarthi et al., RAPTOR, 2024. https://arxiv.org/abs/2401.18059 Jeong et al., Adaptive-RAG, 2024. https://arxiv.org/abs/2403.14403 Es et al., RAGAS, 2023. https://arxiv.org/abs/2309.15217 Liu et al., Lost in the Middle, 2023. https://arxiv.org/abs/2307.03172 RAGSearch: Do We Still Need GraphRAG? Benchmarking RAG and GraphRAG for Agentic Search Systems. https://arxiv.org/html/2604.09666v1 Is GraphRAG Needed? From Basic RAG to Graph-/Agentic Solutions with Context Optimization. https://arxiv.org/html/2606.25656v1 Youtu-GraphRAG (ICLR 2026) 技术解读. https://en.papernotes.org/ICLR2026/information_retrieval/youtu-graphrag_vertically_unified_agents_for_graph_retrieval-augmented_complex_r/ 图结构增强RAG的实证进展与边界——评GraphRAG-Bench最新评测(36氪). https://36kr.com/p/3994003331611654 Building Production-Ready AI Applications with RAG(Acceli, 2025-11). https://www.acceli.com/blog/building-production-ready-ai-applications-with-rag How to Build Production-Ready RAG Systems(Alex Bobes, 2025-11). https://alexbobes.com/artificial-intelligence/how-to-build-production-ready-rag-systems/ Production RAG in 2025: Evaluation Suites, CI/CD Quality Gates, and Observability(Dextra Labs, 2025-11). https://dextralabs.com/blog/production-rag-in-2025-evaluation-cicd-observability/ The Engineering Gap: Why 73% of Enterprise RAG Systems Fail(Rag About It). https://ragaboutit.com/the-engineering-gap-why-73-of-enterprise-rag-systems-fail-where-they-matter-most/ Agentic RAG: Retrieval as a Control Loop(Fordel Studios, 2026-09). https://fordelstudios.com/research/agentic-rag-production-retrieval-control-loop-2026 企业级RAG系统(PIKE-RAG)架构与案例(CSDN, 2025-08). https://blog.csdn.net/weixin_43156294/article/details/150769554 RAG 2.0 — 融合图、推理与决策的知识增强新范式(同济大学 KGLLM 团队演讲). https://tongji-kgllm.github.io/assets/talks/RAG2.pdf 什么是 Agentic RAG(腾讯云开发者社区). https://developer.cloud.tencent.com/techpedia/2721 检索增强生成引擎 RAGFlow 开源(InfoQ). https://github.com/infiniflow/ragflow RAGAgentique Avancé 2026(RAG 演进与生产实践, 法文). https://ayinedjimi-consultants.fr/static/pdf/rag-agentique-multi-agents-graphrag-2026.pdf 从零到精通:2026 大模型学习资源推荐(稀土掘金). https://juejin.cn/post/7588010346071539722