ARTICLE · 1220506
AI芯片的NoC开始参与计算了:组播与归约如何改变片上互连
AI加速器的计算单元正在变得越来越密集。一个芯片内部可能集成数十甚至数百个计算Tile,它们通过片上网络(NoC)交换数据、分发任务和同步计算结果。随着计算规模扩大,片上通信的效率开始直接影响计算资源的利用率。
在传统设计中,NoC主要承担数据传输:把数据包从一个计算单元送到另一个计算单元,完成路由、仲裁和流量控制。但AI工作负载包含大量广播、归约和同步操作,数据经常需要同时到达多个计算单元,或者由多个计算单元汇聚到同一个位置。
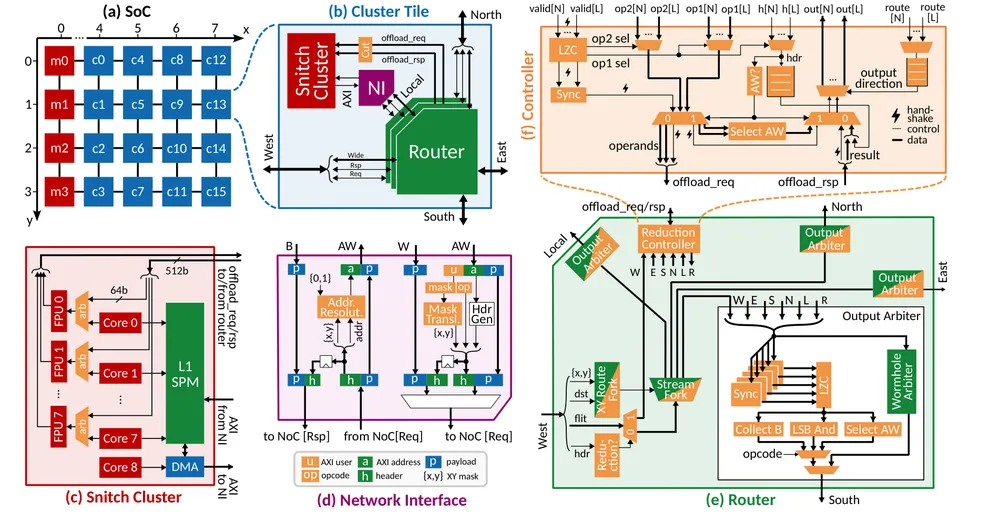
支持集合通信的NoC架构,将计算资源与片上数据传输网络连接起来。
当这些操作越来越频繁,仅靠提高NoC带宽已经难以解决所有问题。MLSys 2026的一项研究提出了新的思路:让NoC直接支持集合通信,使部分原本由计算单元组织的通信操作在网络内部完成。
01|AI计算为什么给NoC增加了新任务?
以矩阵计算为例,同一组权重可能需要分发给多个计算Tile。传统单播网络可以把数据分别发送给每个目的地,但如果接收端很多,相同的数据就可能在共享链路上被重复传输,占用带宽和路由器缓冲资源。
另一类常见操作是归约(Reduction)。多个计算Tile分别产生部分结果,需要通过求和、最大值等操作合并为最终结果。在传统实现中,数据通常先被送往指定计算单元,再由计算单元完成合并。随着参与者数量增加,数据汇聚可能造成局部链路拥塞,也增加了同步等待。
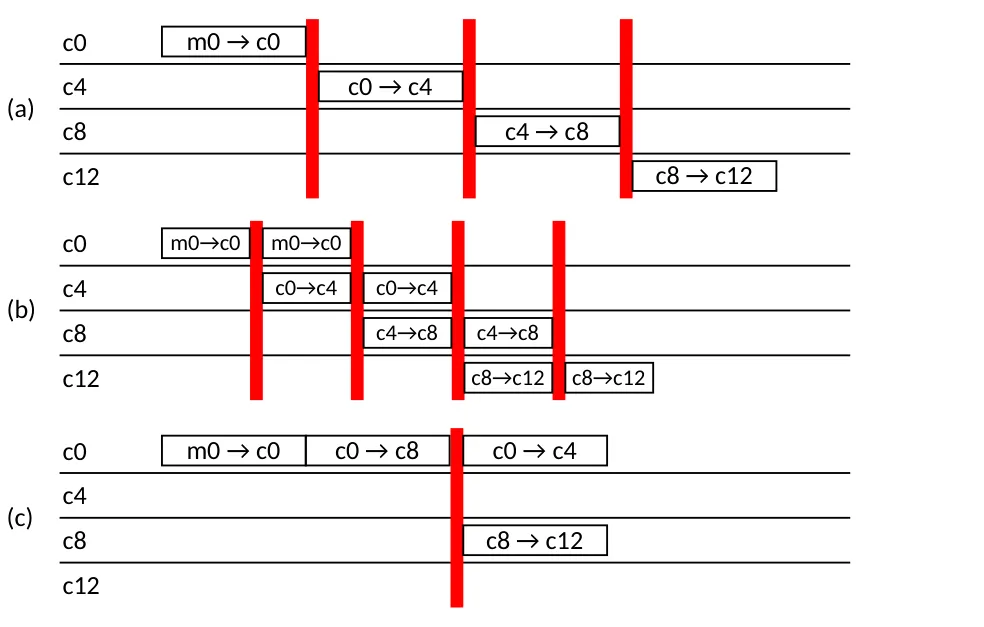
组播与归约具有不同的数据流动特征,对片上互连提出了新的要求。
这两类操作分别对应集合通信中的Multicast和Reduce。它们并非AI芯片独有,但大规模并行计算提高了这些操作的频率,也让通信组织方式对性能的影响更加明显。
问题的关键在于,传统NoC往往把这些通信模式当作普通数据包传输,而没有充分利用组播和归约本身的结构特征。
02|让NoC理解组播和归约
MLSys 2026论文研究人员基于开源FlooNoC提出了一种支持集合通信的NoC架构。
对于组播,网络不必让发送端生成多份相同数据,而是利用路由结构在合适的分支位置复制数据包。共享链路只需要传输必要的数据副本,减少重复传输。
对于归约,研究提出了Direct Compute Access(DCA)机制,使网络能够调用计算资源执行部分归约操作。这样一来,部分数据可以在传输过程中完成合并,减少后续需要传输的数据量。
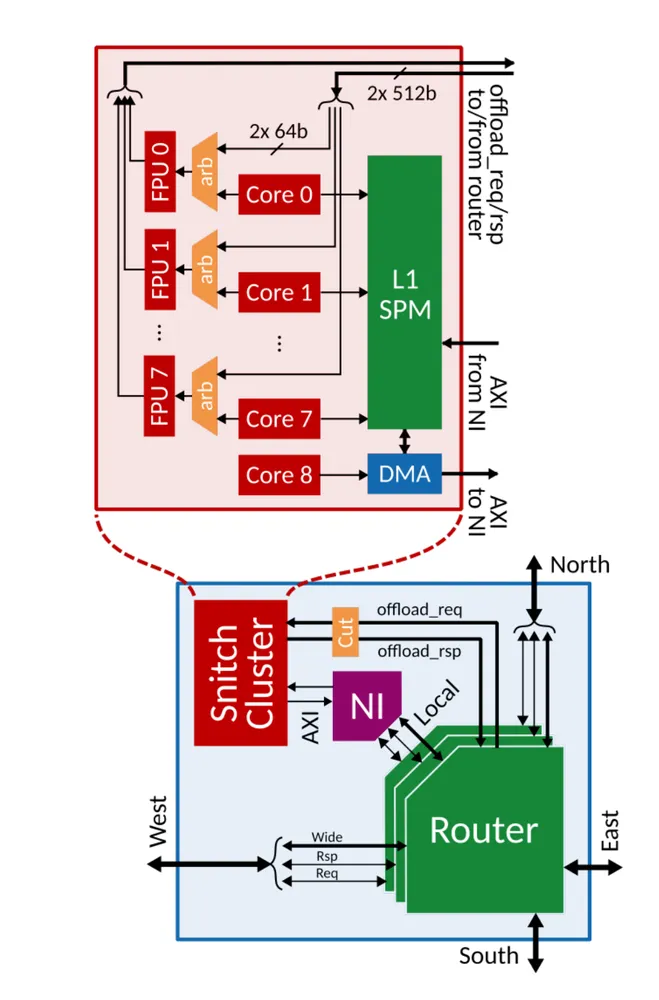
DCA使NoC能够调用计算资源执行部分归约操作,减少不必要的数据传输。
需要注意,这并不意味着每个NoC路由器都变成了计算核心。研究的重点是让通信网络识别集合操作,并通过DCA协调计算资源,而不是在每个路由节点部署完整的算术单元。
这种设计也避免了简单地把大量计算逻辑塞进路由器所带来的面积、功耗和时序压力。
03|通信优化能带来多少收益?
论文在支持集合通信的NoC原型上进行了评估。对于1—32 KiB的数据规模,研究报告的几何平均加速如下:
Multicast(组播):2.9倍 Reduce(归约):2.5倍 路由器面积开销:16.5%
这些数据说明,对于具有明显集合通信特征的工作负载,网络结构优化能够显著减少通信时间。
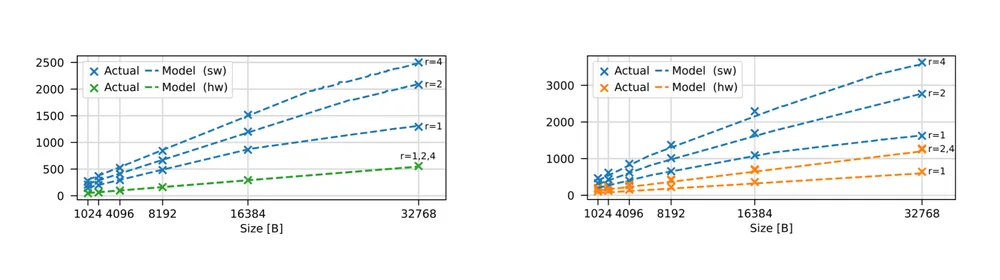
支持集合通信的NoC在1—32 KiB数据规模下获得组播与归约性能提升。
但这些结果来自论文所评估的特定架构和数据规模,并不代表整个AI模型推理速度能够提高2.9倍。实际收益仍取决于通信在总执行时间中的占比、计算与通信能否重叠,以及工作负载的具体拓扑。
从硬件设计角度看,16.5%的路由器面积开销也值得关注。NoC支持更复杂的通信语义,需要在路由资源、缓冲、控制逻辑和芯片面积之间重新权衡。
04|NoC的设计边界正在扩大
传统NoC设计重点关注拓扑、链路带宽、路由算法、虚拟通道、仲裁和拥塞控制。这些基础机制依然重要,但面对AI计算,互连架构师还需要考虑数据本身的通信模式。
例如,一个计算任务是否存在大量一对多的数据分发?多个计算单元是否频繁执行求和归约?网络能否在不引入复杂全局同步的情况下组织这些操作?这些问题都会影响NoC应该提供哪些硬件能力。
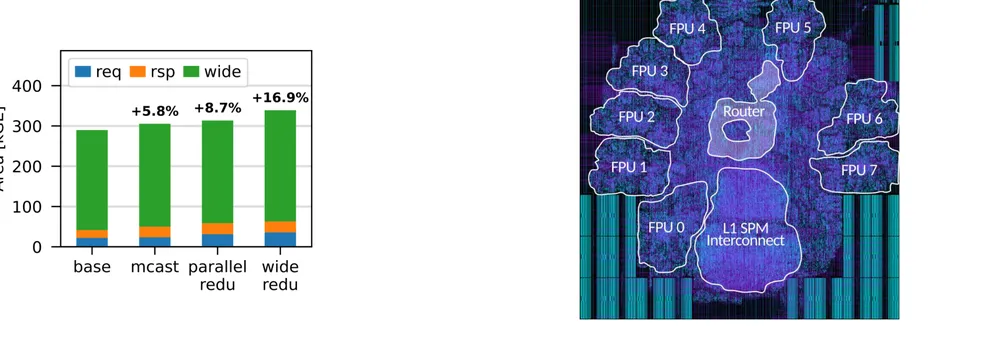
集合通信支持需要在NoC控制逻辑、路由资源与硬件面积之间进行权衡。
对NPU和SoC架构师而言,这也意味着计算Tile与NoC之间的接口可能需要提供更多通信语义。过去由软件或计算核心组织的广播、归约操作,可以通过硬件通信机制获得更高效率,但编译器和运行时也需要能够识别并调用这些能力。
NoC正在从通用的数据传输基础设施,向理解特定计算通信模式的专用互连演进。这并不意味着所有SoC都需要在NoC中增加集合通信支持。对于通信规模较小、数据流相对简单的设计,传统网络可能仍然更划算。
但对于拥有大量并行计算单元的AI加速器,NoC已经不只是连接计算核心的线路。它所支持的通信操作、数据复制方式以及与计算资源的协同机制,都可能成为决定系统效率的重要因素。