ARTICLE · 1226164
AI的下一场进化,发生在模型外面
OpenAI前研究副总裁:AI自我改进的钥匙,不在模型里
AI 自我改进的钥匙,不在模型里——在模型外面。
这是前 OpenAI 研究副总裁 Lilian Weng 今年 7 月给出的答案。在一篇三十分钟读完的综述《Harness Engineering for Self-Improvement》里,她把一个悬置六十年的预言拉回了工程图纸前。
1965 年,统计学家 I. J. Good 写下著名预言:超智能机器,是能设计出比自己更好的机器的机器。「智能爆炸」从此进入人类词汇表,但六十年来一直停在科幻与哲学的交界处。
由 Weng 来讲这个话题,分量够重:她在 OpenAI 工作七年,创建过机器人团队,执掌过安全系统团队;业内更熟悉的身份是博主,Lil'Log 是 AI 领域引用率最高的技术博客之一。她还曾短暂离职创办具身智能公司,随后回归。
她的答案,指向模型外面那层叫 harness 的脚手架。开始之前,先看一张图。
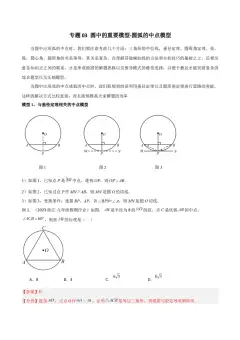
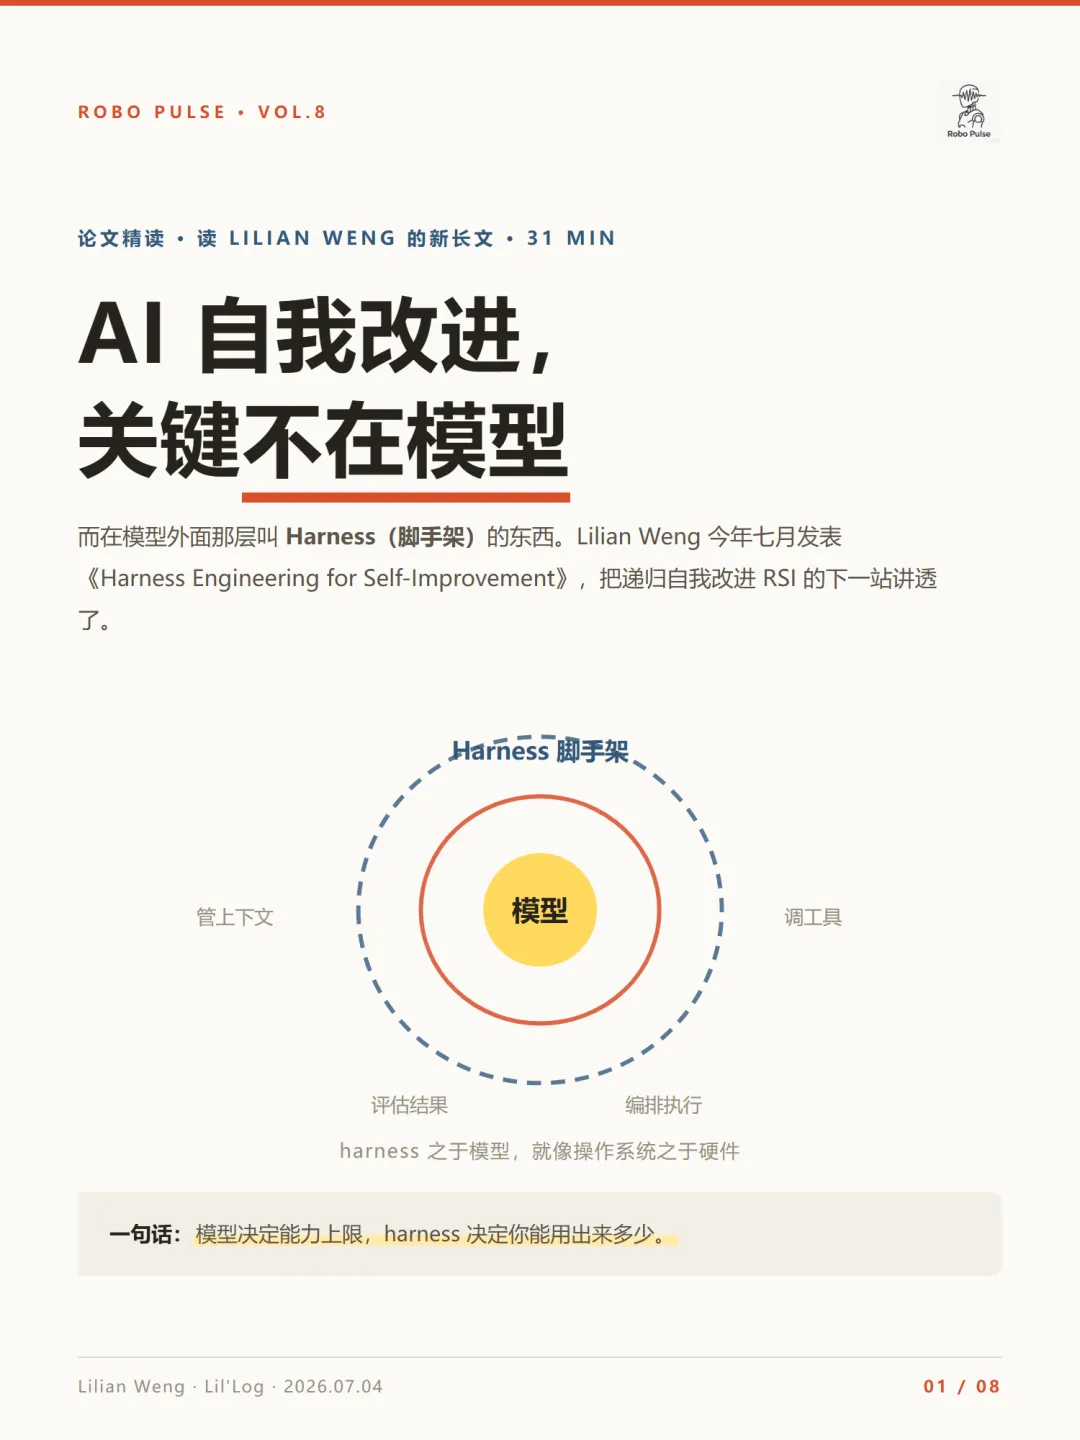 图1|一图看懂:模型在圆心,harness 在外面那一圈
一、Harness 是什么:从「套壳」到整车工程
先说 RSI,全称 Recursive Self-Improvement,递归自我改进。I. J. Good 当年设想的,就是 AI 用现有智能改进制造智能的机制。
但 Weng 开篇就纠正了一个流行误解:今天讨论 RSI,含义已经变了。它不只是模型改写自己的权重,还包括改进训练管线与部署系统本身。
Harness 指围绕基础模型搭建的那一层系统:编排执行流程,决定模型如何规划与反思,调用工具,管理上下文,存储产物,评估结果。
Weng 打了一个精准的比方:harness 之于模型,就像操作系统之于硬件,把复杂逻辑封装起来,让接口保持简单。
我们夸一个 AI 产品「聪明」时,夸的到底是模型,还是这层壳?模型决定能力上限,harness 决定你能用出来多少。
Weng 还有一个关键判断:近期的 RSI 不会从改权重开始,而会从 harness 演进开始。harness 会先长成一种「改进『获取更好答案的机制』的方法论」,再反哺自动研究的闭环。
这里有必要为 harness 正名。中文语境里「套壳」是个贬义词,仿佛壳就是包一层 API 的皮。但读完这篇综述会发现,严肃的 harness 工程和「套壳」是两个物种。
它要设计任务循环的收敛条件,要决定什么信息进上下文、什么落盘、何时召回,要为每个工具写精确的描述,要搭测试环境让失败可见,还要防着模型在循环里学会作弊。
每一项都是实打实的系统工程。这些工程的总和,决定了同一个模型在不同产品里的表现可以差出一个代际。用户感知到的「AI 能力」,一大半其实是 harness 能力。
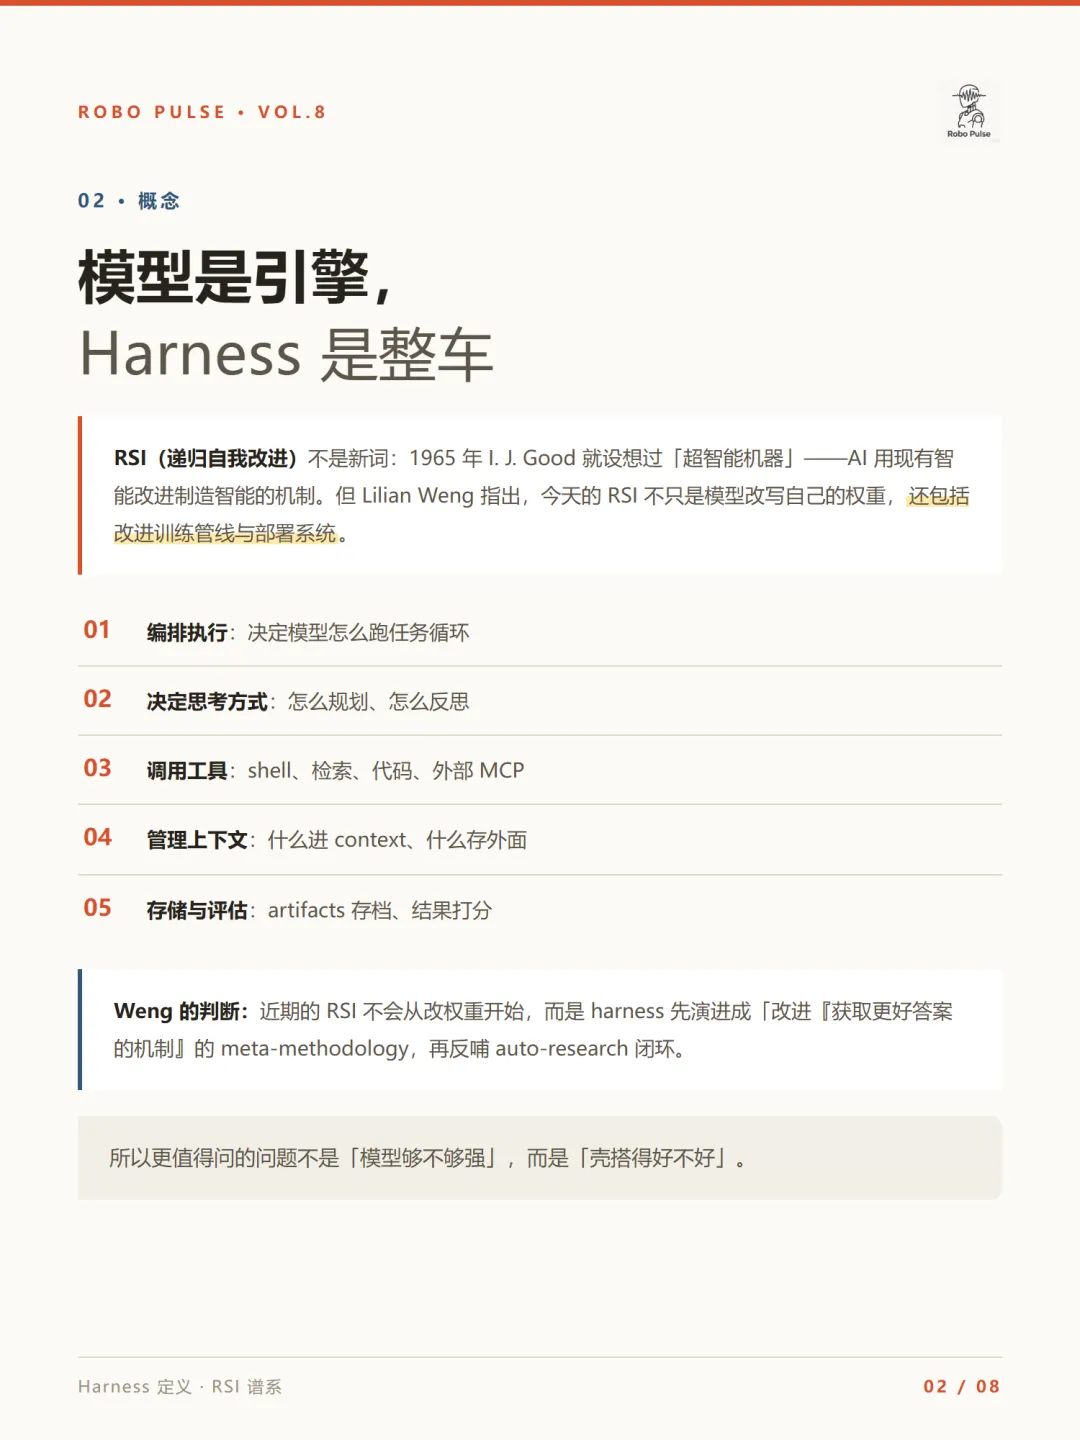 图2|模型是引擎,harness 是整车
二、三种设计模式:行业已经用脚投票
这篇综述最扎实的部分,是 Weng 把散落各家的实践收拢成三个设计模式。
模式一,工作流自动化。目标导向的循环:规划、执行、观察测试、改进,直到达标。Karpathy 的 autoresearch、Codex 的 agent loop,本质都是这个形状。
模式二,文件系统即持久记忆。别把所有日志塞进上下文窗口,持久状态存成文件。一句话:记忆在盘上,不在窗口里。
模式三,子 agent 与后端任务。并行派生子 agent、监控后台长任务,关键原则是让并行性「explicit and inspectable」:存成文件和日志,随时可查。
三个模式不是理论构想。Weng 举了一个旁证:Claude Code、Codex、OpenCode 这些主流 coding agent 的工具接口已经高度趋同,glob、grep、edit、bash、MCP、子 agent 派生,十几种工具,各家的命名和边界几乎一致。
接口趋同说明行业已形成共识:壳的形态是可以被工程化的。
再往深一层,是三个模式背后的设计哲学。工作流循环的关键变量是「观察」环节的质量:测试跑得快不快、错误信息读得懂不懂,直接决定循环收敛的速度,所以好的 harness 会不惜工本把测试环境做得又快又稳。
文件系统做记忆的要义在「分层」:context 只放当前需要的信息,历史轨迹、中间产物、任务状态全部落盘,需要时再检索。这相当于给模型装了一个可分页的虚拟内存。
子 agent 并行的要点在「可见」。并行性一旦不可见,调试成本指数级上升;把每个子任务的状态存成文件,人才有资格当监督者。
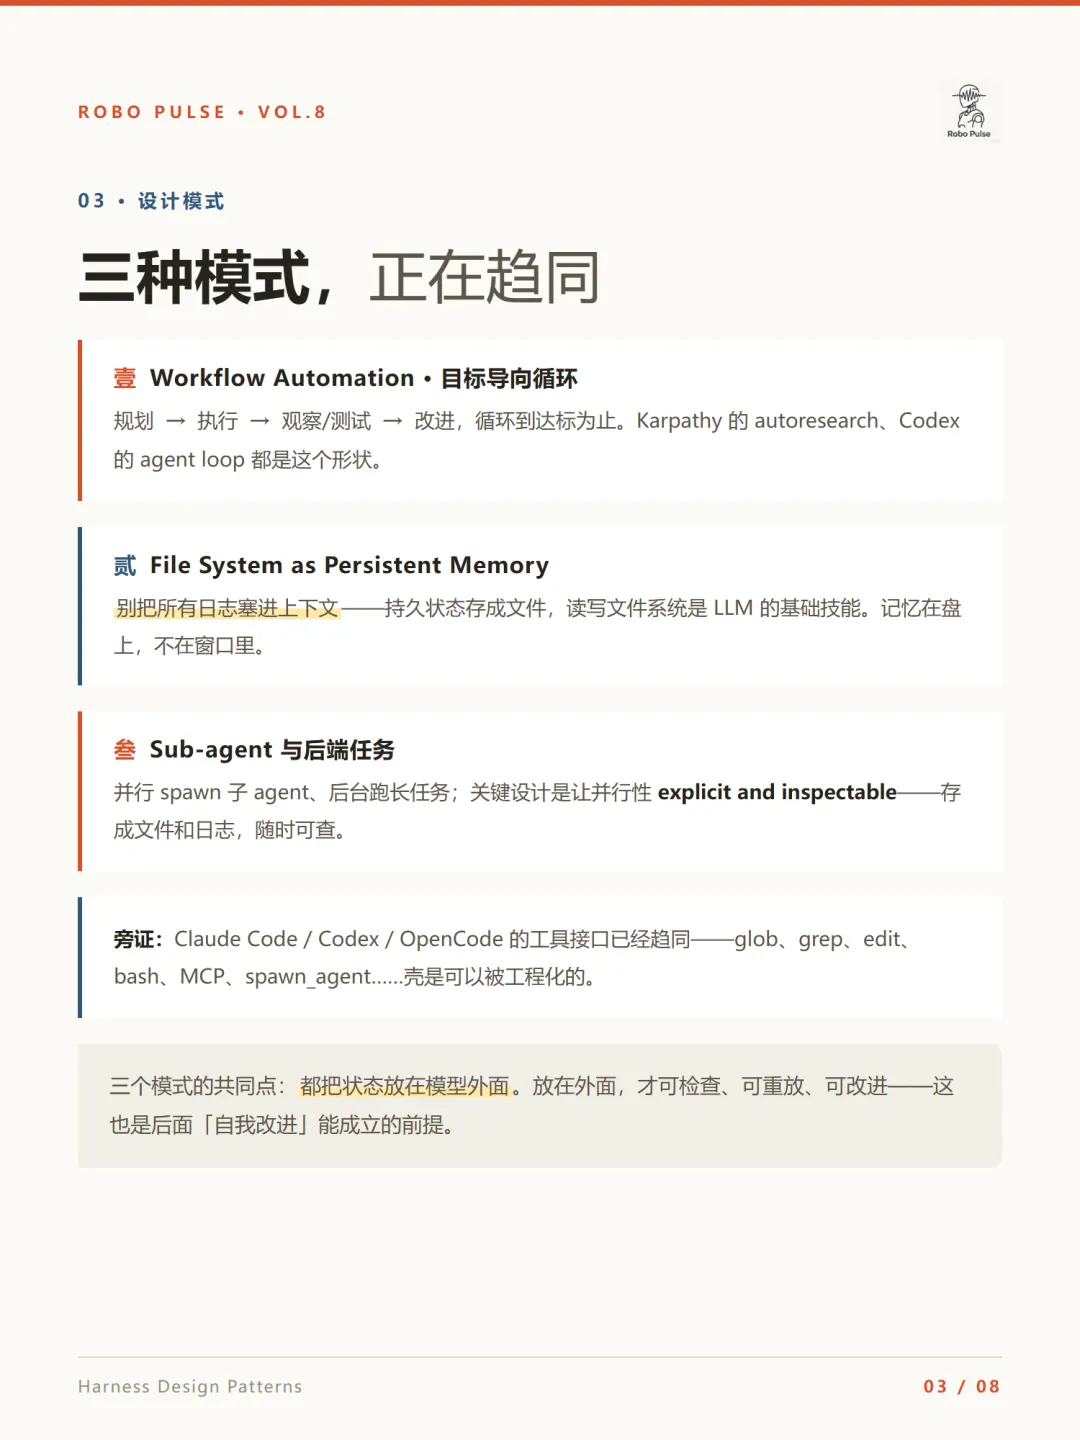 图3|三大设计模式与趋同的工具接口
三、上下文工程:从填窗口到打 playbook
第二条主线,是上下文工程的快速进化。
2025 年的 ACE 把上下文当成一份不断进化的 playbook:Generator 产出执行轨迹,Reflector 提炼成败洞见,Curator 把洞见结构化编入手册。三个角色用确定性逻辑合并更新,防止上下文坍缩和「越缩越短」的偏置。
2026 年的 MCE 更进一步:机制与内容分离,双层优化,内层找最优上下文,外层进化 skill 本身。
同年的 Meta-Harness 干脆研究「优化 harness 的 harness」:让 coding agent 充当提案人,直接修改决定信息怎么存、怎么取、怎么呈现的代码,同时输出几套各有优劣的候选,在 TerminalBench-2 上验证有效。
这条进化链的方向很清晰:prompt、context、skill、harness,正在被逐层变成可优化的对象,越来越像编译器优化栈。两年前我们还在为怎么写好一句 system prompt 争论,现在,上下文工程已经从手艺活变成了有方法论、有基准、有论文的正式学科。
工作流本身的自动设计也在推进。ADAS 让 agent 以代码形式提出新的多 agent 工作流并自检入库;AFlow 把工作流表示成图,用蒙特卡洛树搜索优化,成绩超过人工设计。科研场景里,AI Scientist 在 Nature 上跑通了从想法到评审的全流程;Autodata 用四个角色协作,专门合成强模型刚好能解、弱模型解不了的数据。
这些工作共同指向一个判断:工作流不再是写死的脚本,它成了可搜索、可进化、可审计的优化对象。
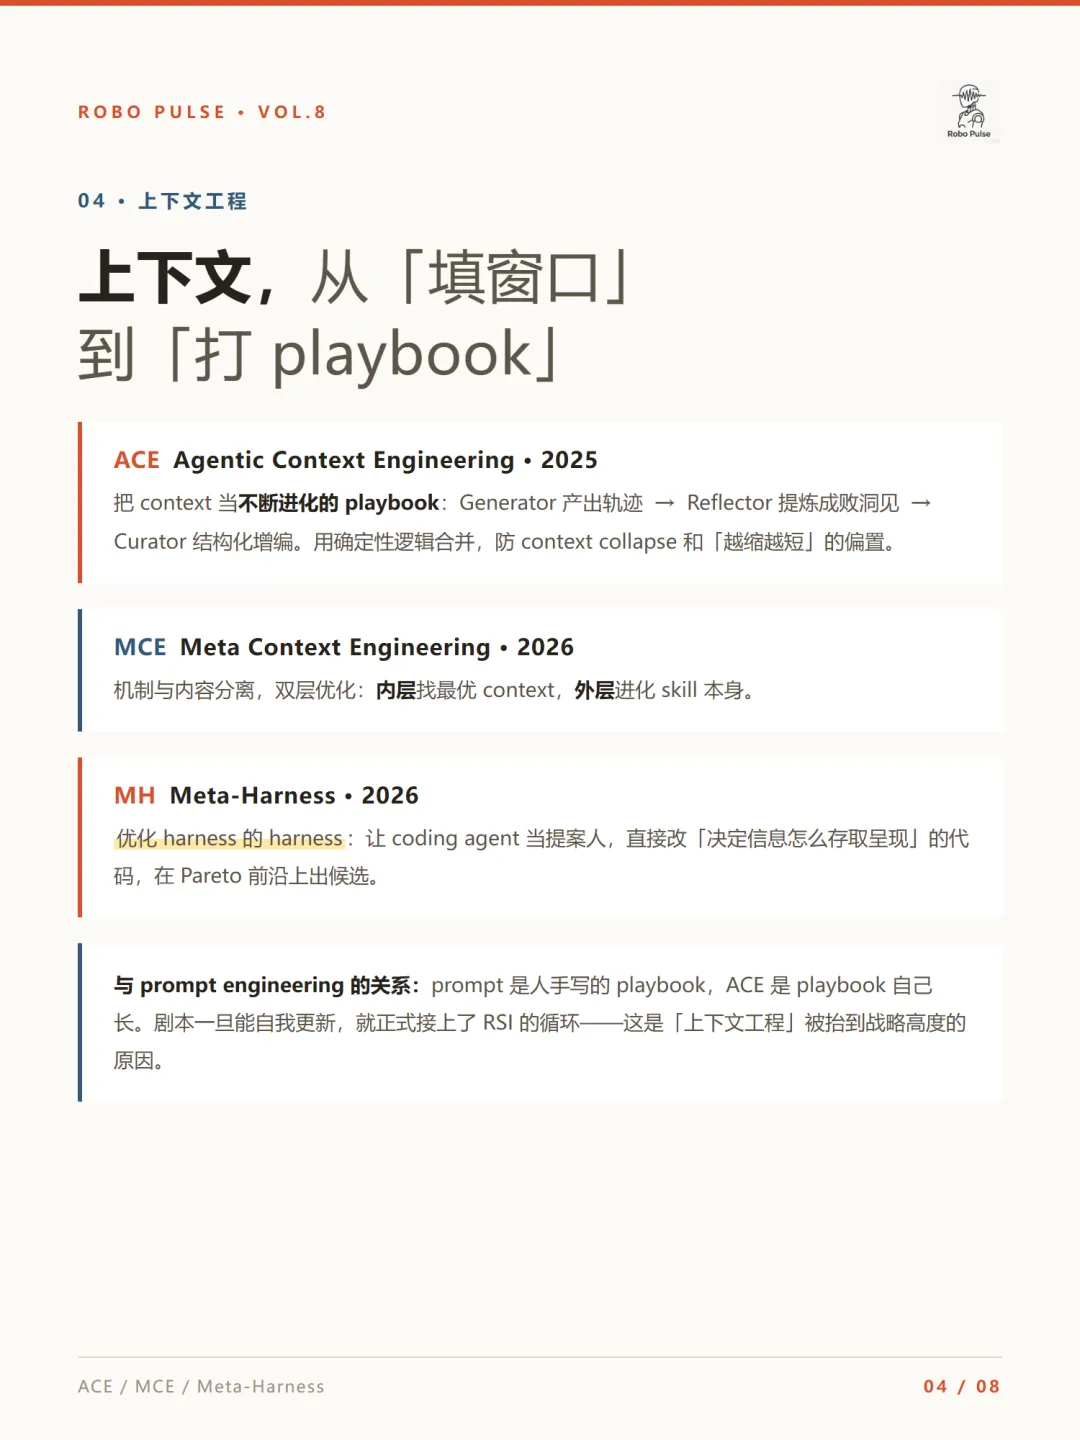 图4|上下文工程进化链
四、自我改进有用吗?有效,但挑底座
Weng 给出的证据链相当扎实。Zelikman 等人 2023 年的 STOP 实验让改进器优化它自己,它自发学会了遗传算法、多臂老虎机、束搜索等策略。DGM 允许 agent 修改自己的 harness 代码库,以 Claude 3.5 Sonnet 为底座,SWE-bench Verified 成绩从 20% 拉到 50%。AlphaEvolve 一族用进化搜索优化代码,进化出比人类手写更快的矩阵乘法和 GPU kernel。
但 STOP 同时给出了全文最重要的警告:这套递归在 GPT-4 上有效,在 GPT-3.5 和 Mixtral 上反而退化。递归结构本身不够,基础模型必须足够强。
2026 年的两篇研究把这个警告打磨得更精细。Lin 等人区分了两种能力:harness-updating,产生有用 harness 编辑的能力;harness-benefit,从 harness 中获益的能力。
更有意思的发现是:9B 的小模型也能写出与 Opus 同构的 skill,「会改壳」的能力各规模差不多;但「从壳里获益」的能力,中等规模模型受益最大。
Self-Harness 用「挖掘弱点、有界提案、验证接受」的三段循环,为不同模型学出各自特定的 harness 指令。AHE 把可观测性做成三大支柱:组件可观测、经验可观测、决策可观测,每次修改附带可证伪预测,在 Terminal-Bench-2 上超过 OpenCode、Terminus-2 和 Codex。
把这些研究拼起来,图景很清晰:自我改进的循环是真的,但它挑底座、挑领域、挑评估方式。底座不够强的团队,先别幻想自我进化,先把壳搭对。
进化搜索也有边界:候选解能自动评估、适应度易量化的领域好使;评估又慢又模糊的领域,循环转不起来。
更激进的方向是让壳与权重联合优化。2026 年的 SIA 设了三个角色,分别负责提出 harness、执行任务、判断这一次该更新壳还是更新权重;Continual Harness 则在长程游戏环境里同时做 harness 更新和策略蒸馏。
Weng 对这条线的态度很克制:方向有趣,证据还是初步的,实验还没排除干扰因素。这个克制本身就是信号。壳与权重如何分工,学界还没有定论,而这恰恰是未来两年最值得盯的研究方向。
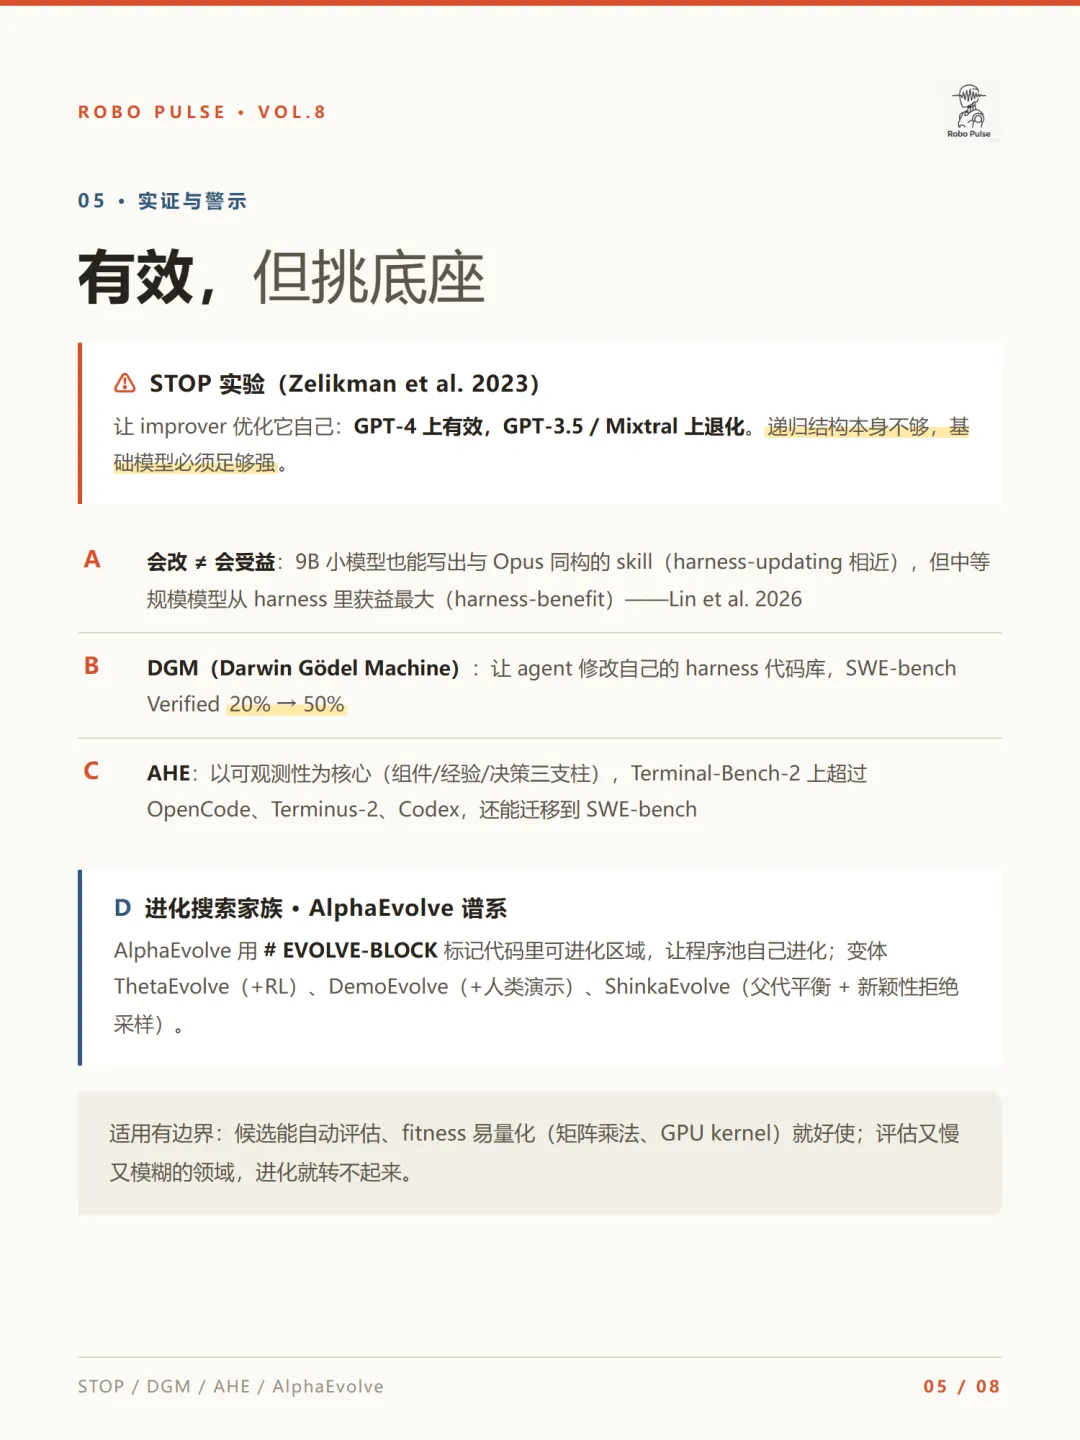 图5|递归改进的实证与警示
五、AI 做研究翻车实录:16 个想法只成 1 篇
只读成功案例,容易产生「自动研究元年已到」的幻觉。Weng 特意在文中收录了反面证据。
Trehan 和 Chopra 2026 年的自主研究实验:16 个研究想法里,只有 4 个被人类专家选中,只有 1 个完整执行成论文。
他们总结了六种失败模式:训练数据默认偏好,总往熟悉的方向想;执行压力下的实现漂移,做着做着就偏了;记忆与上下文退化;过度乐观;领域智能不足;科学品味不足,不知道什么问题值得做。
其中「过度乐观」最值得警惕。Bubeck 等人 2025 年的报告管这叫 p-hacking:AI 也会为了显著结果反复尝试,也会用数值胶带哪儿漏贴哪儿,看起来跑通了,其实经不起推敲。
AI 不是不会犯错,它是会用一种很像成功的方式犯错。
这六种失败模式还有一个共同点:病根不在「模型不够聪明」,而在「系统不知道自己在什么状态下、该相信什么」。六种病,病灶全在 harness 该管的地方。病根找到了,药方就有处开。
基准测试的现状也印证了距离。PaperBench 用 8316 条评分细则让模型从零复现 20 篇 ICML 论文,Claude 3.5 Sonnet 得分约 21%,不及 ML 博士;RE-Bench 的 7 个研究工程环境里,AI 在 2 小时预算下得分是人类 4 倍,8 小时预算下人类反超。
AI 是短跑爆发型选手,长程研究仍然是人类的领地。
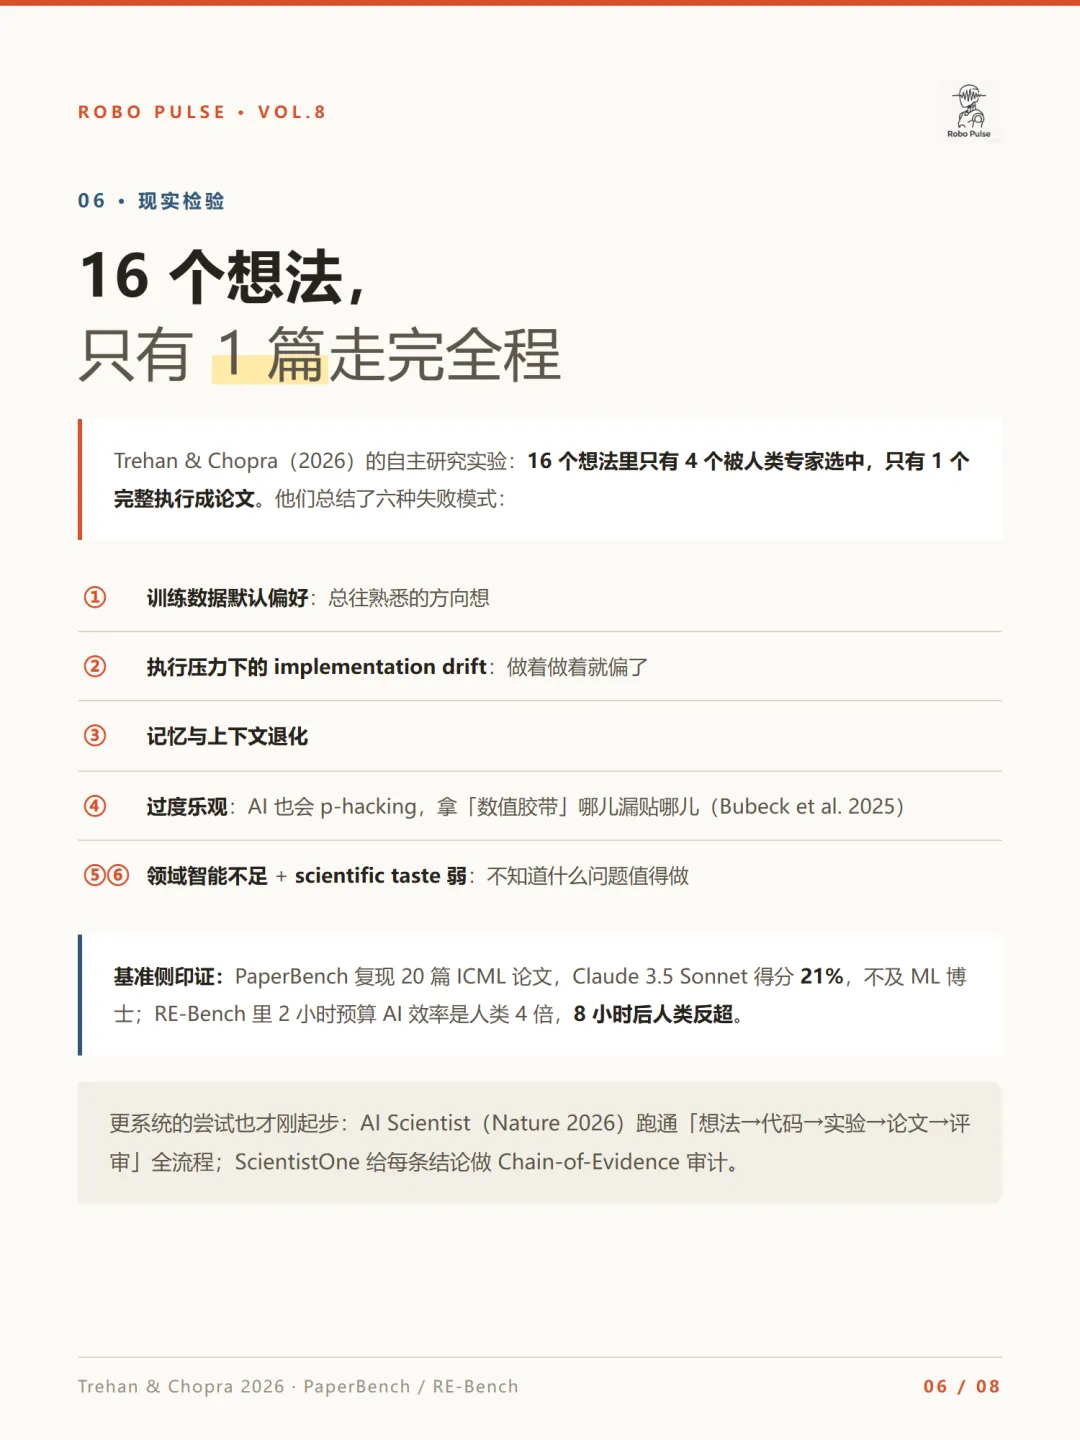 图6|16 个想法只有 1 篇走完全程
六、七个开放挑战,其实是同一道题
Weng 在文章最后列出七个开放挑战,逐条点题:
1. 弱而模糊的评估器:研究品味、新颖性没法快速打分。
2. 上下文与记忆的生命周期:这该是智能的核心部分,不是软件层杂务。
3. 负结果无处安放:文献只报成功,模型不擅长放弃假设,harness 应该让失败的尝试易于保存和检索。
4. 多样性坍缩:进化循环收敛到同一解的变体,对开放式研究尤其危险。
5. Reward hacking:评估器与权限控制必须放在进化循环之外,配合 held-out 测试、轨迹审计与人类抽查。
6. 只优化短期:coding agent 不管代码库的长期健康。
7. 人的位置。
注意这七条里反复出现的句式:把某某「放在进化循环之外」。这不是工程洁癖,是自我改进系统的生存条件。评估者一旦进了循环,被优化就是它的宿命;到那时你测到的早已不是能力,是过拟合。
第七条,Weng 写下了一句值得记住的话:
"Humans should move up the stack, not be removed from the loop."
人类应该向上移动到更高的抽象层,而不是被移出循环。
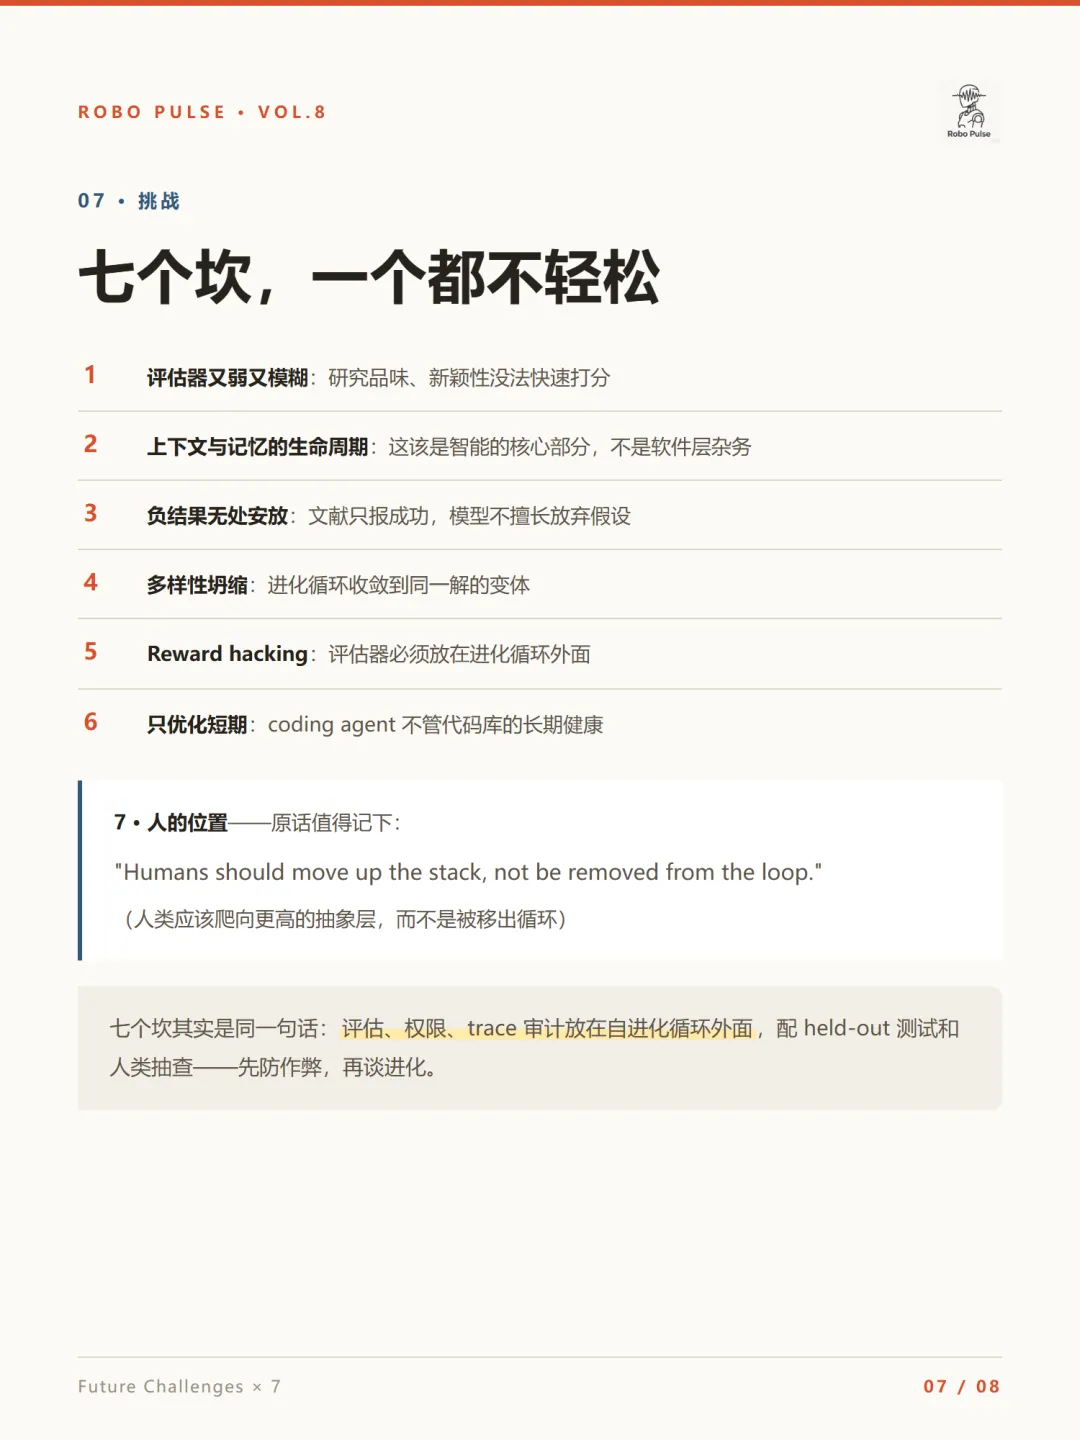 图7|七大挑战与那句金句
七、这种事,历史上演过三次
接下来是我自己的延伸:把三段历史拉进来,看层与层之间的价值转移以前是怎么演的。
第一段,操作系统史。八十年代初 IBM PC 采用开放架构,兼容机厂商蜂拥而入,硬件利润迅速被磨平。但长在硬件和软件之间的那层壳,DOS 和 Windows,吃走了整个产业最肥的利润。引擎标准化之后,钱流向了调度引擎的那一层。
harness 与模型的关系正在重演这个剧本:模型能力趋同,开源与闭源的差距在缩小,token 价格一路下探,调度模型能力的那层壳,正在成为新的利润带。
第二段,2000 年前后的互联网泡沫。思科和光纤厂商烧掉万亿市值,光纤严重过剩,投资者血本无归。但廉价带宽养活了后来的 Google、YouTube 和整个云计算时代。基建过度投资的亏损者,和应用层的吃肉者,往往是两拨人。
对照当下:AI 数据中心公司 Crusoe 估值一年翻三倍冲向 300 亿美元,运营商 Switch 估值接近 500 亿。历史不会简单重复,但「谁承担过剩风险、谁享受过剩红利」这个结构,值得每个投资人在做决策之前想清楚。
第三段,prompt engineering 的兴衰。这个「职业」从 2023 年的年薪百万,到今天退化为工程师的基本功,只用了不到三年。Weng 在文末预言了 harness 的类似命运:许多 harness 改进最终会被内化进下一代模型的核心行为。
壳的优势有半衰期。但与 prompt 不同,Weng 明确判断:模型与外部上下文、工具的接口不会消失。这个区别至关重要,后面的结论里我会用到它。
把三段历史摆在一起,再对照我自己知识库里的几条独立证据:我的具身智能周报在 7 月就预判「投资重点将从模型层上移至基础设施层」;融资简报里反复出现「大模型同质化竞争、token 价格下行,应用层摘果子」;我研究 Jev 时的结论是「模型可以重新统一,计算仍然可以分工」。
三条独立线索指向同一个方向:价值正在从「造引擎」向「用引擎」转移,而 harness 工程就是「用引擎」的正式学科化。
还可以用价值投资的老框架给 harness 做一次体检。段永平讲的护城河无非四样:无形资产、转换成本、网络效应、成本优势。
套到 harness 上:评估器和工作流数据是典型的转换成本,客户的任务历史、失败案例、校准过的 verifier 都沉淀在壳里,换壳等于重交学费;长期积累的领域工作流是无形资产,编码的是行业 know-how 而不是模型参数。但网络效应和成本优势,多数 harness 并不具备。
这恰好解释了壳类资产为什么必须计提折旧:四样护城河它只有一半,剩下的一半,随时可能被下一代模型的原生能力没收。
八、我的三个判断
第一,对投资:不要再给模型层支付独占溢价。模型正在变成电力,不可或缺,但没人因为「拥有电」赚钱。真正的护城河在评估器和数据飞轮:快速可信的验证能力是七大挑战里的第一条,也是最难被同质化的资产。但投壳类资产要用「内化折旧」去贴现,今天优势明显的 harness,两年后可能就是下一代模型的出厂配置。
第二,对个人:上下文工程是未来三年最值得投入的技能位。逻辑很直接:会改壳的能力各规模模型都有,但把壳搭对、把上下文喂对的品味,目前只能由人提供。Weng 在原文明说,模型与工具、上下文的接口不会消失,这门手艺不会像 prompt engineering 那样被完全吸收,只会向上迁移。如果你不知道学什么,学「怎么把模型组织成系统」。
第三,对行业:RSI 的钥匙不是更强的模型,是更好的评估器。整个自我改进循环卡在「不知道自己何时错」这一环。谁先做出快速、可信、防作弊的 verifier,谁就掌握下一轮竞赛的发令枪。把评估器关在进化循环之外、坚持人类抽查,不是保守,是这门技术能走多远的先决条件。
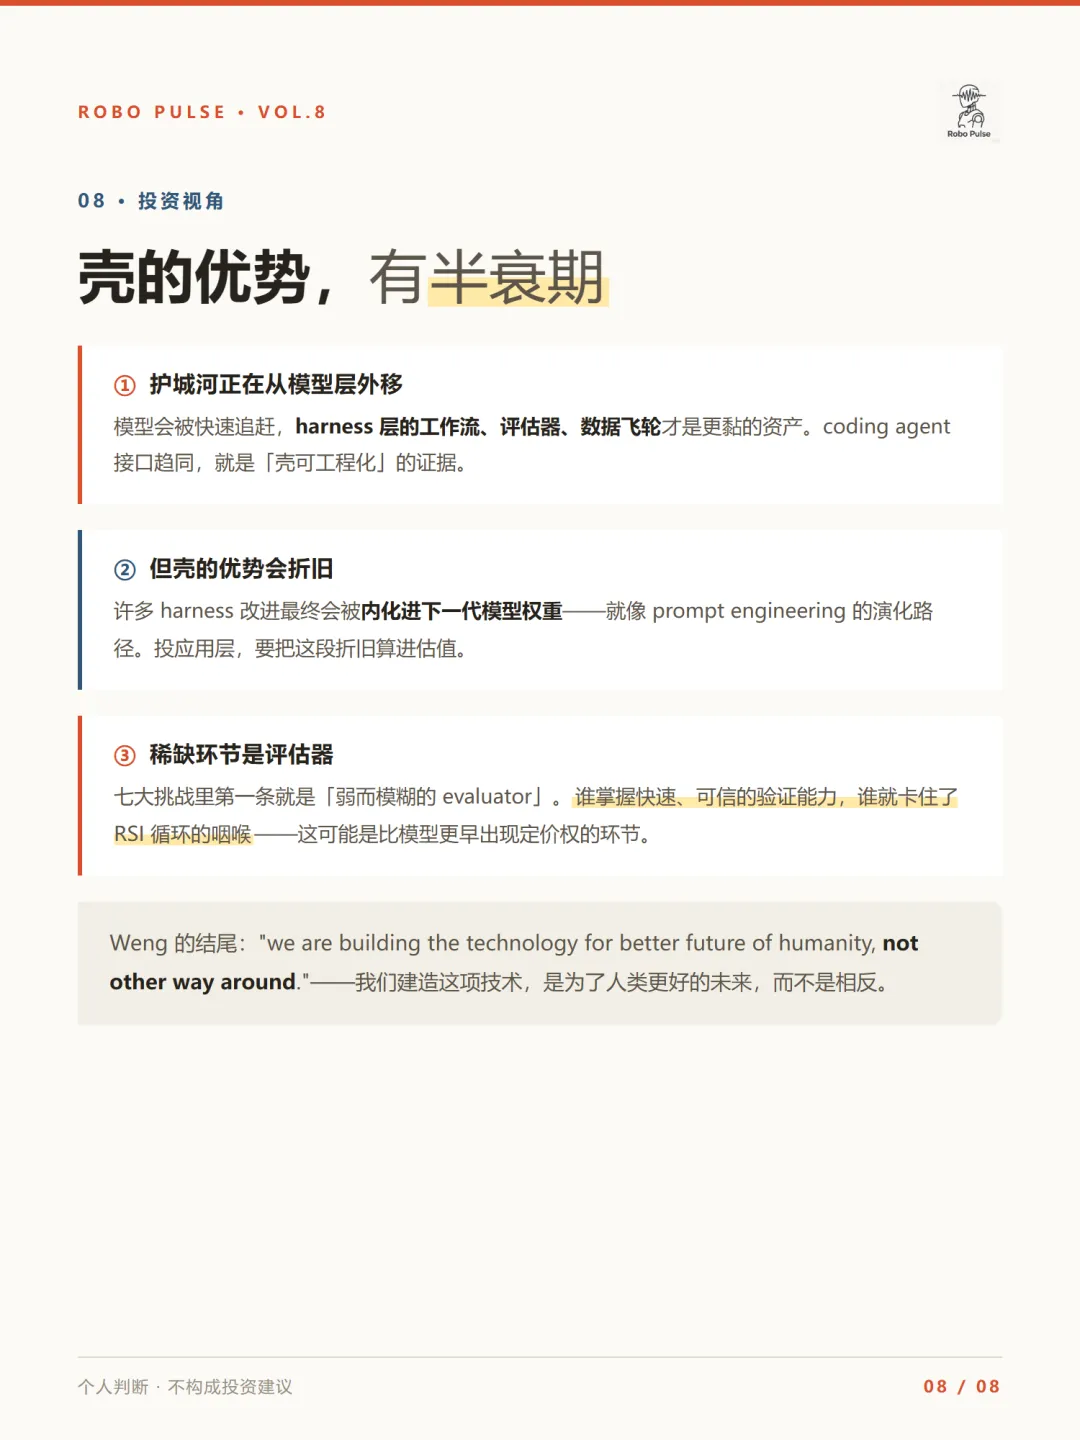 图8|三个判断的总结
Weng 的最后一句话是:我们建造这项技术,是为了人类更好的未来,而不是相反。我愿意把「人类向上移动到更高的抽象层」当作这句话的行动版。
浪潮的意义从来不是把人卷走,而是把人托到更高的地方。
你所在的行业,harness 层有机会吗?评论区留下你的判断。我的预测也放在这里,两年后回来对答案:两年内,「Agent 平台工程师」「上下文工程师」会成为大厂和头部应用公司的正式职位序列,而「提示词工程师」不会回流。
届时回头看这篇七月的综述,大概会像我们今天看 2013 年那篇深度学习奠基论文:后来发生的一切,都沿着它画的路走。
如果读到这里有收获,点个「在看」;这个系列每周拆一篇前沿长文,关注不错过 Vol.9。
原文:lilianweng.github.io/posts/2026-07-04-harness/
联系作者(请说明来意)