ARTICLE · 1232612
AI手搓1.2万行代码榨干GB300!Kimi K3飙至842字/秒,PyTorch大神却当场拆台
2026年10月18日深夜,硅谷AI基础设施圈被一张截图炸醒了。
知名半导体分析机构SemiAnalysis抛出一条重磅快讯:一滴硬件都不用换,仅仅靠一段由编程Agent辅助写出的12,000行“Megakernel(超级内核)”代码,月之暗面(Moonshot AI)开源的2.8万亿参数巨兽Kimi K3,在英伟达最新的GB300芯片上推理速度瞬间暴涨。
但怪事很快就发生了
如果你仔细核对各方晒出的成绩单,会发现一连串对不上的数字:SemiAnalysis在正文里高呼单用户速度达到423 tok/s、提速1.68倍;可它配图里引用的英伟达官方战报,却赫然印着842 tokens/s、提速1.73倍。
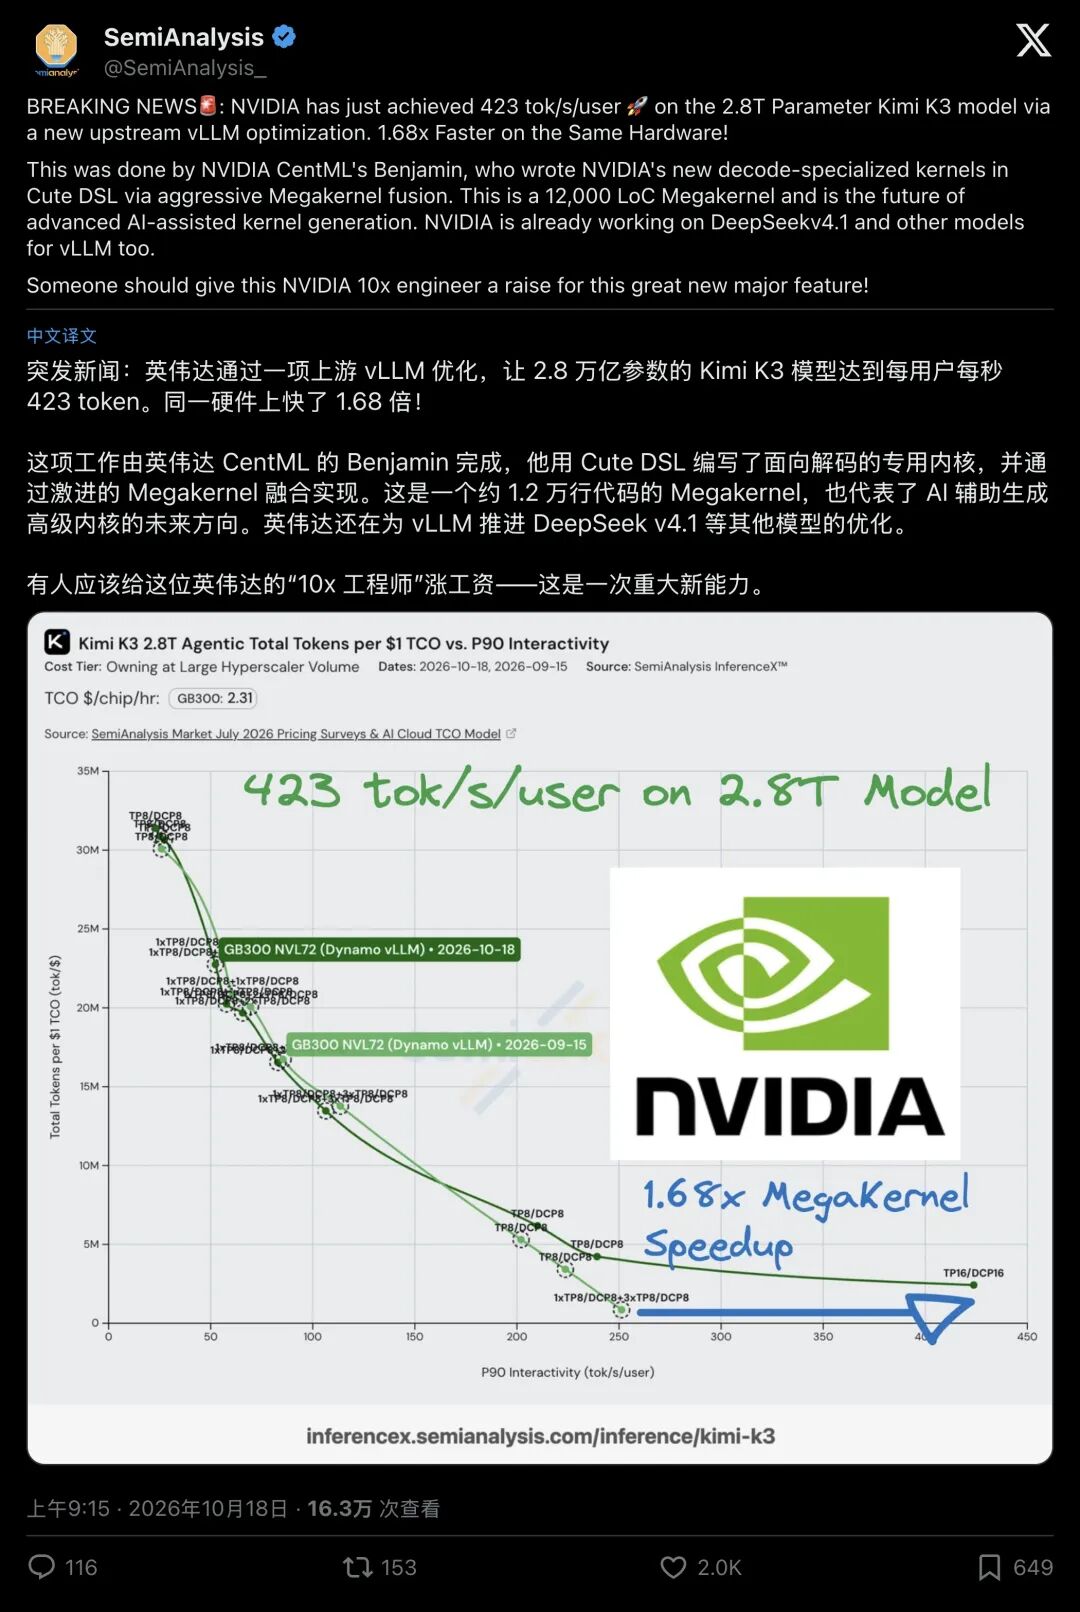
▲ SemiAnalysis发布的快讯:正文写着423 tok/s,配图里的英伟达官方数据却是842 tokens/s
更火药味十足的一幕出现在评论区
就在全网为这个“1.2万行超级内核”狂欢时,PyTorch核心维护者、GPU MODE联合创始人Mark Saroufim直接冷水泼面,公开拆台:
“为什么现在每发布一个新内核都要叫Megakernel?哪怕去看看源码呢?作者本人可从来没这么叫过!”
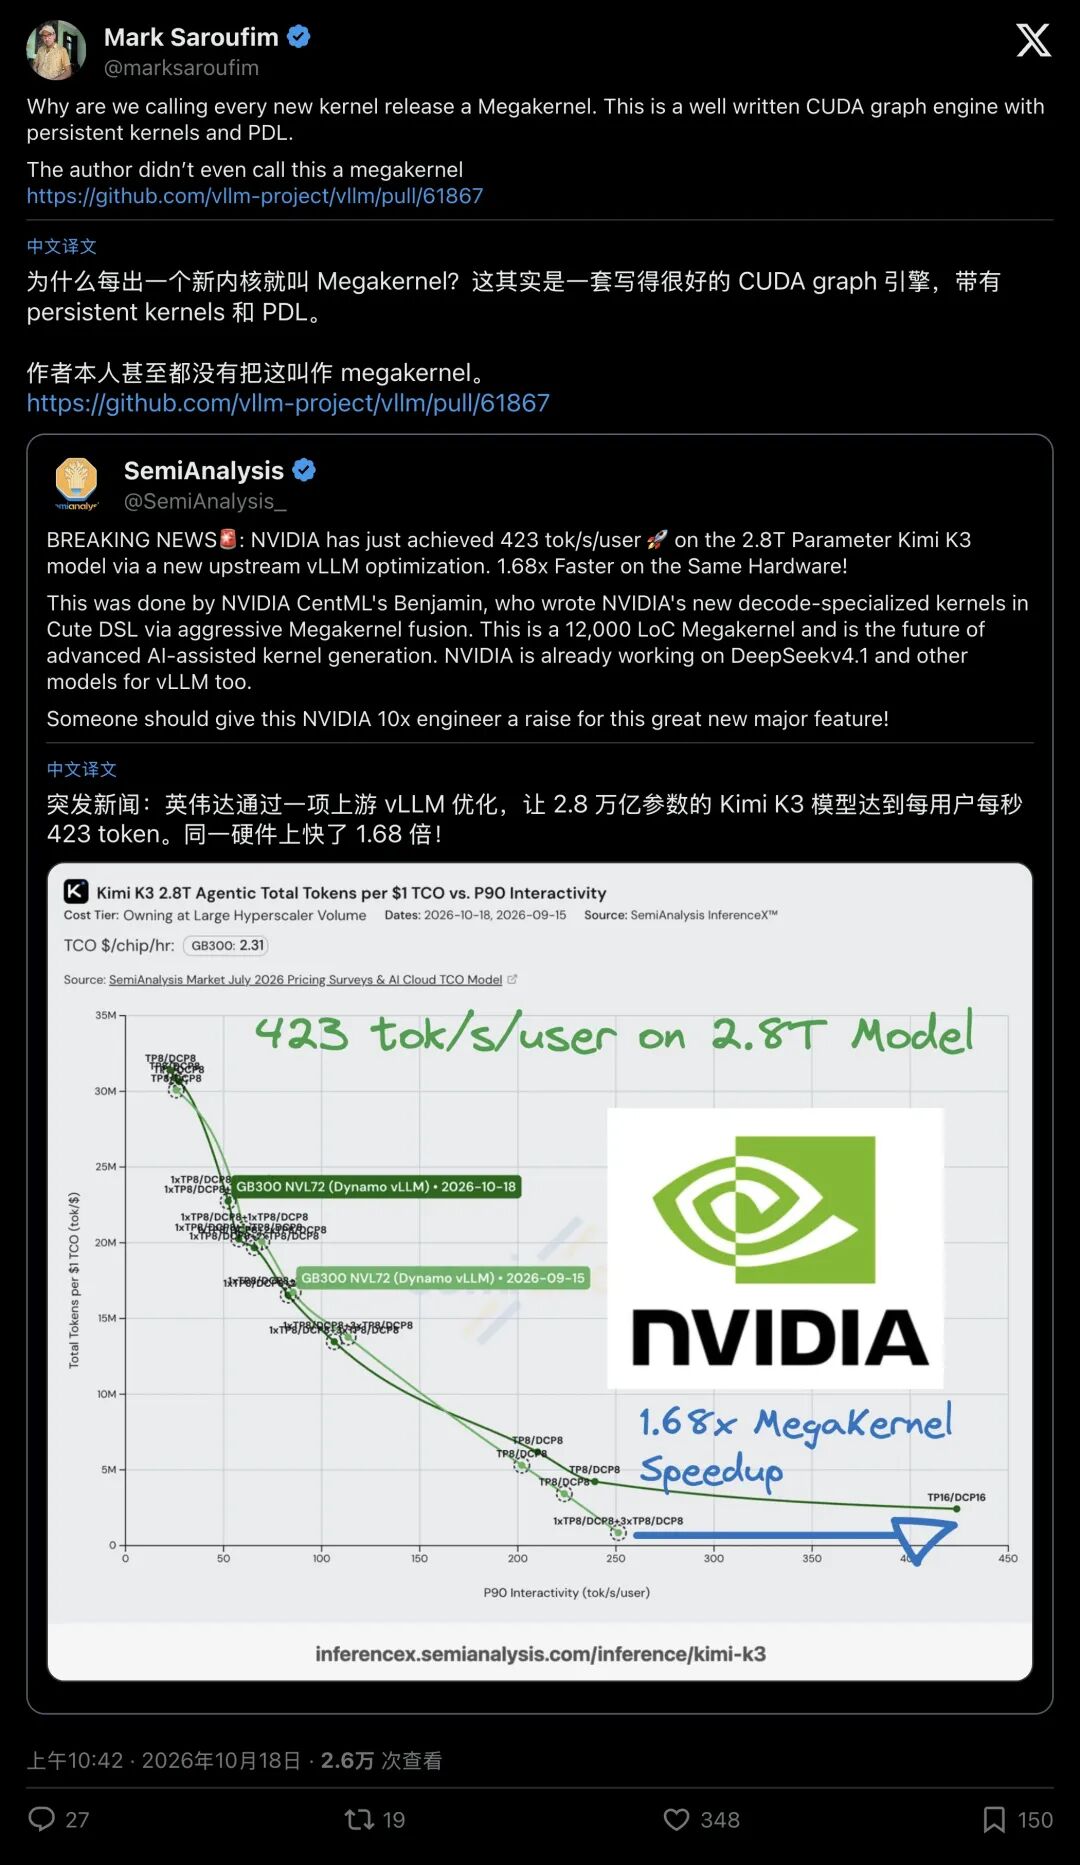
▲ PyTorch核心维护者Mark Saroufim直接下场辟谣“Megakernel”叫法
一边是近乎翻倍的性能狂飙,一边是对不上的口径与顶级专家的当场打假。
在那1.2万行由AI深度参与构建的底层代码里,究竟藏着什么秘密?我们顺着开源推理引擎vLLM刚刚合入的61867号代码提交(PR #61867),把这起轰动硅谷的“极速悬案”扒了个底朝天。
01第一现场:两套失踪的数字,与被饿死的顶级显卡
先破第一个谜团:为什么半天之内,蹦出了842、423和403.2三套完全不同的速度指标?
答案藏在测试台账的细则里,根源来自统计口径的差异。
英伟达与vLLM官方主推的842 tokens/s,是一场极限风洞测试:动用16张GB300显卡(TP16),在只服务1个请求(Batch 1)的条件下,开启了名为DSpark的投机解码技术,也就是让一个小巧的草稿模型先往前狂猜7个词,大参数主模型一次性验货,假设每次固定猜中6个词(合成接受长度AL=6)。在这个受控条件下,整组显卡的解码吞吐从原版vLLM的488飙到了842 tokens/s,暴涨1.73倍。
那如果关掉“猜词外挂”,纯靠硬实力硬刚呢?
官方交出的底牌同样惊人:在16卡、Batch 1的纯解码状态下,每生成一个词的耗时从7.38毫秒直接砍到3.90毫秒,吞吐量从约136跃升至256.4 tokens/s,实打实快了1.88倍。即便是把并发拉高到Batch 64,整体加速依然稳稳维持在1.31倍到1.92倍之间。
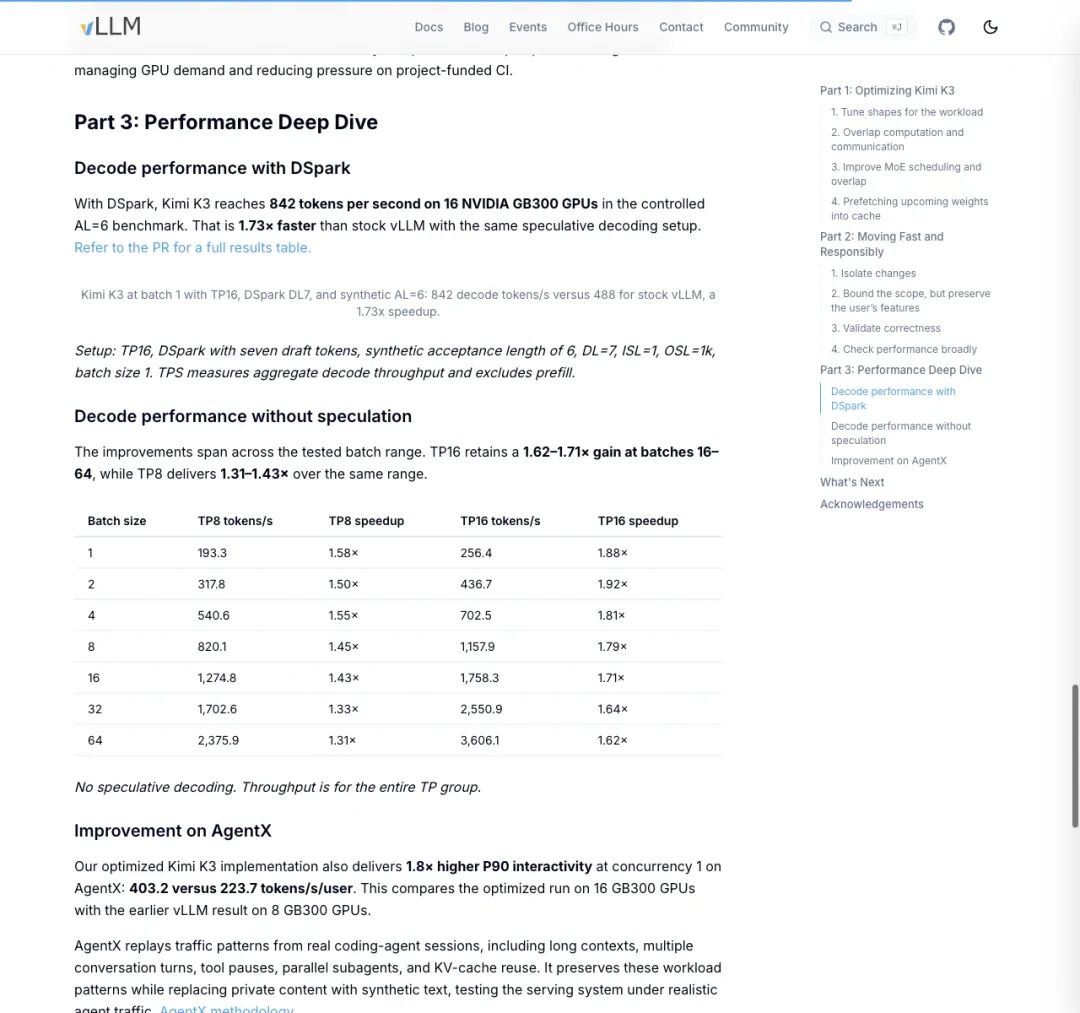
▲ vLLM官方博客披露的842 vs 488极限测试,以及不带投机解码的真实吞吐大表
至于SemiAnalysis口中的423 tok/s/user,则是把视角切到了“单个用户体感速度”的二手转述口径;而官方博客里提到的另一个真实编码测试AgentX(P90交互速度从223.7涨到403.2 tok/s/user,提升1.8倍),报告里其实老老实实标注了一行小字:这次拿16卡的新方案,对比的是此前8卡的老基线。
拨开数字迷雾,一个更反常的物理问题浮出水面:
Kimi K3早在今年7月就已经拿到了vLLM的Day-0首发支持,9月份刚做过一轮吞吐翻倍的大优化。为什么到了10月中旬,面对同一块造价高昂的GB300硅片,工程师还能像拧湿毛巾一样,再凭空拧出近一倍的性能?
因为在此之前,这些顶级显卡在“吐字”时,有将近一半的时间在发呆。
大模型干活分两步:第一步叫预填充(Prefill),一口气读完你输入的几万字文档,这时候显卡算力全开;第二步叫解码(Decode),像打字机一样一个词一个词往外蹦。
Kimi K3是个什么体量的怪物?总参数高达2.8万亿,采用Stable LatentMoE(混合专家架构),每次吐一个词只激活其中约1040亿参数,还混搭了自研的Kimi线性注意力(KDA)和百万级超长上下文。
在低并发解码阶段,显卡算力根本不是瓶颈,内存搬运与启动开销才是要命的枷锁。
这就好比你请了16位米其林三星主厨(GB300的顶级计算核心),切菜速度天下第一。但在解码阶段,客人的点单是一个豆子一个豆子送进来的。为了切这颗豆子,帮厨必须从地下冷库(HBM高带宽显存)跑一趟把菜刀和配料搬上来,切完一刀放回冷库,再签23张交接单(启动23个零碎的GPU内核)。
主厨根本没累着,全在等跑腿和签单!
02拆穿“超级内核”假象:为什么大一统是个死胡同?
怎么把主厨从无休止的等待中解救出来?
外界疯传的剧本是:英伟达工程师Benjamin Chislett用AI写了一个1.2万行的“单体Megakernel(超级内核)”,把所有步骤吞进了一个巨型黑盒。
这正是Mark Saroufim公开提出质疑的原因。
在严格的计算机体系结构里,真正的单体Megakernel,意味着把整个神经网络的所有计算硬塞进唯一一个GPU内核里,一次启动跑完全程。听起来很性感对不对?但在真实的工业界,把Kimi K3塞进单体Megakernel,几乎等于自杀:
- “案板”直接爆仓(寄存器溢出)
:GPU核心里速度最快的私人案板叫寄存器(Registers),空间极小。注意力计算、矩阵乘法、通信同步所需的案板大小天差地别。如果强行合成一个巨无霸内核,系统只能按最占地方的那个算子来分配空间,结果就是案板瞬间爆满,大量数据被迫溢回慢速内存,并发度直接暴跌。 - 动态路由撞上死胡同
:Kimi K3是稀疏混合专家模型,每个词都要从几百个专家里动态挑出十几个来激活。如果锁死在单个大内核里,不同线程走的分支完全不同,会导致严重的指令排队串行。 - 一旦出错,神仙难救
:几万行汇编级逻辑搅在一锅粥里,只要算错一个小数点,连查错工具都不知道从哪下刀。
翻开PR #61867的源码和vLLM官方技术博客,真相水落石出。作者Benjamin Chislett从头到尾都没用过“Megakernel”这个叫法,官方正式命名为“Unified CuTe DSL Decode Path(统一CuTe DSL专用解码路径)”。
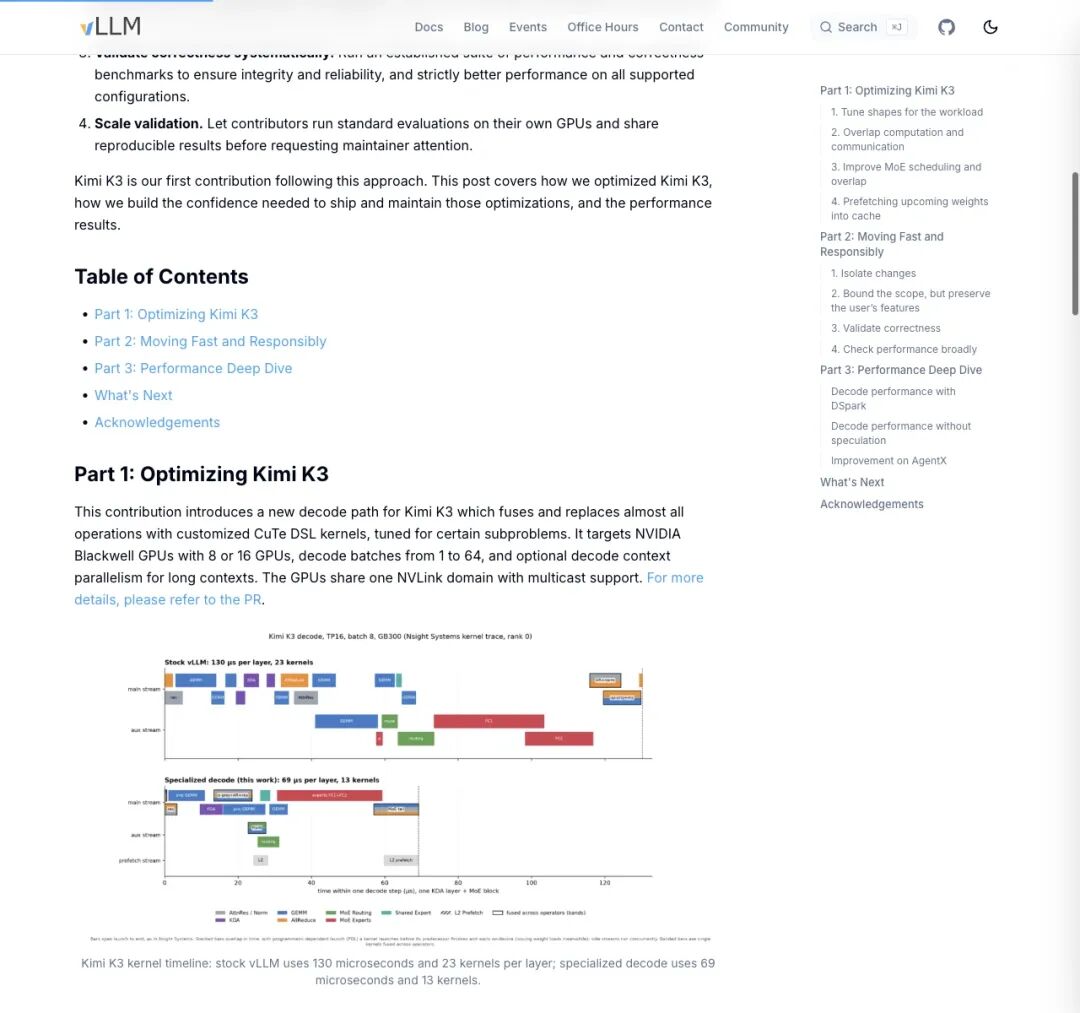
▲ 破案铁证:新路径并非“只剩1个内核”,而是将单层23个零散内核精炼融合为13个高密度内核,耗时从130微秒腰斩至69微秒
看懂上面这张官方时间线截图,你就看懂了现代GPU工程的最高手艺。
在原版vLLM里,跑完Kimi K3的一层网络,需要启动23个零散内核,耗时约130微秒,中间布满了细碎的空隙;而在新路径下,团队用英伟达底层的CuTe DSL语言重写了算子,但并没有盲目追求“大一统”,而是收敛成了13个边界清晰的融合内核,耗时直接腰斩到69微秒!
这套优化涵盖四个关键工程突破:
- 消灭中间落盘,边算边传。
以前算完注意力投影,要先写回显存,再启动跨卡通信(All-Reduce)。现在,计算内核直接把半成品写进NVLink跨卡共享缓冲区,隔壁显卡当场接力加上残差,中间结果根本不落地。 - 化整为零的专家调度。
原本每张卡都要重复算一遍专家路由分数,现在拆给16张卡分头算完再通过NVLink秒级交换;与此同时,固定干活的“共享专家”被安排在独立的旁路通道(Stream)上并行狂奔,把等待时间彻底重叠掉。 - 趁通信间隙预取权重。
当显卡忙着跨卡对账通信、显存带宽闲置的那几微秒,另一条旁路通道已经在后台悄悄把下一步要用的模型权重提前搬进高速缓存(Cache)里了。 - CUDA Graph图固化与持久化调度。
13个内核通过CUDA Graph整合成一张固定的执行图,配合持久化内核(Persistent Kernels)与硬件级依赖启动(PDL),前一个内核刚收尾,硬件直接踹开下一个内核的大门,完全绕开了CPU的慢速指挥。
整套架构立足于吃透硬件物理特性,如同精密运转的机械结构。
03AI写代码的惊魂一刻:被编译器“聪明反被聪明误”
如果说这套架构代表了系统工程师的顶级设计,那么协助写下上万行底层代码的幕后核心,则是Coding Agent(编程智能体)。
写过底层CUDA的人都知道,CuTe DSL这种精细控制张量内存布局和硬件流水线的代码,写起来极其反人类。过去一个顶尖小队磨一套模型专属内核,动辄要几个月;现在,在编程Agent的轰炸式辅助下,几天就能拉出上万行高度融合的定制代码。
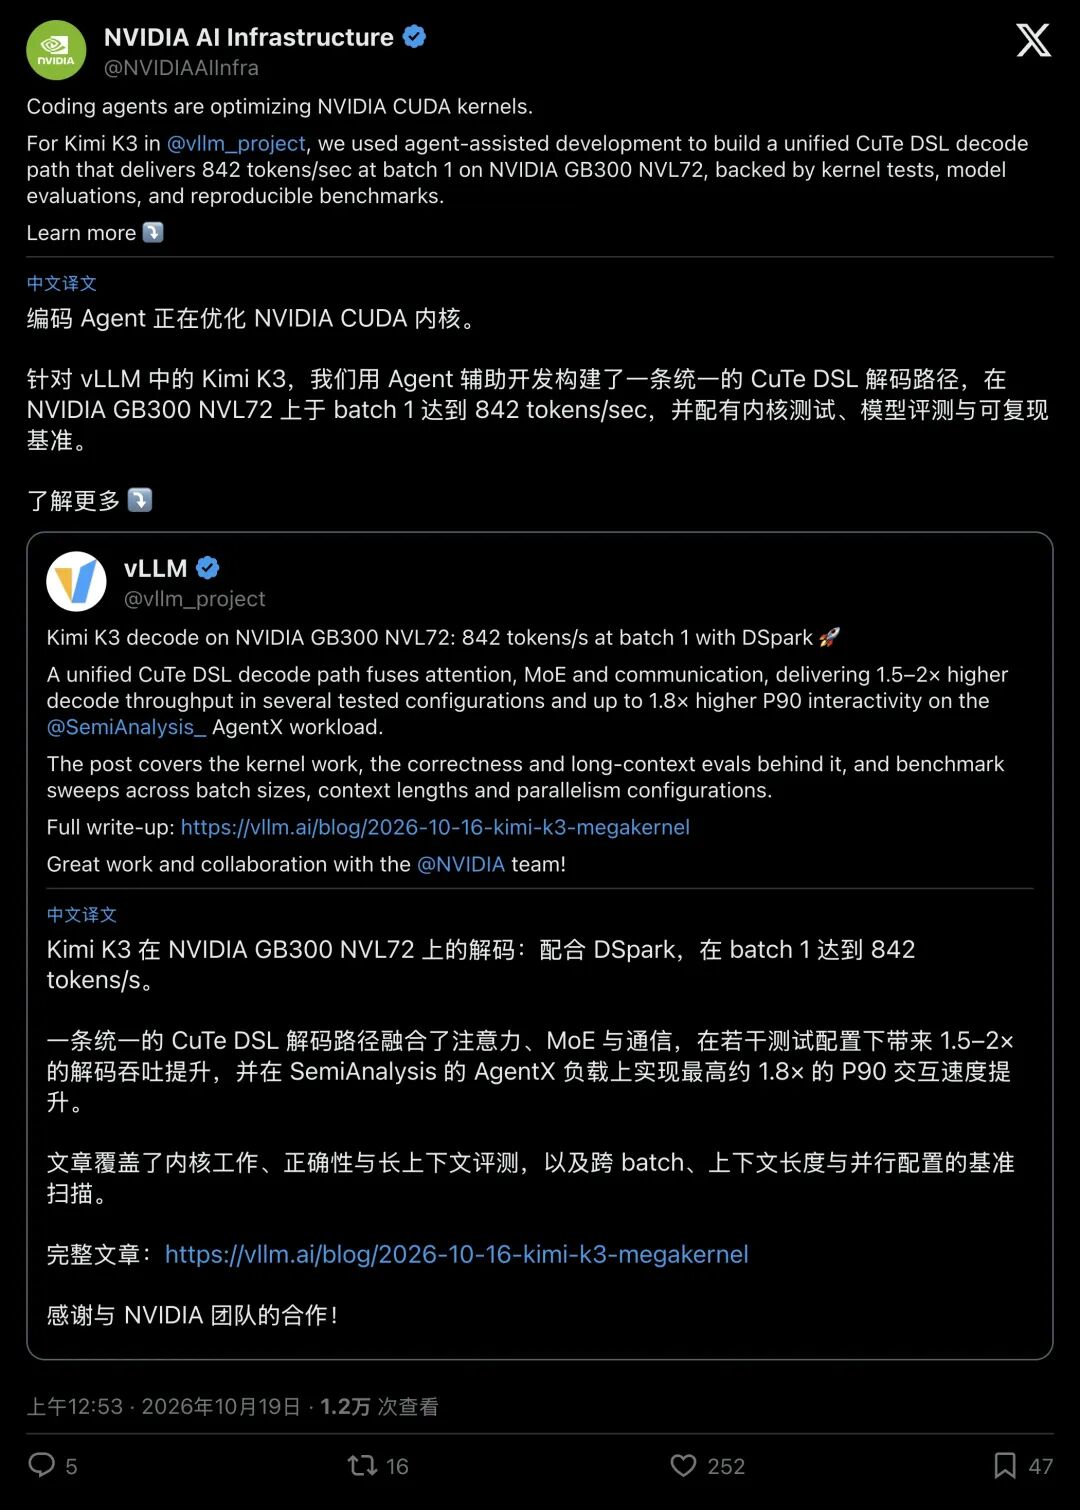
▲ 英伟达AI基础设施官方账号直言:编程Agent正在接手优化复杂的CUDA底层内核
但AI写代码有多快,埋雷就有多深
Benjamin在博客里坦白了一个让人惊出一身冷汗的细节:为了榨干每一微秒,代码里大量使用了跨卡异步同步与预取技巧。结果在测试中,底层编译器在优化这段激进代码时“自作聪明”,竟然把读取激活值的指令,偷偷挪到了“等待跨卡数据同步完成”的屏障指令之前!
如此一来,前方的显卡还没把算好的数字传过来,这边的显卡就已经冲进去把旧内存里的脏数据读走并往下算了!
这种毫厘之间的时序错乱极为隐蔽,普通的单元测试根本抓不住。模型依然能流畅吐字,不会报错崩溃,只是在面对百万字超长上下文大海捞针(MRCR)或者高难度数学竞赛题(AIME25)时,准确率会莫名其妙地“暗中掉线”。
直到工程团队拉起了一套严苛的真机评测铁丝网,强制对比原版与优化版在GSM8k、GPQA-Diamond、AIME25和长文本MRCR上的完整得分,确保误差严格锁死在1个标准误以内,才把这个幽灵般的编译器陷阱彻底揪了出来,强行给预取指令戴上紧箍咒:只准提前偷运静态权重,绝不准提前碰动态激活值。
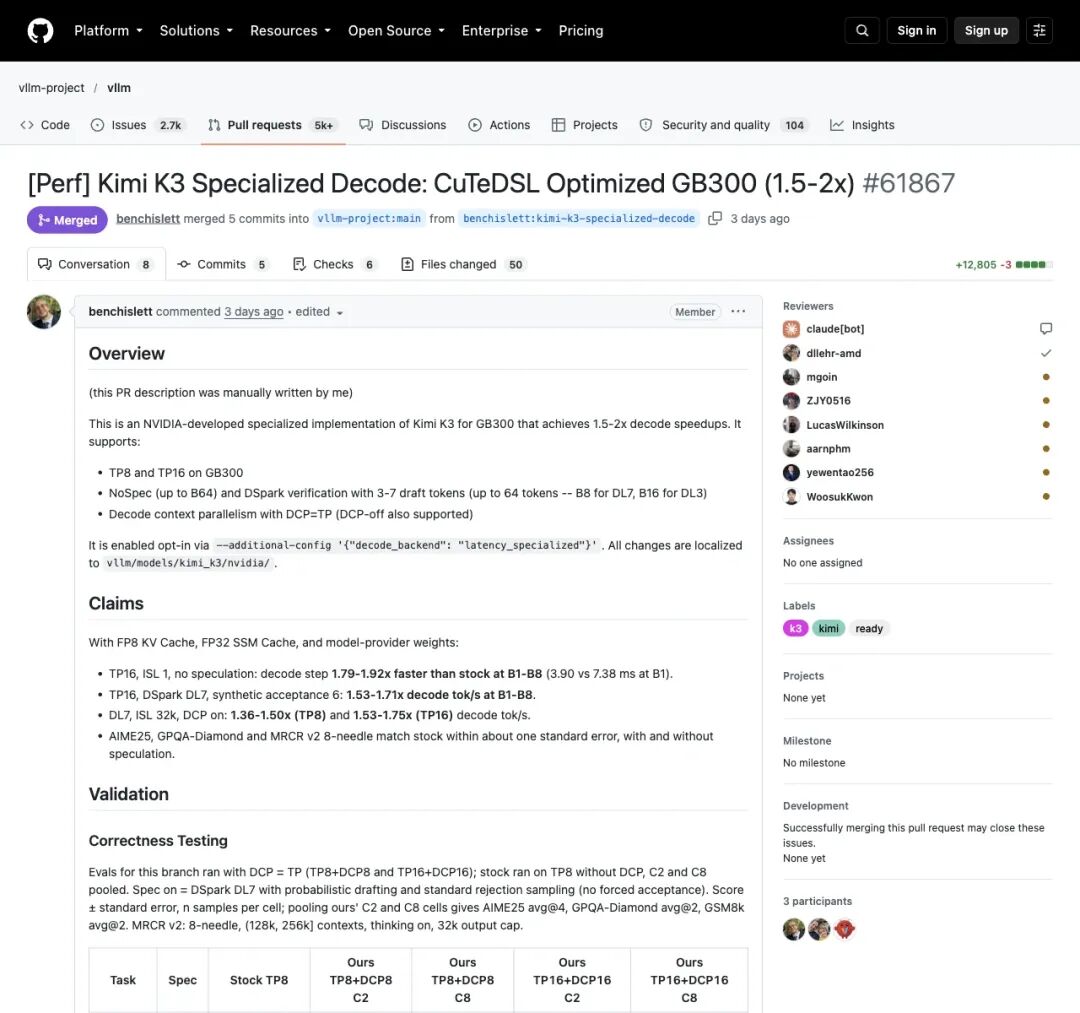
▲ GitHub PR #61867页面:所有激进优化被严格关进独立目录,需通过latency_specialized开关手动激活
这也逼出了vLLM社区一套全新的生存法则:“负责任地开快车(Moving Fast and Responsibly)”。
面对AI潮水般涌来的底层优化代码,开源维护者如果逐行人工审查,根本看不过来;如果盲目合入主干,线上生产环境分分钟炸穿。于是,vLLM设立了“模型专用快车道”:
- 物理隔离
:这1.2万行代码全部关在 vllm/models/kimi_k3/nvidia/独立目录里,绝不污染公共主干; - 手动开启(Opt-in)
:默认不生效,只有当你手握GB300、开启 --additional-config '{"decode_backend": "latency_specialized"}'时才会激活;一旦并发超过Batch 64的边界,系统自动平滑退回稳妥的通用路径。
04尾声:算力霸权的下半场,规则变了
这场围绕Kimi K3与1.2万行代码的风暴,远没有在61867号PR合入的那一刻结束。
就在博客末尾,英伟达团队顺手剧透了接下来的动作:同一套“Agent辅助生成+专用快车道隔离”的打法,已经火速复制到了DeepSeek-V4.1-Flash和GLM上;而针对刚刚开源的Muse Spark Open,他们在短短两天内就跑出了单用户超950 tokens/s的早期怪兽级数据。
正如开发者kache(@yacineMTB)在转发这场论战时写下的那句高赞感叹:
“我不确定这算不算Megakernel,但递归自我改进(RSI)正在多个角落同时发生。它的配方已经齐了:极其聪明的人类,加上帮他们干出逆天壮举的智能工具。”
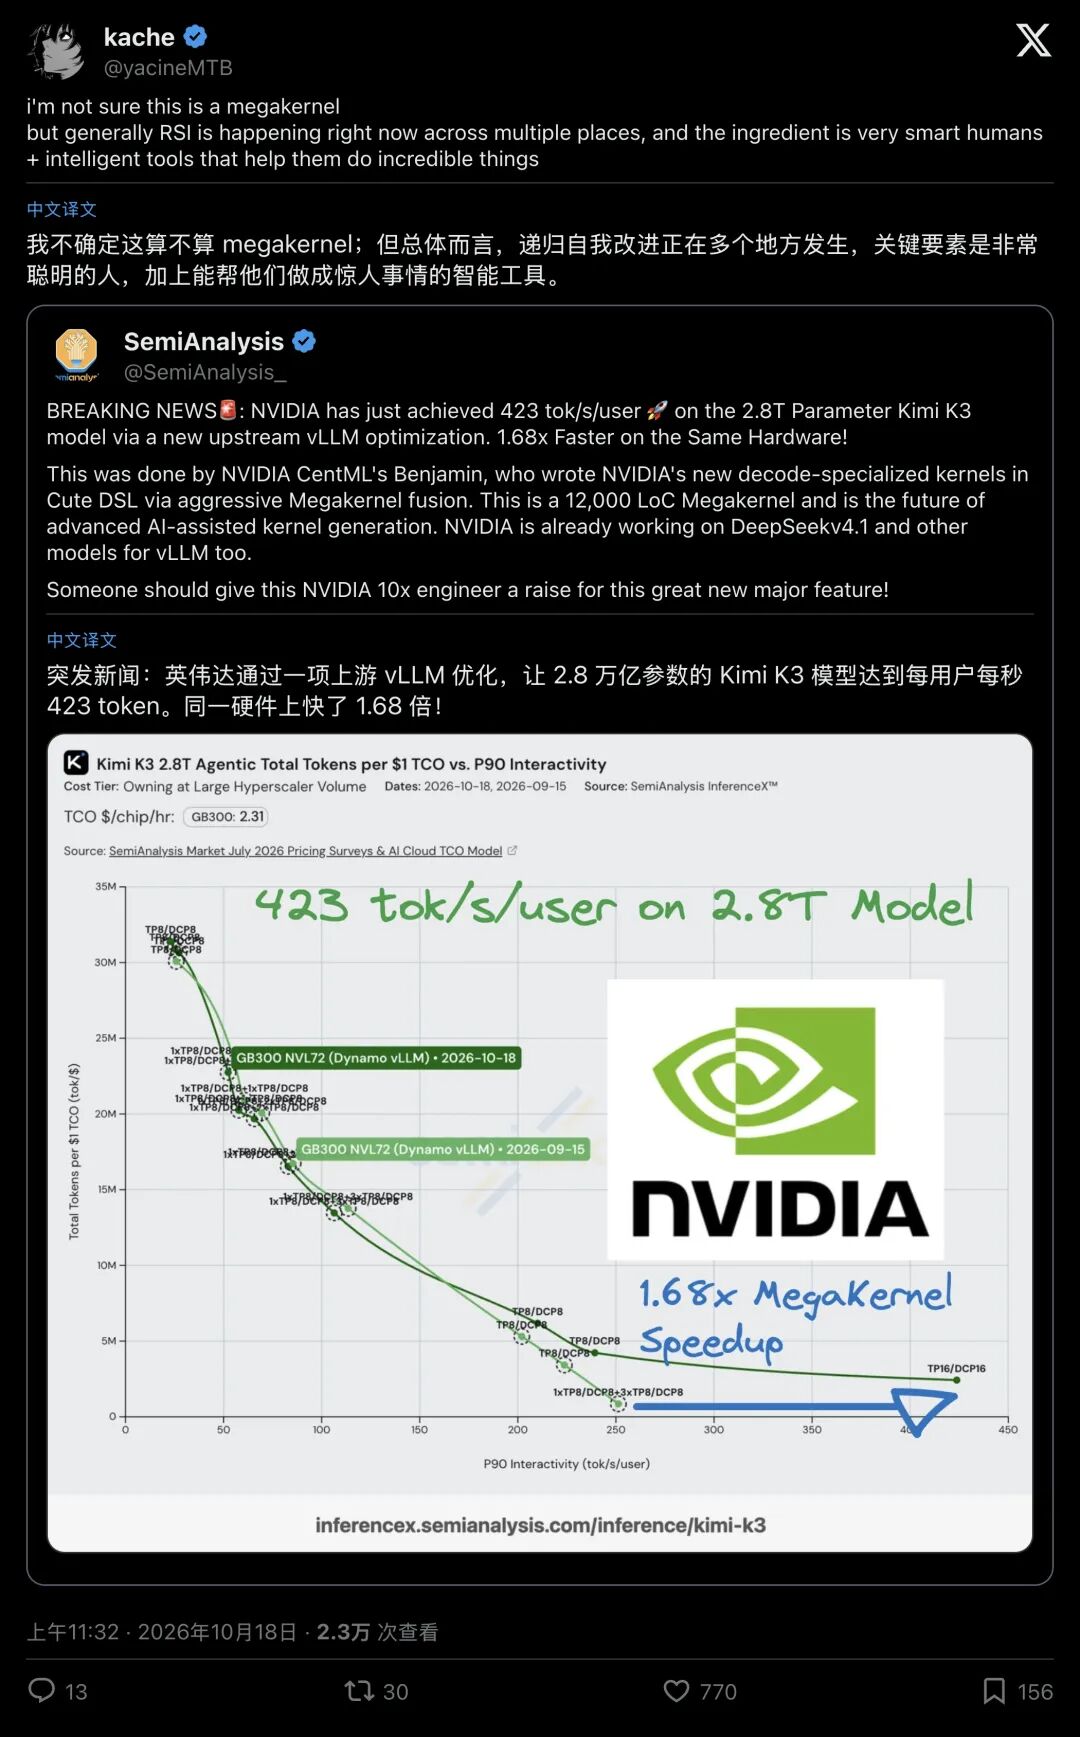
▲ 高赞评论点破本质:顶尖人类工程师+编程Agent,正在触发系统软件的自我加速迭代
过去三年,大模型圈崇拜的是“大力出奇迹”,谁能买到更多显卡,谁就是王。
但2026年10月的这个周末,Kimi K3在GB300上的这记惊天跨越撕开了下半场的残酷真相:哪怕买着一模一样的顶级显卡,懂不懂用AI重构底层软件栈,跑出来的吞吐量和单Token成本,已经可以拉开整整一倍的生死鸿沟。
硬件里的汁水还远没被榨干,而拿着榨汁机的手,已经变成了AI自己。