ARTICLE · 1247815
越南语OCR多了个小模型:有权重和源码,运行效果待核
约43MB的越南语识别权重,部署链还得核对
越南语里,一个声调或附加符号识别错了,词义就可能跟着变化。针对这类文字识别,开发者asterxlabs在北京时间10月24日晚上传了AsterNet v1.0模型权重与技术说明。
作者称模型约有1,065万参数,采用非自回归的文字序列识别结构。公开的asternet_best.pth文件为42,761,405字节,约43MB,配有配置与字符表,面向越南语排印文字、行政材料和票据等场景。
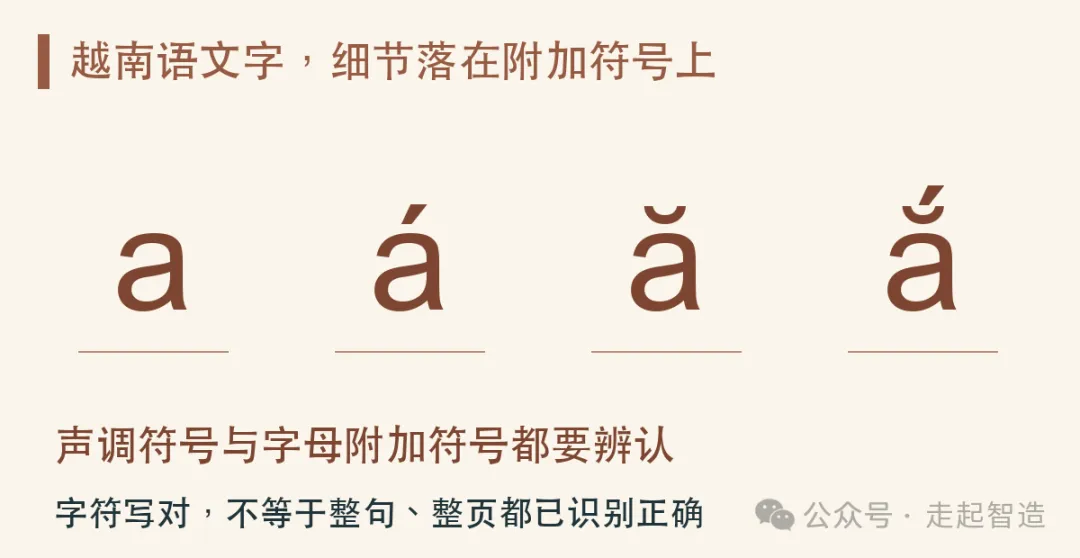
排印字形举例,用来说明需要辨认的细节,不是OCR输出或识别测试。
文字行识别,和整页文档OCR不同
模型卡给出CPU环境的识别速度与准确率对照,其中硬件速度测试使用100条代表性文本行。作者报告字符错误率3.45%、整句完全正确率86%。这些数字来自发布方,不能外推成各种扫描件、手机照片或复杂版面都具备相同表现。
尤其需要分清,文字行识别和完整文档OCR不是一回事。把整页切成文本行、恢复阅读顺序和表格结构,还需要其他处理,不能凭一个权重文件就推断它已经包办了所有环节。
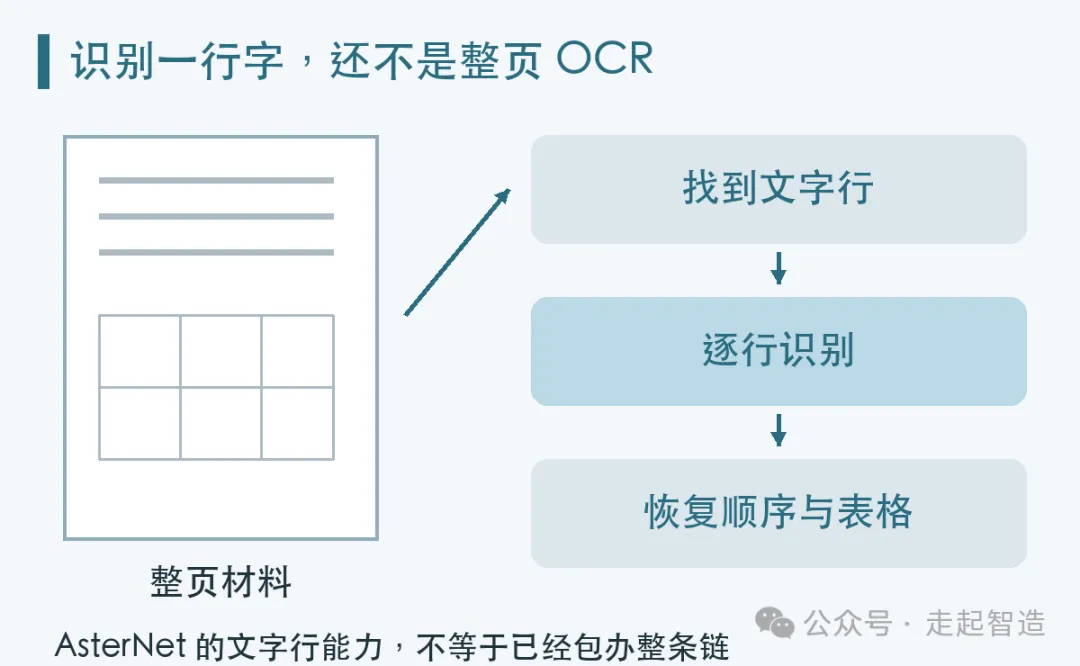
这是理解整页OCR的环节划分,不代表AsterNet已验证完成全部任务。
权重和源码分在两处,演示仍在暂停
部署材料要分两个入口看。模型仓库保留了权重、配置和字符表,提交记录显示相关模型与推理源码曾被移除;但作者另有一个演示Space。本次补核时,Space里确实可读到模型定义、推理实现及应用源码,也列有权重文件。目前该演示的状态为PAUSED。源码可查,和已经验证能加载、识别或稳定部署,仍是两回事;本次只做了静态核对,没有运行模型。
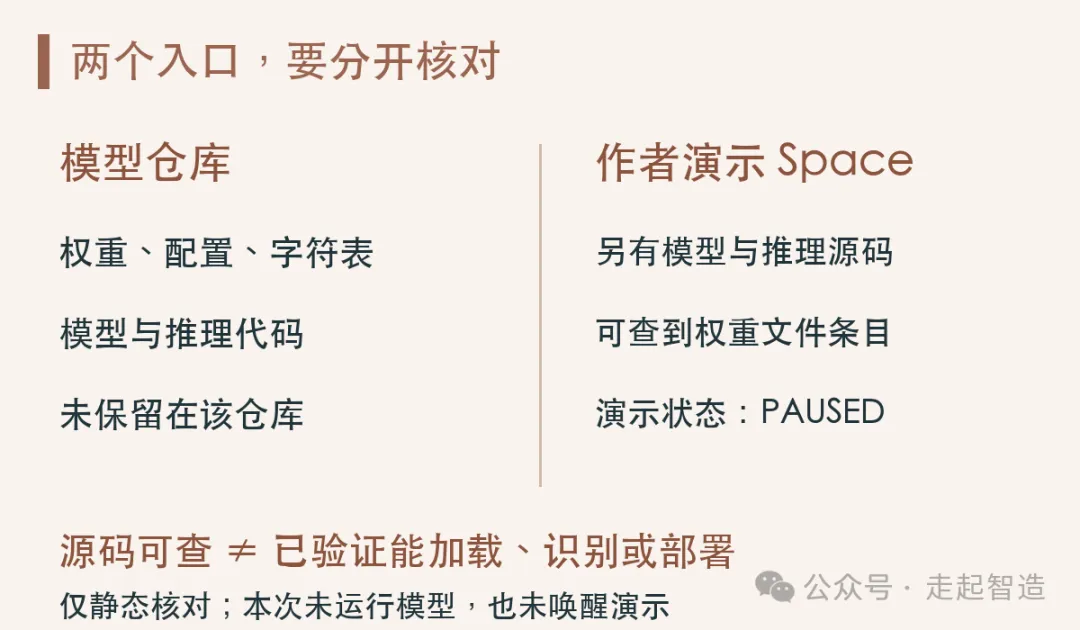
10月25日10:15—10:16静态补核:Space有实际源码,状态PAUSED;未运行模型。
作者在模型卡中声明MIT许可;权重实际可见,不代表训练数据权利、效果和完整部署链都已通过独立核验。对准备做越南语文档识别的人,这个方向可以关注,正式选型还得先核验现有推理实现能否复现,再用自己的文档做测试。
资料来源
asterxlabs|AsterNet模型卡与发布方测试
AsterNet|当前文件与提交历史
作者演示Space|源码、文件与暂停状态