ARTICLE · 1249590
112MB 让本地 AI 开口说话:Ollama 上新 Phonon,我实测了一把
我的 Ollama 终于会说话了。过去一年多,Ollama 一直是我在本地跑大模型最顺手的工具,但它的输出永远停在终端里那一行行文字上——想让 AI 把内容念出来,要么接付费的云端语音接口,要么绕一圈装独立的 TTS 工具。
直到 10 月 24 日,Ollama 官方博客宣布支持语音模型,第一个上架的就是 Gradium 开源的 Phonon:一个 100MB 出头的文本转语音模型,ollama run phonon 一条命令就能让本地 AI 开口。
我当天就把这台 M2 笔记本上的 Ollama 升到最新版,把模型拉下来实测了一把。这篇把过程、数据和坑都写清楚,文末有可以直接抄走的命令清单。
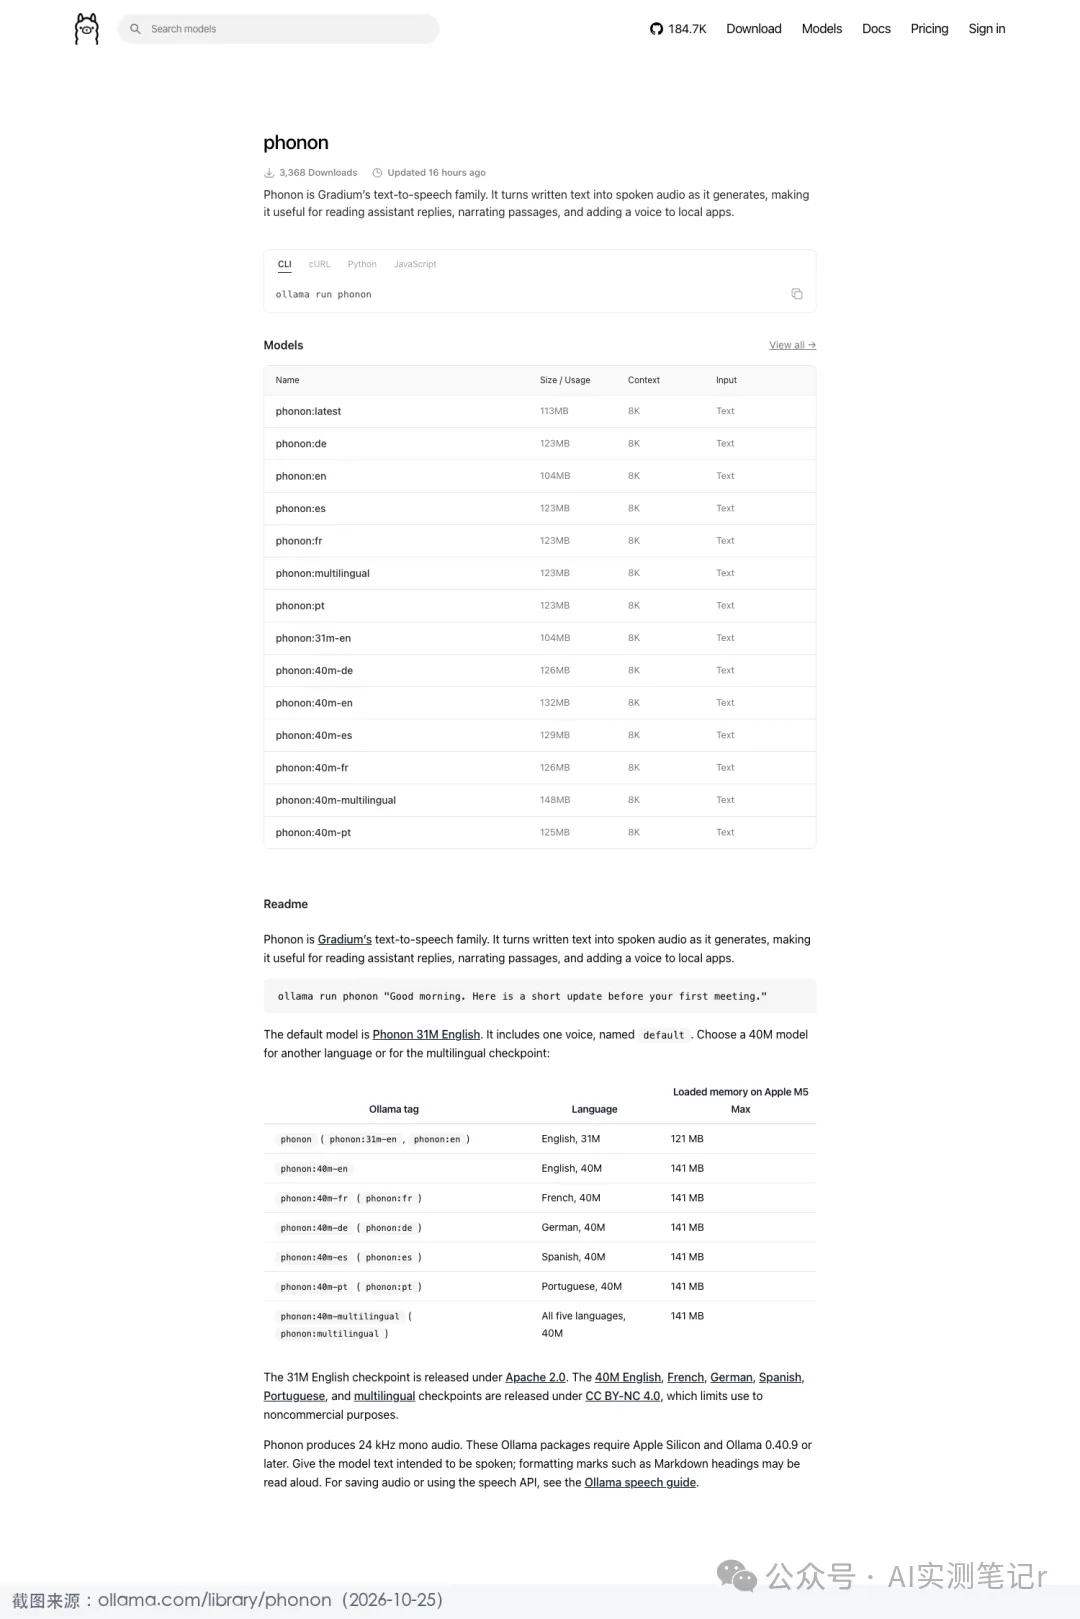
Ollama phonon 模型页:40M 系列标注 123MB,默认英文 31M 版 104-113MB,输出 24kHz 音频
Phonon 是什么:一个 31M 参数就能出声的 TTS 家族
Phonon 是 Gradium 开源的语音模型家族,模型页上标的规格很直接:默认模型 31M 参数(英文),模型页上 40M 系列标注 123MB、英文 31M 版 104-113MB,输入文字、输出 24kHz 单声道音频。除了英文版,还有 40M 参数的法语、德语、西班牙语、葡萄牙语以及五语通用的多语言版。
这里有一个对普通用户很关键的区别:英文 31M 版用的是 Apache 2.0 协议,商用没问题;40M 多语言系列是 CC BY-NC 4.0,仅限非商业用途。你要是打算把本地语音接进自己的产品,选模型前先看这一行,别等上线了才想起授权的事。
另一个值得看的是官方性能数据。Ollama 博客里写了:在 M5 Max 的 MacBook Pro 上,Ollama 生成 45 秒语音的速度比 Gradium 自家运行时快 35%,数据是 10 次运行取中位。注意这是官方在 M5 Max 上测的——我这台 8GB 内存的 M2 跑出来的数据是另一回事,下面单独说。
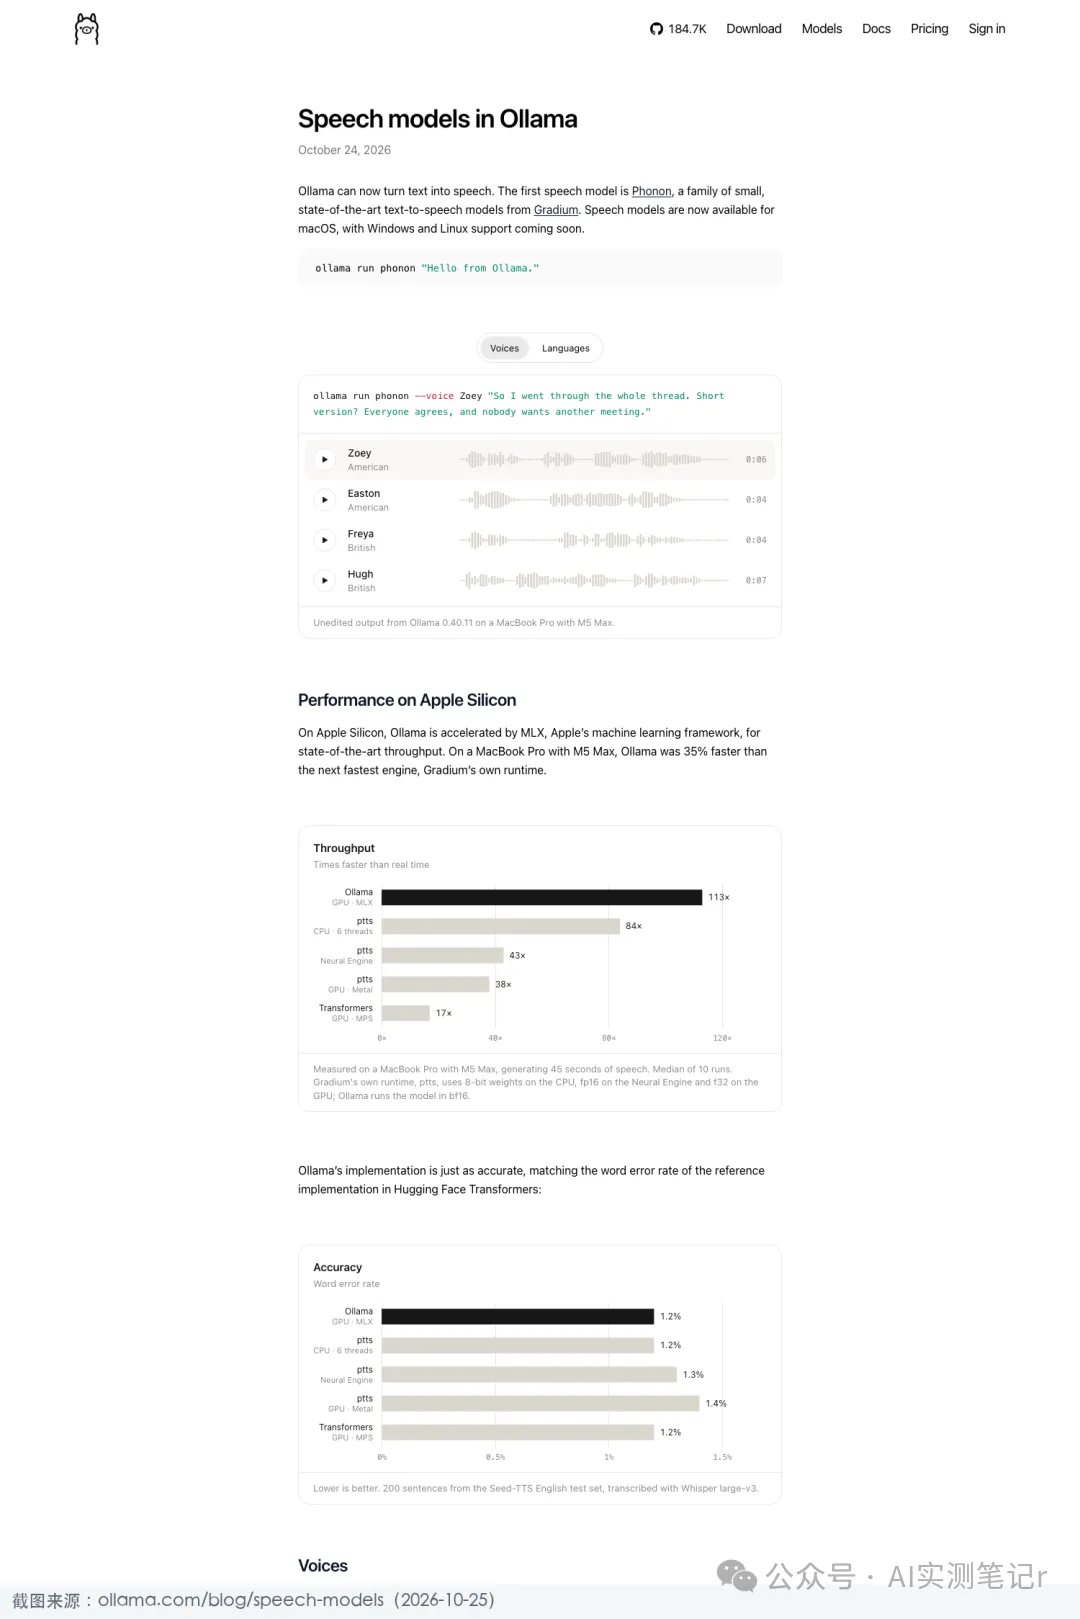
Ollama 官方博客:首次支持语音模型,macOS 先行(2026-10-24 发布)
实测:M2/8GB 上,一条命令出声
先说结论:能跑,而且比我预想的快。
我先把 Ollama 升级到 0.40.11(官方要求 0.40.9 以上),ollama pull phonon 拉下默认模型,模型文件 112MB。然后一句命令:
从敲下回车到 wav 落盘,用了 3.81 秒——生成的音频长 6.64 秒,也就是首次运行(含模型加载)大约跑到 1.7 倍实时速度。文件是一个 318KB 的 WAV,ffprobe 显示 24kHz 单声道、pcm_s16le 编码,与官方文档一致。用音量检测看,平均 -22.5dB、峰值 -5.8dB,是正常说话的音量,不是静音也不是爆音。
第二次我换 API 通道再测,换成一句 6.16 秒的英文,0.47 秒就出音频,因为模型已经在内存里常驻——这时大约跑到 13 倍实时,念一段几百字的稿子也就几秒。
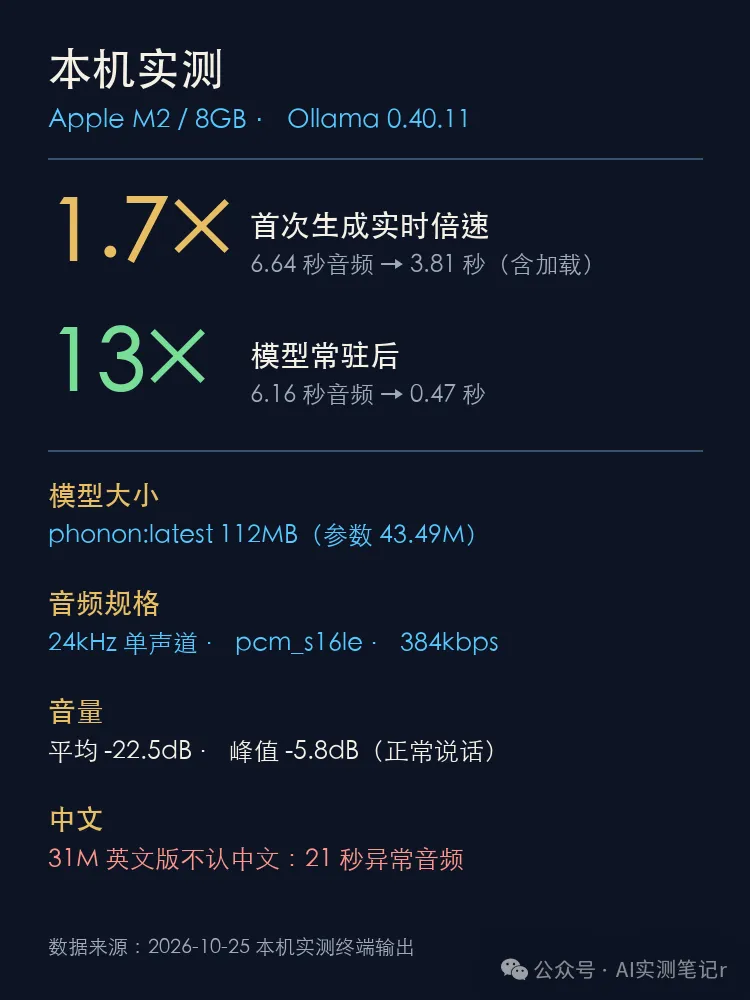
本机实测数据:M2/8GB 上首次生成 1.7× 实时,模型常驻后 13× 实时
一个必须说的实测发现:中文读不了。我拿一句中文去试,模型照样"出声",但生成了 21 秒的音频——它在逐字符地念,不是正常读中文。这个 31M 默认版是纯英文模型,官方多语言版只有法德西葡四种语言,没有中文。中文用户目前只能等,或者拿它读英文内容。
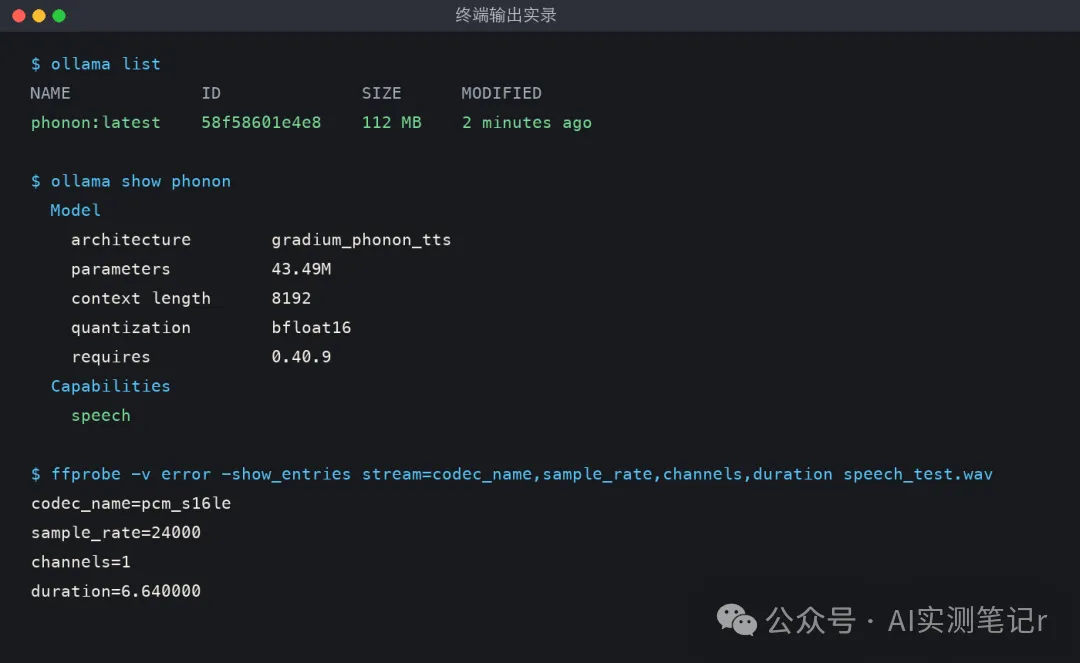
终端输出实录:模型 112MB、24kHz 单声道、6.64 秒音频
除了读一句话,它还能接进你的工作流
Phonon 最实用的地方在于它不只是一个"读一句话"的玩具。官方文档给了三种接法,我自己跑通了存文件和 API 两种:
第一种是管道接 LLM。让本地聊天模型生成回答,直接把输出喂给 Phonon 朗读:ollama run gemma4 --hidethinking "Tell me a fun fact about owls in two sentences." | ollama run phonon。
按文档说法,回答会边生成边念,不用等整段结束——这个要另外装聊天模型,我没跑,只按官方示例写出来。
第二种是存成文件。把输出重定向到文件就是 WAV:ollama run phonon "Save this to a file." > speech.wav。服务器上没有扬声器也能用,生成的音频可以再拿去剪辑、配音。
第三种是 API 调用。Ollama 给语音模型开了 OpenAI 兼容的 /v1/audio/speech 接口,原来用 OpenAI SDK 写的代码,换个 base URL 就能指到本地:
这意味着本地语音可以像调用云端接口一样接进自己的程序,只是数据不出机器。
方法示意:文字进模型,24kHz 音频出来,全程本地
四个坑,实测前先看清
第一,授权分两套,前面已经说过,40M 多语言版不能商用。
第二,Phonon 会"照本宣科":数字、日期、缩写不会自动展开成读法。想让它念对,得在文本里写成"twenty-one"而不是"21"。emoji、列表符号这些也会被直接跳过。
第三,单次输入上限 4096 个字符,ollama run 会自动按段落和句子拆开处理,但 API 调用超了会报错。
第四,语音模型只做语音。你拿 phonon 去问问题、要它写文章,会直接收到 400 错误——它和聊天模型是两类东西,别指望一个模型什么都干。
方法示意:本地语音免费离线,云端语音联网计费
命令速查:从零到出声
这篇实测适合谁:手上有 Apple Silicon Mac、想让本地 AI 内容"能听"的人——读英文文档、给助手回复配音、做无网络的语音播报,它都够用,而且是免费的。不适合谁:需要中文语音的(当前版本不行),或者要商用多语言语音的(40M 版授权只到非商业)。
如果你也在本机跑模型,可以拿一段英文稿子让它念出来听听效果,感受一下 112MB 的模型能跑到什么份上。有什么更好的用法和音频方案,评论区聊聊。