ARTICLE · 1254023
用AI写教案,为什么有人出成果有人白忙
读了个挺有意思的研究。
华南师大还是哪所高校来着,忘了,反正是一篇发在期刊上的实证研究——让67名师范生用DeepSeek写教案,两轮迭代,然后看谁写得好、谁写得差。
结论挺扎心的:不是"用不用AI"的问题,是"怎么用"的问题。
两组人,两种用法
研究者把67人按教案质量分成高低两组,对比他们跟AI互动的过程,发现差异巨大。
高质量组怎么用的?
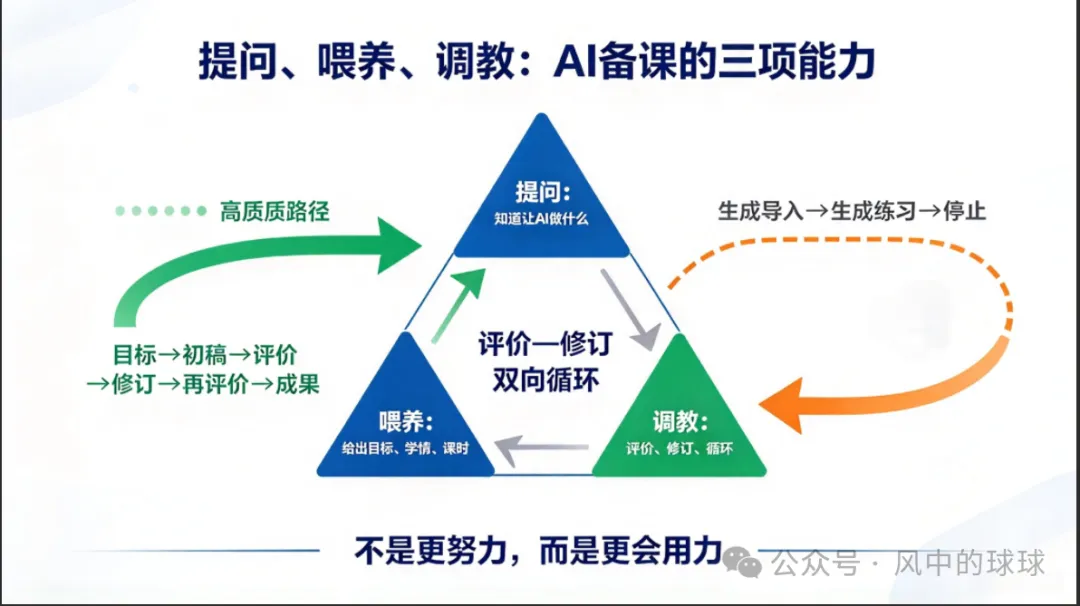
他们不是把题目扔给AI然后等答案。他们的流程是:先自己规划教学目标,再让AI生成初稿,然后自己评价哪里不行,让AI修改,改完再评价,再修改。来回循环,像打乒乓球一样。
研究者管这叫"评价—修订双向循环"。
低质量组呢?
行为零散。一会儿让AI生成个导入,一会儿让AI出个练习题,中间没有连贯逻辑。AI说什么就信什么,觉得"差不多了"就停手。结果要么陷入无效循环(反复让AI改同一个地方),要么草草收场。
一个反直觉的数据
研究还测了认知负荷,就是看这些人用AI的时候累不累、烦不烦。
结果发现:高质量组的"挫败感"反而显著更高。
这有点反直觉——写得好的人,反而更挫败?
仔细想想也对。因为他们一直在"评价—修订—再评价",一直在挑AI的毛病,一直在想"这里还不够好"。这种自我质疑本身就是认知负担。
但有意思的是,他们的"主观努力程度"并没有显著高于低质量组。
也就是说,高质量组不是"更努力",而是"更会用力"。他们把精力花在了关键节点上——评价和修订,而不是漫无目的地跟AI闲聊。
效应量r=0.647,统计学上算大效应了。
这说明了什么
我读完这个研究,第一反应是:这不就是"提问/喂养/调教"三能力的实证版吗?
提问:你得知道让AI干什么,不是扔个题目就完事。
喂养:你得给AI足够的上下文,教学目标、学情、课时安排,不然它只能给你通用答案。
调教:你得会评价AI的输出,知道哪里不行,让它改,改完再评价。
高质量组赢在"调教"——他们会评价、会修订、会循环迭代。
低质量组输在"调教"——他们要么全盘接受,要么陷入无效循环。
我自己的计划
看到这个研究之后,我调整了自己用AI备课的思路。
以前我可能也是"低质量组"的路子——让AI生成个教案框架,看看差不多就用了。现在我会刻意加两个环节:
第一,生成之后先评价。不是看"像不像教案",而是对照自己的教学目标,看AI生成的内容是不是真的服务于这个目标。如果目标是"让学生理解概念的形成过程",那AI给的直接定义就没用,得让它改。
第二,评价之后必须修订。不是"算了就这样吧",而是把不满意的地方明确告诉AI:"这里太抽象了,加个生活案例""这里的逻辑跳跃了,补一步推导"。改完再评价,再改。
这个"评价—修订"循环,可能就是人机协同的关键。
一个提醒
研究还有个发现:高质量组的挫败感更高。
这提醒我,用AI不是越用越爽,而是越用越"较真"。你会开始挑剔AI的输出,会开始反思自己的教学设计,会开始意识到"原来我这里没想清楚"。
这种挫败感是好事。它说明你在思考,而不是外包思考。
如果哪天你用AI备课觉得"太轻松了""AI真厉害我什么都不用想了",那可能不是AI用得好,而是你把自己"调教"成了低质量组。
参考资料:生成式人工智能支持下职前教师人机协同教学设计的行为序列模式与认知负荷特征研究(维普,2026年10月)