ARTICLE · 1257074
面向图文混排文档的 OCR–视觉大模型联合识别:方法、路由与实证评估
摘要
图文混排文档(学术论文、产品说明书、病历、发票扫描件、演示稿截图等)的自动理解,长期被割裂为「字符识别」与「图像理解」两件事。本文提出一种「OCR 打底、视觉大模型按需补图」的联合方法:先用本地部署的 PP-OCRv6 提取文字与版面信息,再依据版面判别在「无图 / 有图」两种情形间路由——纯文字页仅输出文字、不调用视觉大模型;含插图页则裁出插图区域交由视觉大模型描述,最后按序合并「正文文字」与「各图块描述」。在一张含中文正文与数据图表的图文页上,该方法在保持 OCR 级文字准确性的同时,将整页视觉大模型识别的耗时由 26.7 s 降至 20.1 s(约 1.33 倍),且在纯文字页上视觉大模型零调用、单页成本趋近于纯 OCR 的 2.6 s。结果表明,图文混排识别无需在 OCR 与视觉大模型之间二选一,「按是否含图」的判别式路由是同时兼顾准确率、处理速度与计算成本的关键。
关键词:OCR;视觉语言模型;图文混排文档理解;版面分析;判别式路由
1 引言
文档的数字化理解早已不是「把字抠出来」这么简单。真实的文档几乎总是图文混排:论文里有图和公式,说明书里有装配示意,病历里有影像,发票里既有表格也有章。人类读者能同时完成「读字」与「看图」,而自动化系统却常常只完成一半。
长久以来的做法是把问题拆成两个独立的技术栈:光学字符识别(OCR)负责把图上的文字转成可编辑文本,视觉语言模型(VL)负责理解图像内容。两者各自成熟,但单独使用都有难以回避的短板——这构成我们要解决的 gap。
2 问题分析:为什么单靠一边不够
「识字」靠 OCR。它速度快、逐字准确、成本极低,一台 CPU 即可离线运行;但 OCR 只感知字符,不感知插图、图表与公式的语义。
「看图」靠视觉语言模型。它能理解整张图的内容、趋势与关系;但让 VL 逐字转录文字并不可靠,且大模型往往带有「先推理再作答」的特性,识别一张图常需数十秒。
以我们实测的一张「智慧农业年度报告」图文页为例:上半为若干段中文正文,下半为一张标注四种作物病害识别准确率的柱状图。仅用 OCR,能一字不差地抠出所有文字(含图表内的 95.6%、92.3% 等数值与坐标轴标签),却无法得出「四根柱子整体高于 88%、最高者为条锈病、整体高位但逐步走低」这样的趋势性结论;仅用 VL 看整页,虽能描述趋势,但文字转录出现改写与错字(如将「中心数据库」误作「核心数据库」),且整页需二十余秒。
3 方法:OCR 打底 + 视觉大模型按需补图
本文方法的总原则是分工:OCR 负责把字抠准,视觉大模型只在出现插图时上阵,去补「字解释不了」的语义。整体流程见图 1。
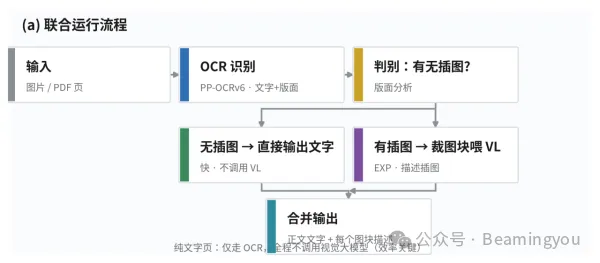
图 1 联合识别运行流程:输入→OCR 得文字与版面→判别有无插图→无图仅输出文字、有图裁图喂 VL→合并输出
如何自动定位「插图在哪」是联合方法成立的前提(图 3):将 OCR 得到的所有文字框涂为遮罩,剩下的「无文字大块」即为插图、图表或示意图所在区域;若整页均被文字覆盖,则判定为纯文字页、直接跳过视觉大模型。
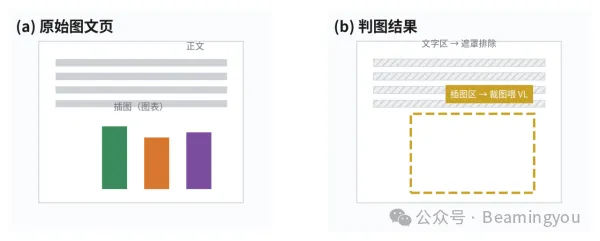
图 2 版面判图原理:(a) 原始图文页;(b) 遮罩文字区、框出插图区,仅对插图区调用视觉大模型
系统组成:OCR 采用 PP-OCRv6(本地离线中文 OCR,纯 CPU 推理、不占显卡、数据不出域),视觉大模型采用本地部署的 DeepSeek 视觉模型(可同时处理文字与图像)。两者均运行于内网,图片无需上传至任何第三方。
4 实证评估
在同一张图文页上,对三种方案进行实测(识别耗时、文字准确性、插图语义覆盖三方面);结果见表 1 与图 2。
方案 | 识别耗时 (s) | 文字准确性 | 插图语义 | 简要说明 |
纯 OCR | 2.6 | 高(逐字) | 无 | 快、便宜,但看不懂图 |
纯 VL(整页) | 26.7 | 较低(改写/错字) | 有 | 懂图,但转字不可靠、慢 |
联合 OCR+VL | 20.1 | 高 | 有 | 兼顾,相对纯 VL 省约 33% |
表 1 三种方案在图文混排页上的实测对比(2026-10-26)。
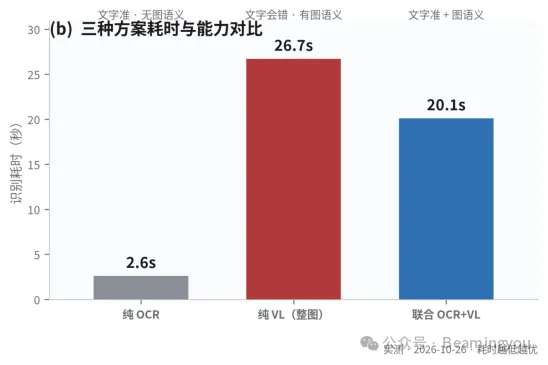
图 3 三种方案识别耗时与能力对比
联合方案并非简单地「快了多少」:其真正价值在于判别式路由——当文档为纯文字页时,联合方案根本不会调用视觉大模型,该页成本趋近于纯 OCR 的 2.6 s;而一旦需要理解插图,又能补上 OCR 缺失的语义。
5 讨论与边界
本方法也存在边界。其一:版面判图依赖「遮罩文字找无文字大块」,对多栏、跨页大图、含大量噪声的扫描件定位可能不准,此时可再叠加版面结构 / 表格结构识别模型。其二:当整页几乎均为大图(海报、演示稿)时,OCR 能提取的文字极少,应改为整页交由视觉大模型,而非强行做 OCR。其三:视觉大模型「爱先推理」,喂入大图或小图都会产生可观的计算开销,因此裁剪换来的主要是准确率与 token 节省,而非与输入尺寸等比例的延迟下降。
展望上,可进一步引入更精细的版面模型与表格结构识别,针对扫描噪声做 OCR 低置信度回送复核,并面向多页 PDF 做「逐页判别、按需调用」的批量路由,使成本随文档实际含图率自适应。
6 结论
图文混排文档的识别,不必在「OCR」与「视觉大模型」之间二选一。以 OCR 打底保住速度与准确率、仅在出现插图时按需调用视觉大模型,即可同时获得「文字准」与「看得懂图」两个优势。判别式路由是兼顾精度、速度与成本的核心。
数据与代码可获取性
本文为演示性质的原创科普,基于本机自研图文识别系统撰写;文中示意图为演示示意(非真实业务文档),识别耗时为本机实测结果(2026-10-26)。系统组件:PP-OCRv6(本地离线中文 OCR)、本地部署 DeepSeek 视觉大模型。