ARTICLE · 1269196
拆解 WeKnora 文档解析模块:一个生产级 RAG 解析引擎是怎么造出来的
源码:
github.com/Tencent/WeKnora(本文基于 2026 年 10 月 main 分支,约 a4dcec644)所有文件:行号都可以直接跳转对照。
用干净 PDF 搭起来的 RAG 知识库,第一周 demo 往往很顺:输入几个规整文件,问答准确率好看。第二周业务部门送来三份真实文件——300 页扫描版合同、WPS 另存出来的假 .docx、带合并单元格和百分比列的销售报表。demo 当场失败。
故障点在解析。这是 RAG 六个环节(解析、切分、向量化、检索、重排、生成)里最不像 AI 的一个,但它决定上限:解析丢了的表格和数字,后面全链路都救不回来。
这篇拆 WeKnora 的文档解析模块。WeKnora 是腾讯开源的企业级 RAG 知识库系统,Go 主程序 + Python 解析 sidecar + 可插拔的十来个解析引擎,支持从扫描 PDF 到 XMind 脑图的二十多种格式。本文用 7 张图依次说明它的架构、引擎选择、异步流水线、状态机、数据流、模块划分和调用链,最后给出一份自己搭建 RAG 解析模块时的借鉴清单。
WeKnora 解析模块的核心设计只有一句话:所有引擎产出同一种形状的结果(Markdown + 图片 + 位置信息),下游对引擎零感知。 多引擎动态选择、扫描件路由、引用溯源、失败恢复,全部围绕这一句展开。
一、全景:三个执行位置,一份契约
先看整体架构(图 1)。
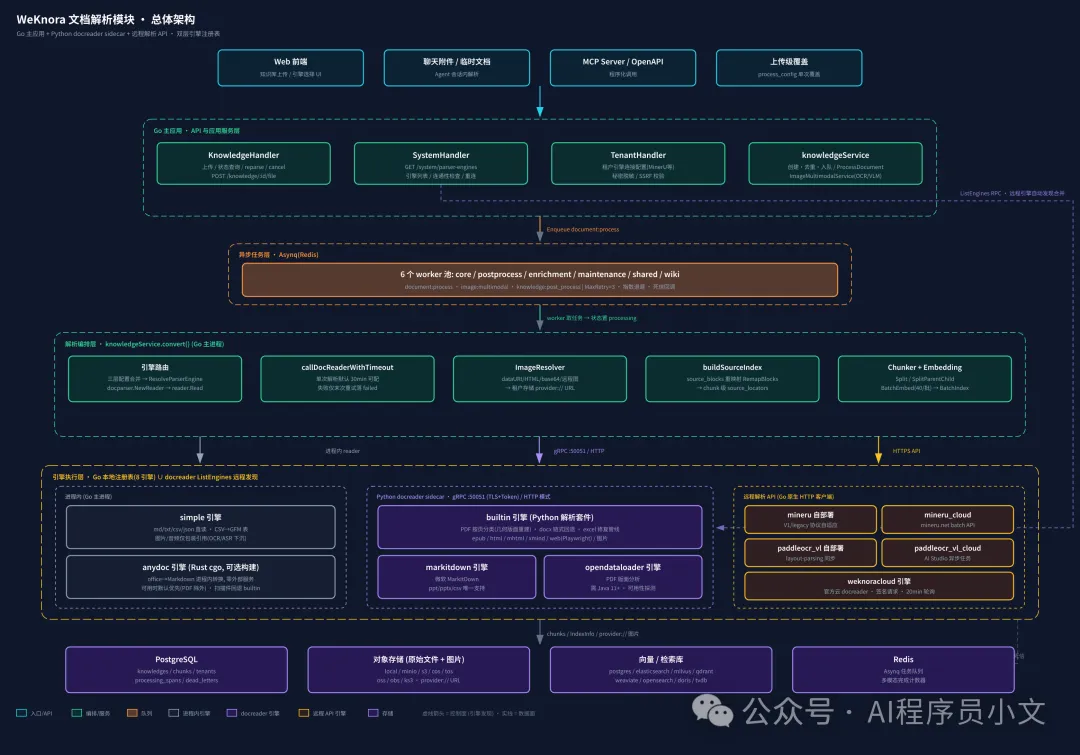
最显眼的分层是「引擎执行层」里的三个子区域,对应解析动作实际发生的三种位置:
• Go 主进程内: simple引擎直读 md/txt/csv/json,anydoc引擎(Rust 库经 cgo 链接)做 Office 转 Markdown,零外部依赖;• Python docreader sidecar:独立容器,gRPC 50051 端口,承载 builtin全家桶(PDF/DOCX/Excel/EPUB/HTML/XMind/图片/网页)、markitdown、opendataloader三个引擎;• 远程 API:MinerU 自部署、MinerU 云、PaddleOCR-VL 自部署、PaddleOCR-VL 云、WeKnora 云,Go 里原生 HTTP 客户端直接调。
Python 单独拆成 sidecar 有三个硬理由:
1. 文档解析的生态在 Python——pypdfium2、python-docx、openpyxl、trafilatura、Playwright、ebooklib,Go 里没有对等物; 2. 解析是最容易崩溃的环节(pdfium 不是线程安全的 C 库、LibreOffice 子进程会挂起、第三方 API 会超时),独立容器崩溃后不拖垮主服务; 3. 镜像解耦——docreader 容器要装 LibreOffice、Java、Playwright WebKit,这些不应该进主程序镜像。
但这个 sidecar 的职责边界切得非常克制。docreader 的 docstring 里写得很直白:不做切分、不做 OCR、不做 VLM、不做存储,只把文件变成 Markdown + 图片引用 + 溯源块。切分、OCR、VLM caption、图片落对象存储,全在 Go 侧的摄入管线里做。这个切法让 Python 侧零模型依赖,镜像轻;OCR/VLM 是 GPU 资源决策,交给调度方(Go)统一编排。
两侧只靠一份契约耦合,就是这两个结构(internal/types/docparser.go:12-36):
// 引擎无关的请求:文件或 URL 二选一,engine 与租户参数随行type ReadRequest struct { FileContent []byte // 文件字节;URL 模式下为空 URL string // 网页导入模式 FileType string ParserEngine string // 选中的引擎名,空 = 默认路由 ParserEngineOverrides map[string]string // 租户级连接参数/开关}// 所有引擎的统一产物type ReadResult struct { MarkdownContent string // 正文 Markdown ImageRefs []ImageRef // 图片(内联字节 + 是否原图标记) SourceBlocks []SourceBlock // rune 区间 → 原文位置(页码/bbox/行号) Metadata map[string]string Error string IsAudio bool // 音频走 ASR 分支的信号}SourceBlocks 这个字段先记住,第六节讲引用溯源时它是主角。
部署形态:一个细节看安全观
docker-compose 里的部署方式值得单独看一眼(docker-compose.yml:417-529):docreader 服务不对宿主机发布端口,只在 compose 内网 expose: 50051,注释写得很清楚——gRPC 默认无鉴权,只供 app 容器经内部网络访问。要跨网络部署就得开 TLS:GRPC_TLS_ENABLED 一开,证书配置缺失或加载失败直接抛出异常并退出进程(docreader/auth.py 的 fail-fast 设计),绝不静默降级成明文。配上 GRPC_AUTH_TOKEN 后,客户端的 Bearer Token 用恒时比较校验,且只允许走 TLS 通道——gRPC 拦截器里的 RequireTransportSecurity 会把明文连接上的凭证直接拒掉,防止 token 泄到可被嗅探的链路。
app 侧连接就两个环境变量:DOCREADER_ADDR=docreader:50051、DOCREADER_TRANSPORT=grpc(可切 http/https 走 HTTP 传输模式)。容器初始化时(internal/container/container.go:1909)没配地址就以 disconnected 状态启动——解析模块不可用时主服务还能启动,只有用到解析的接口报「DocReader service not connected」。
调优项全部走环境变量,启动时打印生效值:PDF 渲染 DPI 200、JPEG 质量 85、长边上限 2000px(防超大页面渲染出上亿像素的图撑爆消息上限)、markitdown 并发 1、预处理子进程内存上限 2048MB。这些默认值都是调过的,抄作业时别乱改。
带着目的读这份源码的推荐顺序:先看 internal/infrastructure/docparser/doc.go——21 行的包文档把整个包的设计立场讲完了;再看 engines.go 和 engine_registry.go(引擎体系全貌);然后进 knowledge_process.go 的 convert() 和 ProcessDocument()(四千多行的主管线,但注释密集不难跟);最后按格式兴趣挑 docreader/parser/ 下的解析器读。tests 目录当验收标准用——每个解析器到底有什么能力,测试文件是最诚实的文档。
二、引擎怎么动态选:两层注册表接力
「支持动态选择引擎」的系统很多,「加一个新引擎不用改主程序」的不多。WeKnora 做到了,靠两层注册表。
Go 侧是第一层(internal/infrastructure/docparser/engines.go:32-42),init() 里注册 8 个本地引擎:builtin、simple、anydoc、weknoracloud、mineru、mineru_cloud、paddleocr_vl、paddleocr_vl_cloud。每个引擎实现同一个五方法接口——报名字、报描述、报支持的文件类型、探测可用性(比如 MinerU 打 /v1/health、云引擎查 API Key)、构造 reader。
路由逻辑在 engine_registry.go:69-79,三段式:
func NewReader(ctx, engine, fileType string, isURL bool, deps ReaderDeps) (interfaces.DocReader, error) { if registration, ok := lookupEngine(engine); ok { return registration.NewReader(ctx, deps) // 1. 本地注册表命中 } if engine == "" && !isURL && IsSimpleFormat(fileType) { return &SimpleFormatReader{}, nil // 2. 空引擎 + 简单格式 → 进程内直读 } return remoteReader(deps) // 3. 其余一律转给 docreader 客户端}第 3 段是精髓:未注册的引擎名自动路由到 Python docreader。markitdown 引擎只存在于 Python 侧,Go 根本不认识它,但你在知识库规则里写 engine: markitdown,请求照样到达 Python 侧被正确处理。Go 侧 reader 构造失败会明确报错(MinerU 没配 endpoint、云凭据缺失),而不是悄悄换一个引擎继续解析——静默降级在生产上是灾难,用户以为用了 mineru 其实走了 builtin,效果差了还查不到原因。
Python 侧是第二层(docreader/parser/registry.py),自己又注册了 builtin、markitdown、opendataloader 三个引擎,带自己的兜底链:请求引擎不支持该类型 → 查类型级默认(ppt/pptx/csv → markitdown,因为 builtin 没实现这三种)→ builtin 兜底 → 都不行就返回一个可操作的报错,列出支持该类型的所有引擎名让你换配置,而不是静默失败。
两层怎么合起来给前端看?ListAllEngines(engine_registry.go:100-145):本地引擎全部列出并做 Go 侧可用性检查;对端 Python 通过 ListEngines RPC 上报自己的引擎清单,同名引擎时远程的 file_types 和描述优先(远程服务才是自己能力的权威),远程独有的引擎直接追加。效果是:Python 侧加一个新引擎类、注册一下,Go 和前端零改动就能看到并选用。
完整的引擎选择调用链见图 2,左栏 Go 路由、右栏 Python 兜底,中间是 gRPC 边界。
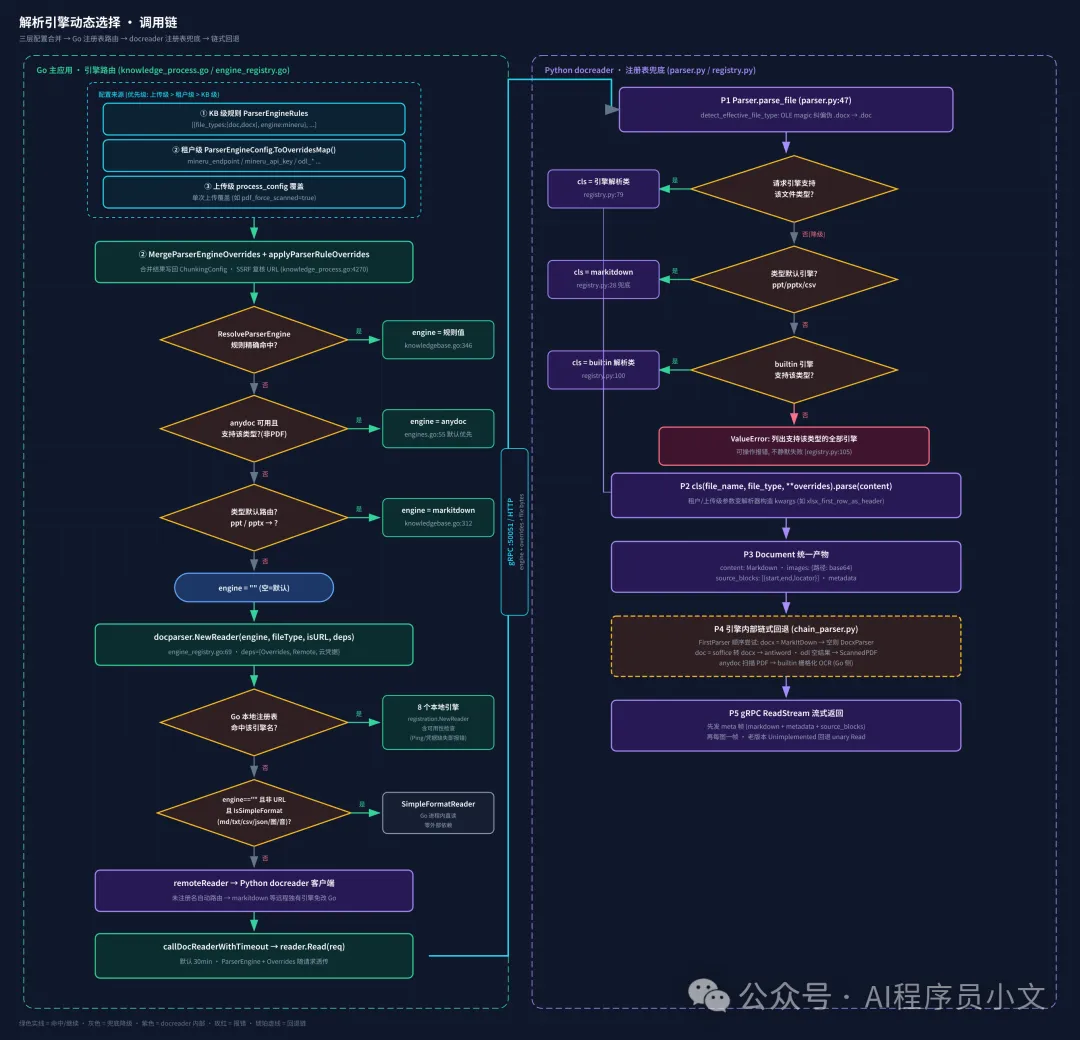
配置怎么进来是另一条线,三层合并(knowledge_process.go:4270-4286):
1. 知识库级规则存在 KB 的 chunking_config.parser_engine_rules,按文件类型指定引擎——这就是「同一个知识库里 doc 走 mineru、pdf 走 builtin」的来源;2. 租户级连接参数(MinerU endpoint、API Key、PaddleOCR 端点……)存在 tenants.parser_engine_config,经ToOverridesMap()平铺成 snake_case map 随请求下发——注意它管「连得上连不上」,不管「用不用」;3. 上传级覆盖允许单次上传改规则或传开关(如 pdf_force_scanned=true强制按扫描件处理),reparse 时还能持久化,方便先试后定。
# 知识库解析规则示例(chunking_config 内)parser_engine_rules: - file_types: [doc, docx] engine: mineru # Office 文档交给版面分析 - file_types: [pdf] engine: builtin # PDF 用内置按页分类 - file_types: [xlsx] engine: builtin xlsx_first_row_as_header: true还有一个容易忽略的细节:没配规则时的默认路由链(knowledgebase.go:312-341 + engines.go:55-64)。anydoc 绑定进构建且支持该类型时默认用它(快、零依赖)——但 PDF 例外,注释里给了很长的理由:anydoc 对 PDF 没有文档模型,一页只出几个字符也会报「解析成功」,图表版面全丢;builtin 会按页分类并路由 OCR/VLM,更适合 PDF。然后 ppt/pptx → markitdown 是硬编码的类型默认。最后空字符串落到 simple/builtin 自动分流。
这段注释把「为什么默认值长这样」的取舍写进了源码,五年后接手的人不用重新踩一遍坑。
前端怎么把这套东西暴露给用户
知识库设置页 KBParserSettings.vue 的做法可以整套搬走:打开时调 GET /api/v1/system/parser-engines 拿合并后的引擎列表(带 available 和不可用原因),把所有引擎的 file_types 汇总,按文件族分组——pdf / doc+docx / pptx+ppt / xlsx+xls / epub / mhtml / csv / md / txt / json / 图片 / 音频——每组一个引擎下拉框,只列出支持该组扩展名且当前可用的引擎。遇到后端新引擎带来的没见过的扩展名,前端动态生成一行,不用发版。
两个体验细节:每组的「(默认)」徽标由后端真实路由逻辑(anydoc 优先、simple 分流、ppt→markitdown)在前端复算一遍得出,用户看到的默认就是实际会走的引擎;xlsx 组选中 builtin 时才出现的「首行作表头」复选框,是引擎级参数透传到解析器构造函数的直接体现。
租户设置页则是另一套:引擎卡片 + 抽屉表单(MinerU endpoint/tier/parse_method、PaddleOCR 端点等),「测试连接」按钮调 POST /system/parser-engines/check 即时探测不落库,保存时秘密字段打码回传、服务端识别打码值后保留旧秘密——这套「脱敏读取 + 打码保留写入」的多租户配置模式,做 SaaS 的可以直接抄。
顺带把「加一个新引擎要动几处」捋一遍,可以看出这套架构的接入成本:Python 侧写一个 BaseParser 子类(实现 parse_into_text 返回 Document)、在 registry 里注册一行、可选补一个可用性探测函数;Go 侧一行都不用动——ListEngines 自动发现、未注册名自动路由、前端动态出选项。只有当新引擎需要 Go 侧深度编排(管上传、轮询、产物对齐)时,才在 engines.go 加一个 EngineRegistration。轻引擎走 Python、重编排走 Go,两条接入路径边界清晰。
三、十一个引擎,到底怎么挑
把两层注册表里所有引擎摊开(表 1)。
| 默认起步选择 | ||||
| PPT/PPTX 唯一支持 | ||||
给出明确推荐:
• 从 builtin 起步。它的 PDF 解析在无外部服务的前提下做到了按页分类路由,扫描页交给下游 OCR/VLM,文本页做几何版面重建,大部分场景够用。 • 扫描件和复杂版面 PDF 是 builtin 的弱项,改用 mineru 或 paddleocr_vl。这两个引擎基于版面分析模型,产出带 bbox 的内容块,表格还原质量高一个档位。选自部署还是云,取决于是否愿意自己维护 GPU。 • PPT 只能选 markitdown(builtin 里 ppt/pptx 就是转发给它的)。 • 音频只有 builtin 路径能走(占位符 + Go 侧 ASR 转写)。
anydoc 这个进程内引擎还有两处细节值得看:资源超限错误(比如 XML 节点数撑爆预算)被包装成可识别的 ErrResourceLimit,调度层据此判定这是永久失败不再重试,省掉三次注定失败的重跑;扫描 PDF 检测(错误对象自带 NeedsOCR 语义,或文本全空)触发回退 builtin 栅格化 OCR,回退事实写进 metadata(anydoc_fallback=scanned_pdf),事后可审计。错误分类驱动调度行为,这个模式比「所有错误一律重试」更成熟。
可用性是动态探测的。前端打开知识库设置时调 GET /api/v1/system/parser-engines,后端把租户配置的 endpoint/Key 传给每个引擎的 CheckAvailable——MinerU 真的发一次带鉴权的请求验证 Key 有效性(401 会翻译成「请配置 API Key」或「Key 无效」)、opendataloader 检查 Java 和健康检查端点——返回不可用原因直接显示在下拉框上(「请安装 opendataloader-pdf 与 Java 11+」)。用户不会选到一个跑不起来的引擎。
四、一个文件进来之后发生了什么
图 3 是业务流程全景,五条泳道从上传贯穿到可检索。
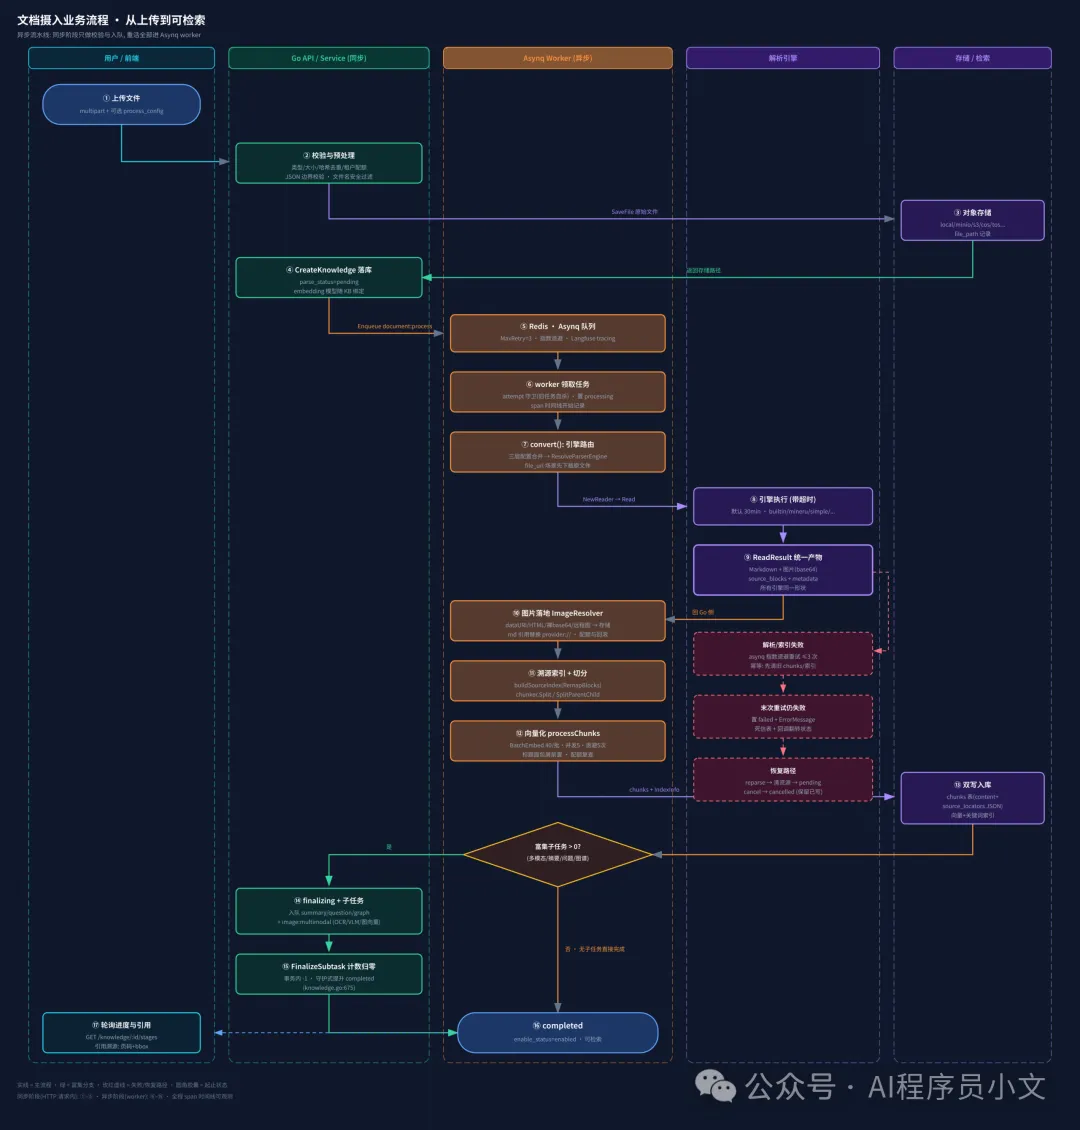
同步阶段只干轻活(HTTP 请求内,秒级返回):类型/大小校验、文件哈希去重(同 hash 直接拒并提示已有文档)、租户配额检查、原始文件存对象存储(local/minio/s3/cos/tos/oss/obs/ks3 八种后端)、建一条 parse_status=pending 的 knowledge 行、往 Asynq 投一个 document:process 任务。然后 HTTP 就返回了,knowledge_id 给前端去轮询。文件名还会过一道安全校验,JSON 文件在 HTTP 边界就做 json.Valid(截断的 JSON 立刻失败,而不是异步重试三次之后才告诉用户)。
入口其实不止文件上传,还有三个变体:网页 URL 导入(用伪文件类型 url 走 WebParser 浏览器渲染)、文件直链(worker 内先下载再解析,不占 HTTP 上传通道)、手工知识(直接粘贴 Markdown 或分段文本,跳过解析直达切分)。聊天附件和临时文档也走同一套引擎注册表,只是入口在会话侧,用租户的 ChatParserEngineRules 路由。同一份解析能力服务了知识库、对话附件、Agent 工具三条业务线——这是统一契约带来的复利,解析模块只写一遍,业务侧各取所需。
重活全在异步 worker 里。任务队列是 Asynq(Redis 后端),6 个 worker 池按任务类型分队列:core 跑文档解析、postprocess 收富集、enrichment 跑摘要/图谱、maintenance 跑回收、shared 是弹性池、wiki 独立。MaxRetry=3 指数退避。worker 领到任务后先过两道守卫——attemptSuperseded(这条记录被重新上传/重解析过,旧任务直接终止)和取消检查——然后把状态翻成 processing,进入核心函数 convert()。
convert() 的顺序(knowledge_process.go:4246-4390):三层配置合并 → ResolveParserEngine 选引擎 → NewReader 拿 reader → 读回文件字节 → 带 30 分钟超时调 reader.Read(默认值,可按知识库配)→ 拿到 ReadResult。
传输这一跳值得单独讲,图 4 是完整时序。
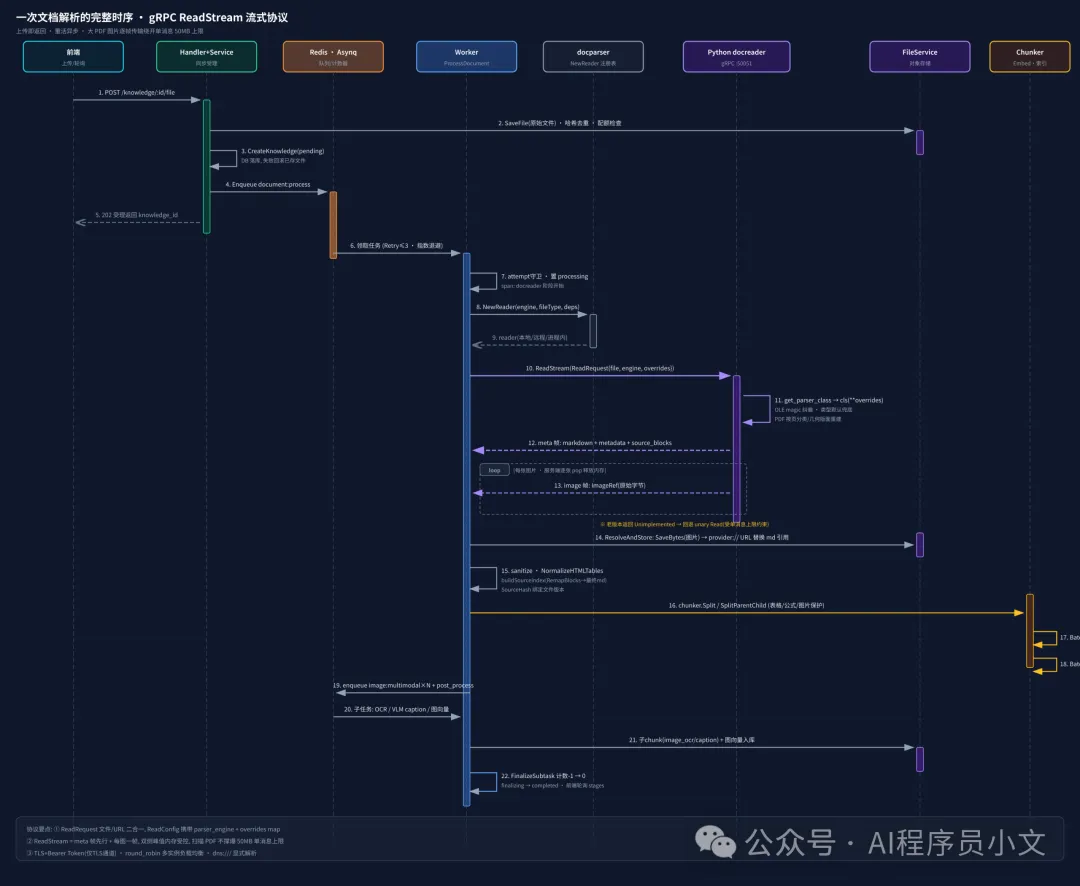
Go 客户端优先调服务端流式的 ReadStream(grpc_parser.go:107-144):第一帧 meta(Markdown + metadata + source_blocks + 图片数量),随后每张图片一帧。这么设计是因为两个硬约束:gRPC 单消息默认上限 50MB,一份大扫描 PDF 渲染出的页图轻松超限;即便不超限,两侧同时持有全部图片的 base64 + 解码字节,峰值内存成倍上涨。流式之后每一帧都是小消息,服务端还用生成器逐张 Pop 释放 base64 源(main.py:128-150)。对端如果是老版本返回 Unimplemented,客户端降级回 unary Read——版本兼容做在了协议层。
连接本身也有一堆细节:dns:/// 显式解析器配 round_robin 负载均衡(docreader 可以多实例)、TLS 缺配即拒绝启动、Bearer Token 只走 TLS 通道。另有纯 HTTP 传输模式(DOCREADER_TRANSPORT=http,base64 JSON over POST /read)给 gRPC 互通不了的部署形态,两种传输共用同一套 DTO,甚至 WeKnora 云 reader 也复用它。
解析结果回到 Go 侧后是一条后处理流水线,全部与引擎无关:
第一站,特殊分支。音频文件拿到的是占位 Markdown + 原始字节,走 ASR 模型转写(knowledge_process.go:4013),转写结果带时间分段,每段生成一个 time 类型定位器——引用一个音频结论能精确到毫秒区间。OCR 类引擎输出的带样式 HTML 表格先过 NormalizeHTMLTables:转成 GFM 省 token,转不了(含 rowspan/colspan)就降级——剥掉表现属性、每行 <tr> 独占一行,让切分器至少能按行切而不会从单元格中间切开;围栏代码块里的表格示例不动,重复调用幂等。
第二站,图片入库(image_resolver.go:104):四趟扫描——Markdown dataURI、HTML <img> dataURI、裸 base64 残片(含跨行 wrapped base64 的边界推断)、ImageRefs 显式引用——命中就存租户对象存储、把 Markdown 里的引用替换成 provider:// URL。带一圈防线:文档级配额 1000 张/100MB、魔数嗅探(PNG/JPEG/GIF/WEBP/BMP)、按格式尾签验完整性(PNG 找 IEND、JPEG 找 FFD9)、像素预算单图 16M(GIF 另有 32M/256 帧)、图标过滤(任一边 <64px 或 <512B,但 IsOriginal 标记的原图豁免——原始上传的图片本体不允许被当图标丢掉)、代码块里的示例图片不误传、失败用 context.WithoutCancel 回滚已上传图片防悬挂。
第三站,溯源索引:把 source_blocks 从「解析时 Markdown」重映射到「表格归一化后的最终 Markdown」,并给每张已存图片按其出现位置赋上定位器。
第四站,切分(Go 侧,internal/infrastructure/chunker):默认 512/80,表格、$$公式$$、图片引用、链接受保护不被切开,表格跨 chunk 时表头自动重复且列数冲突就停,另支持父子切分策略(父块保上下文、子块保召回精度)。每个 chunk 入索引时前面拼上标题面包屑(context_header,从 H1 到当前层级的路径)——这一步对检索质量的提升经常被低估,裸段落没有标题上下文,embedding 质量明显更差。
第五站,向量化双写:embedding 按 40 条一批、并发 5、失败指数退避 5 次;chunks 表落库(content + 面包屑 + source_locators + image_info,chunk 之间还有 pre/next 指针链),向量/关键词索引入库(11 种向量库后端,组合引擎按支持类型并发分发)。幂等靠先删后建:重跑前清掉旧 chunks、旧索引、旧图谱。
到这里主索引已经可检索了。但流程没完——图片的 OCR/VLM caption、文档摘要、问题生成、知识图谱这些富集子任务被 fan-out 成独立任务(每张图一个 image:multimodal,Redis 计数器盯完成度),文档进入 finalizing 状态等它们完成。
多模态那一支展开讲讲(internal/application/service/image_multimodal.go):worker 领到图片任务后按管线跑——可选的拍照矫正(调 docreader 的 PreprocessImage,后面第七节细讲)、OCR 抽文字、VLM 生成 caption、观察图片属性——产出两类子 chunk:image_ocr(图里的文字,可被检索)和 image_caption(图的语义描述),都通过 parent_chunk_id 挂到包含该图的文本块上,引用展开时跟着父块走。知识库开了 ImageVectorEnabled 且 embedding 模型支持图片编码时,图片本体还会向量化成 image_vector chunk 直接入索引(维度必须和文本索引一致,这个校验不过直接报配置错误而不是悄悄写脏数据)。检索侧,命中的图片以 MatchedImages 挂在结果上(只存存储引用不存字节),最多 3 张转成 data URI 塞给视觉模型做视觉问答。
五、解析失败了怎么办:状态机与可靠性
异步流水线的可靠性设计看状态机最清楚(图 5)。
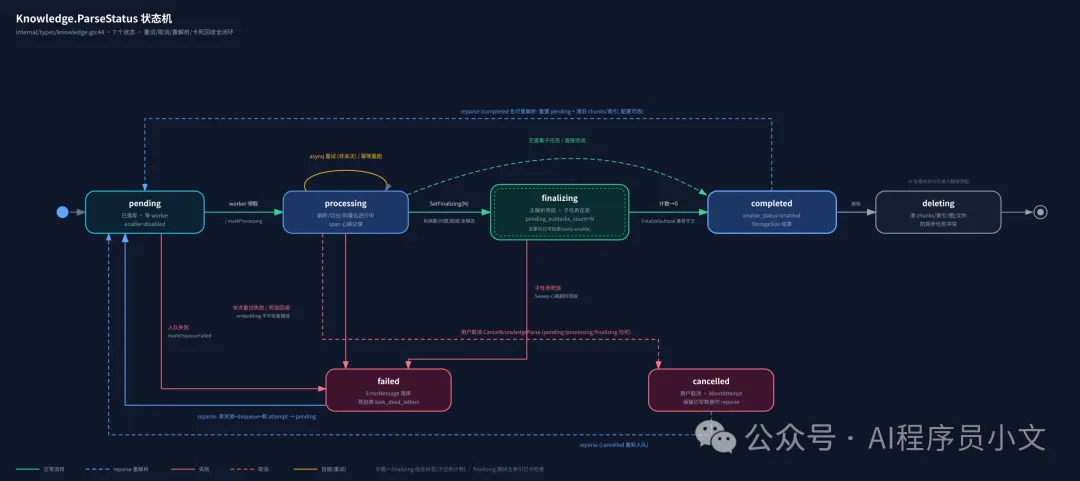
七个状态:pending → processing → finalizing → completed 是主链,failed、cancelled、deleting 是旁路。几个设计点:
finalizing 是个组合状态,带子任务计数器(pending_subtasks_count)。主解析完成、富集任务在途时进这个状态,每个子任务结束调 FinalizeSubtask(repository/knowledge.go:675),事务里原子减一并守护式判断归零提升 completed。效果是摘要慢一点不会阻塞检索——主索引在 finalizing 期间已经可查,慢任务只影响锦上添花的部分。用户传完文档三十秒后就能搜到正文,「摘要还在生成」只是状态条上的一小段。
重试和失败落库是解耦的。Asynq 任务重试 3 次,但只有最后一次重试失败才把 knowledge 行置 failed——前几次返回 error 让队列重跑,行状态保持 processing,前端不会看到状态来回抖。重跑是幂等的:先删旧 chunks/索引/图谱再重建。任务彻底耗尽预算后走死信中间件(middleware/asynqdl):先写 task_dead_letters 表供运维 SQL 排查,再触发回调把对应 knowledge 行翻成 failed——回调覆盖三种任务类型,不会出现「队列里死了、状态还是 processing」的裂缝。
卡死有兜底回收。Housekeeping 定时任务扫描超过阈值仍停在 pending/processing/finalizing 的行,依据 knowledge_processing_spans 表里的阶段心跳判断是否真死,标记失败并写明原因。worker 崩溃、Redis 丢任务这类「没人来更新状态」的场景不会留永久 processing 的僵尸行。
reparse 是完整的重置流程(knowledge_process.go:2853):清旧资源、dequeue 在途任务、分配新 attempt、状态回 pending、允许改配置后重跑——试错成本低。取消(CancelKnowledgeParse)则是置 cancelled + AbortAttempt 级联取消 span 树 + 从队列撤任务,已写入的数据保留,之后可以 reparse。
还有一个前面提过的 attempt 机制值得强调:每次上传/重解析递增 attempt 号,旧 worker 领到过期任务会通过 attemptSuperseded 自动终止。没有它,「用户重传文件后旧任务又跑完把新数据覆盖了」这种幽灵 bug 会非常难查。
配额是两道关:上传时查一次租户 StorageQuota,索引前再按 EstimateStorageSize 复查一次——防止「原始文件 5MB 但解析出 200MB 图片」这种膨胀型超限漏网,成功后 AdjustStorageUsed 结算。第一道关挡明显超限,第二道关挡解析后的隐性超限,两道都过才写索引。
可观测性不是可选项。每个文档的处理过程在 knowledge_processing_spans 表里留下五个阶段的时间线(docreader/chunking/embedding/multimodal/postprocess,每个 span 有 pending/running/done/failed/skipped/cancelled 状态),前端 GET /knowledge/:id/stages 渲染成进度视图——用户看到的是「解析完成,正在向量化」这样的具体阶段。任务入队时 payload 注入 Langfuse tracing 上下文,Asynq 全局中间件串起来,慢在哪个阶段一查便知。这套记录在排查「为什么这篇文档处理了二十分钟」时非常关键。
六、Markdown 切完之后,引用怎么回到 PDF 第几页
这是整个模块里我认为最被低估的部分:source_blocks 溯源协议。数据流见图 6。
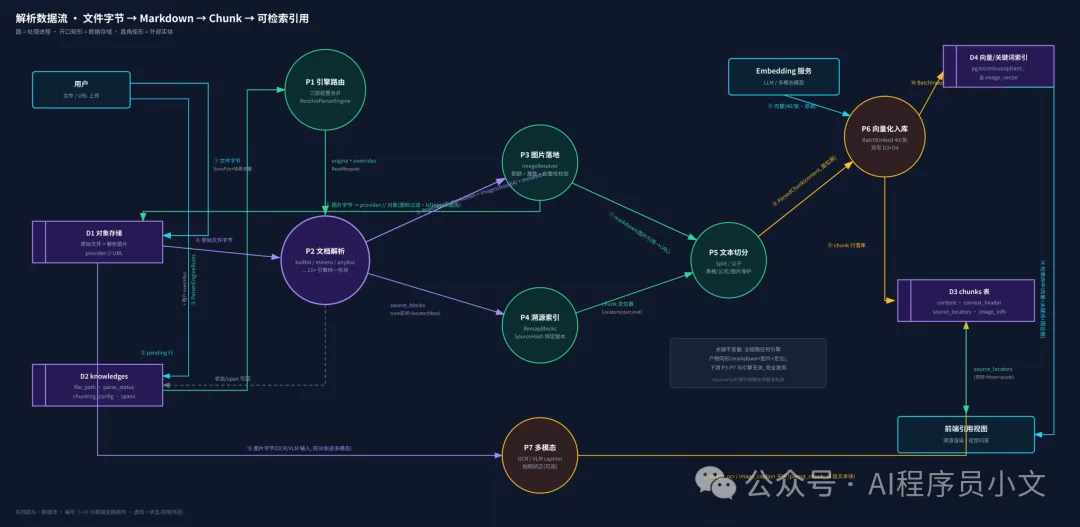
问题陈述:RAG 答案要可信,引用必须能跳回原文——「这个结论来自合同第 14 页左下角那个条款」。但解析产物是 Markdown,切分后更是碎块,原始位置信息在哪?
WeKnora 的答案是在 ReadResult 里带一组「溯源块」:
{ "start": 1024, "end": 1189, "locator": { "type": "pdf", "page": 14, "bbox": [0.08, 0.62, 0.91, 0.78] }}start/end 是解析产物 Markdown 里的 rune 区间(end 排他),locator 是原文位置——7 种类型覆盖全部格式:pdf(页+bbox,分数坐标左上原点,任意缩放可画框)、docx(第 N 个段落/表格)、slide(第 N 页)、sheet(sheet 名+行区间)、text(rune 区间)、time(音频毫秒区间,ASR 分段生成)、section(EPUB spine 章节)。
生成侧各引擎自己负责:builtin 的 PDF 解析器逐行记录文本盒几何,聚合段落时 bbox 取成员行并集(docreader/parser/source_locator.py),行定位用「投影归一化 + 顺序游标 + 双栏同列游标」的算法——投影时全角折半角、大小写折叠,但数字中间的 .,:/ 只有在语义位置才保留,数字证据不丢;双栏 PDF 阅读顺序交错时,从同列上一行末尾继续找,避免串栏;出现次数不唯一或 key 太短的行直接放弃定位,宁可没有 bbox 也不能画错框。MinerU/PaddleOCR 产出的版面 bbox(一个 0-1000 归一化、一个 0-1 归一化,这里踩过坑所以代码里有专门注释)被转成统一比例坐标后交给 sourceloc.Align 做精确文本对齐:对齐原则是「单元文本在文档中的每一次出现都必须被源单元覆盖」,只精确匹配不外推——bbox 越界、NaN、页号乱序的块直接丢弃。整条链的信条是「宁缺毋错」:溯源信息的信任成本极高,画错一次框用户就再也不信引用了。传输层同样贯彻这个信条:wire 格式里空区间、空 locator、JSON 解析失败的块在解码时直接丢弃(docreader/source_blocks.go:20-29),一个坏块不会拖垮整份解析结果。
消费侧闭环(knowledge_source_locators.go):切分时每个 chunk 按自己的 rune 区间从索引里取定位器,连同 300 字截断的原文 quote 落到 chunks 表的 source_locators JSON 列;检索命中后随 SearchResult 下发,相邻 chunk 的证据合并时定位器也跟着合并;前端引用视图拿到后按页码+bbox 在 PDF 预览里画框高亮,用户还可以按句子粒度选择定位。每张图片也按它在 Markdown 里的位置拿到定位器——点开引用图片能告诉你「这张图来自原文件第 3 页」。
SourceHash 字段绑定文件版本(取文件哈希),文件重传后旧引用标记 stale,前端有专门的状态处理(ChatReferenceSourceView.vue 里那个 idle/locating/found/ambiguous/stale/missing/partial 状态机)。
这篇文章里如果只带走一个设计,推荐选这个。它便宜(解析时顺手记录)、渐进(不支持溯源的引擎直接不给,不影响主流程)、但把 RAG 的可信度抬了一档。
七、每种格式的脏活:解析器内部分解
模块内部结构见图 7,左 Python 右 Go。这一节讲里面最值钱的几个实现——这部分代码注释密度极高,大量防御逻辑对应真实世界的损坏文件。
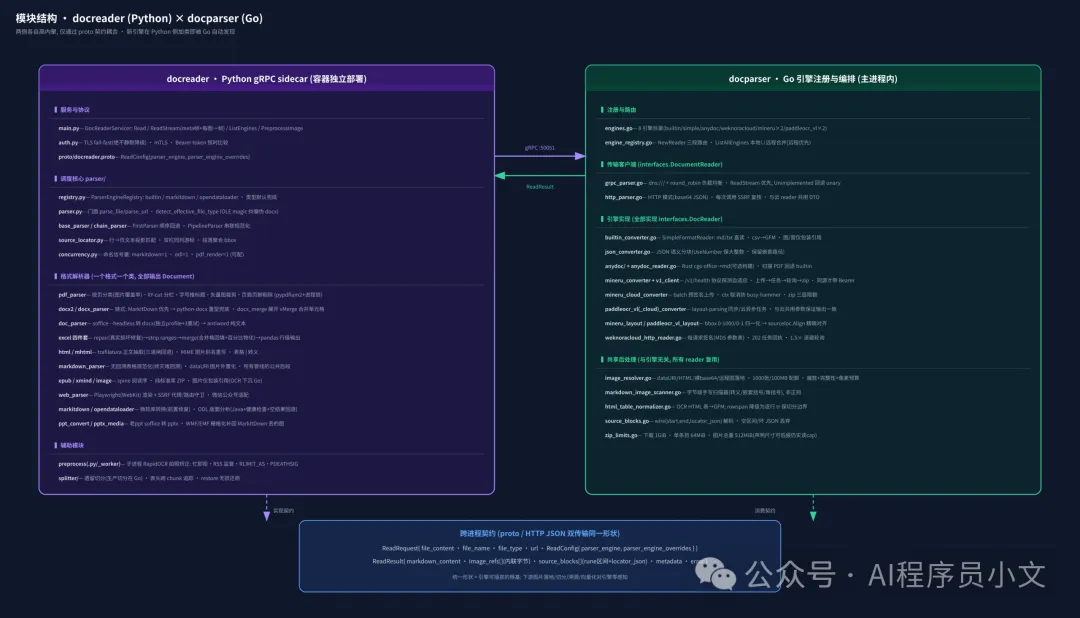
PDF:按页分类 + 几何版面重建
builtin 的 PDF 解析器(1786 行)不打模型,但做了三遍流水线:
第一遍逐页分类:是不是扫描页,主信号是图片对象面积覆盖率 ≥0.5(pdf_parser.py:175-207),次信号是文本少于 10 字且覆盖率 ≥0.1。用图片面积而不是字符数是有原因的——扫描件常带低质量内嵌 OCR 文本层,信任它曾经产出过乱码 RAG 内容,所以宁可当扫描页走 OCR(这个决策与 MinerU/Docling 的做法一致)。混合文档天然支持,第 3 页是照片第 4 页是文字各走各的路。分类完,扫描页渲染成 JPEG 输出成图片引用(DPI 200、质量 85、长边 2000px),标记 image_source_type=scanned_pdf 交给下游 OCR/VLM——docreader 自己从不跑 OCR。
文本页做几何版面重建:glyph 级取字框,XY-cut 递归切双栏,页边竖排水印栏丢弃,按 y 聚行,水平 gap 推断空格,字号相对中位数推 Markdown 标题(≥2 倍 H1、≥1.6 倍 H2、≥1.35 倍 H3,超过 40% 行都是标题就整体放弃)。最后一道保险叫 _should_prefer_plain:几何重建可能把内容弄坏,所以重建前后数字的多重集必须完全一致——每一个数字都得对得上,差一个就回退用朴素文本抽取。防的是几何重排把财务报表里的数字搬家,这种错误 RAG 场景是致命的。
另外几个细节:跨页重复页眉页脚要 ≥60% 文本页重复且页数 ≥4 才删(保守);矢量图表从 Figure N. caption 反推图区域裁剪渲染成 JPEG,插到 caption 前面供下游理解;arXiv 水印行、纯页码行、图内标签碎行、坐标轴刻度碎行各有专门的清洗规则;隐藏文本(render-mode 3)直接过滤——同时防了扫描件里预埋的隐形 prompt 注入。
工程上最关键的一笔是 pdfium 全局锁 + 多进程渲染:pdfium 非线程安全,并发 PDF 曾导致整个进程死锁,所以所有 pdfium 操作用一个进程级锁串行化,页渲染换 ProcessPoolExecutor 多进程绕开(forkserver 启动、每 worker 独立打开文档、失败回退串行)。非线程安全 C 库的标准处理范式:锁保正确性,进程池保吞吐。
DOCX:为什么有两代解析器
注册表里 builtin 的 docx 指向 Docx2Parser,而它的全部实现只有一行——_parser_cls = (MarkitdownParser, DocxParser)。这是个 FirstParser 链:先试 MarkItDown(快、表格好),空结果或异常再落到 python-docx 重型实现(多进程分页、按文档序组合段落和表格、图片按段落顺序交错)。两代并存由链式组合器刻意构造,形成快慢双路。chain_parser.py 里另一个组合器 PipelineParser 负责「转换 + Markdown 规范化」两段串联——HTML、网页、MarkItDown 的输出都要过一道 Markdown 规范化(表格对齐、dataURI 图片外置化),这个公共后段让所有管线的 Markdown 质量一致。
前置还有一层 docx_merge:Markdown 表格表达不了 rowspan,转换器遇到垂直合并单元格会把后续行丢成空。它在进库之前用 lxml 按 ZIP part 级把 vMerge=restart 主单元格内容深拷贝到所有覆盖行,重打包再交给 MarkItDown(lxml 解析带 resolve_entities=False, no_network=True 防 XXE)。MarkItDown 路径处理 xlsx 前同样先过修复管线,和 builtin 共用同一套 Office 预修复层。
门口还有个 detect_effective_file_type:WPS 常把老 .doc 另存成 .docx 扩展名,但文件头还是 OLE Compound File magic(\xd0\xcf\x11\xe0...)。按 magic 纠偏路由到 DOC 解析器,否则二进制内容进入 ZIP 解析器会直接报错。信任文件内容的 magic 而不是扩展名,这条规则适用所有二进制格式。
Excel:修复管线 + 百分比物化
Excel 四件套的打开顺序是 repair → strip ranges → fill merges → pandas,每一环都对应真实世界的损坏文件:
• repair_xlsx:sharedStrings.xml 路径不规范、manifest 引用了缺失 part——某些导出器的常见病;• strip_unreadable_ranges:dataValidation 的 sqref 是整列C:C或#REF!时 openpyxl 直接抛出 TypeError,导致整个工作簿无法读取(issue #3599),先用它自己的 MultiCellRange 试解析,不可读的元素删掉;• sanitize_xlsx_styles:styles.xml 里空<fill/>让 openpyxl 拒载(issue #3637,云文档/LabView 产出),等长 no-op patternFill 原位替换保持 fillId 引用稳定。修复永不抛异常——干净文件零成本通过。
fill_merged_cells_xlsx 把合并区域主单元格值复制到每个被覆盖格,不然 pandas 看到一片 NaN,行级 chunk 全丢上下文。顺带删图表 sheet(openpyxl 没有公开删除 API,直接清内部列表,属于脏但有效的解法)。
百分比物化是 opt-in 功能,规则精细:Excel 里存 0.6112 显示 61.12%,模型照抄就是 100 倍错误,开启后把百分比格式单元格改写成显示文本 "61.12%",只处理已知数字百分比模式(条件格式、缩放不动);还有「同行提示」回退——同行 ≥N 个百分比格时,同行的无格式 0<|v|<1 也按百分比读。必须在合并格回填之前跑,因为只有主格带 number_format,这类顺序约束在代码注释里都写明了。另外 =DISPIMG(...)、=_xlfn.IMAGE(...) 这类单元格内嵌图公式会被过滤——WPS 和 Office365 的函数,别的库读出来是一串噪音文本。输出形态是每行一个 chunk(列A: 值1, 列B: 值2),带 sheet 名+行号的定位器,行号是用户视角的行号。
HTML / 网页:守门式正文抽取
HTML 默认整页转换(nav/页脚都进索引,保持行为可预期),开了 DOCREADER_HTML_MAIN_CONTENT 才用 trafilatura 抽正文——而且抽取结果要过三道闸(html_parser.py:89-115):结果 ≥250 字符、≥全文 15%、没有重复正文块,全过才替换整页转换,否则回退。升级解析库时保持已有知识库的索引行为不变,这种兼容性约束是刻意的设计决策。
MHTML(浏览器单文件存档)走 MIME 解析:选最大的非广告 HTML part 为主文档,图片 part 抽出来 base64 存档并登记多种别名(Content-Location/Content-ID/cid:/URL 编码变体),再把 <img src> 重写到本地路径——别名表是因为浏览器保存时的编码花样太多。还要恢复邮件头里的 raw 8-bit UTF-8,否则别名匹配全挂。
网页导入(URL)用 Playwright WebKit 渲染(SPA 等待 networkidle + 可见文本 ≥80 字才算渲染完)+ trafilatura 提取,全套 SSRF 防护:URL 白名单校验、出站走黑洞代理、页面级路由守卫拦截每个子请求(页面里的图片和 iframe 也不能乱请求)。有一条铁律写在代码里:错误信息绝不作为文档正文进索引——抓取失败返回结构化错误,而不是把「404 Not Found」页面当文档存进去。还有微信公众号适配——monkey-patch trafilatura 的图片扩展名表和正文 XPath,因为公众号图片 URL 没扩展名(wx_fmt= 参数)、正文容器是 #js_content,patch 带守卫防止上游升级后静默失效。
其余格式的要点
EPUB 按 spine 阅读顺序处理章节(manifest 顺序不可靠),metadata 抽 Dublin Core 全套,图片全量外置;ebooklib 解析失败还有纯 ZIP 的兜底路径按 chapter(\d+) 排序。最近一个提交还在修外部图片引用保留的问题(#4676),这种长尾会一直有。
XMind 用纯标准库实现:ZIP 里读 content.json(新格式)或 content.xml(老格式),加密条目和超过 32MiB 的直接拒,递归渲染成 Markdown 嵌套列表,note 变引用块。不引第三方依赖,避免了一批供应链风险。
opendataloader 引擎每次解析起一个 JVM 进程跑版面分析,所以并发限流是 1、可用性探测要查 Java 和健康检查端点;结果太短(<20 字符)自动回退 builtin 的扫描 PDF 路径——版面分析服务不可用时,解析不至于整体失败。
markitdown 引擎进库前做格式前置修复(ppt 的 magic 检测和转换、docx 的 vMerge 展开、xlsx 的 strip+sanitize,全部复用 builtin 的修复层),PPTX 输出如果有未解析的图片占位符,还会用 python-pptx 按形状位置重走一遍把 WMF/EMF 矢量图栅格化补回来——MarkItDown 对矢量媒体只留占位符,直接用就丢图。
拍照矫正是独立的一套(docreader/image_preprocess.py + preprocess.py):思路很巧——不做页面检测模型,用 RapidOCR 检出的文本行几何恢复页面内容四边形:文本行角度做长度加权众数求主方向(在 mod-180 圆上做,避免 ±90 分裂)、过滤角度不一致的框、外支撑线拟合内容四边形、透视矫正、再靠「关掉方向分类器后正反两张的识别分数对比」判定 0/180 度翻转。跑在隔离的子进程池里:忙时立即拒绝(调用方保留原图)、RSS 内存超限即杀掉进程、RLIMIT_AS 硬限制、PR_SET_PDEATHSIG 在父进程退出时终止子进程、图片头先查像素上限防解压炸弹。探测在缩到 2000px 的图上做、裁剪却在原图坐标系做——防止缩放后小字变模糊。HTTP 传输模式不提供这个 RPC,直接回退用原图,调用方唯一回退路径不会产生失败日志。
老格式:LibreOffice 是绕不开的
.doc、老 .ppt、.et、WMF/EMF 矢量图,全部硬依赖容器里的 LibreOffice 和 ImageMagick。soffice 转换有三个坑都有标准解法:并发 profile 锁(每次独立 -env:UserInstallation 临时 profile)、偶发挂起(超时后强制终止进程组,POSIX 下 start_new_session + SIGTERM→SIGKILL)、外联风险(子进程全部走黑洞代理 http://128.0.0.1:1)。.doc 的兜底链是 soffice 转 docx → antiword 纯文本(丢图丢表,保底有字);textract 路径因为 SSRF 漏洞被注释禁用了——留着一个 import 但不用,代码考古时能看出取舍痕迹。
远程引擎的防呆
MinerU 自部署客户端每次请求先打 /v1/health 探测协议版本(200 是 V1、404 是 legacy、503 翻译成「模型预载中」),MinerU 原地升级不用改配置。V1 上传走对象存储预签名 URL,只有目标 URL 与配置 endpoint 同源(scheme+host+有效端口)才带 Bearer——把 API Key 附到第三方预签名 URL 上是真实发生过的事故类型;下载重定向跨主机时 Go 自动丢 Authorization,302 到 CDN 不会泄 key。等待失败会用新鲜 context 尽力 DELETE 任务,不让服务器继续烧 GPU。云 API 轮询循环每轮先查 ctx.Err(),不然取消后会 busy-hammer 云接口刷爆日志直到 deadline。zip 结果包三层限额:下载 1GiB、单条目 64MiB、图片总量 512MiB,而且声明尺寸不可信(攻击者或厂商都可以低报),解压时仍然按实际读取 cap——LimitReader(limit+1) 读满再多读一字节的技巧用来区分「恰好达限」和「超限」。
八、如果你要自己搭一个,抄哪些作业
按从零搭一个 RAG 解析模块的顺序给清单。前提假设:已有一个任意语言的主服务,要给它加「上传文档 → 可检索」的能力。
第一优先级(没有它们系统立不住):
1. 契约先行。先定义你的 ReadResult 等价物(正文 + 图片 + 位置 + 元数据 + 错误),让它成为跨引擎、跨进程的唯一形状。WeKnora 整个可插拔体系就建立在这一个结构上。反例是每个引擎各自返回格式,下游全是 if-else,每加一个引擎改一遍全链路。 2. 引擎注册表 + 类型默认兜底 + 可操作报错。注册表核心就 50 行:name → {文件类型 → 解析器}。兜底链「请求引擎 → 类型默认 → 内置 → 报错并列出可用引擎」照抄 registry.py的结构。报错信息要能让运维直接知道改哪个配置。3. 异步流水线 + 幂等重试。HTTP 请求内只做校验和入队,解析放队列。重试必须幂等(先删后建),且只有最后一次重试才把失败落到用户可见的状态。死信要落表,回调翻转状态,两者必须成对出现。 4. 统一图片入库。解析器只报图片字节,存储统一由主服务做(权限、配额、URL 生成都在一处)。记得配额和失败回滚,不然悬挂对象会慢慢吃掉你的存储账单。
第二优先级(决定好不好用):
5. 三层配置:实例级连接参数 / 知识库级按类型路由 / 单次上传覆盖。WeKnora 的映射「租户管连接、KB 管路由、上传管覆盖」职责分得很干净,借鉴时注意保持职责分离。 6. 按文件类型选引擎的规则结构( ParserEngineRules),而不是一个知识库一个引擎。真实语料天然是混合格式。7. PDF 按页分类路由。图片面积覆盖率做主信号,扫描页交给 OCR 链路,文本页走文本抽取。这一个决策让混合文档不用用户手动选模式。 8. 流式传输(如果你的图片量大):meta 帧 + 每图一帧。哪怕不用 gRPC,HTTP 分块或多条响应同理。单消息上限和峰值内存这两个问题迟早会找到你。 9. 溯源协议:解析时顺手记 rune 区间 → 位置,切分时按区间分配到 chunk。成本极低,收益是引用可信。bbox 用分数坐标(0-1),任意缩放都能画框。 10. 状态机显式建模 + 阶段时间线:不要用一个 status 字段加一堆 flag 拼凑。finalizing 式的「主结果就绪 + 富集在途」状态实现成本低,对体验的提升明显。
第三优先级(规模上来之后): 死信表 + 回调、卡死扫描(心跳表)、attempt 版本号防旧任务覆盖新数据、finalizing 子任务计数器、安全清单(SSRF 校验所有出站 URL、zip 三层限额、图片魔数+像素预算、TLS fail-fast、子进程黑洞代理)、Langfuse/OTel tracing。
测试策略单独说一句:docreader 的 tests 目录是一份重要资产——每个解析器对应一个测试文件,还有专门生成 fixture 的脚本(generate_issue_2634_fixture.py 这种,issue 号直接进文件名)。修一个真实世界的损坏文件,就把它变成 fixture 进版本库,回归永远跑。这个习惯比任何解析技巧都重要。
最后给出一张最小架构的拼装清单:契约结构体 ×1(正文/图片/位置/元数据/错误)、注册表 ×1(五十行)、引擎 ×2~3(内置文本直读 + 内置 PDF 基础解析、一个版面分析、可选一个云)、异步队列 ×1(Asynq/Celery/自研都行)、幂等 worker ×1(先删后建)、图片入库器 ×1(含配额与回滚)、切分器 ×1(带表格保护)、状态机 ×1(五个状态够用:pending/processing/failed/completed/cancelled,finalizing 可以后加)、溯源块 ×1(可选但强烈建议)。这九件套就是 WeKnora 解析模块抽掉血肉后的骨架,剩余工作量全部是往骨架上补防御代码,防御的完整度决定解析模块在真实语料上的可靠性。
可以不抄的:6 个 worker 池(单队列起步够用)、11 个引擎(builtin + 一个版面分析引擎 + 一个云引擎,三个能覆盖绝大多数场景)、双语种双切分器(WeKnora 保留 Python splitter 是历史兼容,新项目无需效仿)、XMind/MHTML 这类长尾格式(等真有用户要再写)。
收尾
回到开头那三份文件在 WeKnora 里的下场:扫描合同被 PDF 按页分类路由成页图、走 OCR/VLM 链路,引用能定位到第 14 页的 bbox;假 .docx 被 OLE magic 纠偏、soffice 转换、vMerge 展开后变成完整表格;销售报表过了修复管线、合并格回填、首行作表头后按行切成 chunk,百分比列可以选择物化成显示文本。
这套系统当然不是完美的。老格式对 LibreOffice 的硬依赖意味着镜像小不了,make build 拉依赖的网络问题在它的 Dockerfile 里留了一堆重试逻辑(最近几个提交都在修这个);百分比物化默认关闭,多数部署享受不到;docx 双代解析器和 Python/Go 双切分器都是迁移中间态的维护税;anydoc 要 Rust 工具链才能编,多数人拿到的构建里它就是不可用状态。但把这些放在一起看,它对「真实世界的脏文件」的容忍度在我读过的开源 RAG 里最高——解析模块的可靠性取决于愿意为 0.1% 的畸形文件写多少行防御代码,接入的模型强度只决定起点。
下一篇计划拆解它的切分策略(父子 chunk、表头追踪、上下文面包屑)和多模态检索(图片向量化、image_ocr/image_caption 子块、视觉问答上下文),这两块和解析咬合得很紧。
生产环境里扫描件和表格的处理如果有不同做法,欢迎交流——这两块目前还没有公认的最优解。