ARTICLE · 1270462
Oracle 导出的 Excel 一打开就卡死?212MB 的报表,8 秒变真 Excel
上个月有个下午,我在 Oracle 里点了一次导出,格式选的 Excel。
得到一个文件,扩展名 .xls,图标是 Excel 那片绿。
双击。
转圈。
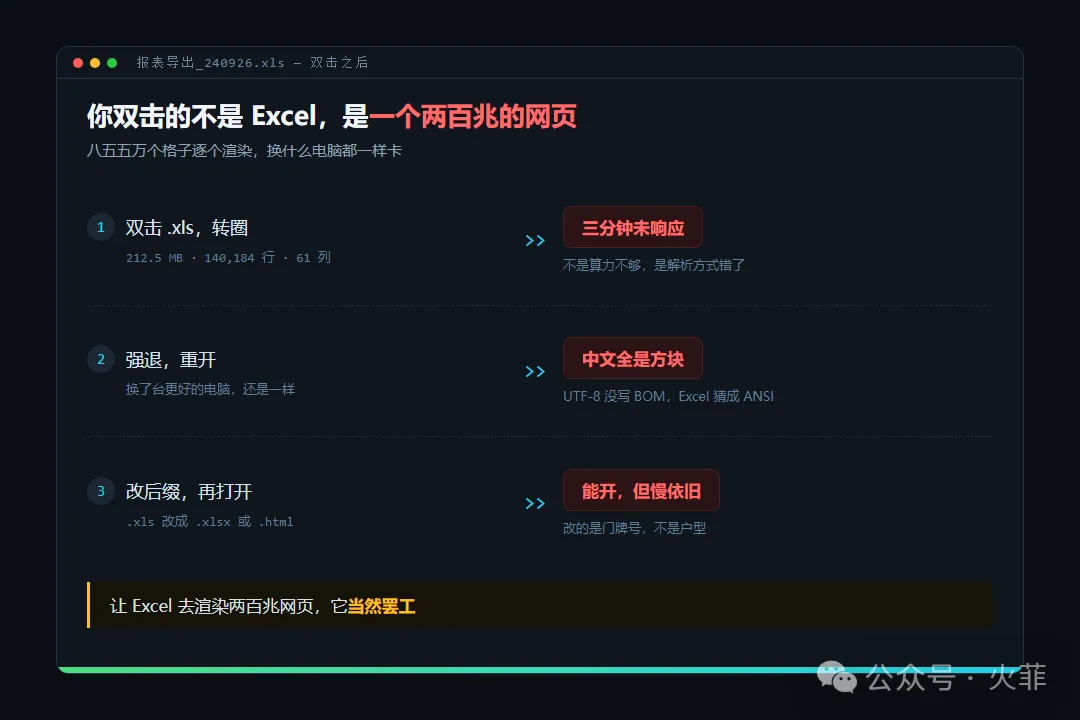
转到第三分钟,标题栏后面多出三个字:未响应。
强退,重开。
这次开了,中文全是方块。
以前我会以为是自己电脑不行。
这台是 i5 十三代,十六线程,固态硬盘,跑什么都够。
问题不在电脑。
那东西从生成的第一秒起,就不是 Excel。
这篇讲三件事:它到底是什么,为什么改后缀没用,以及一份 212.5 MB 的报表怎么在 8 秒内变成真能筛能算的 xlsx。
一、你打开的不是 Excel,是个网页
用记事本打开那个 .xls,第一行是 <html>,接着是 <table>,一行行 <tr>,一格一格 <td>。
扩展名写着 .xls,内容是网页。
这不是哪个版本没修好的 bug,是这类系统早年的习惯:报表页面上显示的就是一张网页表格,你要导出,它就把这张表原样存给你。
一份 212.5 MB 的报表,我数过:八成体积是尖括号和属性,真正的数据不到两成。
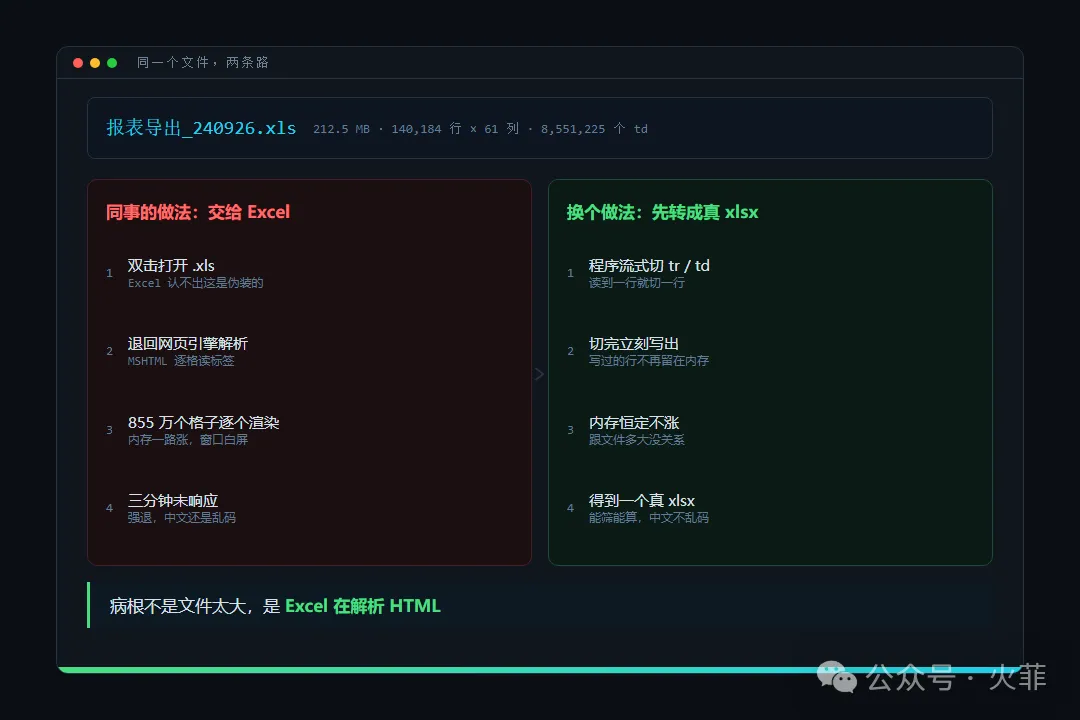
Excel 拿到这种文件,认不出是伪造的 xls,于是退回网页引擎,把这两百兆标签一个个解析成单元格。
这份报表 140,184 行、61 列,一共 8,551,225 个格子。
八百五十五万个格子,一个一个渲染。
这解释了两件事。
一是换多贵的电脑都一样卡。
卡的不是算力,是解析方式。
二是中文会变方块。
文件是 UTF-8 存的但没写 BOM,Excel 猜编码,猜成了本地 ANSI。
BOM 是文件开头三个看不见的字节,专门用来告诉程序「我是 UTF-8」。
省了这三个字节,后面全靠猜。
猜错的后果不是乱码两个字这么轻。
一份六十列的报表,列名全变方块,你连哪列是金额都认不出来。
一句话:让 Excel 去渲染一个两百兆的网页,它当然罢工。
那这文件到底长什么样?
我从项目里的样例文件截了一段出来,去掉内容只剩骨架,是这样:
• 每一个单元格写成 <td align=left>内容</td>,光这对标签就 20 个字节• 整行再包一层 <tr>,行尾还有换行• 表格前面还有 <style>、<title>、几行<BR>参数,都跟数据无关
拿这 20 字节算一下:855 万个格子 × 20,标签本身占掉约 163 MB。
而整份文件 212.5 MB。
也就是说,真正的内容只剩不到五十兆,标签占七成半上下。
实测下来,约八成体积都是标签。
Excel 不是读不懂,是它太老实了:你给它标签,它就一个一个认真渲染。
顺便说个细节,这个细节后面会咬人:样例的样式表里定义了一个 .amount,规则是 mso-number-format:Standard,意思是「按数字显示、右对齐」。
可这份样例里没有任何一个格子引用它。
也就是说,生成这份报表的那套模板,本意是要把金额列当数字处理,只是没套上。
而真正被标了 align=left 的那种编码列,值是 11.020,一个物料分类编码。
Oracle 认它是数字,你的业务认它是编码,两边从文件生成那天起就打架了。
二、三条省事的路,全是死胡同
同事们早就自己发明了办法。
最常见的一条:改后缀,把 .xls 改成 .xlsx。
改完确实能打开,然后呢,还是慢,还是乱码。
因为改的是门牌号,不是户型。
Excel 照样按 HTML 解析,一分钱没省。
第二条:换电脑。
我见过有人为这个申请加内存,十六 G 加到三十二 G,卡的时间从三分钟变成两分半。
第三条:写脚本读。
让 Python 把数据读出来再写成 xlsx,听着对,做起来死。
pandas 的 read_html、BeautifulSoup 这类库,会把整棵 HTML 树建成对象放进内存。
八百五十五万个格子,每个变成一个对象。
普通办公机要么内存溢出,要么卡到你以为死机。
看出来了吗,这跟 Excel 打不开是同一个病:一次性把整个文件吃进内存。
三条路都通不了,剩下的方向只有一个:不要一次性读。
边读边切,切出来就写走,内存不跟着文件长大。
这个思路叫流式。
说人话就是:不把整本书搬进屋子再看,而是站在门口一页一页翻,翻完一页记下要点,把这一页扔掉。
书多大都无所谓,屋里永远只放一页。
落到这个工具上:程序读到一行,切出这行的格子,立刻写进 xlsx,然后把这一行放掉;写 xlsx 的库还有个常驻内存模式,连写过的行都不留。
两端都不攒东西,内存就能一直稳着。
实测跑完整份两百多兆,内存曲线几乎是平的。
这比速度更值钱:速度慢你还能等,内存爆了程序直接死,前面转的全白搭。
三、我给它下了三句话
这次动手的不是我,是 OpenCode。
分工还是那套:我是产品经理,它写代码。
需求单三句话:
1. 把这种 html 报表转成真正的 xlsx,内容跟原文件一个字符都不能差; 2. 两百多兆的不能卡死,内存不能被文件大小带着涨; 3. 做好之后双击就能用,不能让财务同事去装 Python、开命令行。
第一句锁死保真,第二句锁死流式,第三句锁死交付形态。
三句话没一句在讲怎么实现,但每句都在排除一种错误的实现。
我原本以为它会先写转换循环,它先做的是确认病根:拿一份真实报表读出来看结构,确认这就是 html 表格,确认编码是 UTF-8 无 BOM。
这一步决定了后面所有设计。
病根是「Excel 在解析 HTML」,解法必然是「别让 Excel 干这活」;如果判断成「文件太大」,后面就会去压缩、分片、加配置,全走偏。
四、第一道险情:那 1 万多个尾零
第一版跑通了,速度可以,数据也对得上。
然后我看着满屏数字动了念头:这些格子都是文本,在 Excel 里不能排序不能求和,要不顺手把像数字的都转成数值?
这是大多数人第一次做这类工具都会加的功能,看着很贴心。
OpenCode 没直接加,它先数了一遍。
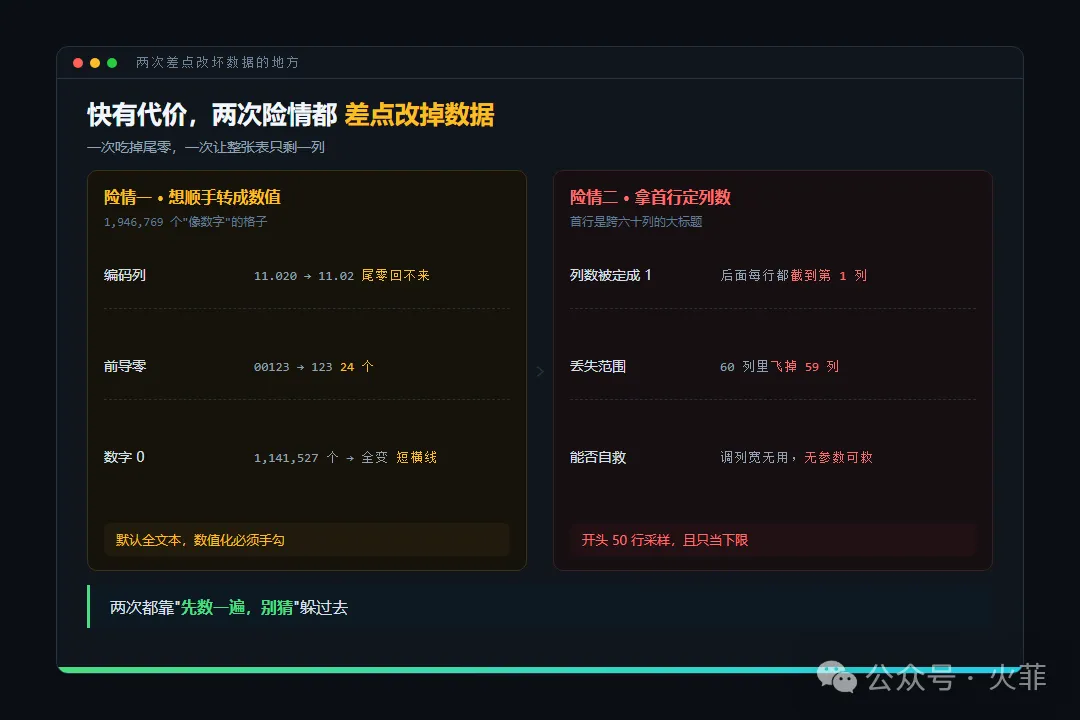
这份报表里看起来像数字的格子有 1,946,769 个,其中三类不能碰。
一是编码列。
库存分类写着 11.020,它是编码不是数量。
转成数值,末尾那个零当场消失,变成 11.02。
而且回不来。
Excel 的数字格式只管显示,管不了存值。
这样的格子有 10,505 个。
二是前导零,00123 这种,转成数值是 123。
24 个。
三是 0。
表里有 1,141,527 个 0,套上会计格式全显示成一条短横线;而这张表本来就有 360 万个真正的空格子。
满屏短横线,你分不清哪个是零、哪个是空。
结论很干脆:数值化默认关闭,所有格子按文本写,跟源文件逐字符一致。
想要数值,界面上有个勾选框,旁边写着代价。
为什么不干脆删掉这个选项?
因为确实有人要做透视、要排序。
你不给,他就用别的工具硬转一遍,那时更没人提醒他尾零的事。
留着,但把话说清楚。
界面上那行提示是:勾选后数字列可排序求和,编码类列会被改写。
快不是唯一指标。
改错了还看不出来,才是最贵的错。
五、第二道险情:整张表只剩一列
第一版发出去试用,回来一条反馈:有几种报表,转出来只有第一列有内容。
我以为数据丢了,打开源文件一看,数据好端端都在。
问题在列数怎么定。
第一版拿表格第一行定列数。
这条假设在大多数报表上成立,第一行就是表头。
但有些报表不这么长:第一行是个大标题,一个格子横跨六十列;第二行是参数,期间、组织、币种;真正的表头在第三行。
程序看到第一行只有 1 个格子,于是认定这张表只有 1 列。
后面每行都被截到第 1 列。
六十列的数据,五十九列当场蒸发。
更难受的是,没有任何参数能救。
调列宽没用,列宽是显示,列数已经定死了。
改法有三个方向。
自动跳过标题行?
聪明但危险。
程序凭什么判断哪行是标题,跳错了连数据行一起跳。
全量预扫找最宽那行?
最稳,但要把它多读一遍,实测 8.4 秒变 13 秒,慢五成。
最后落地的是第三种:只看开头 50 行,取其中「最右非空格」的最大列数,而且只当它是「至少这么宽」,不当上限;后面遇到更宽的行,列数当场扩。
不预扫所以不慢,遇见宽行所以不丢。
这个取舍承认了一件事:采样是猜,兜底才是保险。
宁可多占一列,不能少一格。
这条反馈还有个额外价值:它来自一份我这辈子不会拿到的报表。
我自己测一百遍那份 212.5 MB 的大表也测不出来,因为那份表首行就是表头。
测试数据越干净,越容易漏掉脏数据的问题。
六、8 秒是这么来的
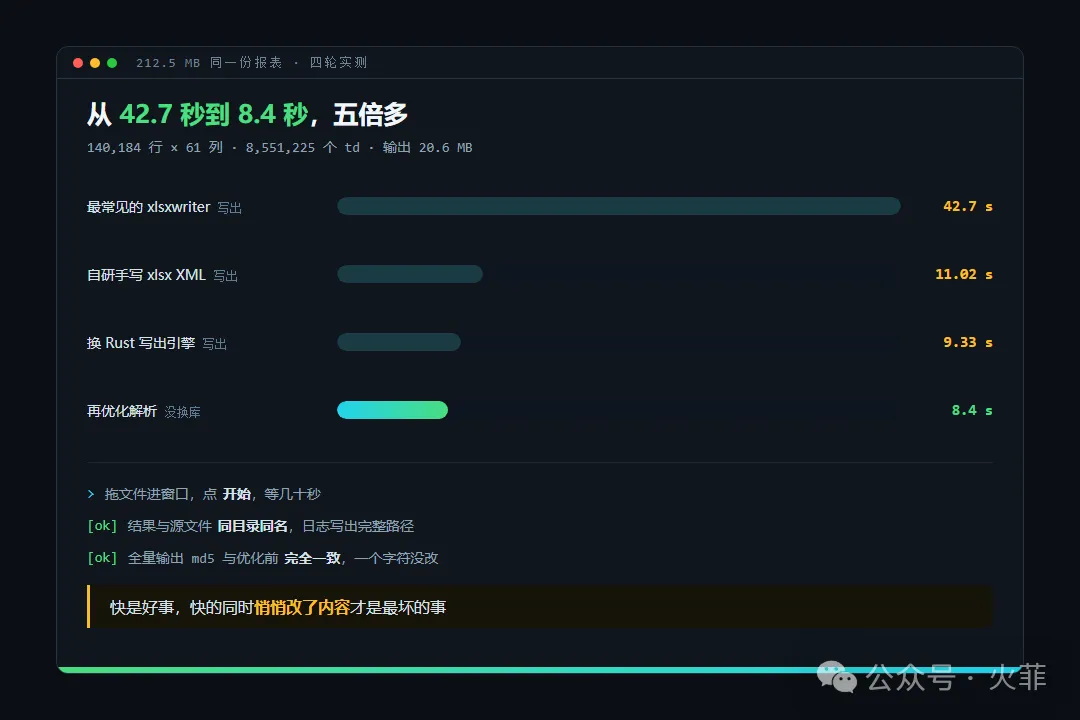
同一份 212.5 MB、140,184 行、61 列的报表,四轮实测:
真正有意思的是最后一步,因为它没换库。
解析代码改了两处:读单元格原本是一个个匹配取内容,改成一次扫描把整行的格子全取出来;找行尾原本从头往后比,改成从缓冲区尾部往前找第一个候选再验一次。
都是很土的办法。
纯解析从 5.62 秒降到 4.35 秒,端到端从 9.5 秒降到 8.4 秒。
改完我做的第一件事不是看时间,是把输出文件全量算一遍 md5。
跟优化前一模一样,一个字符都没改。
这一步不能省。
快是好事,快的同时悄悄改了内容,那是最坏的事。
上期我写过一句:那个 212MB 的项目同时用着两个引擎,就是这篇里的东西。
Rust 那边只吃字典、列名必须唯一、只能做一张表,所以程序默认走 Rust,遇到要分表就自动退回内置引擎,日志里写明为什么退;表头重复时把第二个「存储期限」改成「存储期限_2」,但日志会写出原名。
名字可以改,得让你知道改了哪个。
七、最后一公里:让人敢双击
技术问题平了,需求单第三句还悬着。
财务同事不会开命令行,不知道什么叫 pip install。
你发个 py 文件过去,等于没做。
这一步是打包:把整个包编译成一个 730 KB 的 pyd,外面套一层运行时目录,双击 exe 就出窗口。
这里有个反直觉的地方:那 730 KB 里装的是全部业务代码,可交付目录加起来七十多兆。
为什么?
因为 Python 解释器本身就在里面。
runtime 目录 20 MB,PyQt6 加 xlsxwriter 53 MB。
你不是发给同事一个脚本加一堆库,是发给他一个能自己跑起来的整套环境。
他那边什么都不用装,不用管 32 位 64 位,也不用在环境变量里折腾。
代价就是这七十多兆得跟着工具走。
我算过,比起让他花一下午配环境,这个代价很划算。
打包这块踩的坑比转换本身还多。
第一次打出来的包里,一运行就报「找不到模块 html_to_xlsx.core」,因为编译参数少了一个开关,子模块根本没被编进去。
还有一次,验收脚本先建了一个界面对象,再调主函数,程序直接崩溃退出,连报错都不给,屏幕上一片空白。
排查了半天才发现:Qt 不允许一个进程里有两个应用对象。
后来把主函数改成「有就复用、没有才新建」,才算稳。
编译成 pyd 还有个副作用:源码看不见了。
对内部工具不算坏事,同事不会不小心改到某个数字;反过来,以后要修 bug 也只能在你自己机器上改、重新编译。
界面只有三样东西:拖文件的地方、一个开始按钮、一块日志。
原来有个「输出格式」能选 xlsx 和 csv,删了,固定 xlsx。
多一个选项,就多一次「我该选哪个」的犹豫,而这个问题没有意义。
转换完成的弹窗,默认按钮从「关闭」改成「打开文件」:人转完文件,下一秒想看的就是那个文件。
验收那天把测试全跑了一遍,72 个全过,包括界面的离屏测试。
现在同事把文件拖进窗口,点开始,等几秒到几十秒,完事。
结果跟源文件同目录同名。
原来双击一次等三分钟还可能白等,现在双击一次,等一杯水的时间。
八、三个判断
第一个:先认清病根,再决定用不用力。
最开始我以为问题是文件大。
按这个判断走,我会去压缩、去分片、去申请更好的电脑,全是白费。
病根是 Excel 在解析 HTML,认准这一句,后面每一步都顺。
下次你被一个「就是很慢」的问题卡住,先花十分钟问:慢在哪一步。
第二个:数据保真优先于功能花哨。
默认全文本这个设计当时看着保守,现在我觉得它是这个项目里做对的最重要一件事。
程序分不清编码列和数值列,那就别猜。
猜对了没人夸你,猜错了没人发现,等发现了已经过了三个月。
第三个:让工具自己承认边界。
Rust 只做单表,就在日志里说;表头被改写,就写出原名;中途取消,就把半成品删掉。
这些都是「我不行」的坦白。
可靠不是永不出错,可靠是出错的时候,你立刻知道错在哪。
回到那个下午。
Oracle 里点导出,得到一个 .xls,双击,转圈,三分钟,未响应。
现在这个流程是:点导出,把文件拖进一个窗口,点开始,八秒,一个真 xlsx,能筛能算能排序,中文不乱码。
中间没有一步需要懂技术。
这就够了。
在公众号对话框回复【资料】,领取《AI 办公工具清单》。
📚 往期回顾
• Excel 处理为什么首选 openpyxl,不用快 10 倍的 Rust 引擎?20 万行实测 • AI 写的脚本,你的电脑却跑不了?装个 Python:5 分钟装好,避开 3 个坑 • ima 知识库怎么让 AI 直接用?装个技能,资料自己读、报表自己写
如果你觉得这篇有用,点个「赞」和「在看」。
也欢迎「转发」给那个每月导完报表、还在对着转圈发愁的同事。
留言区聊聊:你们系统导出的「Excel」,打开要等多久?
① 几秒钟 ② 一两分钟 ③ 直接卡死,早就不指望了