ARTICLE · 1271026
三个AI工具, 一条30秒片,两个小时,从零到发视频号
拍条片子,得有团队、设备、预算
三个AI工具,一条30秒片
两个小时,从零到发视频号
脚本 · 定妆照 · 分镜提示词 · 剪映 · 视频号
案例:地板上一摊水
📦 5 Parts + Conclusion
👉 滑动
PART 01
先定钩子
脚本先行
PART 02
角色一致
定妆照
PART 03
生成提示词
脚本转提示词
PART 04
剪辑两件事
剪映
PART 05
封面标题
发布
PART ///
写在最后
领文档
做完这条片子,我最大的感受是——
AI 没有让拍片变简单,只是把门槛从「会不会」挪到了「想不想」
昨天我把一条 30 秒的萌宠短片,从零做到发布。全片没有一台摄影机、没有一个演员、没有一间真的客厅。
客厅是生成的,猫和狗是生成的,连桌上一杯牛奶的热气都是生成的。真正花掉时间的部分根本不是「生成」,而是想清楚要讲什么——生成只要几十秒,想明白要花掉大半时间。
这篇把整条流程拆开给你看:用了哪三个工具、每一环的提示词怎么写、哪几个地方最容易翻车、最后怎么发到视频号。都是刚踩过的坑,不吹。
先看成片,再拆流程
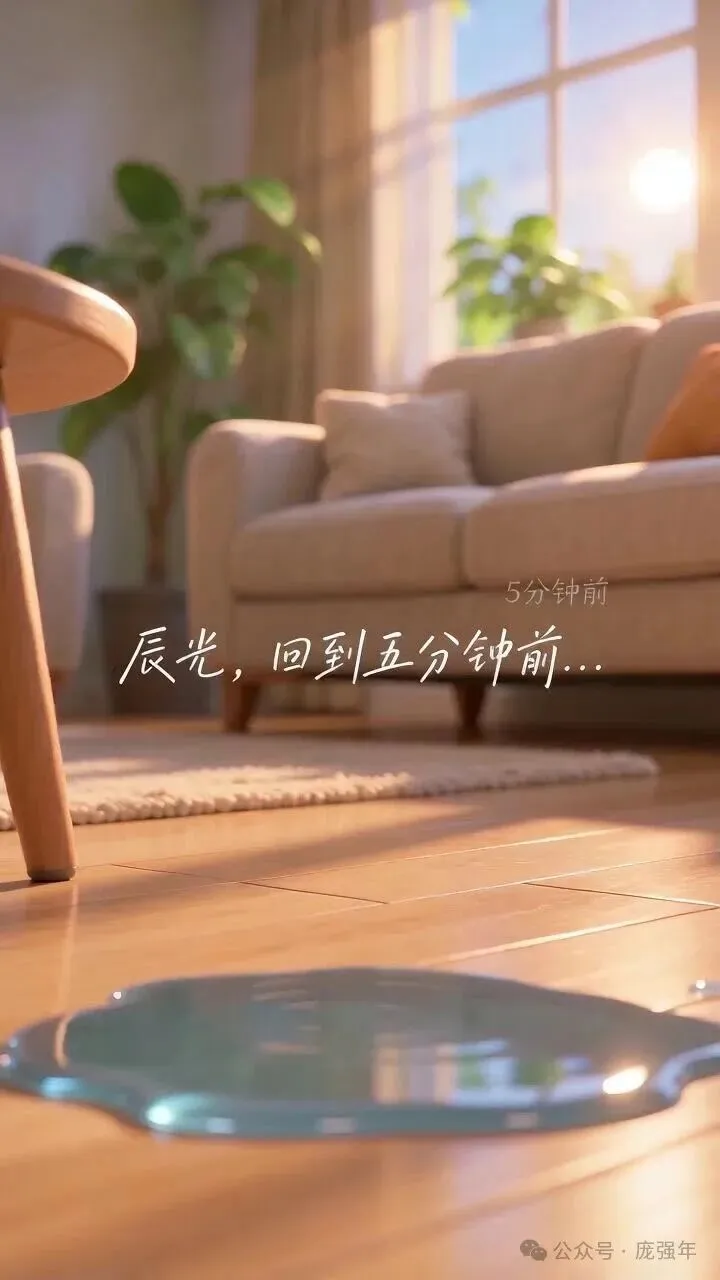
第 01 段 / 0—10s
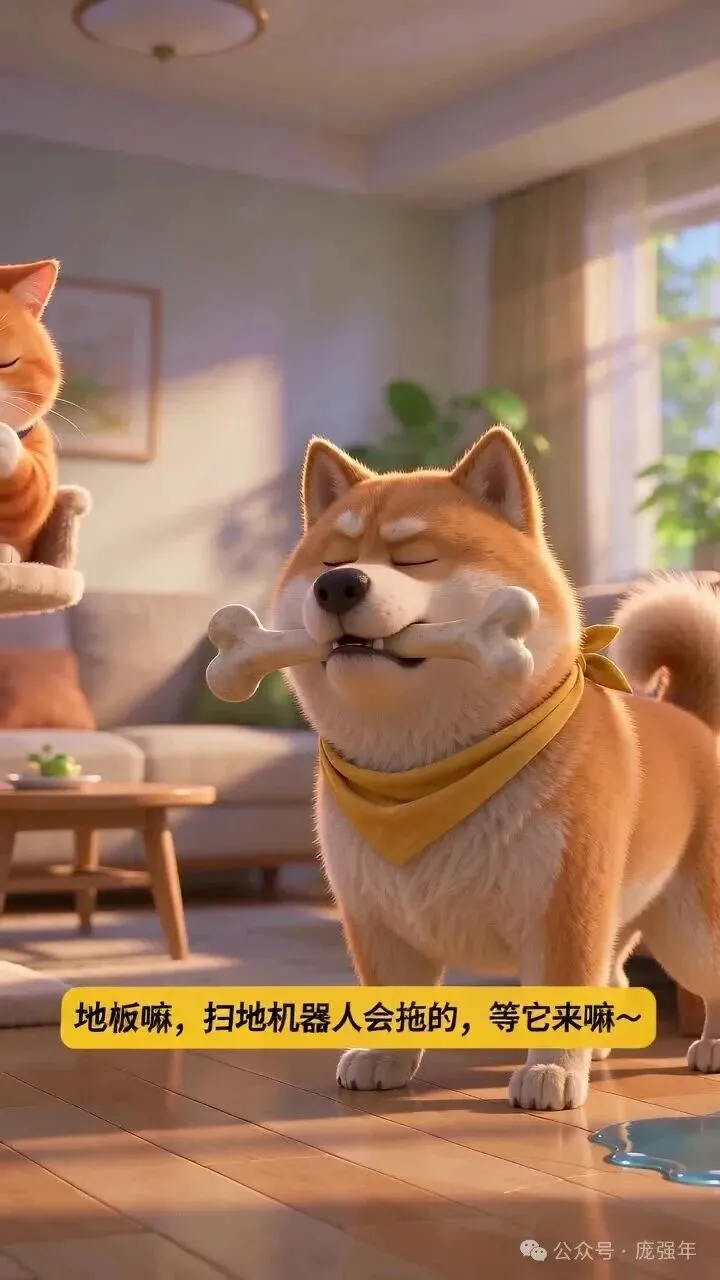
第 02 段 / 10—20s
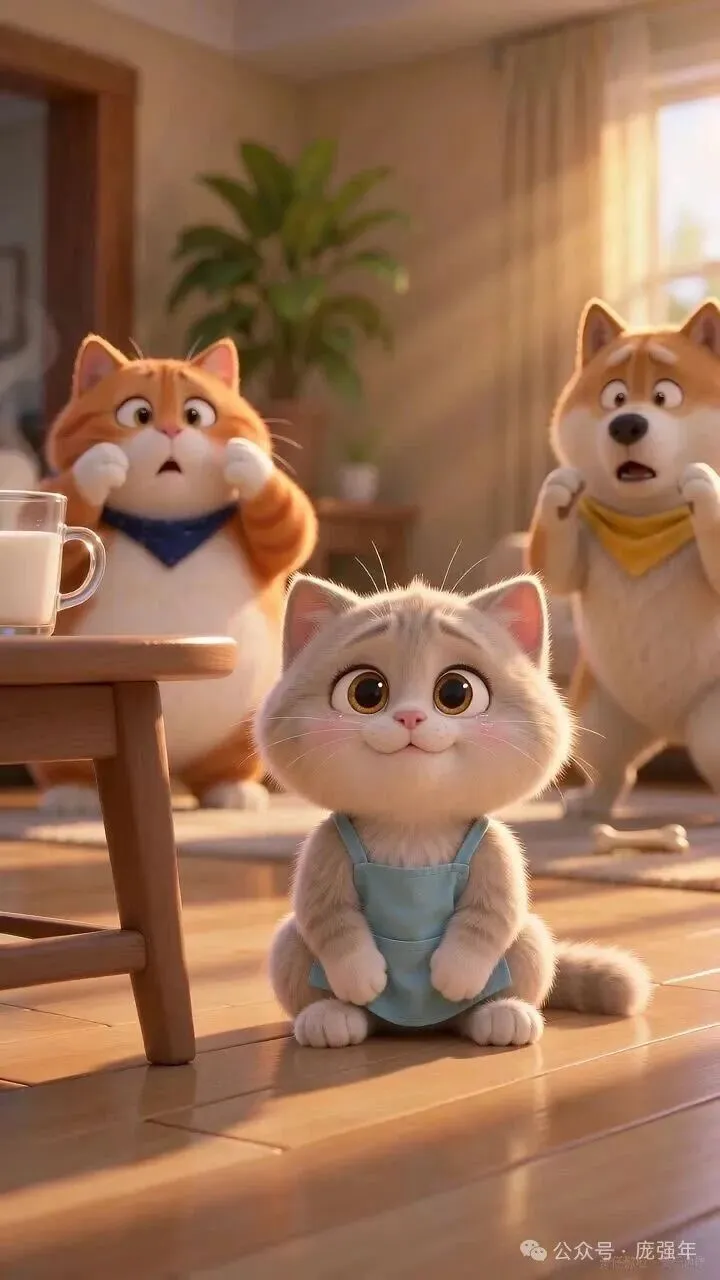
第 03 段 / 20—30s
三段成片,各 10 秒拼接。下面逐段拆。
01
PART
先定钩子,再打开软件
SCRIPT · 30 秒只够讲一件事
我选的题是责任边界模糊:客厅地上一摊水,橘猫等柴犬管,柴犬等橘猫管,谁都不动;学步的宝宝摇摇晃晃就要踩上去,最后是家里最没存在感的小奶猫默默把事办了。
萌宠负责让人愿意点,宝宝负责让人不敢划走,一句上海话负责让人记住。三种情绪,在 30 秒里各有各的位置。
3 段 × 10 秒,结构定死
唯一不能妥协的是开头三秒。视频号里划走的动作发生在第 2 秒,所以第一段我根本没铺垫水从哪来,直接给「脚已经抬起来、下面就是一摊水」的瞬间。
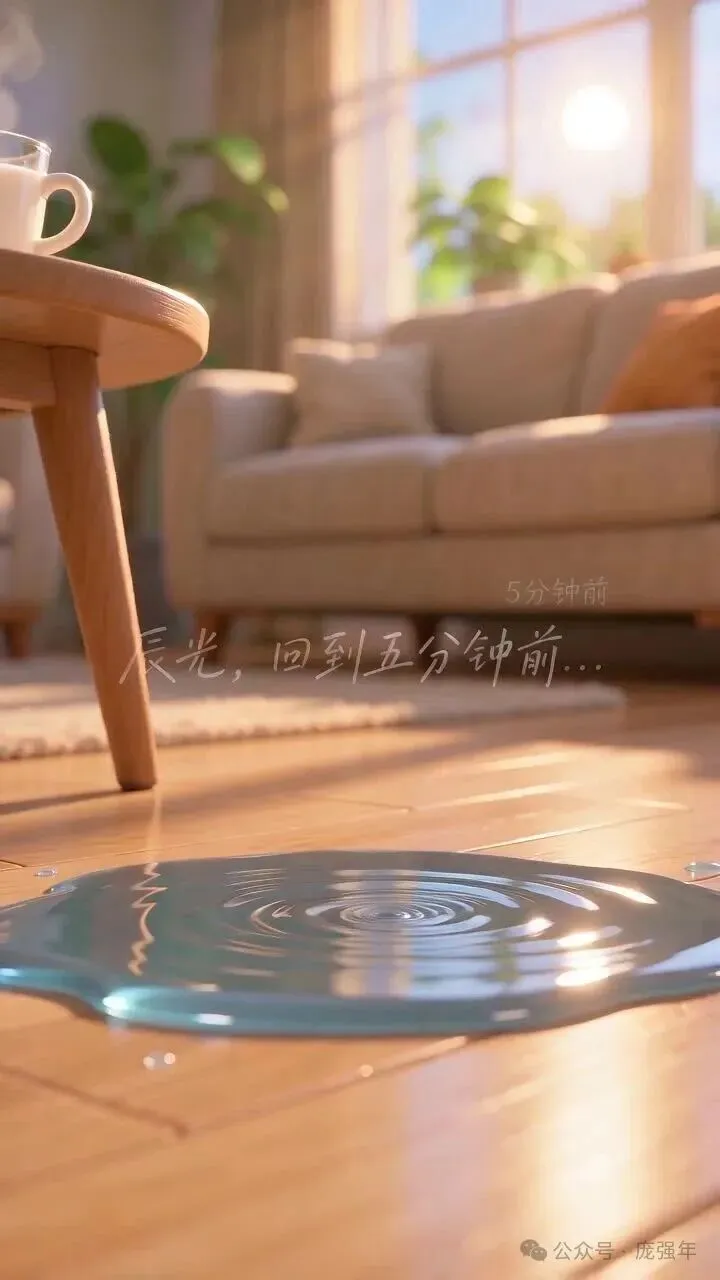
第 1 段的第 2 秒:脚还没落下,字幕已经压上去了——这行字是即梦直接烧进画面的,剪不掉。
✦ 一个能省很多时间的小习惯
写脚本时把每一秒标出来,别写形容词。「温馨的客厅」是形容词,「水摊在画面右下角、猫从右往左绕过去」才是指令——后面写提示词时,你会发现台词早就帮你写好了一半。
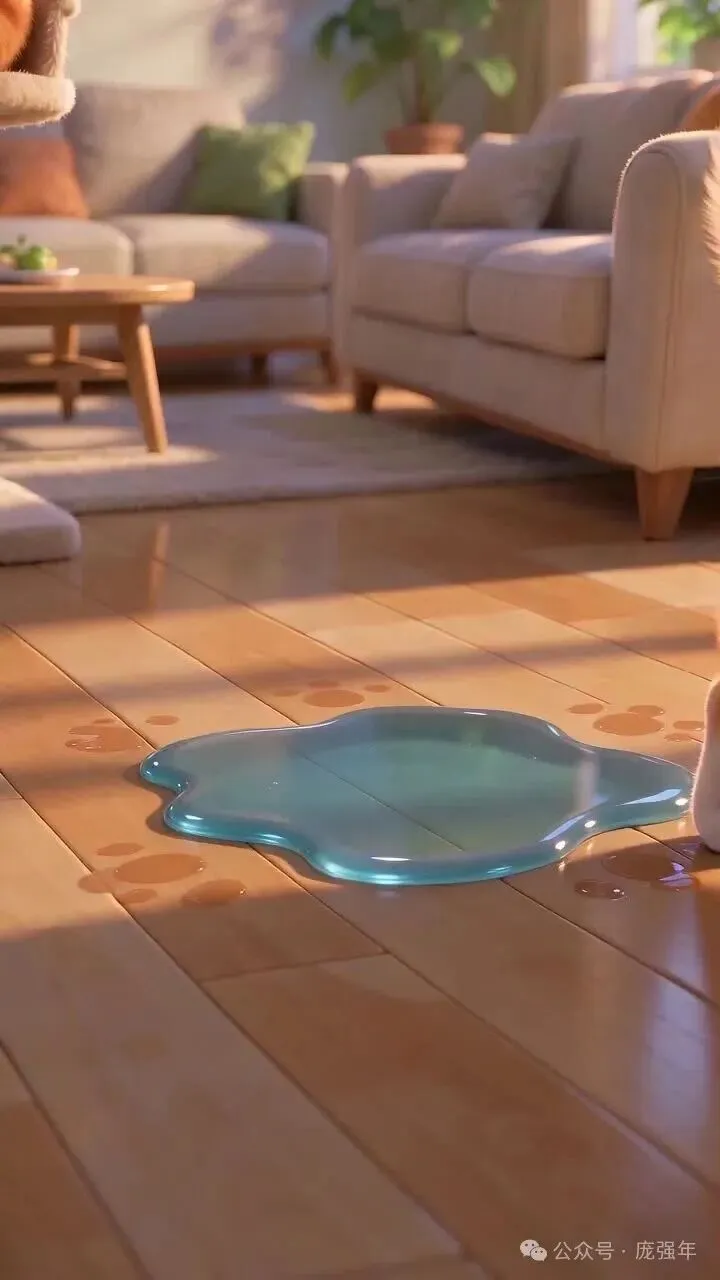
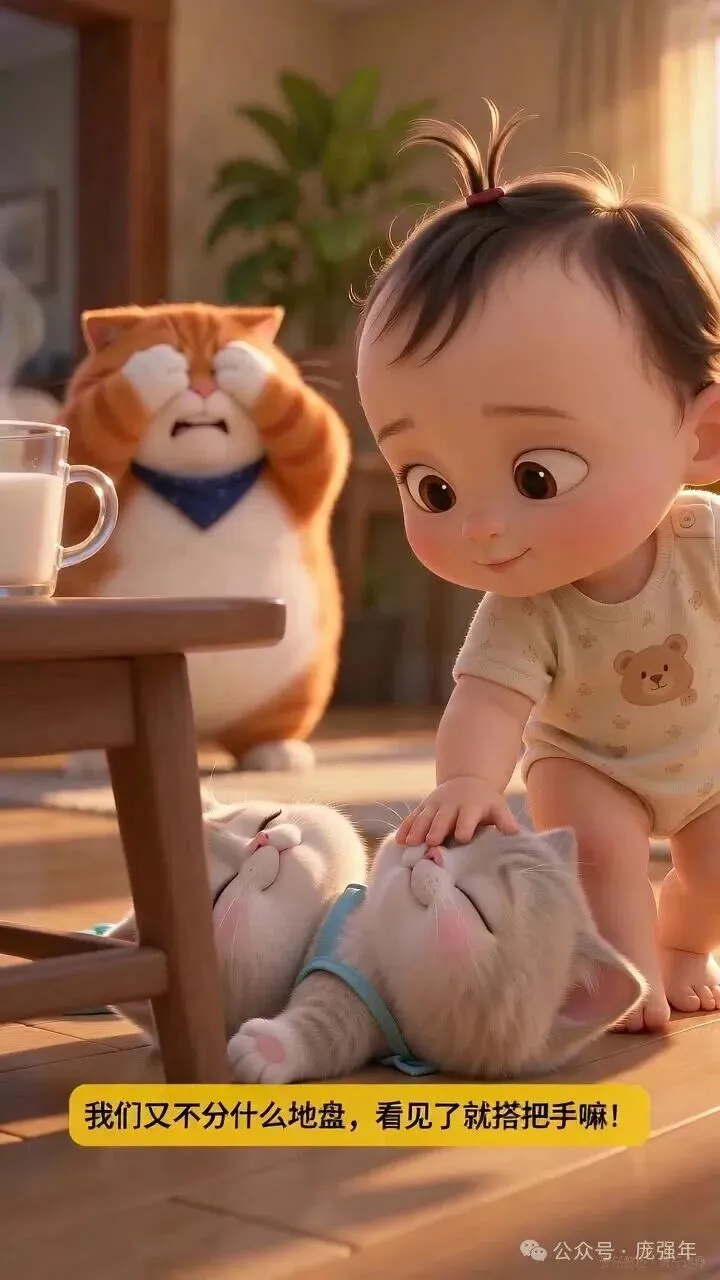
第 2 段里水摊越晕越大,旁边一圈绕开的爪印——不用一句台词,观众自己就看懂了「没人管」。
02
PART
角色一致性,是第一道坎
CHARACTER · 先把脸定下来
AI 视频最劝退的不是画面不好看,是同一条片子里,主角长着三张不同的脸。解决办法很土:先出定妆照。
四个角色,四张正面全身照
橘猫阿橘、柴犬阿柴、小奶猫囡囡、学步宝宝。全部用同一句风格前缀生成,光从右侧窗户进来、暖黄夕照、浅木地板——光位统一,是后面所有镜头能拼在一起的前提。
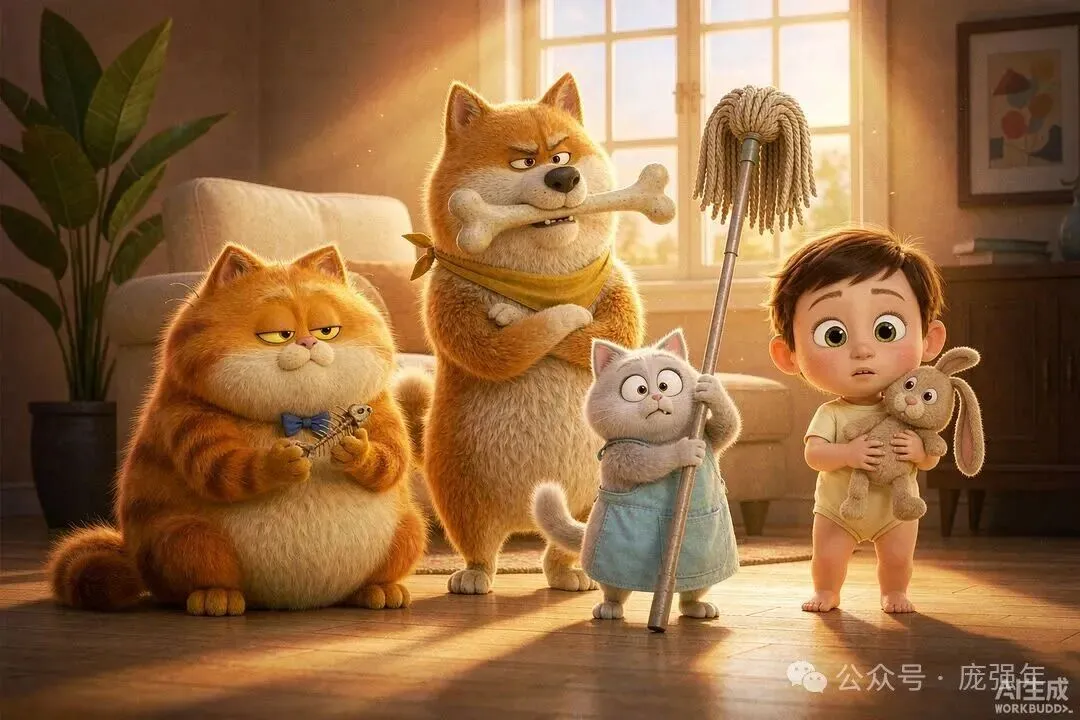
四口同框的定妆参考图:阿橘、阿柴、囡囡、小主人。大小比例就是片中的比例。
用体积说人物地位
阿橘最胖最占画面、阿柴中等偏壮、囡囡只有它们一半高。「最没存在感」用体型说,比写十句台词都有效,反转那一刻的视觉落差也最大。
另外每人配一件识别物:蓝领巾、黄领巾、过大的蓝围裙、兔子玩偶。观众记不住名字,但记得住颜色。
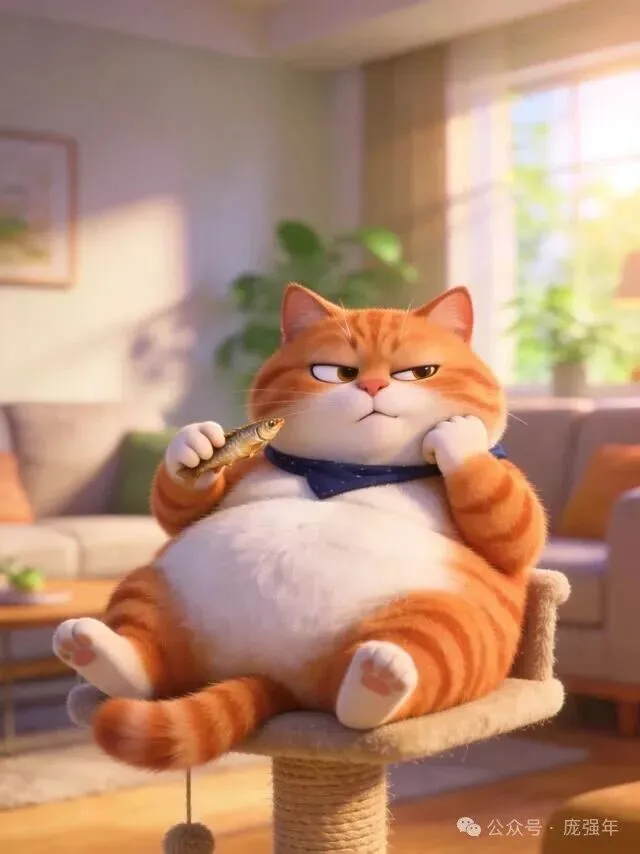
阿橘 · 橘猫 · 深蓝领巾
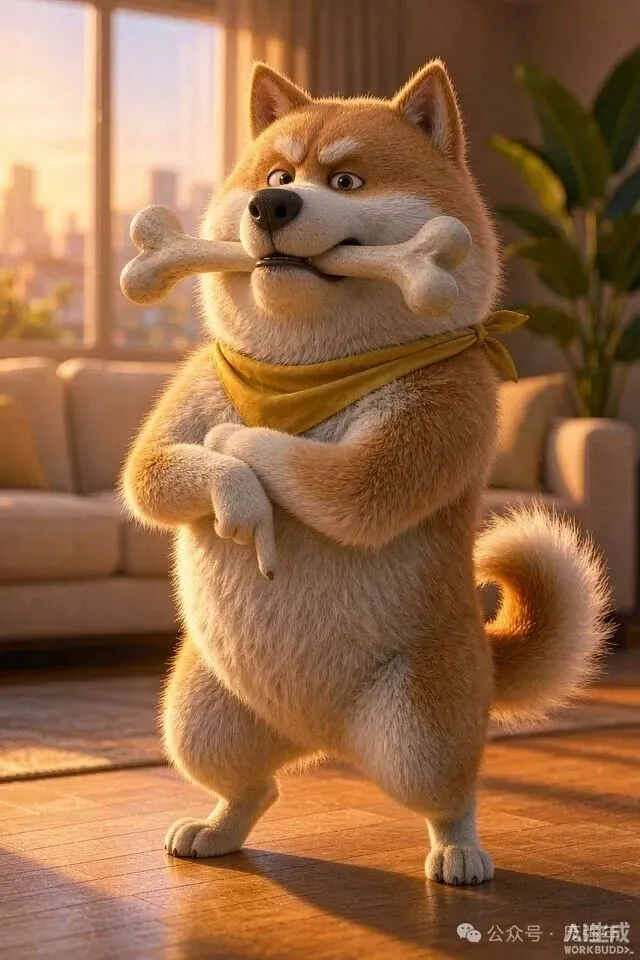
阿柴 · 柴犬 · 芥黄领巾
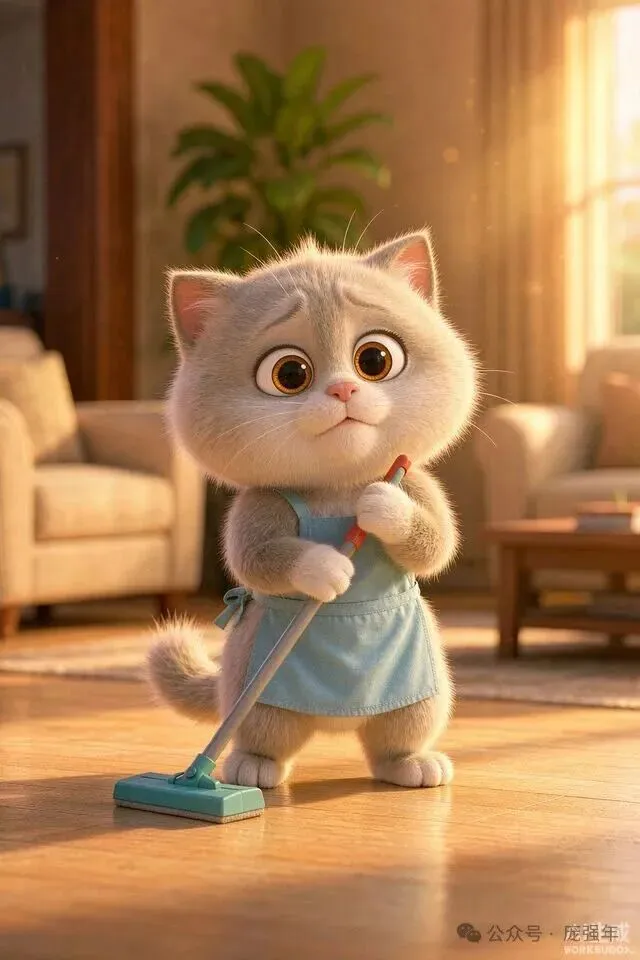
囡囡 · 小奶猫 · 浅蓝围裙
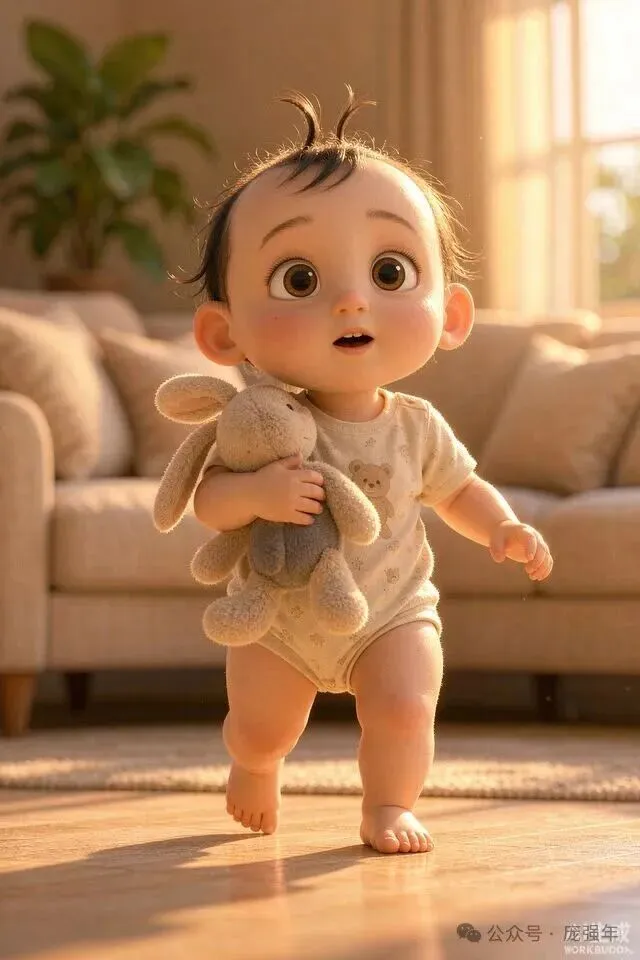
小主人 · 学步宝宝 · 兔子玩偶
四张定妆照,同一句风格前缀、同一侧光源生成。
每次生成都传参考图
生成视频时把对应角色的定妆照一起上传,毛色、脸型、配饰都能锁住。不锁图的结果就是五条片子像五只不同的猫。
03
PART
分镜头提示词怎么生成
PROMPT · 从脚本到提示词
我用的是即梦,三个分镜是分别生成的——它单条能出 10 秒,所以一条片就是三段 10 秒各跑一次,最后在剪映里拼起来。
提示词我不自己硬写,直接交给 WorkBuddy。脚本定稿后,接着在同一个对话框里往下说一句:「照这份脚本,出第一段的即梦提示词,按画面 / 声音 / 字幕三行、每行前面标好秒数」,它就好一段一段吐出来。
有一个要求必须写清楚:字幕和声音要在同一次生成里一起出。即梦一条 10 秒是把画面、配音、烧进画面的字幕一口气给你的,别默认「先出画面、后期再补」——把它写进要求,它才会把台词、音效、字幕文案一起排进那 10 秒里。
✦ 全程只开一个对话框
写脚本、出分镜提示词、做封面,都别另起新对话。角色长什么样、哪句是金句、光从哪边进来,全在上下文里——换一个窗口,设定就得重讲一遍,还容易讲漏。
PROMPT0到3秒画面:极低机位贴着浅木色地板,前方一摊清水,水面反射窗外暖光,一只胖乎乎的婴儿光脚高高抬起、脚趾微张,正要踩进水里;镜头贴地快速推进,在脚掌离水面两厘米处骤然停住。声音:一声短促猫叫加心跳鼓点。字幕:画面正中弹出巨大白色粗体字「完——蛋——!」。
三条片子怎么接上?拿上一段的最后一帧,当下一段的首帧,场景、光线、道具位置就都不会跳。
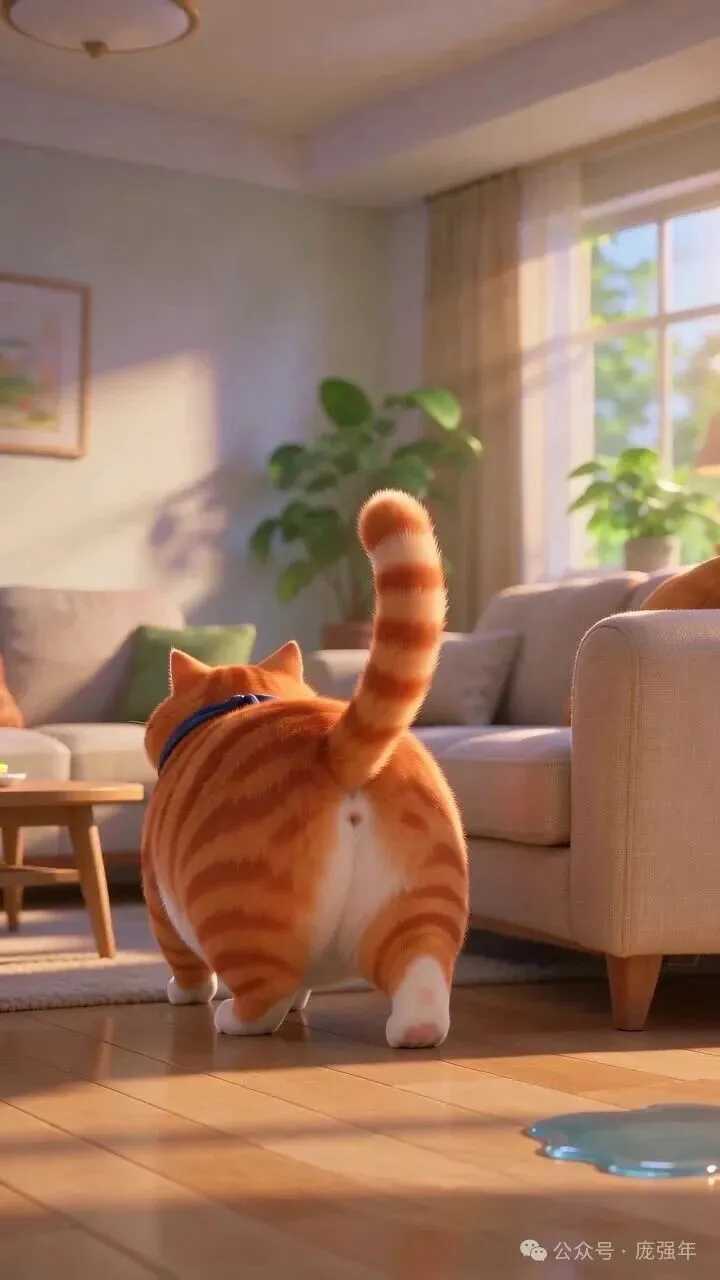
第 1 段的真实最后一帧:水摊留在画面右下角,光还在右侧。第 2 段就是拿它当首帧接上的。
✦ 10 秒和 5 秒怎么选
10 秒:即梦每天送的积分够直接跑一条 10 秒,一次成型;但画面容易带瑕疵,想重跑就得再耗一次积分。
5 秒:要多切一刀、多一次生成和拼接,费时间;但每段动作少,可以磨得更精致。
我的做法是先拿 10 秒把整段节奏跑出来,哪一处实在崩了,再单独把那 5 秒拆成两段重做。
▶ 整条 30 秒成片
30 秒 · 剪映成片
[编辑位:放视频号卡片或上传成片后删掉这张图]
04
PART
剪辑只做两件事
EDIT · 剪映里别贪多
三条视频丢进剪映,我实际只做了两个操作。剪辑越少,观众越觉得片子「干净」。
拼接:三条素材按顺序拖到主轨道,前一条的尾巴贴住后一条的头,剪映会自动吸附,30 秒的片子几下就拼完。接缝处只比两帧——上一段的最后一帧、下一段的第一帧,动作接得上、光没变,就算拼对了。
定格:把播放头放在要停的那一帧,右键素材选「定格」,自动生成一张静态片段,拖边缘就能控制停多久。片头那句「完蛋」和结尾黑场都靠它。
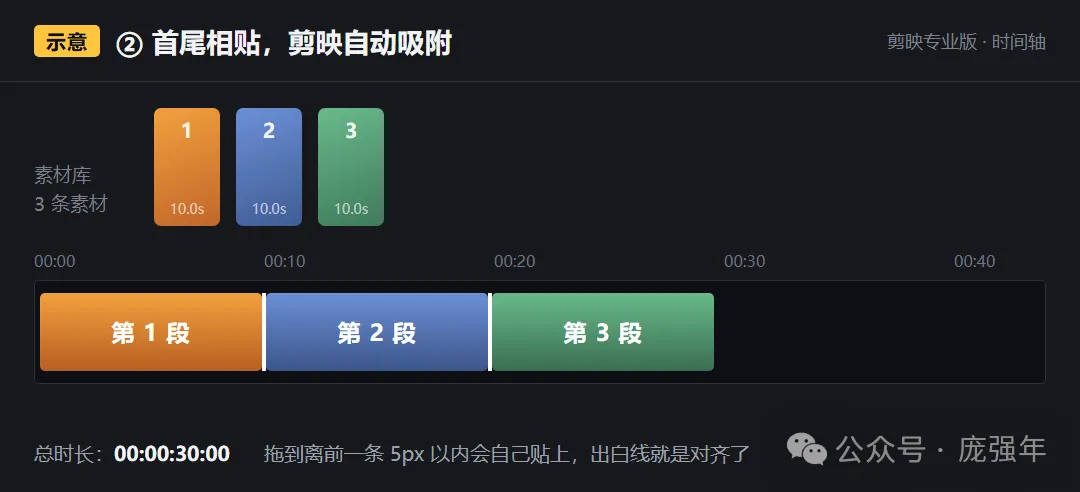
三条拖到首尾相贴就会自动吸附,出现白线就是对齐了,总时长刚好 30 秒。
05
PART
封面和标题,决定有没有人点
COVER · 三层信息各干各的活
片子做完只是做完,封面才是视频号的第一道漏斗。我的封面固定放三层信息。
封面也是在同一个对话框里让它做的。前面聊过角色、聊过那句金句,它知道这张图该是什么调性;我只说一句「做个视频号封面,要吸引眼球的」,出来的就是一张 1080×1920、能直接上传的成品,尺寸、配色、风格都不用再交代一遍。
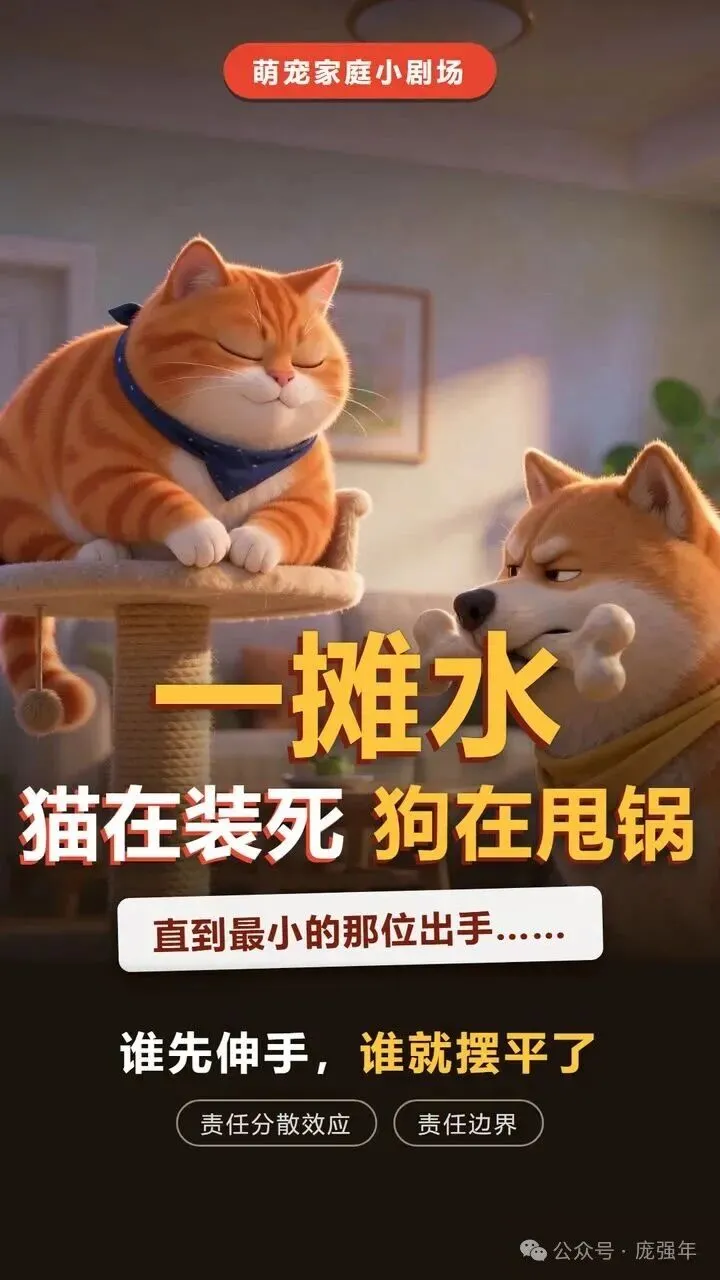
最终上线的封面:大字只有三个字,冲突交给副标,钩子交给省略号。
主标题卖冲突
大字只放三个字:一摊水。下面一行写清矛盾:猫在装死,狗在甩锅。别在封面上写完整句子,写一个说不完的状态。
悬念条给一个没说完的钩子
「直到最小的那位出手……」——省略号是关键,它让脑子自动想补完。再加一句金句「谁先伸手,谁就摆平了」,被截图转发的就是这一句。
标题和封面要错开视角:封面卖「里面讲什么」,标题卖「为什么点开」。所以我标题里刻意不再出现「一摊水」三个字,让两条信息互补,而不是重复。
话题标签混着用,八个以内:
大流量:萌宠 · 搞笑萌宠 · 橘猫 · 柴犬
蹭大类目,保证有基础曝光。
差异化:上海话
方言标签的受众很稳,评论区极活跃,还容易引发「这句我听懂了」的互动。
内容定性:责任分散效应
让算法知道这不是纯卖萌,能推到职场、管理、家庭教育人群。
系列专属:地板上一摊水
每集都带同一个标签,观众点进去能看到全部,这是做系列最省力的方式。
///
LAST
写在最后
SUMMARY · 工具不决定上限
整条片子算下来,两个小时就够了。真正花时间的不是生成,是那句脚本——创意脚本得来回打磨,改到自己都觉得一句废话都没有了才敢拍;视频生成出来的画面有点瑕疵反而不重要,观众不会盯着爪子的边缘看,工具成本也几乎为零,真正贵的是「你得先知道要说什么」。
这也是我做企业 AI 落地这几年最确定的一件事:模型和工具每三个月换一茬,能把需求翻译成画面、把画面拆成指令的人,一直稀缺。
谁先伸手,谁就摆平了
我是庞强年,专注于 AI 赋能个人与企业成长。