ARTICLE · 1271121
软件工程可能要被AI编程毁掉了?
软件工程可能要被AI编程毁掉了?
乾坤AI容我懒 | AI外网
 cover
你上周让 AI 写了一个登录模块,二十分钟搞定,测试全过,上线了。
然后呢?
没人读得懂它为什么用那个加密方式,没人知道 session 管理里藏了什么假设,三个月后有个安全审计来问"这个 token 刷新逻辑为什么长这样",你愣了三秒——你写不出答案,因为你没写,AI 写的,你不记得它当时怎么想的了。
这件事不是假设。它正在发生。
快是真的快
先说句公道话:AI 写代码确实快。
一个中等熟练度的后端工程师,从零搭一个 CRUD 接口要两三个小时。现在丢给 Copilot 或者 Cursor,提示词写好,十几分钟出第一版。前端组件更快,让 AI 把设计稿转成代码,过去两小时的事现在二十分钟。
整个行业都在拿这个速度做 KPI。"提效 5 倍""一个人顶一个小组""vibe coding,凭感觉出活"——这些词已经不只是博客里的,是周会里、招聘 JD 里、甚至老板嘴里的。
速度本身不是问题。问题是,快的那一步从来不是软件工程最难的那一步。
"写"从来不是最难的事
这句话可能有点反直觉。
一个软件项目里,写代码大概占 30% 的工时。剩下 70% 花在哪?读别人的代码、审 PR、排查为什么改了一个地方另一个地方崩了、重构一段半年没人动过的逻辑、写文档让下一个人能接手。
这些步骤有个共同特点:需要有人真正理解代码在做什么。
AI 不读代码。它生成代码。你让它写一个排序函数,它写出来,漂亮,能跑。但它不知道你的项目里已经有一个自己封装的、带监控埋点的排序工具。于是它又写了一个新的。再过一周,另一个需求又生成一个第三版。
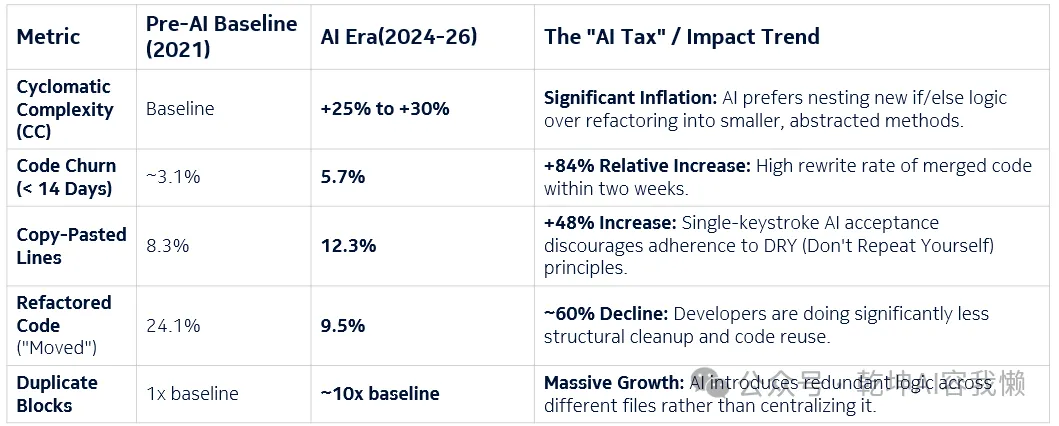
GitClear 追踪了全球开源仓库的复制粘贴率:2021 年,提交里的复制粘贴代码占 8.3%。2024 年,12.3%。三年内涨了 4 个百分点。
这不是程序员变懒了。是 AI 在鼓励你"再写一个"而不是"去用那个已有的"。
更扎心的是重构在萎缩。一份内部代码度量报告(来源待核)显示:代码被"移动/重构"的比例从 24.1% 掉到 9.5%——将近 60% 的下滑。而 14 天内被反复改写的代码(code churn)从 3.1% 涨到 5.7%,涨了 84%。
翻译一下:以前写完一段代码,你会把它挪到该去的地方、拆小、合并重复;现在写完就扔在那,过两周又改一遍。代码不是变少了,是变得"活着但没人管"了。
 02
AI 正在吃掉最难的那一步
数据比形容词有说服力。
幻觉包。 Janea Systems 扫了 576,000 个 AI 生成的代码样本,19.7% 推荐了不存在的 npm/pip 包。更绝的是,其中 43% 的假包名在重复生成时还会出现——AI 会非常自信地推荐一个根本不存在的东西,每次都不一样,但就是那几个。
有人专门注册这些假包名,等 AI 推荐,然后在包里塞恶意代码。这叫 slopsquatting。你的 AI 帮你写代码,顺手帮你装后门。
 03
漏洞率。 2025 年一项大样本研究显示,AI 生成的代码里,C 和 C++ 的漏洞率约 41%。Python 16-18%。TypeScript 好一些,不到 10%。
41% 是什么概念?你写十段 C 代码,四段有安全漏洞。如果你的 AI 替写了四段,有 1.6 段是坏的。你审得出来吗?前提是你读得懂它写了什么。
你读得懂吗?
AI 生成的代码有一个特点:它倾向于在已有函数里塞逻辑,而不是抽出一个干净的 helper。Janea Systems 建议的门禁规则是"单函数复杂度涨 3 倍就 block 掉这个 PR"——言下之意,AI 干这事干得很频繁。
同一份内部度量报告里,圈复杂度(Cyclomatic Complexity)在 AI 工具普及后涨了 25% 到 30%。不是代码行数涨多少,是每个函数里面嵌套的分支变多了。AI 喜欢在你已有的 if 里再套一个 if,而不是抽出来单独写。三个月前你让 AI 改了个配置解析器,现在它嵌套了六层 if,变量名从 temp 变成了 temp2 又变成了 finalValue。你改不动它,因为你已经不确定哪层 if 是 AI 自己加的、哪层是你自己加的。
这就是 InfoWorld 那篇文章说的:AI 技术债比传统技术债更难还,因为你不知道 AI 在里面做了什么假设。 你自己写代码留的坑,你记得。AI 留的坑,你只能靠读出来。
毁掉的不只是代码,是"工程"本身
先看一个宏观数字。
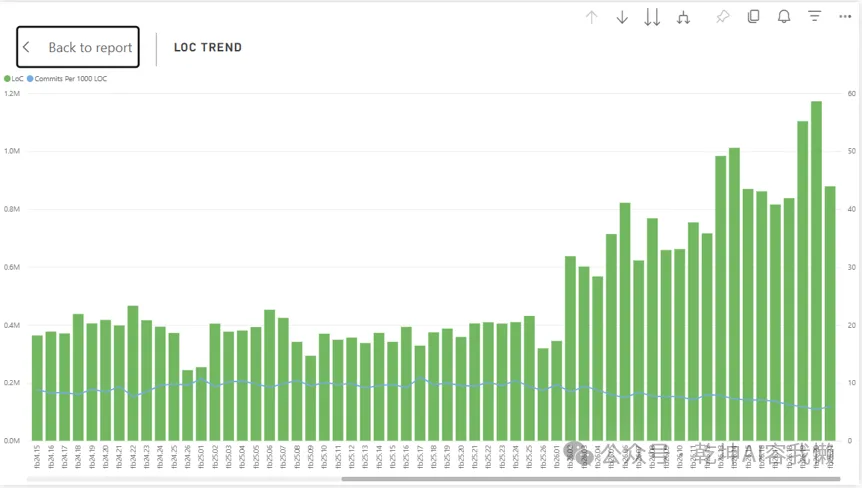
同一份内部度量报告追踪了 2021 年到 2026 年的 committed NLoC(非空行数):AI 编程工具普及之后,总代码量翻了将近 2 倍——从大约 40 万行涨到 120 万行。
但同一张趋势图里,每个千行对应的 commit 数在下降。代码多了,改动密度反而低了。多出来的 80 万行里,多少是新功能?多少是 AI 又生成了一遍的重复逻辑?多少是嵌套了三层 if 的复杂度膨胀?多少是被删了又加、加了又删的反复折腾?
没人说得清。这就是"2 倍"真正的含义:不是"2 倍功能",是"2 倍不确定性"。
 01
你公司那个 MVP,上线前用 vibe coding 三天赶出来的。现在它有了 5 个第三方集成、一个支付网关、一套用户数据。
Janea Systems 的建议是:如果生成代码超过 1 万行、有复杂数据模型、有多个集成,诚实的答案是找几个高级工程师重写核心,把现有 UI 当 spec 用。 理由是"12 个月里,打补丁比重建贵"。
对创业者来说这话很扎心。你的 MVP 是 AI 帮你"做出来"的,但你要卖的那个产品,AI 没有帮你"工程化"。
再看安全侧。2025 年一份审查扫了 2,600 多个公开的 MCP server 实现,36.7% 存在 SSRF 漏洞可以被利用。MCP 是 AI 编程工具跟你的文件系统、数据库打交道的接口。AI 在你的机器上跑,拿着你的权限,读你的代码,执行你的命令——它生成的那些包名不存在的依赖,那些嵌套六层的 if,那些你不知道的假设,全在这个信任域里。
软件工程的"工程"两个字,意思不只是"我写了代码",意思是"我理解我写了什么、它能跟什么交互、它崩了谁负责"。 AI 把"写"压到 5 分钟,把"理解、审查、负责"推到了更远的地方。远到没人愿意做那 70% 了。
怎么不毁
不写鸡汤,给三个数字。
15% 到 25% 的 sprint 容量固定给还债。 不是"有空就重构",是写进排期的、不可谈判的份额。就像安全补丁窗口不可谈判。跳过它的代价是:六个月后,你 65% 的 sprint 在修 bug。
Refactor-to-add ratio,每个 sprint 出两个数。 这个 sprint 新加了多少行,同时重构/合并/删除了多少行。如果新加的连续三个 sprint 是重构的 10 倍,你正在看着技术债积累。这个指标不告诉你做什么,但它告诉你该往哪看了。
季度架构审查,人来做。 找团队里最能看全局的人,每季度坐一起,从头看一遍代码。看重复代码集中在哪、复杂度在哪个模块爬升、AI agent 在哪些地方活动最频繁。然后重新设计。
静态分析工具能发现问题,但重设计一个模块这件事,目前 AI 干不了。得是人。