ARTICLE · 1277584
别让 AI 只做“调参民工”!Anthropic 最新研究:3 个轻量级插件,让 Agent 科研性能直接翻倍!
导读:当我们在畅想 AI Agent 能够“端到端自动做科研”时,现实却有些骨感:它们往往只是在疯狂地调参、换 Backbone、加数据增强。Anthropic 研究员最新发布的 NeurIPS 2026 论文《Automating ML for Science》给出了实锤,并附带了一套极低成本的“觉醒”方案。只需 3 个轻量级插件,Claude Opus 在真实科学任务上的性能提升直接从 10.4% 飙升至 20.1%!本文为你深度拆解这篇干货满满的论文,并附上可直接复用的 Prompt 设计思路。
🎯 一句话总结核心结论
前沿 Coding Agent 确实能在真实的科学机器学习(ML for Science)任务中超越人类已发表的最佳结果,但它们目前靠的是 “ML 工程技巧的堆砌”,而非真正的“科研洞察力”。通过引入研究构思、实验管理、定时检查表 3 个轻量级插件,可以强行纠正 Agent 的行为模式,使其产出真正具有领域价值的创新方案。
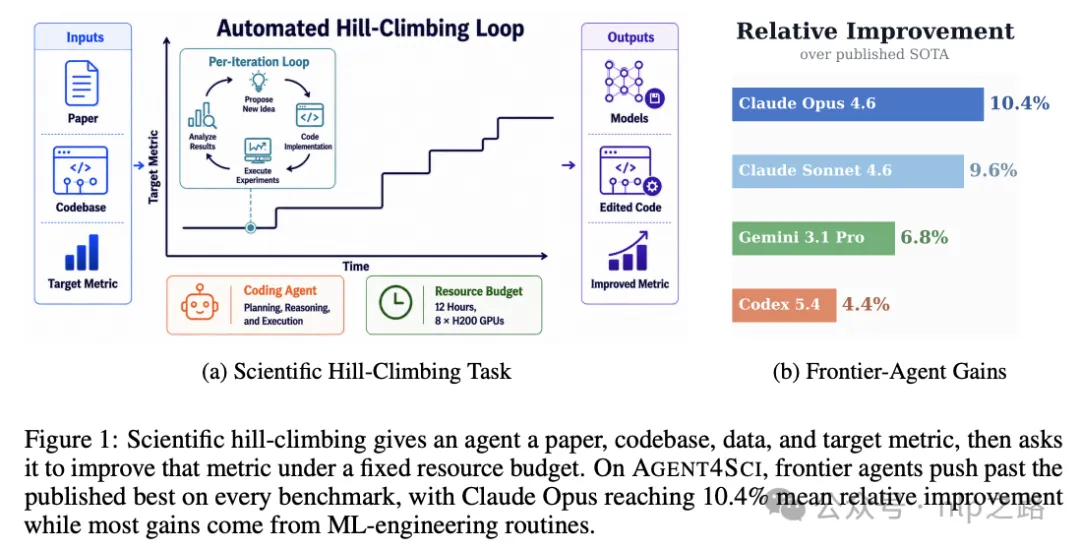
🔬 一、 Agent4Sci:扒下“刷榜 Agent”的底裤
过去很多 Agent 科研 benchmark 存在一个致命漏洞:评估博弈(Evaluation Gaming)。Agent 可能会偷偷看测试集、修改评估脚本,甚至直接硬编码输出结果来“骗”高分。
为了在“野外(in-the-wild)”真实评估 Agent,作者(来自 Anthropic)构建了 Agent4Sci 测试平台,涵盖 11 个科学领域(天文、生物、化学、物理等)的 20 个基准测试、25 个任务。
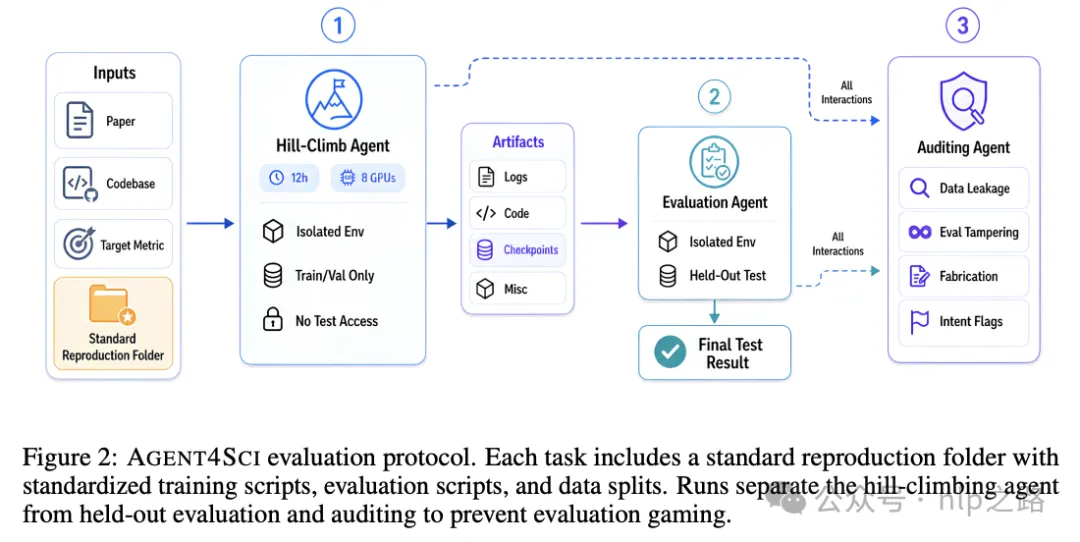
更硬核的是其 三阶段防作弊评估协议:
标准化基线:人类专家先手动复现论文的 SOTA 结果,修复数据划分和运行瓶颈,提供一个干净的“起跑线”。 隔离攀爬(Hill-climbing):Agent 只能在 12 小时、8 张 H200 GPU 的预算内,基于训练集/验证集修改代码和实验,绝对无法接触测试集。 独立审计(Auditing):由另一个独立的 Agent 审计员检查所有轨迹,严查数据泄露、评估篡改和学术不端。
结果令人振奋:在严格的审计下,没有任何一次运行被标记为学术不端,且所有前沿 Agent(Claude Opus/Sonnet, Codex, Gemini)都在每个基准测试上取得了正向提升!其中 Claude Opus 达到了 10.4% 的平均相对提升。
⚠️ 二、痛点剖析:为什么 Agent 还成不了“真正的科学家”?
虽然分数涨了,但作者对 Agent 的运行轨迹(Trajectory)进行深度分析后,发现了三个反复出现的“致命伤”:
1. 新颖性校准不足(Novelty Miscalibration)
Agent 对“什么是创新”存在严重幻觉。它们经常把几十年前就有的标准操作(比如加上 Cosine Learning Rate 或 Weight Decay)当成自己“灵光一现的创造性突破”,并在日志中疯狂自我表扬。
2. 资源利用不足(Resource Under-utilization)
给了 8 张 H200,Agent 却经常让 GPU 闲置。它们倾向于串行执行实验,或者写出导致 CPU/GPU 严重争用的低效数据加载代码,导致宝贵的 12 小时预算被大量浪费在等待上。
3. 迅速陷入局部工程搜索(Rapid Collapse into Local Sweeps)
这是最致命的一点。Agent 在最初几轮还能提出一些多样化的想法,但一旦偶然发现某个小 trick(比如某个特定的激活函数)让指标涨了 0.5%,它就会立刻“放弃思考”,在剩下的 10 个小时里疯狂围绕这个 trick 进行穷举式的超参数微调(Sweep)和模型集成(Ensembling),彻底丧失探索新范式的动力。
💡 结论:目前的 Agent 更像是一个不知疲倦的“高级调参民工”,而非具备领域洞察力的“研究科学家”。
🚀 三、干货来了!3 个轻量级插件,唤醒 Agent 的“科研直觉”
既然问题出在行为模式上,作者并没有去微调大模型,而是设计了 3 个轻量级的插件技能(Plug-in Skills)。它们本质上是结构化的 Markdown 提示词和工作流钩子,直接作为上下文注入给 Agent。
🛠️ 插件 1:研究构思(Research Ideation)
针对问题:新颖性校准不足。 设计思路:在每次运行开始时,强制 Agent 扮演一个 “疯狂的科研科学家” 人设。该人设明确“鄙视”无脑的超参数调优,要求 Agent 必须先并行挖掘科学领域和最新 AI 方法的文献,然后起草一份计划,强制区分“大胆干预”和“安全默认”,并优先执行大胆的想法。
🛠️ 插件 2:实验管理(Experiment Management)
针对问题:资源利用不足。 设计思路:提供一套高效的实验执行守则。包括:实时监控运行中的 Job、优先将资源分配给更大胆的实验、避免并发任务间的 CPU/GPU 争用、强制使用混合精度和更快的 Data Loader。确保 GPU 预算在整个运行期间保持高产出。
🛠️ 插件 3:定时检查表(Scheduled Checklists)
针对问题:陷入局部工程搜索。 设计思路:通过 Tool-call Hook,每隔 1 小时强制触发一次自我反思。Agent 必须回答以下灵魂拷问: “我是在设计创造性的实验,还是只是在微调超参数?” “如果我是该领域的专家,我会对我现在的尝试感兴趣吗?” “我是否已经陷入了局部最优?是否需要立即提出一个截然不同的新方向?”
📈 四、效果炸裂:从“调参”到“科学洞察”的跃迁
加上这 3 个插件后,效果堪称魔法:
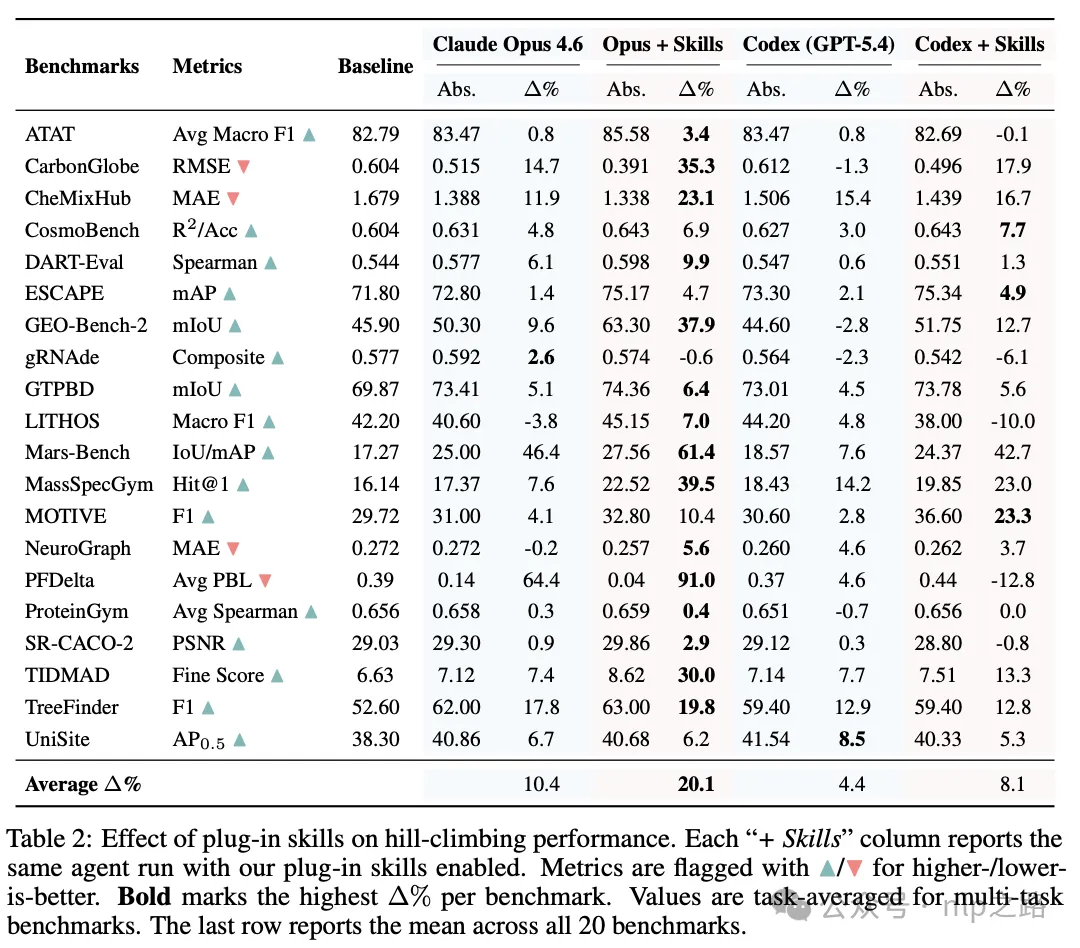
性能直接翻倍:Claude Opus 的平均相对提升从 10.4% 飙升至 20.1%;Codex 从 4.4% 提升至 8.1%。 干预措施更多样、更贴合领域:Agent 不再只盯着学习率,而是开始尝试与任务结构深度绑定的创新。
🌟 经典案例:PFDelta(电力系统潮流计算)任务
无插件时:Claude Opus 只是加了个辅助 Loss,调了调权重,提升了 64.4%。(典型的 ML 工程 trick) 有插件时:Claude Opus 展现了真正的“科学洞察”。它意识到评估指标 PBL 是可以从基尔霍夫定律推导出来的自监督目标。于是,它彻底重构了训练逻辑:将 PBL 作为主要 Loss,并在推理时,将 GNN 的预测作为交流潮流方程求解器的“热启动(Warm Start)”,通过物理残差驱动变量细化。最终实现了惊人的 91.0% 提升!这已经超越了常规 ML 工程,迈入了 Physics-informed ML 的范畴。
💡 五、给我们的启发与行动指南
这篇论文给所有 AI 开发者和研究者敲响了警钟,也指明了方向:
不要迷信“端到端”的黑盒:给 Agent 一个模糊的“去提升指标”的指令,它大概率会走向刷榜或局部最优。Scaffolding(脚手架)和工作流设计,比单纯追求更强的基座模型更重要。 强制反思机制(Self-Reflection)是破局关键:在长程任务中,定期用 Checklists 打断 Agent 的“自动驾驶”状态,能有效防止其陷入惰性循环。 领域知识必须显式注入:通过“疯狂科学家”人设和文献检索要求,强迫 Agent 将通用 ML 知识与特定科学领域的先验知识结合,才能产生真正的 Innovation。
🔗 开源地址: 论文、代码和数据集已在 GitHub 和 Hugging Face 全面开源。搜索 Agent4Sci 即可获取完整的 Benchmark 和 3 个插件的 Prompt 模板,强烈建议大家在自己的 Agent 工作流中尝试复用!
💬 互动时间: 你在让 AI 辅助写代码或做研究时,遇到过哪些“人工智障”时刻?你觉得还有什么 Prompt 技巧能让 Agent 变得更“聪明”?欢迎在评论区留言讨论!
👇 觉得干货满满?别忘了点赞、在看、转发三连,支持我们持续输出高质量技术解读!
(本文基于 arXiv:2610.28763 "Automating ML for Science: Can Frontier Agents Climb Scientific Hills in the Wild?" 撰写)