ARTICLE · 1285892
EXCEL新函数---REGEXP---不规则内容统计的克星
EXCEL新函数---REGEXP---不规则内容统计的克星在现实中进行统计,由于缺少统一度量衡,导致表格千奇百变,各种样式都有,到了最后汇总数据的人手里,真的会让人很苦恼 小白志在让办公变的人人都容易,如果有哪里不明白或者需要修改的地方,欢迎留言,感恩相遇,希望能帮到你 针对上的那种不规范的内容的整理,小白根据常遇到的情况简单进行了一下整理,并根据这些不规范的情况给出相应的方案,咱们今天需要的用的是EXCEL新出的一个正则函数,REGEXP函数,语法相对简单,难理解的是正则表达式,关于正则表达式大家可以搜索一下,有很多很多,小白在这里只列举出日常用到的正则表达式,所以关于他的语法,咱们就在下面的案例里面一并解释了,就不在这里啰嗦了,咱们一起来看看吧 一、提取费用文字+数字的费用总额 我们常常会遇到不同的人员统计的表格参差不齐,例如买个东西会把当天或者同类的放在一个单元格里,具体来说就是像下面展示的那样,谁买了什么,花了多少钱,但是要从这些内容中自动计算出总共花了多少钱,这该怎么办呢?咱们来看一下小白整理的,具体公式如下 公式=SUM(1*REGEXP(A3,"[0-9.]+")) 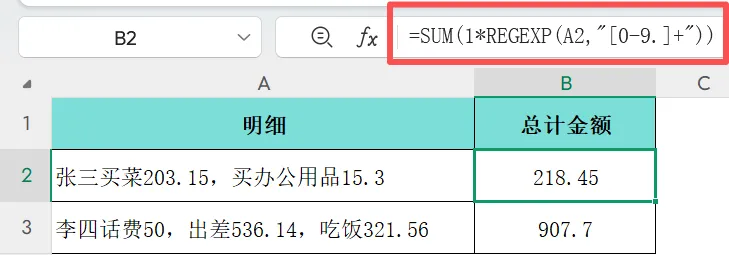
REGEXP是一个正则函数,她的意思就是原始内容+正则表达式,这个其实就是他的语法,正则表达式其实就是要提取出的规则,就像咱们上面的[0-9.]+就是正则表达式的一种,[0-9.]+表达的意思就是指连续的数字,那为什么前面还要乘1呢 ?是因为提取出来的内容是文本格式的,乘以1就是为了把文本变成数值,这样再用SUM来求和就可以了 二、提取固定内容前面的数字并求和 这时候就有人问了,平时我们统计都是数字后面带元的,那这样的话上面这个公式还能用吗 ?答案当时肯定的 但是我们现在只统计某个标识前面的金额呢?例如元?其实就是上面函数的延伸 =SUM(1*REGEXP(A2,"[0-9.]+(?=元)")) 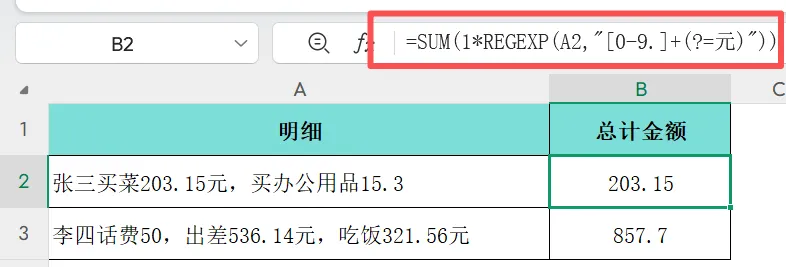
(?=元)也是一种正则表达式,表达的意思是表示 元 前面的内容,看上面的内容结果就知道了,只是将带有元的前面的数字进行了求和 所以日常中我们单纯把数字求和就用第一种,如果是特定字符前的求和就用第二种 三、姓名提取 在我们日常工作数据统计中,还会遇到人员信息统计的时候,有的会将姓名和手机号统计在一起,这时候我们需要将姓名提取出来,怎么办?那就是下面这个新的正则表达式了 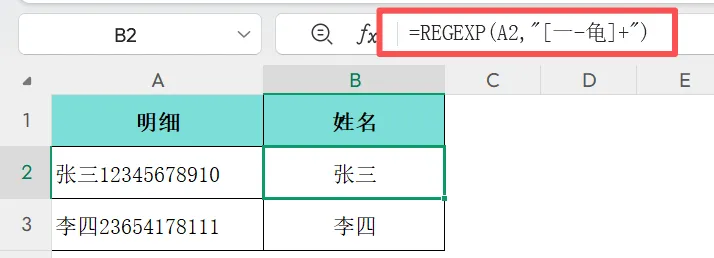
有些人要问了,[一-龟]+是正则表达式,那[一-龟]+是什么意思,他代表连续的中文,那如果手机号后面还有文字怎么办?这时候就需要借助take来组合一下,截取第一列的内容 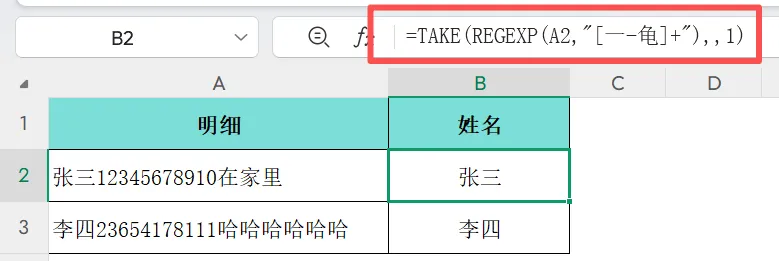
四、提取手机号 通过上面的案例,有的小伙伴就会提出新的问题了,我们姓名提取出来了,那手机号呢?手机号怎么提取,会了上面的,其实就很简单了,就是第一种案例的简化版 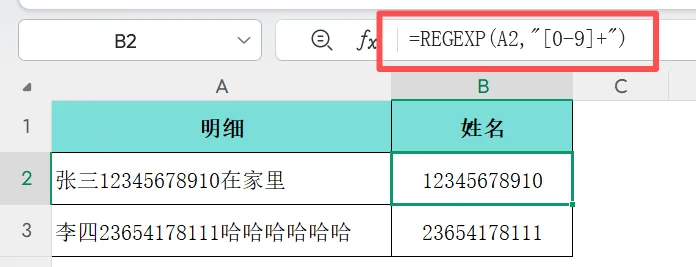
五、按不同类别进行统计 日常统计的时候,可能会遇到N多种付款方式或者收款方式,咱们统计的时候都统计在了一个单元格里,在看明细的时候就会很苦恼,例如微信115元,支付宝58,现金67.8,需要分别统计微信多少、支付宝多少、现金多少,这种情况我们会经常遇到,并且搞起来会非常苦恼,那该怎么办呢?咱们来看下面的公式 公式=IFERROR(REGEXP(A2:A5,B1:D1&"\K[0-9.]+"),) 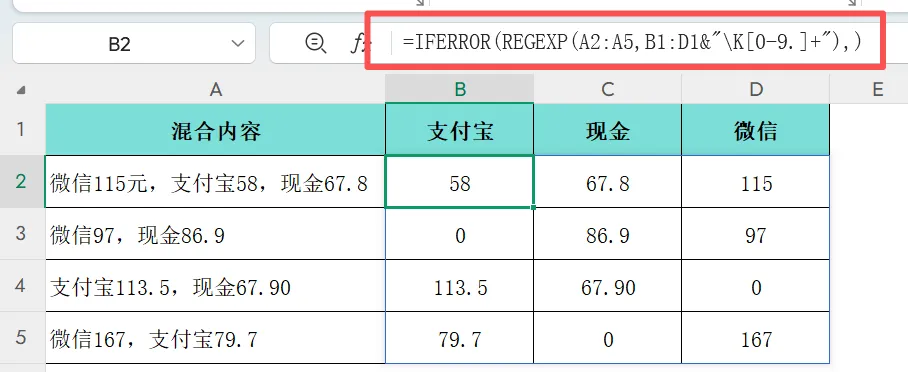
咱们这里的A2:A5就不用说了,就是咱们要处理的单元格 B1:D1就是需要统计的各种付款方式,他与\K[0-9.]+用&符号组合在一起,就表示以B1:D1开头的连续数字 说的具体点就是,咱们上面用的是某个字符前面的内容,现在这里是用的某个字符后面的内容,所以说一通百通,不把他说明了,很多人都在蒙圈中 因为我们在统计中,有的时间段儿内,并不是所有的统计方式都有,就像上面的第二行,他就只有微信和支付宝两种方式,所以就会出现错误值,咱们用IFERROR在最外面包装一下,就会把错误值忽略了 小白志在让办公变的人人都容易,如果有哪里不明白或者需要修改的地方,欢迎留言,感恩相遇,希望能帮到你
=REGEXP(A2,"[一-龟]+")
=REGEXP(A2,"[0-9]+")
这里就不再过多解释了
这个正则函数还有很多种用法,我把常用的案例整理了一下列在了这里,如果还有其他的案例,大家可以留言或者自己搜索一下正则表达式