ARTICLE · 1291121
我装了3个AI工具,断网也能跑!
上周给视频配旁白,edge-tts 突然开始 403。
查了半小时,不是微软封版本号,是我这台机器上的代理端口又变了。
那一刻挺没面子的。小C 我天天在稿子里写「本地部署」「离线可用」,结果一条配音流水线,卡在一个网络请求上,整条线全停。
所以我这周末干了件笨事:把三个真能干活的工具,全装到这台没有独显的笔记本上,然后把它们的 HTTP 出口掐死,看它们还认不认我。
先把家底交代清楚,免得有人问我什么配置。
适用系统:Windows 10 / 11(macOS、Linux 一样能装) 测试机:i9-9880H + 16G 内存,显卡是 AMD Radeon Pro 5500M 显卡说明:这卡跑 AI 等于没有,CUDA 一个都不认,下面全是纯 CPU 跑出来的数 装包耗时:三个包加起来 295 秒 硬盘占用:整个虚拟环境目录 454 MB(含两个模型) 花的钱:0
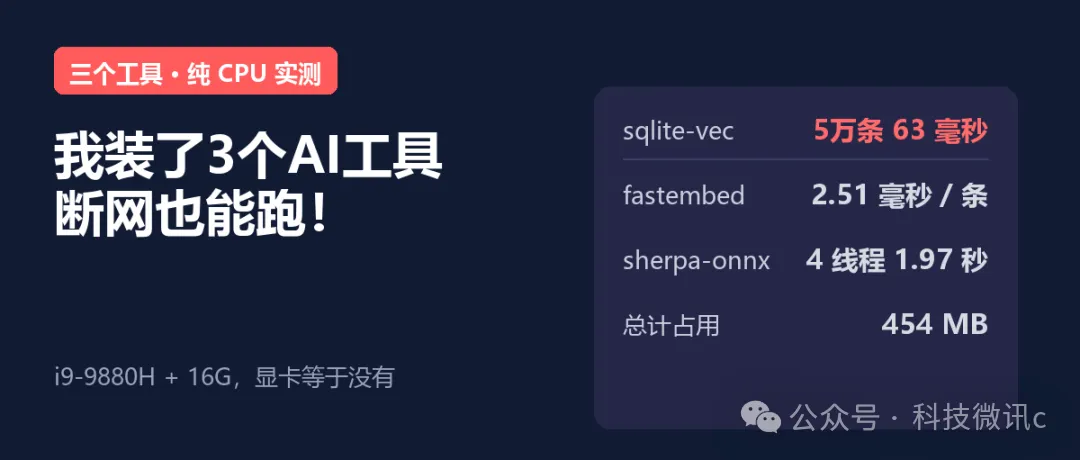
三个工具纯 CPU 实测
1、sqlite-vec:把向量检索塞进一个文件
先说最轻的这个。
它能干啥:给 SQLite 加一张叫 vec0 的虚拟表,向量搜索就变成一句 SQL。
我以前给项目做语义搜索,标准动作是起 Docker、拉一个向量数据库、配端口、写客户端。就为了查几十万条向量,得养一个服务。
sqlite-vec 把这个服务砍成了一个 .db 文件。
怎么装:
pip install sqlite-vec 7.97 秒装完。装完我去看了一眼 site-packages,四舍五入到 MB 完全看不出变化——它是纯 C 写的 SQLite 扩展,PyPI 上写着零运行时依赖,连 numpy 都不需要。
怎么用,三步:
import sqlite3, sqlite_vec db = sqlite3.connect("vec.db") # 或者 ":memory:",建内存库 1、开扩展:db.enable_load_extension(True) 之后 sqlite_vec.load(db),用完记得关回去 2、建表:create virtual table v using vec0(embedding float[512]) 3、查:select rowid, distance from v where embedding match ? and k = 10
我测出来的数(5 万条 512 维随机向量,i9 纯 CPU):
灌库:1.80 秒 KNN 查 10 条:中位 63.02 毫秒(20 次,最快 62.38,最慢 65.07) 落盘:99.3 MB 正确性:我把第 7 条向量原样丢回去查,top1 回来的 rowid 就是 7,距离 0.0000
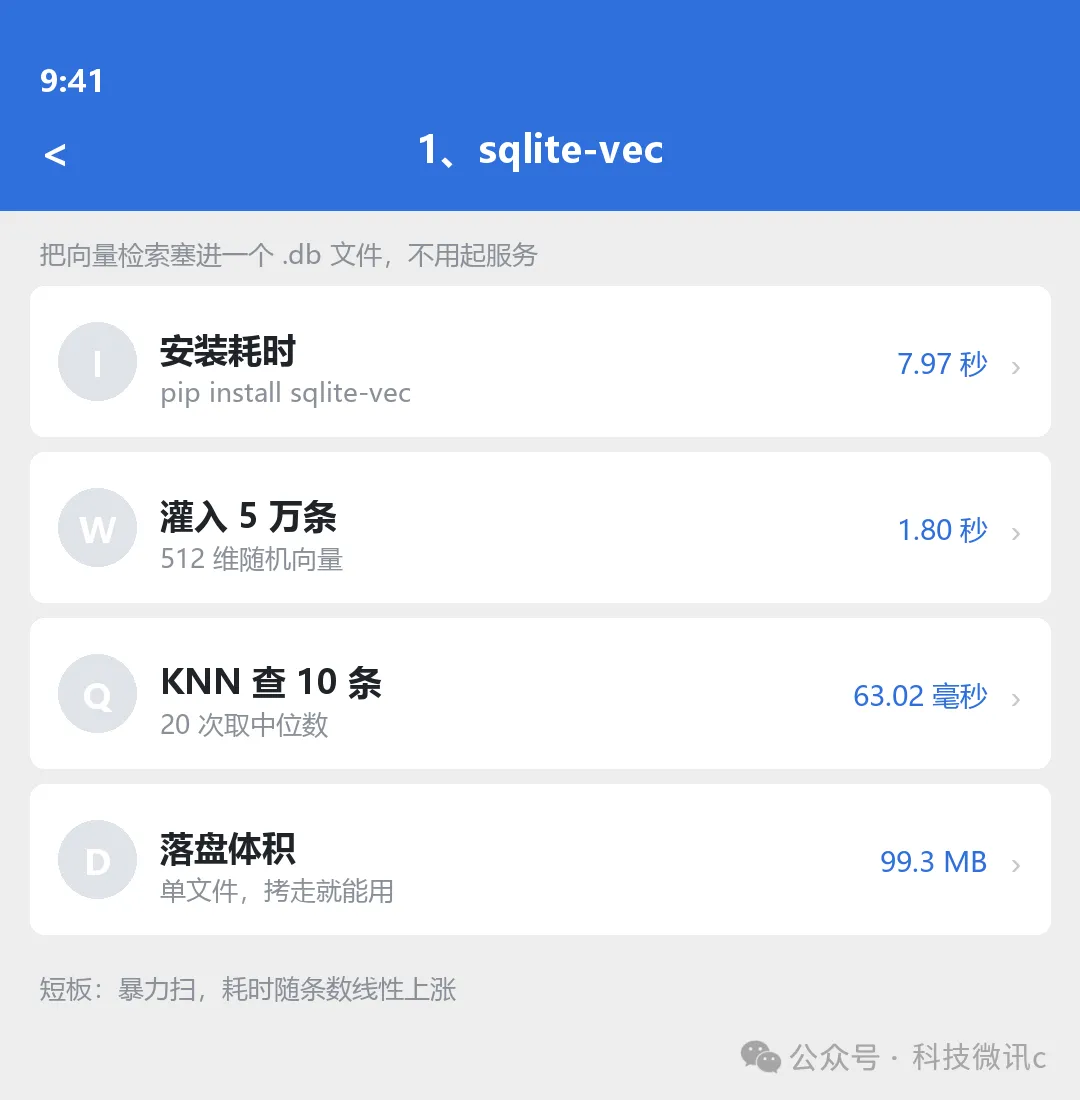
sqlite-vec 实测数据
取舍,说实话:
它是暴力扫,没有 IVF、没有 HNSW 这些索引结构(0.1.9 这个稳定版就是这样)。
所以 5 万条 63 毫秒,按线性推算 10 万条约 126 毫秒——这个 126 我没实测,别当准数。百万级就别指望它了。
但如果你要的是「一个文件拷到 U 盘就能带走、双击就能查」,它比养一个向量库服务省事太多。
2、fastembed:91 MB 的模型,2.51 毫秒算一条
有了库,还得有向量。
它能干啥:Qdrant 出的轻量 embedding 库,底层是 ONNX Runtime,纯 CPU,不碰 PyTorch。
这点对我很重要——我这台机器上装了 torch,一个 import 就要吃掉几百兆内存,笔记本风扇立刻起飞。
怎么装:
pip install fastembed 218 秒。慢,因为依赖多(onnxruntime、tokenizers、huggingface-hub 一堆)。包本身占 160 MB,模型另外下。
模型我选的是 BAAI/bge-small-zh-v1.5,512 维,下下来 91 MB。
怎么用:
from fastembed import TextEmbedding model = TextEmbedding(model_name="BAAI/bge-small-zh-v1.5") vecs = list(model.embed(["第一句话", "第二句话"])) # 批量传 list,比一条条喂快得多 我测出来的数:
100 条一批(离线跑):0.251 秒,折合 2.51 毫秒一条 200 条一批:0.55 秒,折合 2.75 毫秒一条 真活儿:把 67 天抓的 3177 条资讯 + 我自己的稿,全算成向量,91.30 秒,平均 28.74 毫秒一条
同一批短句,100 条一批和 200 条一批差 9%,这是正常的批次波动,别拿单个数字当准数。
为什么短句 2.5 毫秒、批量反而 28.74 毫秒?因为那 3177 条每条最多 300 字,长的短的混着算,短句占便宜。这个数别拿去吹,它就是个「能接受」的量级。
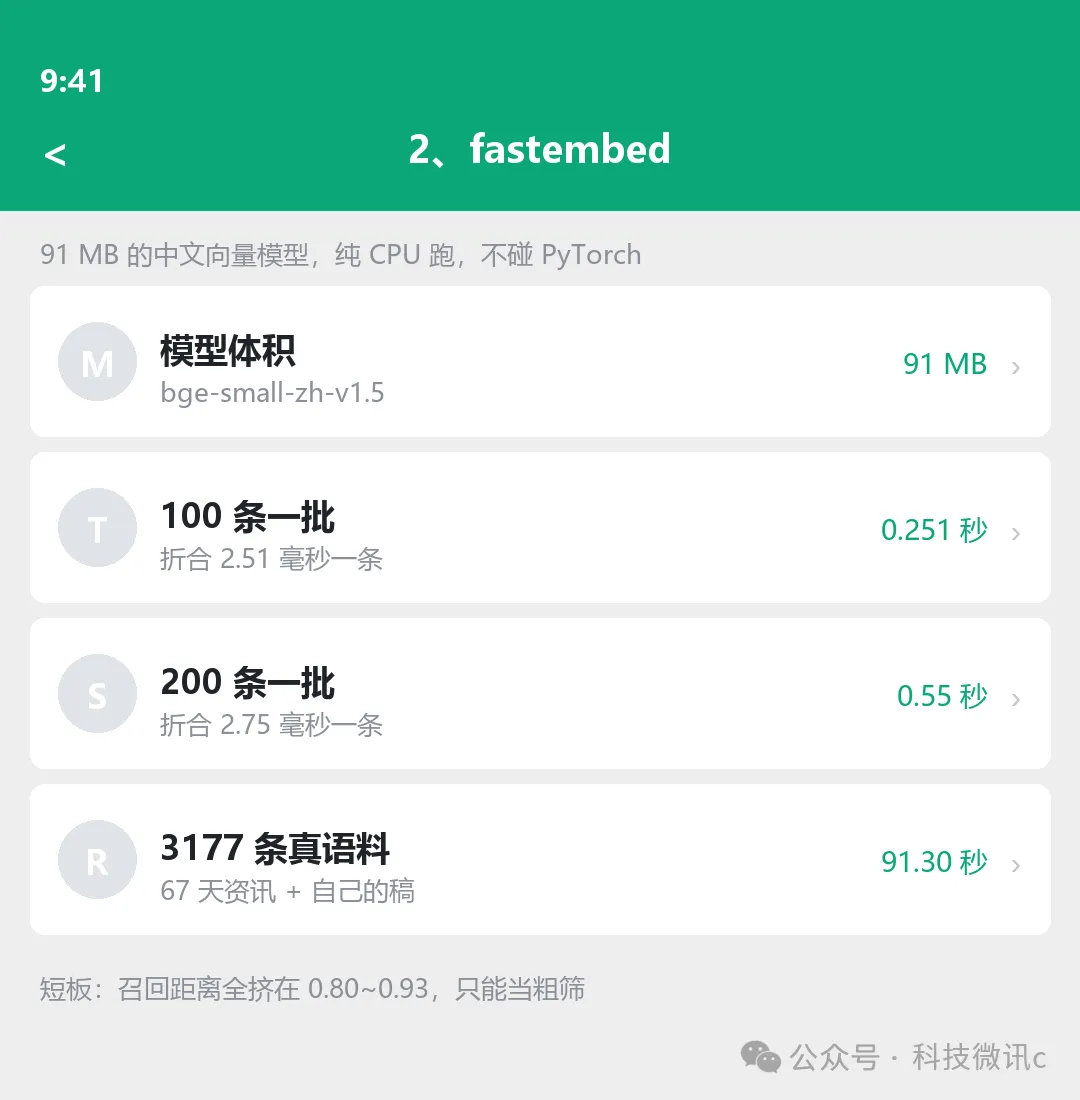
fastembed 实测数据
这里必须泼一盆冷水。
我把这 3177 条灌进 sqlite-vec,库文件 8.44 MB,查询 45~53 毫秒,看着挺美。然后我拿四条查询试召回:
「本地部署的大模型」→ 召回了「生产级大模型平台工程实战手册」,对 「语音合成不联网」→ 召回了一条 ASR 实测,勉强沾边 「向量检索 数据库」→ 召回的是「.NET 多类型数据库通用库」,跑偏 「开源 OCR 表格识别」→ 完全没召回我写 OCR 那篇
看距离就更清楚了:所有结果全挤在 0.80 到 0.93 之间,好和坏拉不开。
结论:小模型 + 300 字截断,只能当粗筛。想靠它替掉关键词搜索,真会翻车,我试过,头一回拿它当主搜索就栽了。我现在的用法是「关键词先筛一遍,再用它排个序」,这样才稳。
3、sherpa-onnx:不联网出声,还比在线快
这个是这次最让我意外的。
它能干啥:语音识别、语音合成、端点检测,全在 CPU 上跑,模型统一是 ONNX 格式。
怎么装:
pip install sherpa-onnx 69 秒,包 27 MB。
模型得自己下。中文我用的是 vits-zh-hf-fanchen-C(模型 121 MB,在 HuggingFace 上搜这个名字就有),另外还要两个文件:tokens.txt(331 字节)和 lexicon.txt(2.4 MB 拼音词典)。
这两个小文件不能漏,尤其词典——我头一回只下了模型,中文直接不出声,白跑一趟。
还有个小坑:官方包里模型叫 vits-zh-hf-fanchen-C.onnx,我本地图省事改名成了 model.onnx。下面代码我按官方名写的,你直接抄就行;要是你也改过名,换回你自己的。
怎么用:
import sherpa_onnx cfg = sherpa_onnx.OfflineTtsConfig( model=sherpa_onnx.OfflineTtsModelConfig( vits=sherpa_onnx.OfflineTtsVitsModelConfig( model="tts/vits-zh-hf-fanchen-C.onnx", tokens="tts/tokens.txt", lexicon="tts/lexicon.txt", ), num_threads=4, # 这个参数是重点,下面说 ), max_num_sentences=1, ) tts = sherpa_onnx.OfflineTts(cfg) audio = tts.generate("要念的句子", sid=0, speed=1.0) # audio.samples 是 float 数组,audio.sample_rate 是采样率,存 wav 用标准库就行 我测出来的数(同一句话 22 个字,常驻后跑 7 次取中位):
1 线程:6274 毫秒 2 线程:3622 毫秒 4 线程:1970 毫秒 8 线程:1770 毫秒 16 线程:1718 毫秒
看出问题了吧。4 线程之后基本就平了——从 4 加到 16,只快了 13%,剩下那 12 个核全在发热。
这句话我在稿子里写过好几次,这次自己踩上了:默认参数不是给你这台机器调的。
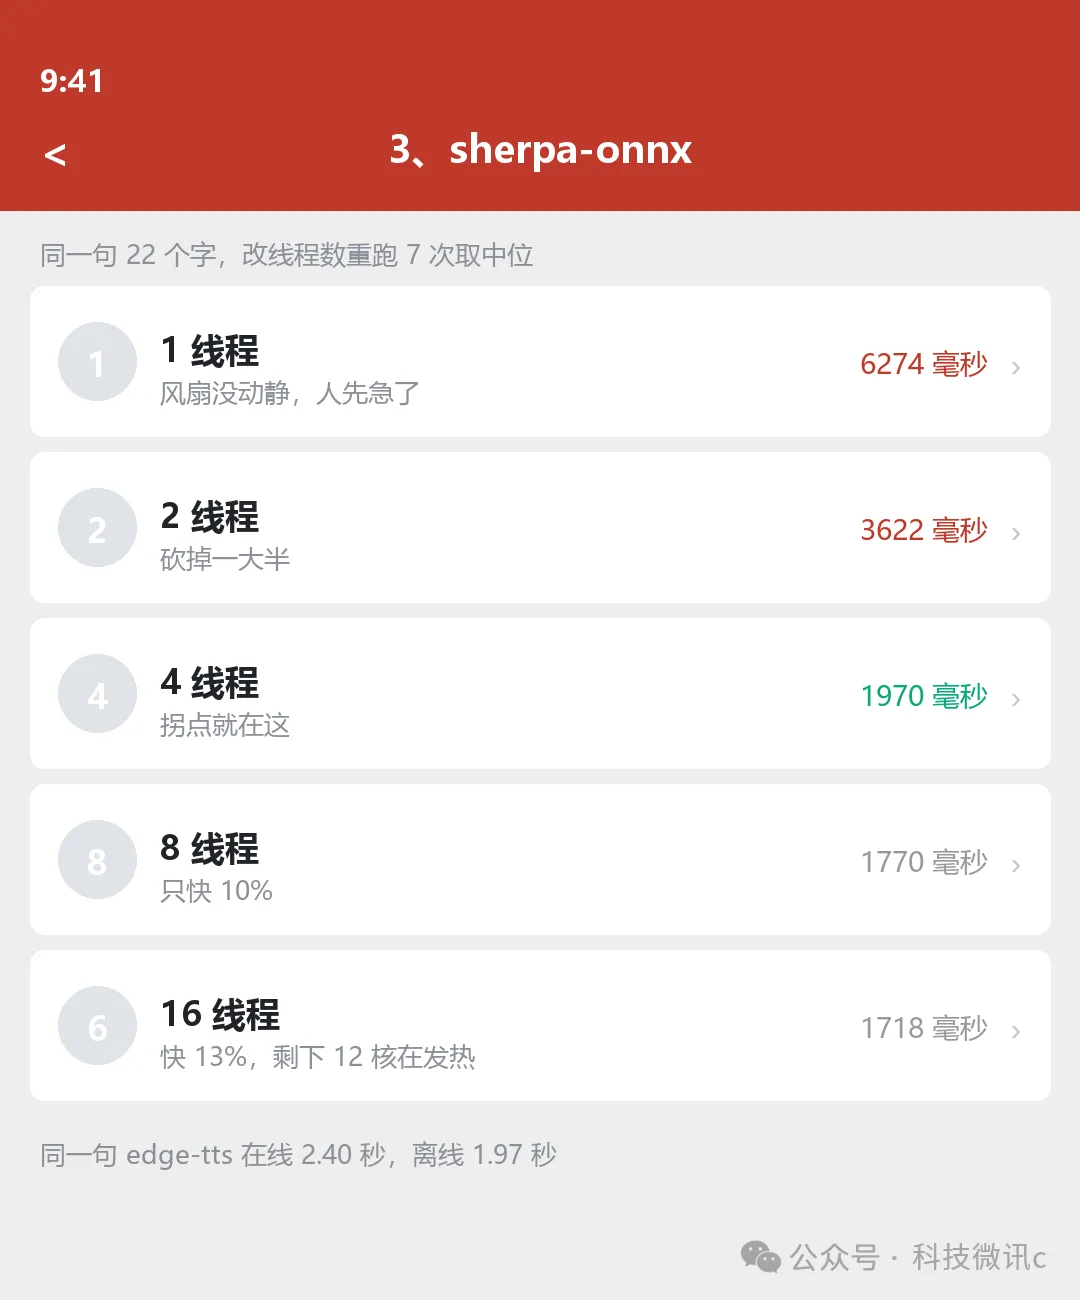
sherpa-onnx 线程数实测
顺带说个反直觉的:同一句话我跑了 6 次,出来的音频时长是 5.73、5.83、5.79、5.99、6.15、6.19 秒——每次都不一样。VITS 这类模型的时长预测本身带随机性,所以别指望「同一句必定同样长」。按中位 5.91 秒算,4 线程合成用 1.97 秒,实时率 0.33(大约 3 倍速)。够用,但不快。
想复现的话,把 noise_scale_w 设成 0,时长就定死了——代价是语调会平一点。我保留默认值,是因为我要的是「像人说话」,不是「每次跑出一模一样的数」。
跟我在用的 edge-tts 对一下(同一句话,在线):
在线 edge-tts:2.40 秒,32 KB mp3 离线 sherpa-onnx(4 线程,常驻):1.97 秒,约 190 KB wav
离线反而更快,因为省掉了网络往返。代价是 wav 比 mp3 大好几倍,不过用 ffmpeg 搞定就完事。
4、断网到底怎么断的(这步别学歪)
先说清楚:我不是真把网线薅了,这台机器全程是联网的。
我做的是把 HTTP 出口掐死:
import os os.environ["HTTP_PROXY"] = "http://127.0.0.1:1" # 指向一个没人监听的死端口 os.environ["HTTPS_PROXY"] = "http://127.0.0.1:1" os.environ["HF_HUB_OFFLINE"] = "1" # 禁掉模型库联网 os.environ["NO_PROXY"] = "" 这个设置必须在 import fastembed 之前生效,否则库已经把客户端建好了,改环境变量也白搭。
掐完之后跑一遍:
向量化:冷启动(含模型加载)100 条 0.57 秒;常驻后 100 条 0.251 秒,折合 2.51 毫秒一条 语音合成:冷启动(加载模型 + 首次合成)3.95 秒;常驻后 4 线程 1.97 秒 全程没看到一个请求真发出去——代理指向死端口,能发出去才怪
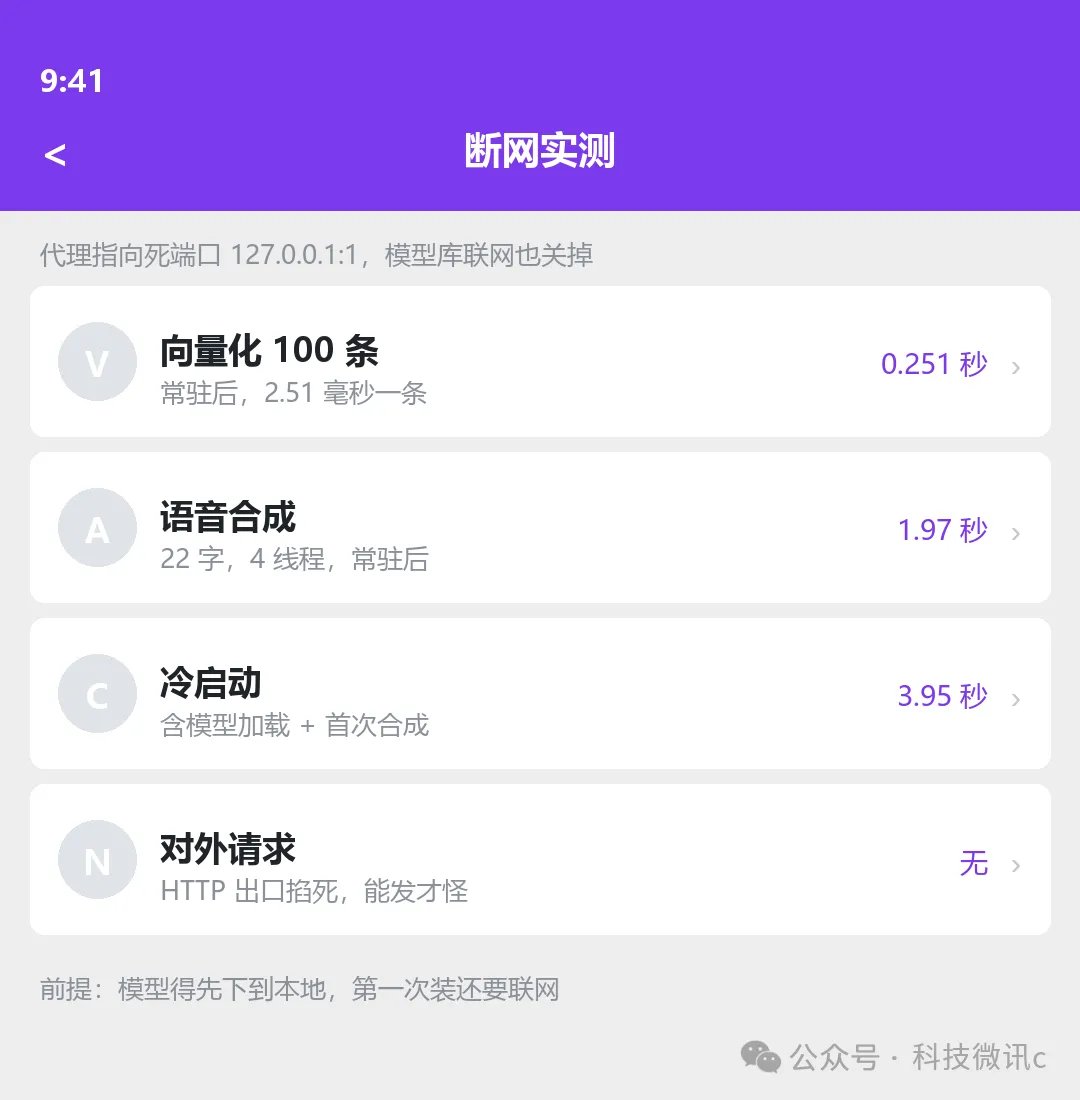
断网实测
所以准确的说法是:这三个工具不依赖网络,不是「这台机器断网了」。能绕过代理的直连库照样会尝试联网,这一点我不装懂。
但有个前提必须说:模型得先下到本地。头一回装、头一回用,该联网还是得联网,fastembed 是「首次使用时下载模型」,sherpa-onnx 是「模型自己下好放本地」。
我说的是:装完之后,模型在硬盘上了,从此不用再看网络脸色。别理解成「装个包就能断网」。
那一刻挺爽的。不是「理论上能离线」,是出口掐死了它还在转。
最后说点不好听的
这两年「本地部署」被说烂了,好像不装个 70B 就不算玩 AI。
我这周末的体会正好相反:真正卡住人的从来不是模型大小,是那个必须联网的环节。一张 121 MB 的语音模型、一个 91 MB 的向量模型、一个不到 1 MB 的 SQLite 插件,加起来不到 220 MB,跑在七年前的 i9 上,够我干完手里所有活。小C 这台本是 2019 年的,早该换了,一直没换就是因为它还够用。
这三样凑一块,就是个 8.44 MB 的库,装着我 67 天的资讯和稿子,断网能查、断网能读出声。这组合现在天天在用,挺好使。但它算不出新东西,只会翻旧账——指望它替代大模型,那是想多了。
也别被我带偏:它召回质量一般,暴力扫有延迟上限,语音是机器味不是人味。这三条短板是真的,我认。
所以最后一个问题,问个你肯定知道的数:
你电脑几个核?
我 16 核,只开 4 个线程干活,剩下 12 个全程在给我发热。评论区报个数,顺便说说你干过最浪费算力的一件事——我先认,我拿 16 核跑过一个单线程的批量下载,跑了一整晚。