ARTICLE · 1300693
项目规矩写成文档没人看,写成文件它每次都执行
一、场景
我们 Wiki 上有一篇规范,标题叫《后端开发约定》,写了两年。
一千八百多字,分九节。每次新人入职我都发一次链接。
今年三月我数了一下:同一个约定,我在四个不同的会话里跟 AI 解释过。金额不许用浮点、分页要用我们自己的封装、Service 不许直接发 HTTP。
四次。每次它都点头说记住了,下一个会话又忘。
我一开始怪工具。后来发现是我自己搞错了地方——我把规矩写在了它读不到的地方。这也是我折腾 AI 编程技巧这几年,返工次数排前三的一类错。
二、问题
文档和代码不同源,这是病根。
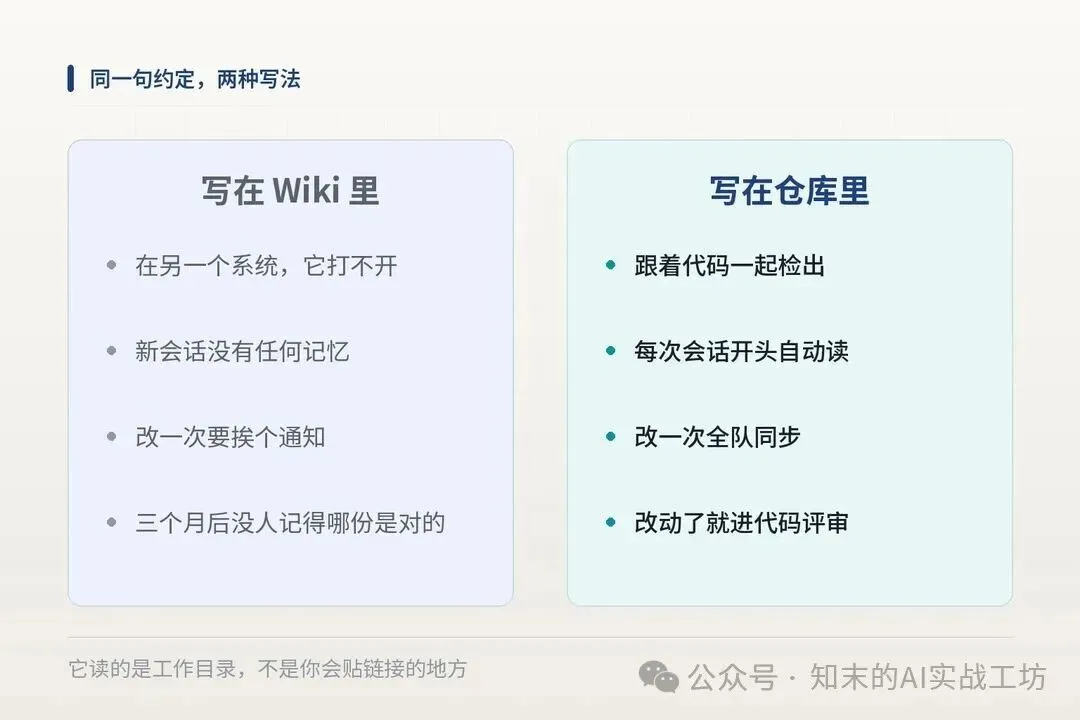
Wiki 在另一个系统里。AI 打开一个仓库,它读的是工作目录里的文件。Confluence 的链接对它来说就是个字符串,点不开。
更根本的一层是:AI 每次会话都是新开的。
它没有上一次的记忆。你昨天跟它讲过的规矩,今天它一概不知。这一点和人不一样,人是会带着昨天的印象来的。
补一句机制上的事,这决定了文件该多长。
这类约定文件在多数工具里的加载方式,是每次会话开头整份塞进上下文。
它不检索,也不是等它需要时才去翻。也就是说,你写进去的每一行,都在跟这次要改的代码抢位置。
文件越长,留给代码的注意力越少。这是我把九节砍到六节的直接原因,跟审美无关。
理解了这一层,后面很多决定就顺了:为什么禁止项要写清单、为什么路径不如职责、为什么子目录要单独放一份。
所以「写在文档里」这件事,对人的默认路径成立(人知道自己该去查),对 AI 的默认路径不成立(它不知道有这么一份文档)。
规矩想让它每次都知道,只有一条路:写进仓库,写进它每次必读的那个文件。
同一句约定,两种写法
三、方案
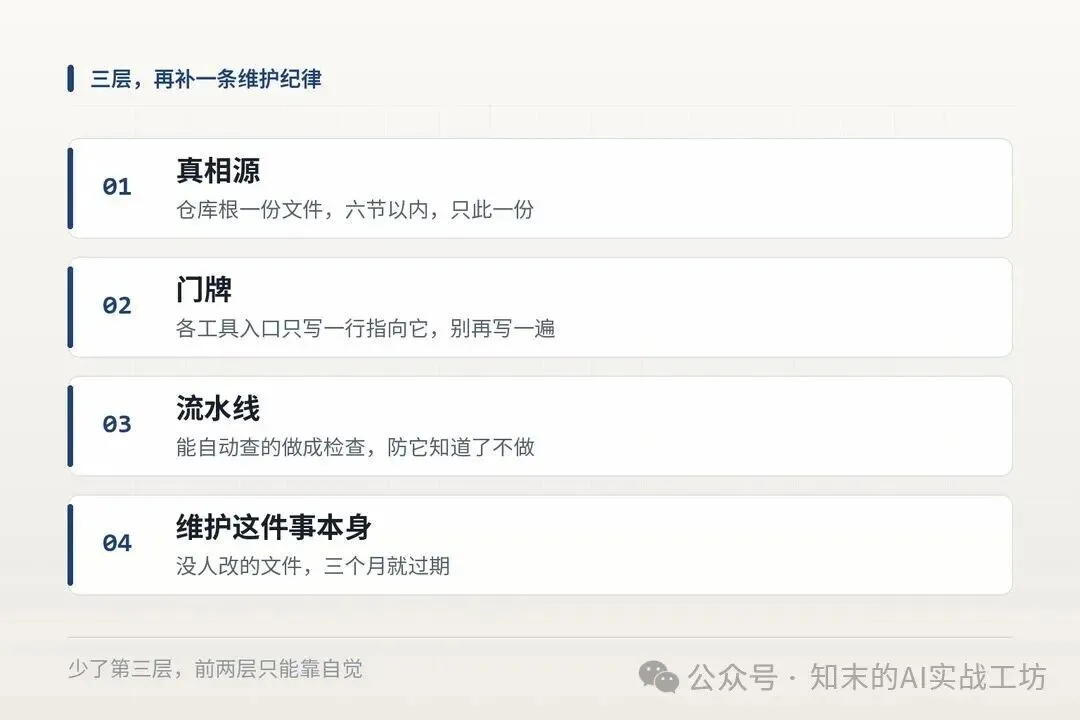
我试了三轮,落成三层,各管一件事。
第一层,一份真相源。
仓库根一个文件,写这个项目所有的硬约定。六节以内,别铺成九节。
为什么只留一份?因为我同时用三个工具:命令行里的编码助手、编辑器里的补全、团队里别人用的另一个。
三个工具读的文件名不一样。如果我每处都维护一份,三天后三份就开始互相矛盾,而且没人知道哪份是对的。
一份真相源,其余的位置只做一件事:指向它。
这么干还有个副作用,比省事重要:规矩改一次,全队所有工具的读法一起变。以前我改 Wiki,得挨个通知,通知到第三次就没人看了。
第二层,门牌。
各工具自己的入口文件里,只写一句「详细约定见 AGENTS.md」,加上这个工具专属的两三条补充。
门牌要短。长门牌必然和真相源打架。
第三层,能自动查的进流水线。
文件解决的是「它不知道」,流水线解决的是「它知道了也可能不做」。这两层谁缺了都不完整,不能互相顶替。
三层约定,再加一条维护纪律
四、实操:两份约定文件怎么写
先说格式上的现状,截至 2026 年 11 月。
AGENTS.md 是一个跨工具的约定文件名,目前被 Codex、Cursor、Copilot 等多个工具直接支持,仓库数量已过六万,2026 年起由 Linux 基金会下的 Agentic AI Foundation 托管。
它不是某一家定的,这也是我选它当真相源的原因。
但有几个坑得提前知道,不然写完发现不生效。
坑一:Cursor 不认 .cursor/rules 里的普通 .md。 那个目录下必须是带 frontmatter 的 .mdc 文件,否则整份被忽略。想用纯 markdown,就把 AGENTS.md 放在仓库根。
坑二:Claude Code 默认读的是 CLAUDE.md,不是 AGENTS.md。 只有在工作目录及其上层都没有 CLAUDE.md 时,它才回退去读 AGENTS.md。想两者都用,就在 CLAUDE.md 开头加一行 @AGENTS.md 做引用。
坑三:Copilot 的位置是 .github/copilot-instructions.md,单文件,没有层级,没有按路径匹配。它的好处是简单,坏处是仓库一大就写不下。
所以我的仓库根长这样:
AGENTS.md 真相源,六节CLAUDE.md 只有一行 @AGENTS.md.cursor/rules/ backend.mdc 只给后端目录,按 glob 生效 migrations.mdc 只给迁移脚本目录.github/copilot-instructions.md 精简版,指回 AGENTS.md.mdc 的门面(frontmatter)是这样写的:
---description: 后端服务层的写法约定globs: src/Modules 目录下所有 .csalwaysApply: false---globs 那一行写的是路径匹配模式,星号按目录层级展开。它让规则只在碰到那个目录的文件时才加载,省上下文。alwaysApply: true 则是每次会话都塞进上下文,两种都行,看这条约定是不是全局的。
再说内容。六节,顺序有讲究。
第一节,命令。 构建、跑测试、跑单个测试、格式化。这四行放开头。它是每次都用的东西,位置越靠前,模型伸手拿到的概率越高。
第二节,禁止项。
这一节比允许项重要。模型默认会写「合理的代码」,它写不出的东西是你项目里那些「看着合理但不许」的例外。
我们填的是:金额不许用浮点、不许在 Service 里发 HTTP、不许直接改迁移脚本、不许引新的第三方包。
每一条都对应一次真事。第三条是前年一次误改,把生产库的一个字段类型改了。
第三节,版本。
.NET 写具体版本,Java 写 JDK 版本和 Spring 版本。不写会出什么事?它会给你一版语法对、API 已废弃的代码。这种错很难在评审里看出来。
第四节,分层与边界。 只写一句依赖方向,加上一句「细节见结构说明卡」。
第五节,验收。 什么算完成。我们写的是三条:编译过、指定测试过、git status 干净。
第六节,不要改的文件。 生成物、依赖锁文件、构建产物目录。写清这些,能省掉一批没必要的 diff。
写完怎么验证它真读了?我的做法是开一个新会话,问它两个问题:
根据 AGENTS.md,回答:一、我要改 OrderService 里的一个金额计算,你会用哪种类型?二、这个项目跑单个测试的命令是什么?两问答对,说明它读到了。答错或者答得含糊,八成是文件名或位置不对——这是排查第一步,别急着改内容。
五、避坑
第一个坑:越写越长。
我第一版写了六百多行,把我能想到的规矩都塞进去。
结果它开始忽略中段的内容,只对开头和结尾有反应。文件是每次会话都要读的,读得越多,留给代码的注意力越少。
后来砍到一百二十行。判断标准很简单:这一条,新人第一天需要知道吗?不需要就删。
第二个坑:写成原则。
「代码要清晰」「注意可维护性」——这类句子零信息,写进去只占位置。
能判真假的才算约定。「金额用 decimal」能判真假,「代码要清晰」不能。
我拿这条筛过一遍,第一版里有一半句子被判掉了。
第三个坑:路径写死。
我在文件里写过一行「Handler 都在 src/Api/Handlers/」,两个月后目录重构,那行就成了误导,而且没人记得改。
后来改成描述职责不描述路径:「入参校验在 Handler 层做」,让代码自己告诉它文件在哪。
第四个坑:冲突时不知道谁赢。
多层文件同时存在时,规则是谁离得近谁赢。子目录里的 AGENTS.md 会盖住根目录那份。
这件事我在文档里写明了,不然团队里两个人各写一份,出问题互相推。
边界也说清楚。 这套东西解决的是「约定能被读到」,解决不了「约定本身是错的」。写进去一条不合理的规矩,它执行得比人还彻底。
还有一条:它只对「读了文件」的工具有效。有些工具不支持这类文件,那这部分工作得靠人在提示词里补。
六、延伸
现在我的做法是:任何一条纠正过两次的约定,写进 AGENTS.md,不进 Wiki。
判断标准很土——同样的话我说过第二遍,就不用说第三遍了。
团队这边推得慢一些。三个人里目前两个在用,第三位的工具不认这个文件,他还是手工贴上下文。我没强推,先让能用的用起来。
再往下,约定文件得进代码评审。规矩改了,diff 里就该看见那一行。这一条比写多少内容都管用——它保证文件不会过期。
往组织层面说一句:这套东西在企业 AI 架构里算成本很低的一层投入。不用买工具,不用改流程,就是把已经在做的事写成文件。但它的收益依赖一个前提——有人愿意维护它。没人维护的文件,三个月后跟 Wiki 一个下场。
你项目里的规矩现在写在哪?有没有哪条是你跟 AI 解释过三遍以上的?
我把这份六节约定文件的模板整理出来了,.NET 和 Java 各一版,含可直接改的 frontmatter 和多工具入口写法,回复「约定」就能拿到。