ARTICLE · 1318125
8GB 能跑、Comfy直连、30万次下载、无审查:Qwen-Image-2.1 Turbo到底改了什么
这是 abenzerps 给 Qwen-Image-2.1 Turbo 做的一站式打包,11 档主模型、文本编码器、VAE 全塞在同一个仓库,ComfyUI 里接好三个加载节点就能出图。仓库挂着 comfyui 和 comfyui-gguf 两个标签,模型卡大半篇幅在讲 ComfyUI 怎么配。近 30 天 305,860 次下载,累计 5,653 个赞,在社区量化仓里算跑得快的。
有三件事转发时常被说混,我按官方文件表核了一遍。
「无审查」不是有人把模型改了。模型卡原话写得很直白:The base model, Qwen-Image-2.1-Turbo, natively supports uncensored image generation. No built-in safety checker or content filter is applied, and no special settings are needed. 属性在上游基座,量化包既没重训权重,也没挂 abliterated 文本编码器或 uncensored LoRA。文件树 23 个文件,连 loras/ 目录都没有。
「8GB 能跑」是算出来的,不是官宣。模型卡只给了文件体积,还专门提醒一句 model file size is not total VRAM use,没承诺具体显存档位。
「8 步」也不是把 KSampler 的数字改成 8。Turbo 有一张固定 sigma 表,普通 8 步 simple 走的是另一条曲线。
下面按这三条拆开。
一、无审查:上游本来没装
这里得和同作者另一个仓库分开。abenzerps/Qwen-Image-2.1-Uncensored-Quantized 是 9 月那波非 Turbo 版本的打包,走 main / base 分支外加一个 uncensored LoRA 的路子;这次的 Turbo 仓是另一套东西,基座换成 Qwen/Qwen-Image-2.1-Turbo,仓库里只有量化和配套文件。把旧稿那套「UC 系列、原版分支、额外 LoRA」的说法搬过来,就写错了。
准确的说法是:Qwen 这个 Turbo 基座本身没配安全检查器或内容过滤器,社区分发时也没加。不需要特殊设置,不需要换编码器,不需要挂 LoRA。效果上确实不拒题,但这是「没装护栏」,不是「把护栏拆了」。
代价也在这里。产出内容的责任全在使用者一侧,公开发布或进产品线之前,合规得自己过。许可别看漏:license: other,license_name: qwen-research,Qwen Research License,研究评估用途没问题,不受限的商业用途不行。仓库标签里还有 region:us。这不是早期 Qwen-Image 那个 Apache 2.0。
二、仓库里有什么:11 档主模型,三个配套文件
按文件树接口翻完,23 个文件里 14 个是权重。主模型 11 档,按格式分三类:
配套三个:文本编码器 qwen3vl_8b_int8_convrot.safetensors 9.35 GB、BF16 版 17.53 GB,VAE qwen_image_2.1_vae_bf16.safetensors 0.68 GB。Comfy-Org 做的那套 Comfy 就绪文件,作者直接收进同一个仓库,这大概是最省事的地方。
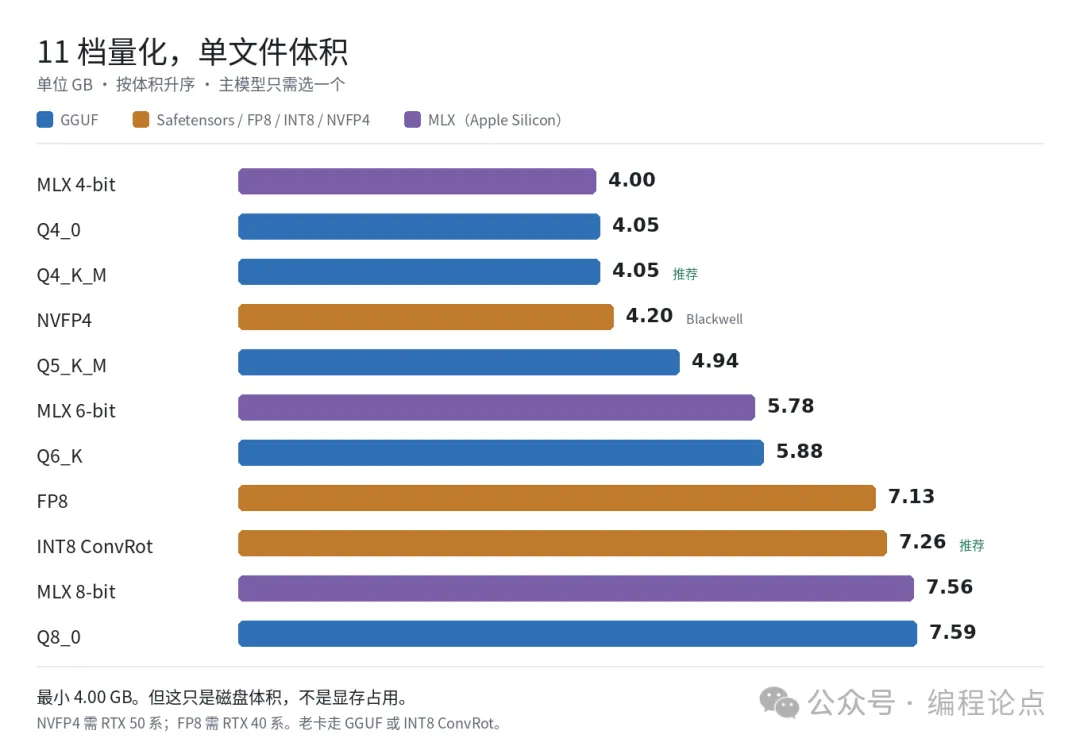
选档不用纠结。ComfyUI 里 GGUF 选 Q4_K_M,safetensors 选 INT8 ConvRot,这是模型卡给的起点。NVFP4 只有 4.20 GB,但要 Blackwell;FP8 要 Ada。这两条是低精度格式本身的硬件要求,模型卡没写代际,别把 4.20 GB 当成谁都能用的最小值。
MLX 那三档是给 MFLUX 用的,准备脚本会从官方 Turbo 仓补下 text_encoder、vae、scheduler,和后面讲的 ComfyUI 流程无关。命令行用户走 stable-diffusion.cpp,参数里带 --offload-to-cpu。
三、8GB 的账,得逐文件算
只看仓库总大小会误判,这里要凑的是最小可跑组合:一个扩散模型、一个文本编码器、一个 VAE。
Q4_K_M 4.05 GB 加 VAE 0.68 GB,常驻显存 4.73 GB。8GB 卡剩下 3.27 GB 给采样中间态和激活。文本编码器 9.35 GB 不进显存:命令行用 --offload-to-cpu,ComfyUI 侧编码跑一次就把模型挪到系统内存,结果留在显存里继续用。文本编码每次生成只做一次,这样做对出图速度影响不大。
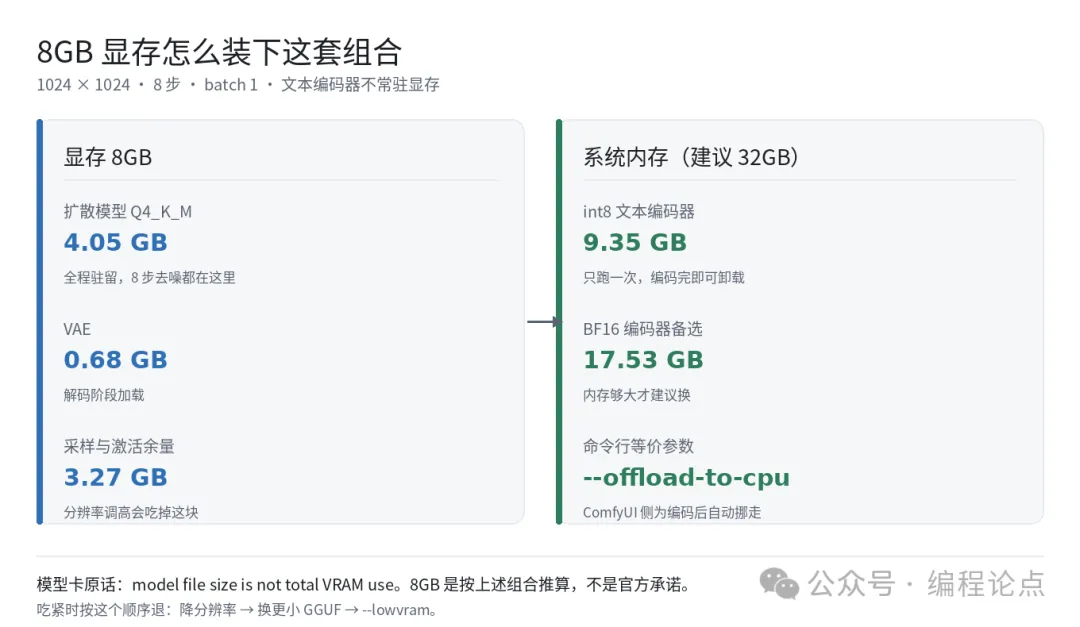
之所以能压进 8GB,Turbo 的采样量小是关键:8 步、CFG 1、1024 × 1024、batch 1,比 40 步配 2048 × 2048 轻得多。模型卡给的参考速度是预热后 1024 × 1024 出图 10–20 秒,取决于硬件——这是作者口径,不是我测的。
得把话说回来:8GB 是按上面这套组合推算,模型卡没这么写,而且它明确说了文件大小不等于显存占用。吃紧时按顺序退:降分辨率,换更小 GGUF,再上 --lowvram。想试 2048 × 2048,先确认显存和内存都够。
四、ComfyUI:三个文件,两个坑
文件放好,重启 ComfyUI:
ComfyUI/└── models/ ├── diffusion_models/ │ └── qwen-image-2.1-turbo-Q4_K_M.gguf ├── text_encoders/ │ └── qwen3vl_8b_int8_convrot.safetensors └── vae/ └── qwen_image_2.1_vae_bf16.safetensors工作流用官方模板库里的 Qwen Image 2.1 Turbo — Text to Image,对应 image_qwen_image_2_1_turbo_t2i.json。一定要用 Turbo 模板,别拿非 Turbo 的 t2i 模板改步数。打开子图能找到内部加载器。
节点规则:GGUF 文件用 Unet Loader (GGUF),safetensors 用标准 UNETLoader,weight_dtype 保持 default;Load CLIP 选 qwen3vl 编码器并把 type 设为 qwen_image;VAE 用标准 Load VAE。GGUF 那条路要装 leejet 维护的 ComfyUI-GGUF,把 MODEL 输出接回原来的下游输入,模板里的 Qwen Image 2.1 Cache 和采样链别动,cache 保持 auto。
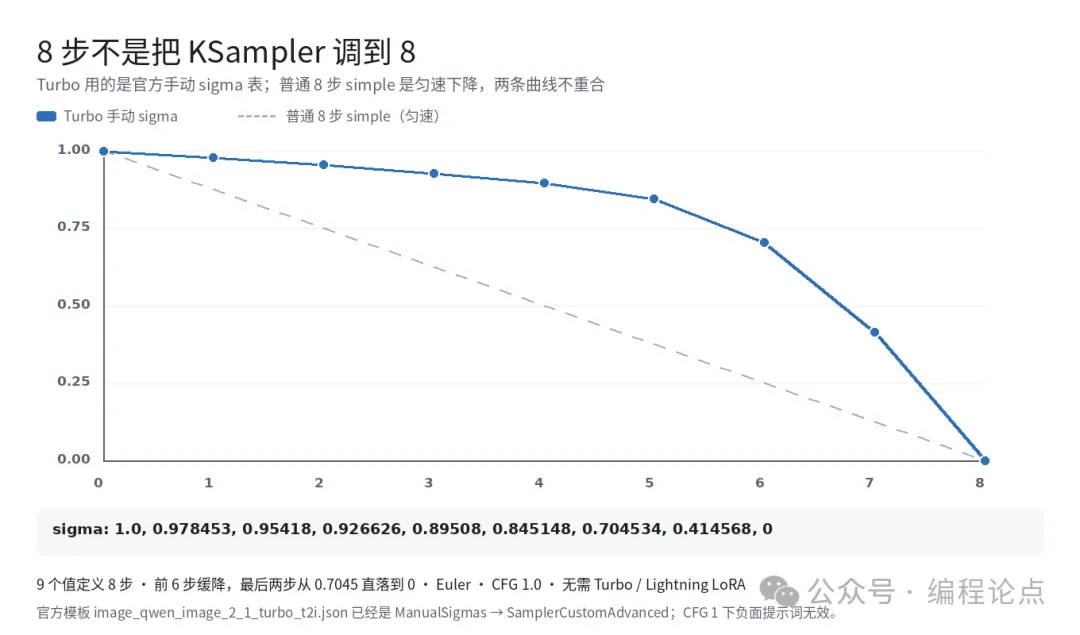
第一个坑就在这张图里。模板用的是 ManualSigmas → SamplerCustomAdvanced,9 个 sigma 值定义 8 步:
1.0, 0.978453, 0.95418, 0.926626, 0.89508, 0.845148, 0.704534, 0.414568, 0把普通 KSampler 设成 8 步 simple,复现不出这条曲线。CFG 1 之下负面提示词也不起作用,别浪费时间调。这套 Turbo 检查点不需要额外挂 Turbo 或 Lightning LoRA。
第二个坑是加载器版本。模型卡里 clone 的是 leejet 那份 ComfyUI-GGUF,别顺手拿停更的旧仓库,Qwen-Image 2.1 的架构支持是后加的。
五、几个别忽略的边界
量化掉多少画质,模型卡没给各档对比评测。Q4_K_M 相对高精度在文字渲染和细纹理上的差距,得自己固定 seed 跑样张判断。这个仓库没有 BF16 主模型档,对照测试得回官方 Turbo 仓取。
速度只有作者给的 10–20 秒,没有第三方复测。NVFP4 / FP8 的速度优势要新架构 GPU 才吃得满,老卡用 GGUF 的体验差距是实打实的。
「无审查」不等于「无后果」。没有过滤器也意味着没有护栏,再叠加 Qwen Research License 的非商用限制,这个包适合本地学习和内部试验,进商业产品线前先把许可和内容合规过一遍。
最后,仓库状态随时会变。下面的热度与时间戳是 2026-11-05 的快照。