ARTICLE · 1325285
【文档解析】新突破!阿里Qwen联合西电推出P2TPO,把页面级信用拆到元素与跨度上
【文档解析】新突破!阿里Qwen联合西电推出P2TPO,把页面级信用拆到元素与跨度上
整页文档解析里,两个输出的页面级分数可能一模一样,但一个漏了整张表、另一个只是把公式写错——只给一个页面级优势,模型永远分不清这两种错。
论文:P2TPO: Structure-Aligned Page-to-Token Credit Assignment for Full-Page Document Parsing
机构:阿里巴巴通义千问事业部、西安电子科技大学
会议:预印本
论文:https://arxiv.org/abs/2610.21979
页面级优势掩盖了什么
端到端整页文档解析的目标,是同时保住异构元素的内容与结构——文本、公式、表格各有各的规范。但论文指出一个常见现象:看起来已经很准确的输出里,仍然可能藏着局部错误与遗漏。
问题的根源在信用分配。用 GRPO 这类组相对方法训练时,一个页面级的优势值会被广播到该输出里的所有 token。论文用一个示意图把缺陷摆得很清楚:两个采样的输出可能拿到完全相同的页面级分数,但它们的错误性质截然不同——一个是整块遗漏,一个是内容有误、位置也不同。页面级聚合把这些差异在归类时抵消掉了。
论文用「固定权重可加页面效用」这个设定给出了一个理论陈述:按元素索引的对比,能保留页面级聚合会被抵消掉的局部质量差异。这句话是整篇论文的立足点——它不是说页面级信号没用,而是说页面级聚合在数学上会丢掉一部分本可用的对比信息。
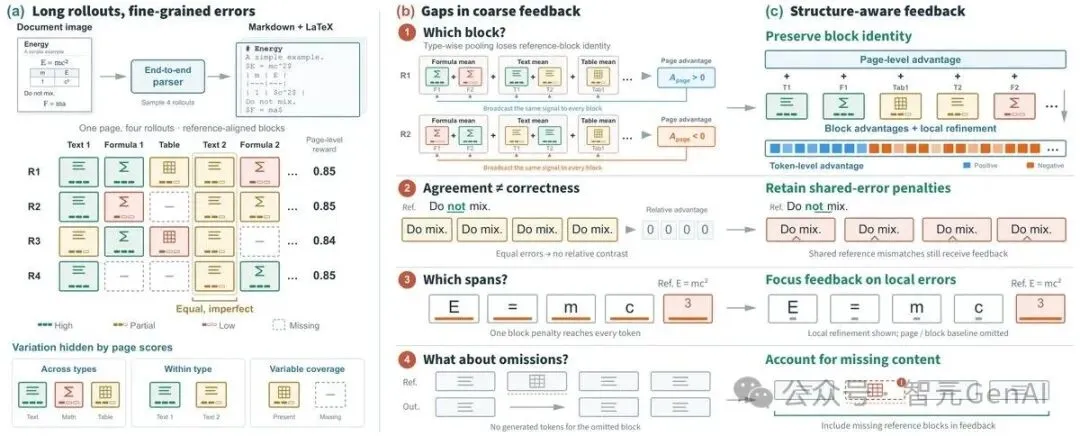
方法一:先把输出与参考做元素级对齐
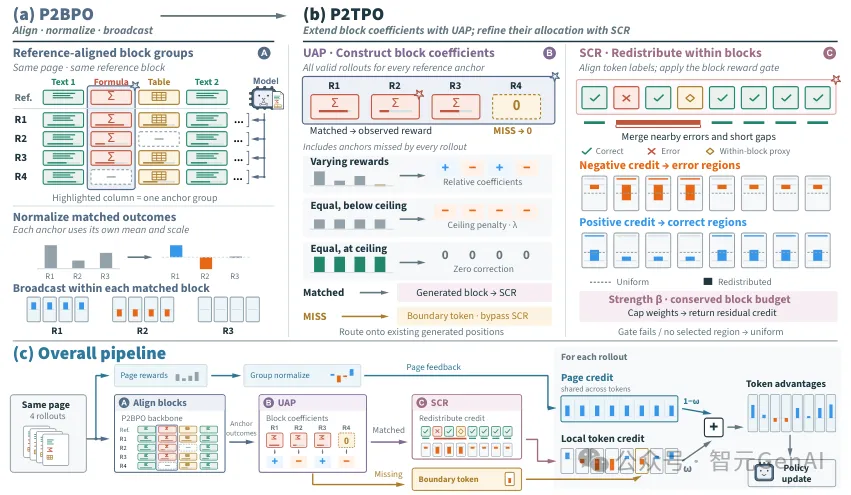
P2TPO 的第一步是参考元素对齐。给定页面图像 x 与提示 p,按 GRPO 的组采样协议抽取 G 个整页输出:
y_i ~ π_θold( · | x, p )
预测与参考都被解析成有序的文本、公式、表格块。然后做基于内容的序列对齐,允许插入与删除,同时保持阅读顺序。
这里有一个关键的设计细节:每个匹配到的预测,用它对应的参考块 y_k* 来索引,而不是它在生成序列中的位置。这个选择的后果很实际——同一个类别的不同实例在多次 rollout 之间保持可区分,即使前面的元素被漏掉了。如果用生成位置索引,「漏掉第一个表格」会导致它后面所有元素的位置全部错位,对齐就崩溃了。
记 i、k、t 分别索引 rollout、参考元素与 token。一个匹配块有类型相关的质量分数 s_{i,k} ∈ [0, c_k],以及长度为 L_{i,k} 的生成 token 支撑 ℬ_{i,k}。实现里取归一化分数 c_k = 1,并把生成块边界映射到互不相交的 token 跨度上。
方法二:P2BPO —— 按参考元素独立归一化
第一层信用是页到块策略优化(P2BPO),它对每个匹配的参考元素独立地做归一化。
对每个有有效匹配的参考 k,记 ℐ_k 为它的有效匹配 rollout 集合,μ_k^B 与 σ_k^B 为这些分数的均值与总体标准差,则
A_{i,k}^B = ( s_{i,k} − μ_k^B ) / σ_k^B,当 σ_k^B > ε;A_{i,k}^B = 0,当 σ_k^B ≤ ε,i ∈ ℐ_k
其中 ε ≥ 0 是数值容差。
这个式子的意义要对照 GRPO 才能看清。GRPO 的归一化是在整个页面上做的——平均分高但某元素很差的输出,和平均分低但该元素很好的输出,在页面尺度上可能拿到相近的优势。P2BPO 改成在「同一个参考元素」的跨 rollout 集合内归一化,于是哪怕一个输出的页面总分很高,只要它在某个元素上相对其他 rollout 明显更差,这个元素就会收到一个负系数。
随后每个系数在 ℬ_{i,k} 上广播,于是同一个响应里的不同块可以拿到不同的符号与幅度。这正是论文强调的「元素索引对比保留局部差异」——一个输出可以同时在某个元素上被奖励、在另一个元素上被惩罚。而参考级对比还顺带保住了页面级或类别级聚合会掩盖的对比。
方法三:UAP —— 处理遗漏与「全体同分」两种退化
只有 P2BPO 还不够,因为有两种情形它处理不了。
情形一:整块遗漏。 一个参考元素在某次输出里根本没生成,它就没有匹配块,也就没有 s_{i,k}。情形二:一致但都不完美。 所有 rollout 在该元素上都拿到相同的不完美分数,此时组内标准差为零,归一化退化成 0——模型得不到任何改进方向。
统一锚定定价(UAP) 就是来补这两处的:
A_{i,k}^U = ( Q_{i,k} − μ_k ) / σ_k,当 σ_k > ε;A_{i,k}^U = − λ · h( μ_k, c_k ),当 σ_k ≤ ε
其中
h( u, c ) = max( 0, c − u )
第二支的含义值得细读:当组内分数没有差异(σ_k ≤ ε)但均值 μ_k 明显低于质量上限 c_k 时,给出一个负的、与差距成正比的系数。也就是说,「大家都一样烂」不再意味着「无需改进」,而是被明确地惩罚——惩罚幅度由「离质量天花板有多远」决定。这解决了退化情形二。
而 Q_{i,k} 的构造同时容纳了匹配与遗漏两类结果:遗漏的块不再从信用体系里消失,而是以「低于锚点」的形式进入对比。这解决了退化情形一。用论文的表述,UAP 的作用是在采样输出对某个参考元素给出相同但不完美的分数时,提供相对于一个固定质量天花板的反馈。
方法四:SCR —— 在块内把信用再分到正确的跨度上
到这一步,信用还停在「块」的粒度。但一个块内部可能既有对的部分也有错的部分,如果把块级系数均匀分给块内每个 token,正确的 token 会被错误的 token 拖累。
跨度信用重分配(SCR) 负责把已有的块信用按对齐的正确与错误跨度重新分配。它引入一个重分配系数,其构造满足两个约束:
ν_{i,k}(t) ≥ 0,且 Σ_t ν_{i,k}(t) = 1
也就是重分配只是在块内搬动信用,不改变总量。具体形式是
d_{i,t} = 1 − η_{i,k} + η_{i,k} · ( L_{i,k} · u_{i,t} / N_{i,k} )
其中 N_{i,k} = Σ_{t ∈ ℬ_{i,k}} u_{i,t} 是块内被判定为正确的 token 计数,u_{i,t} 是对应的指示变量。并且论文明确保证
Σ_{t ∈ ℬ_{i,k}} d_{i,t} = L_{i,k}
这正是前面那个「总量守恒」约束的落地:分配后的系数总和等于块长度,因此块的总体信用没有被放大或缩小,只是在跨度之间重新分布了。
η_{i,k} 的取值形式为
η_{i,k} = min{ β, p_{i,k} ( D − 1 + β ) }
这个设计限制了重分配的强度上限(不超过 β),并根据块内的质量比例 p_{i,k} 决定实际强度——块内质量差异越大,重分配越有意义。
对块内遗漏,SCR 用边界代理(boundary proxies)来处理——因为块内缺失没有对应的生成 token 可以直接标记,只能落在边界位置上作为代理。而整元素遗漏则走另一条路:直接用单独的边界路径,论文明确说明遗漏块的系数直接到达边界 token,绕过 SCR。这个分路是有道理的——整块缺失时块内没有可分的跨度,重分配无从谈起,只能落在边界上作为「这里本该有内容」的信号。
最终的 token 级系数是局部项与页面系数的合成:
A_{i,t} = ( 1 − ω ) · A_i^P + ω · C_{i,t}
其中 A_i^P 是页面级优势(在页面尺度上归一化,σ_𝒢 > 1e-8 时用标准归一化,否则退化为均值中心化),C_{i,t} 是元素与跨度级的局部信用。ω 就是「局部信用占多大比重」这个权重——这一项把「页面的整体好坏」与「具体到某个 token 的对错」按比例混合起来。
实验:六个基准、13 个评测切分上全面领先
论文的主实验设定是 Qwen3.5-2B,用 700K 页做 SFT 初始化,然后比较各强化学习方法。报告的是五次种子的均值 ± 标准差,在 100 次更新后。
评测覆盖 六个基准、13 个评测切分,包括用 OmniDocBench 评测器的五个基准,以及用官方评测器汇总数字与拍照两个赛道的 FinixDocBench;另有两个评估拍摄鲁棒性的基准(Real5 与 Wild)复用 OmniDocBench 的源页面。
主结论是:P2TPO 在每个基准的种子平均分数上都优于所有被评测的策略优化基线。论文给出的具体初始化与对比数字包括:OmniDocBench v1.6 的 Init(RL 前)为 92.17,GRPO 为 92.25 ± 0.34,GSPO 92.38 ± 0.18,GDPO 92.31 ± 0.24,RDPO 92.32 ± 0.35,P2BPO 92.48 ± …
消融部分的信息量更大。论文做了两组消融:
1. UAP 干预(去掉 UAP):论文报告完整的 P2TPO 在 13 个切分中的 8 个上平均分超过它;
2. SCR 分配控制(去掉 SCR,或去掉一致性处理):完整方法在 11 个切分上超过它。
更值得注意的是一个稳定性指标:完整 P2TPO 的跨种子标准差更低。这一点比平均分提升更有说服力——一个降低方差的方法说明它带来的不是运气,而是更稳定的信号。
论文还设置了一组很有意义的对照:用 GRPO 与 P2BPO 做对比(对应消融表 (a) 的组),也就是「页面级归一化」与「元素级归一化」的直接比较。这个对照把「归一化的粒度」这一个变量单独隔离出来,因此对比结果直接对应论文的核心主张。
为什么有效:把「一个系数」换成「一条从页面到 token 的分解链」
P2TPO 的结构可以概括成一条自顶向下的分解链:
块级对齐(对齐 + 索引)→ 元素级归一化(P2BPO)→ 补齐退化情形(UAP)→ 块内重分配(SCR)→ 与页面级优势合成
每一层解决的是一层精度问题。P2BPO 解决「元素之间的差异被平均掉」,UAP 解决「遗漏没有分数」与「同分没有梯度」,SCR 解决「块内对错被混合」,最后的加权合成解决「局部信号与全局信号如何配比」。
这条链的价值在于它每一步都在提高信用的分辨率,同时保证总量可控。SCR 的守恒约束防止了分辨率提高带来的信号放大;UAP 的固定质量天花板防止了「全组同分」时的静默;η 的上限 β 防止了重分配过激。分辨率与稳定性同时被照顾到,这是它比「直接把信用拆细」更难的地方。
局限与总结
局限方面:对齐依赖基于内容的序列比对,对解析结构本身的错误敏感(如果预测被打成了错误的块类型,对齐就可能失败);UAP 的负系数形式 −λ·h(μ_k, c_k) 与 SCR 的 η 上限 β 都是需要调节的超参,论文未给出跨数据集的调参规律;F3 中「缺失块系数直接到边界 token」的实现在块类型密集相邻时可能产生边界归属歧义;此外,主实验集中在以 Qwen3.5-2B 为骨干的设定上,论文虽提及 50K 页、4B 与 Qwen3-VL-2B-Instruct 等额外设定,但 2B/700K 之外的结果未作为主要对比呈现。
一句话总结 P2TPO:整页解析的信用分配不该止步于页面级——先用参考元素对齐把块身份钉住,再按元素独立归一化保住局部差异,用统一锚定定价补齐遗漏与「同分」两种退化,最后在守恒约束下把信用重分到正确的跨度上,页面级信号才不再把「漏一张表」和「写错一个公式」混为一谈。
更多更全的Arxiv论文、直播、求职信息,关注[大模型技术]知识星球
点击小程序链接加入:大模型技术知识星球
欢迎关注我们的公众号【大模型技术】,每日AI相关新闻推送、arxiv论文分享