ARTICLE · 1333737
AgentScope Java 源码图解:从一次调用,看懂 Agent 的运行过程
源码分析项目链接:https://github.com/liulangjietou/AgentScope-source-analysis
调用一次 agent.call(...),里面可能已经请求了几轮模型、执行了一批工具,还保存了下一次继续执行需要的会话状态。返回一条消息,也可能意味着正在等用户确认,或者正在等外部工具提交结果。
读 AgentScope Java 源码,最容易迷路的地方就在这里:同一个入口,既承载普通问答,也承载工具循环、暂停恢复和失败清理。只顺着方法往下翻,很快就会同时碰到 Reactor、中间件、权限和持久化。
先抓住一条主线:输入进入会话,模型决定下一步,框架执行工具,结果回到上下文,直到产生终态。 再沿着这条主线看,哪些逻辑控制执行,哪些逻辑保存状态,哪些逻辑只是向前端报告进度。
我整理的 AgentScope-source-analysis 项目按这个顺序组织了十章:模块地图、消息与状态、ReAct、工具、模型、中间件、Harness、扩展生态、历史应用映射和迁移问题。
这篇以指南绑定的上游提交 dcb131a 为准,对应 AgentScope Java 2.1.0-SNAPSHOT,使用 Java 17 与 Project Reactor。指南中的 customer_work 则保留了依赖 2.0.3 的历史应用案例,阅读时要分清版本。下面的框架图和方法名沿用指南的 2.1 源码体系。
1. 先看懂循环,再看全景
ReAct 的两个动作,在这里有直接对应的方法:reasoning() 请求模型,acting() 处理工具调用。一次模型响应可能包含普通文本,也可能包含要求调用工具的 ToolUseBlock。
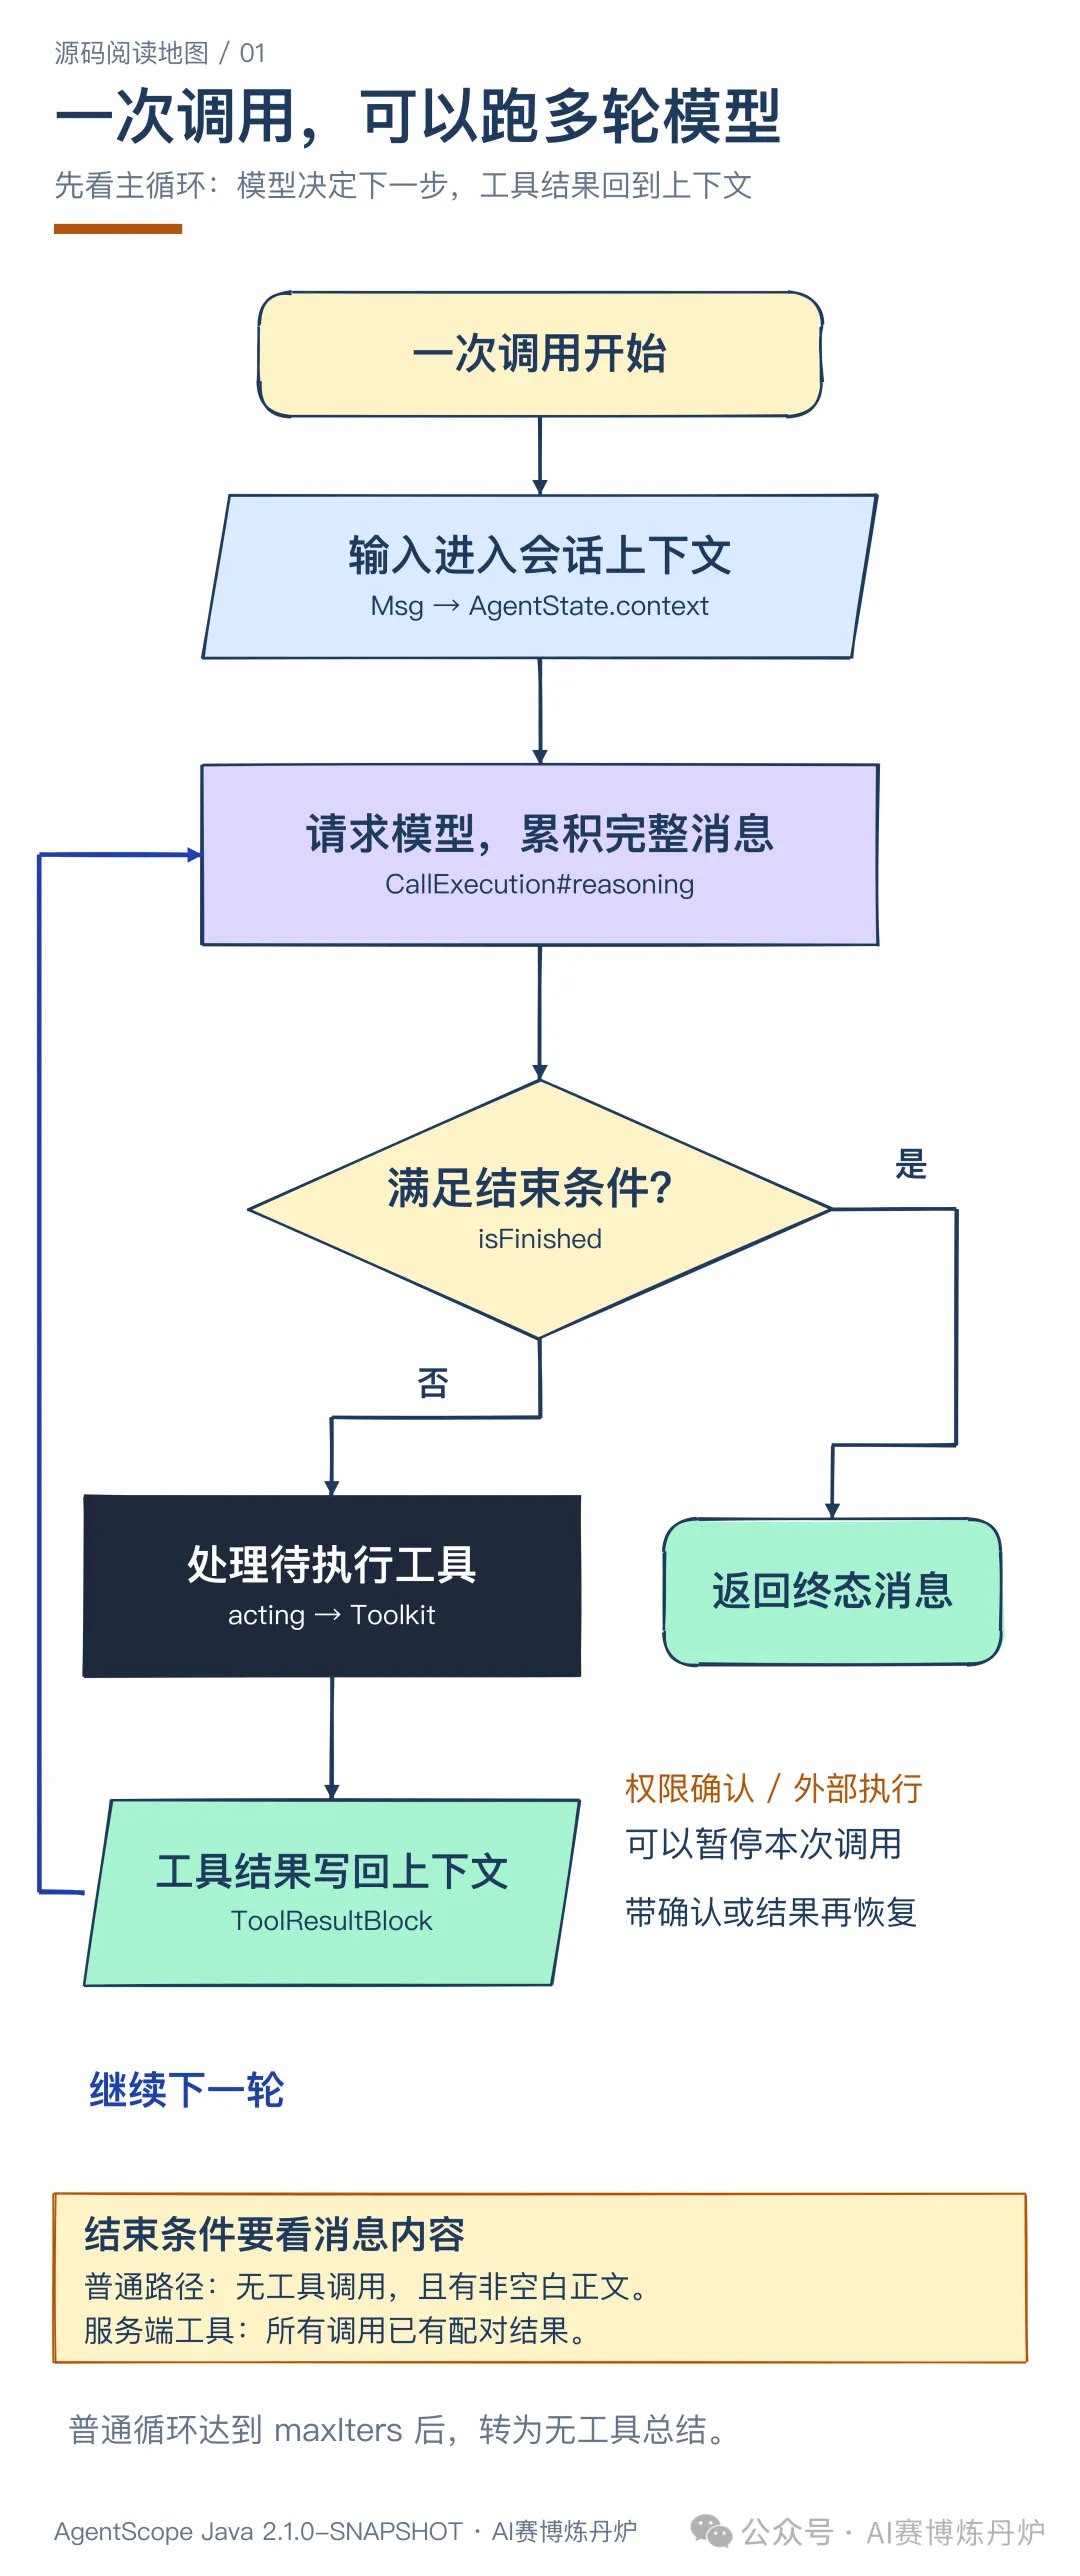
图里的“结束判断”有具体条件。普通文本路径要求没有工具调用,而且至少有一个非空白文本块。只返回 thinking、正文为空,不能直接当作已经回答了用户。服务端工具还有另一条路径:如果全部工具由模型厂商执行,配对结果也已经随助手消息返回,就无需再在本地执行。
工具执行后,框架将 ToolResultBlock 写回上下文,模型才知道这一步做成了什么、哪里失败、接下来能做什么。maxIters 默认是 10;达到普通循环上限后进入 summarizing(),不再给模型提供工具,生成总结并标记 MAX_ITERATIONS。因此,迭代上限也不能简单理解成整次请求最多发生十次模型调用。
有了这条循环,再看全景图。蓝色突出执行主干,紫色表示模型相关逻辑,绿色用于状态与结果,金色强调判断和暂停。 架构图按职责分区,连线区分调用与扩展装配。全景细项适合点开原图查看,后面的局部图分别展开关键路径。
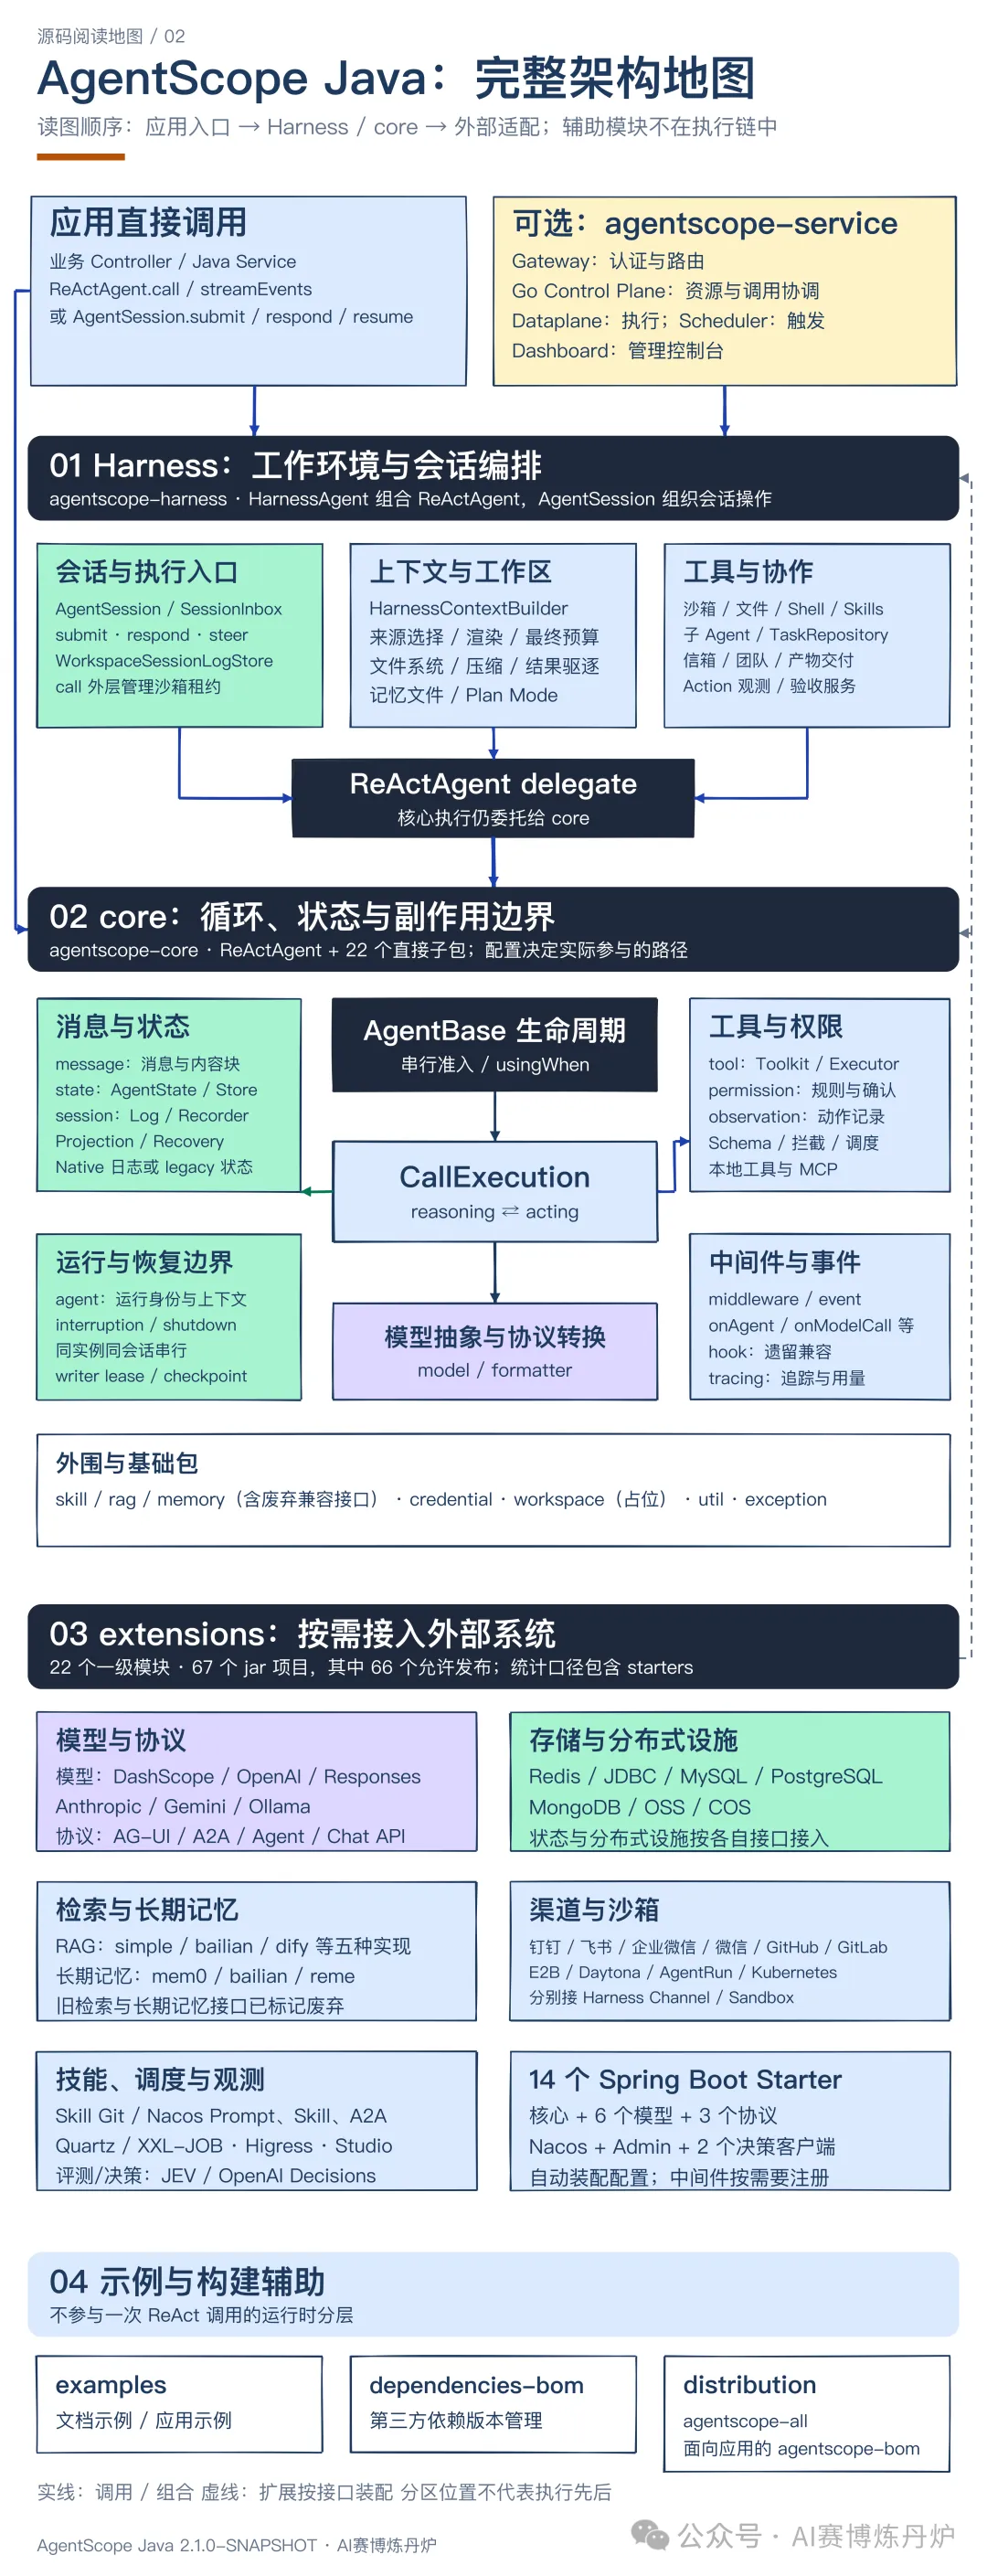
根 Maven 工程有七个顶层模块,但真正读运行过程时,先分清四个职责区域就够了。
core 执行 Agent。 它定义消息、运行上下文、ReAct 循环、工具、模型接口、权限、中间件、事件和原生会话日志。具体模型厂商实现位于扩展模块。 harness 组合工程能力。 HarnessAgent内部持有ReActAgent delegate,装配工作区、文件系统、沙箱、技能、子 Agent、上下文预算和会话操作。extensions 接外部系统。 模型、存储、协议、渠道和 Spring Boot Starter 都在这里;各扩展按能力依赖 core 或 harness。 service 提供管控平台。 Gateway、Go Control Plane、Java Dataplane、Scheduler 与 Dashboard 位于框架之上。调用一个裸 ReActAgent并不需要部署这套平台。
剩下的 examples 用于应用示例,dependencies-bom 管第三方版本,distribution 包含面向应用的依赖聚合和 BOM。BOM 管版本,不会自行把依赖加入 classpath。
模块地图和对应目录在指南第一章。
链接:https://github.com/liulangjietou/AgentScope-source-analysis/blob/a861e5ef9f1ee6134f3cf97fb4586de93a75ea1a/01-模块全景与依赖拓扑.md
2. 一次 call,先经过哪些边界
下面这张方法级长图可以配着 IDE 使用。它保留从公共入口到状态保存的主干,右侧展开调用上下文、模型与工具的下游;复杂分支再由后面的局部图说明。
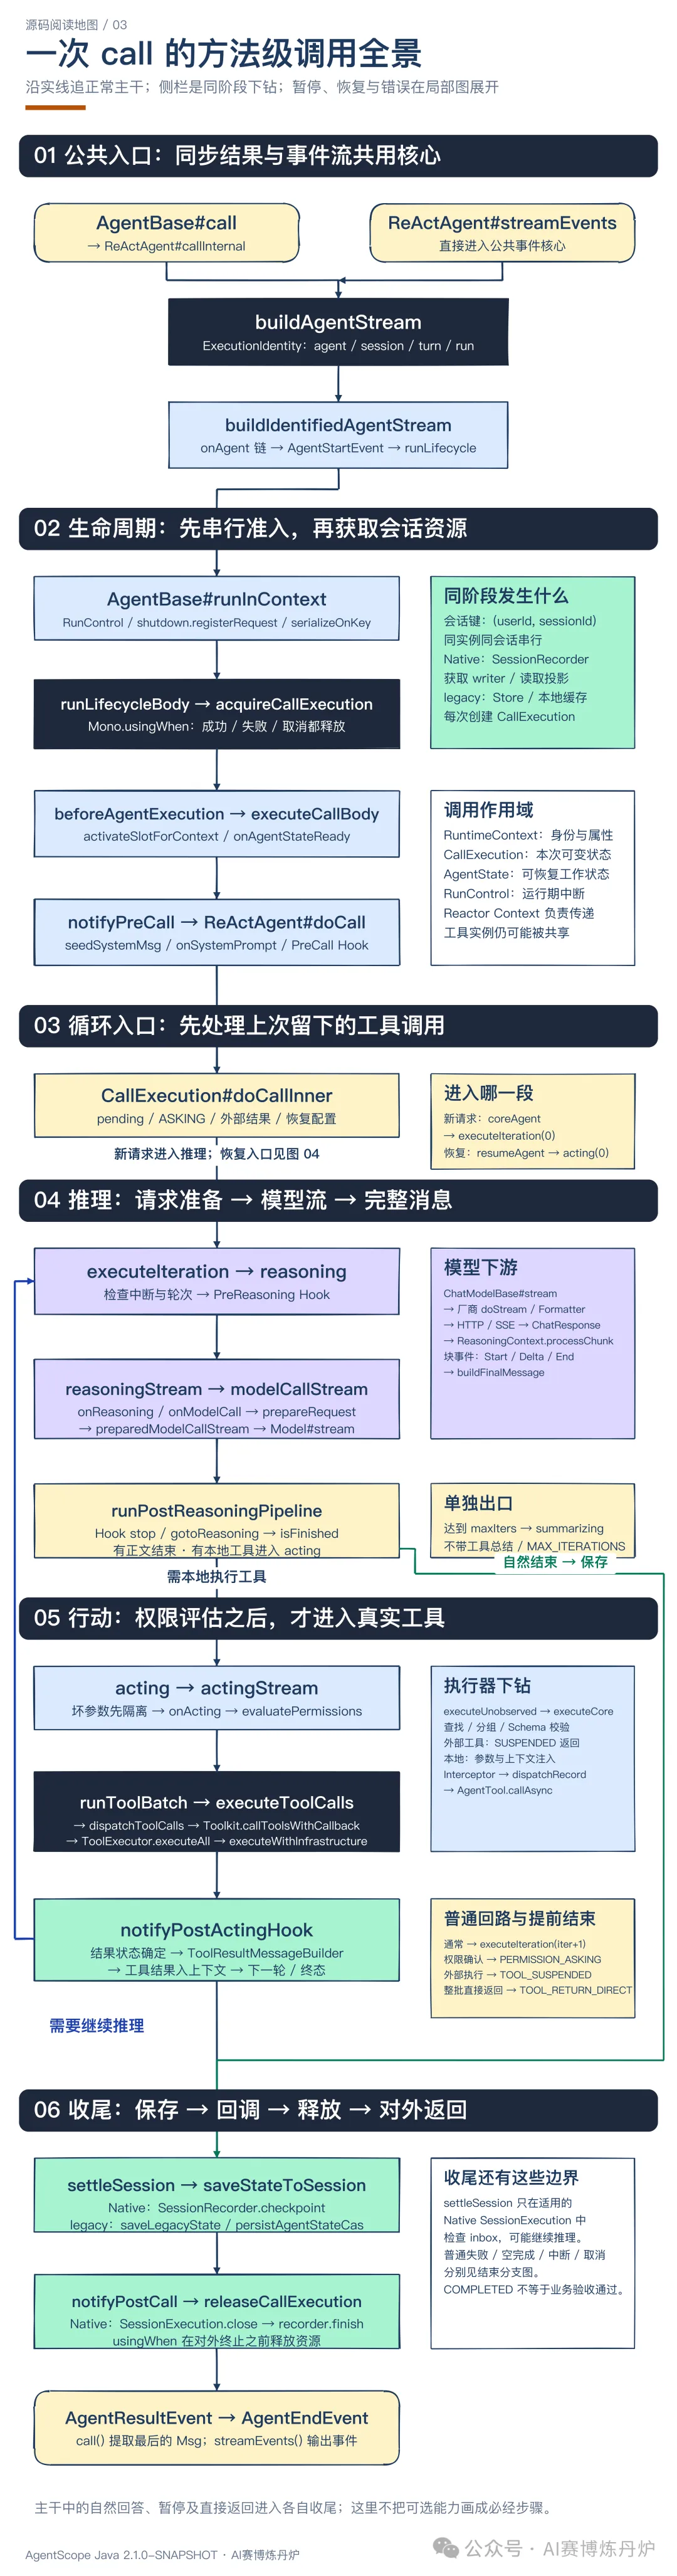
入口有一个容易忽略的设计:**call() 和 streamEvents() 共用 buildAgentStream()。**
call() 通过 callInternal() 进入事件流,再过滤 AgentResultEvent,取最后一条结果消息;streamEvents() 直接把类型化事件交给调用方。两者的 onAgent 中间件链都在这条公共路径上装配。内部继续执行 runLifecycle(),避免再次调用公共 call() 而重复包裹中间件。
接下来由 AgentBase 管生命周期:
runInContext()读取本次RuntimeContext,绑定RunControl,注册在途执行。serializeOnKey()按(userId, sessionId)做同实例内的同会话串行准入;不同会话可以并行。runLifecycleBody()用Mono.usingWhen包住会话资源的获取、执行与释放。executeCallBody()进入notifyPreCall → doCall → notifyPostCall,并接入错误处理。
这里的职责划分有实际作用。排队与资源释放属于一次调用的生命周期,放在 AgentBase;推理和行动的循环属于 ReAct 行为,放在 ReActAgent;每次调用的可变数据集中到内部类 CallExecution。
CallExecution 持有本次 AgentState、权限引擎、工具视图和中断信号。共享 Agent 实例上的配置可以复用,本次运行的数据则沿 Reactor Context 传播。这也限定了并发保证的范围:实例内串行闸门不等于跨副本分布式锁。 Native Session 还要依靠持久化后端的 writer lease 与提交协议。
AgentBase 的生命周期入口可以从这里跟读。
链接:https://github.com/agentscope-ai/agentscope-java/blob/dcb131a3f257f06e2b7ddcd3dacfe75d31d04028/agentscope-core/src/main/java/io/agentscope/core/agent/AgentBase.java#L313
3. 为什么重新 call,有时会直接执行工具
进入 CallExecution#doCallInner() 后,框架先检查历史中有没有尚未配对结果的工具调用。新输入不一定意味着新一轮推理。
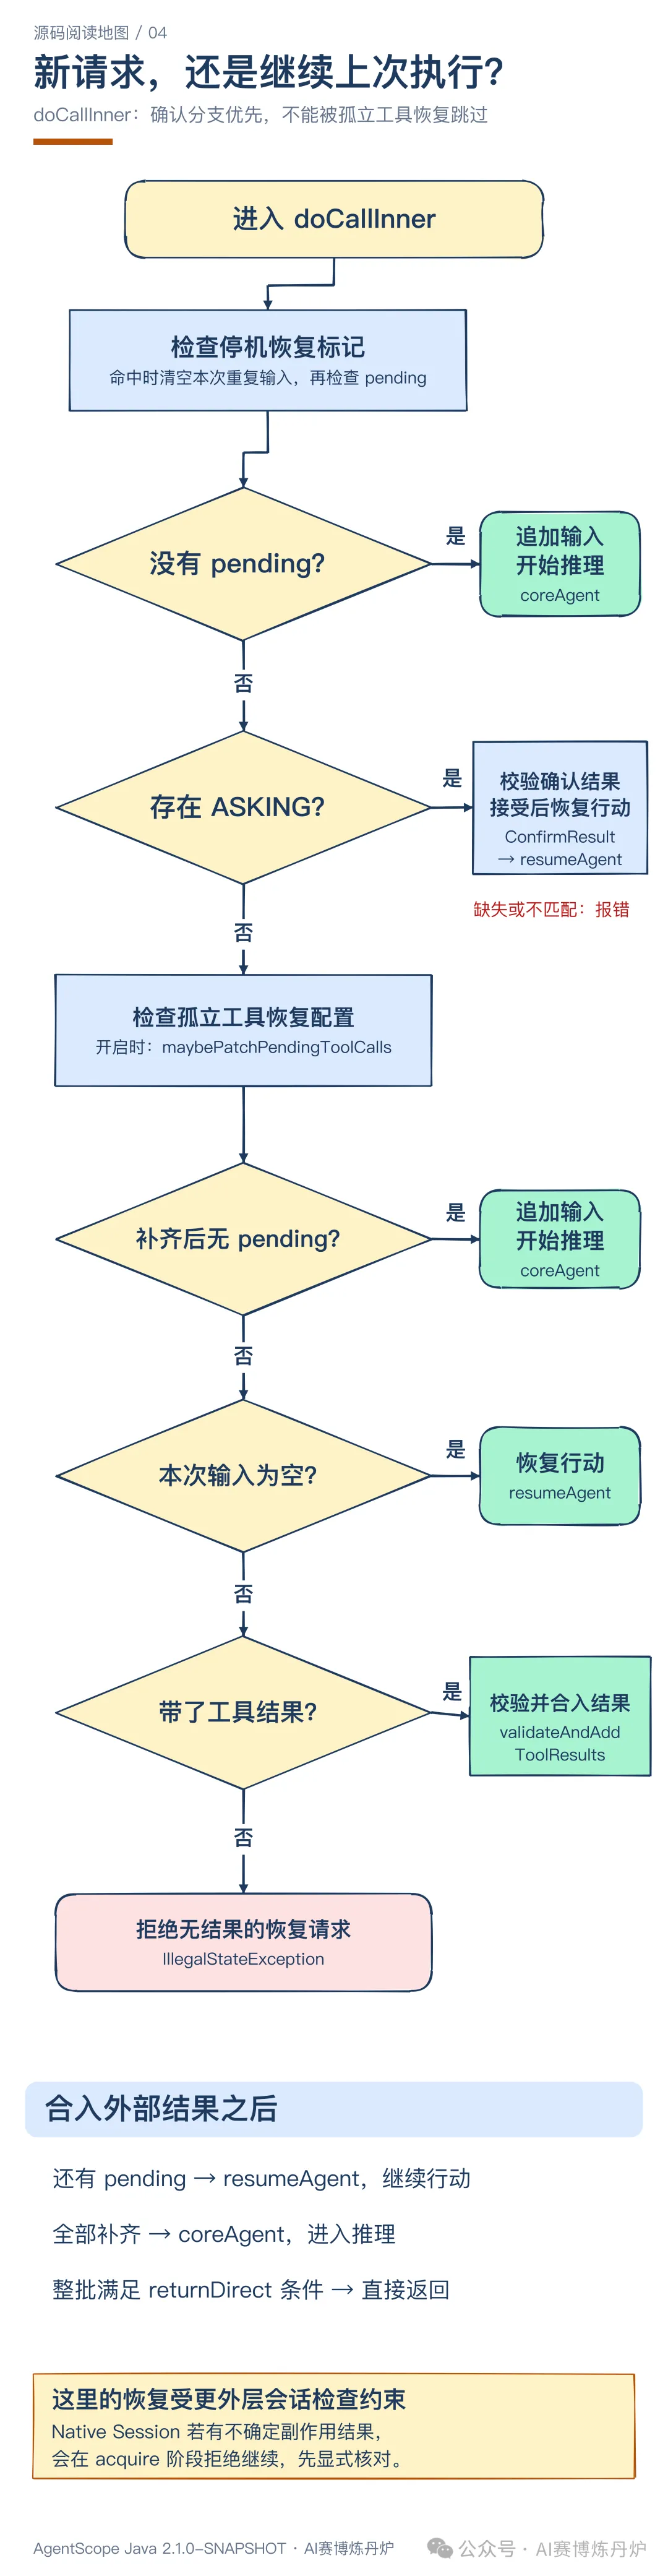
最常见的情况是没有 pending 工具:追加输入,进入 coreAgent(),从 executeIteration(0) 开始。
如果存在 ASKING 工具,说明上次停在权限确认。调用方必须通过 Msg.METADATA_CONFIRM_RESULTS 提交 ConfirmResult。校验并接受确认后进入 resumeAgent(),直接从 acting(0) 继续。这样才能对准原来的工具调用,不让模型重新生成一个可能不同的动作。
如果挂起的是外部工具,调用方需要提交与原调用对应的 ToolResultBlock。补齐后根据剩余 pending 状态继续行动或开始推理;没有输入时也可以进入 pending 工具恢复路径。既有 pending,又只发来普通文本,且没有适用的恢复处理,就会报错。
enablePendingToolRecovery 默认关闭。显式开启后,它可以为孤立的 pending 调用补错误结果,但 ASKING 分支优先,不能借这个开关跳过人工确认。Native Session 如果发现工具副作用结果不确定,还会在更早的会话获取阶段拒绝恢复;这种情况必须先核对结果。
源码入口是 doCallInner(),分支顺序本身就是恢复协议的一部分。
链接:https://github.com/agentscope-ai/agentscope-java/blob/dcb131a3f257f06e2b7ddcd3dacfe75d31d04028/agentscope-core/src/main/java/io/agentscope/core/ReActAgent.java#L2178
4. 模型调用:先准备请求,再把分片还原成消息
reasoning() 要组装三类输入:消息、工具 Schema、生成选项。消息里有会话上下文和系统提示词,工具列表取自本次会话激活的工具组,选项里包含模型生成与结构化输出等配置。
这份输入依次经过 onReasoning、onModelCall,到真正发出请求前,再由 ModelRequestPreparer 处理最终请求。Harness 的上下文预算就接在这里。
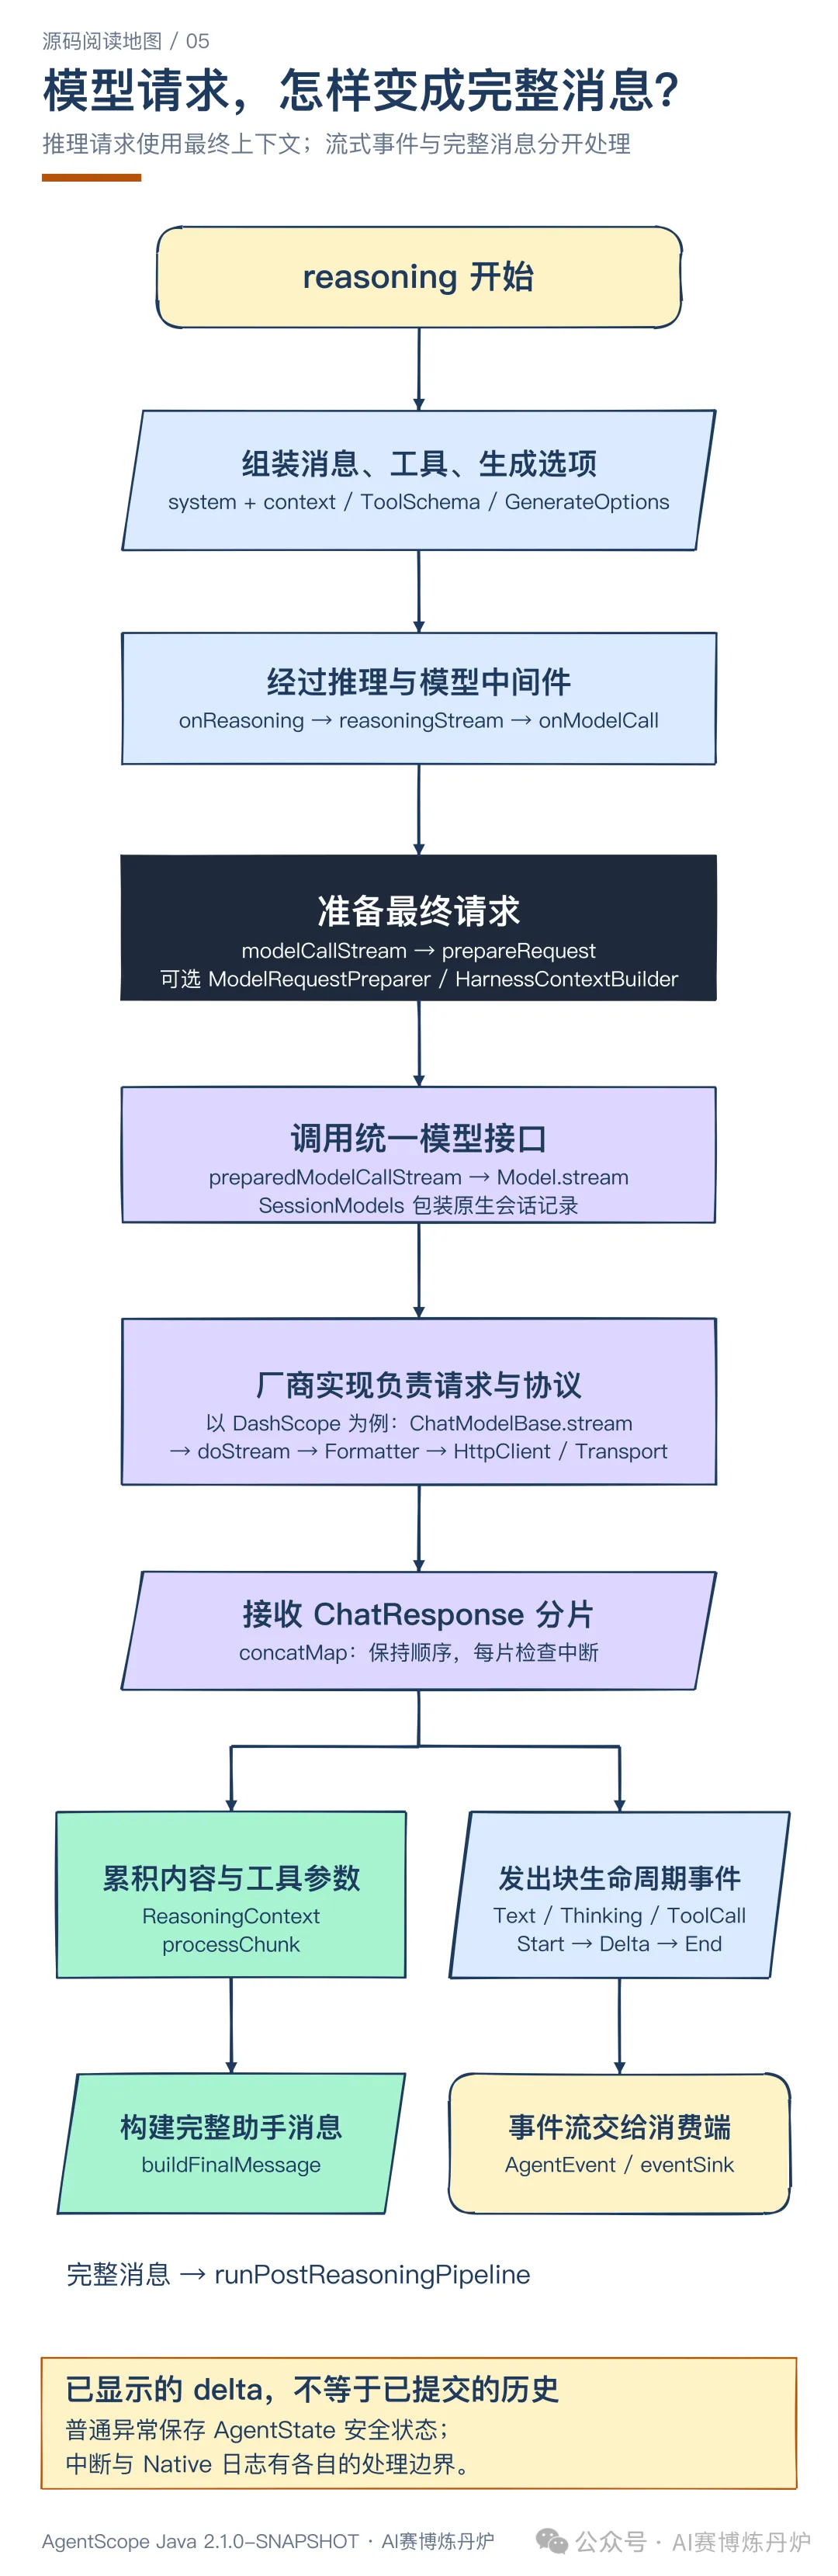
core 中的 Model 把推理调用统一成 stream(messages, tools, options),返回 Flux<ChatResponse>。以 DashScope 路径为例,ChatModelBase#stream() 包裹追踪,具体模型的 doStream() 组织厂商请求,Formatter 转换消息与工具,HTTP Client 和 Transport 处理网络收发,再将响应解析回统一的 ChatResponse。
返回的分片有两种用途:一边产生文本、思考、工具调用等事件,供前端观察;另一边由 ReasoningContext 累加,最终构造完整助手消息。流式工具参数也要等到累积完成后才能判断是不是合法 JSON 对象。
前端已经看到一段文本,不等于这段文本已经成为可恢复的完整消息。 普通失败路径保存的是已经进入 AgentState 的安全状态;未完成的模型分片通常还在当前轮累加器里。中断另有专门处理,不能与普通模型异常混为一谈。
中间件切点也影响“改了哪里”。普通推理轮中,onModelCall 改写后的文本增量会回灌累加器;在更外层 onReasoning 或 onAgent 改写显示文本,不会因此同步改写那条历史消息。onActing 的工具事件则在内层发布,不能假设外层过滤它们就一定改变前端所见。做脱敏或展示转换前,要先明确需要改变输出流、历史上下文,还是工具本身的结果。
模型层与事件层的对应关系,指南第五、六章有完整展开。
链接:https://github.com/liulangjietou/AgentScope-source-analysis/blob/a861e5ef9f1ee6134f3cf97fb4586de93a75ea1a/06-Middleware与事件流.md
5. 工具执行:真正调用业务代码之前,还要经过什么
模型返回工具名和参数后,acting() 先隔离损坏的参数。半截 JSON 会被转换成与原工具调用配对的 ERROR 结果,不会悄悄替换为 {} 再去执行业务方法。
剩余调用经过行动中间件和权限评估,才进入工具批次。这里要分清两层:ReAct 的权限门负责判断这次动作是否放行;Toolkit 的执行器负责工具查找、可用性、参数与实际执行。 直接调用 Toolkit.callTool(),并不会自动经过外层 ReAct 权限门。
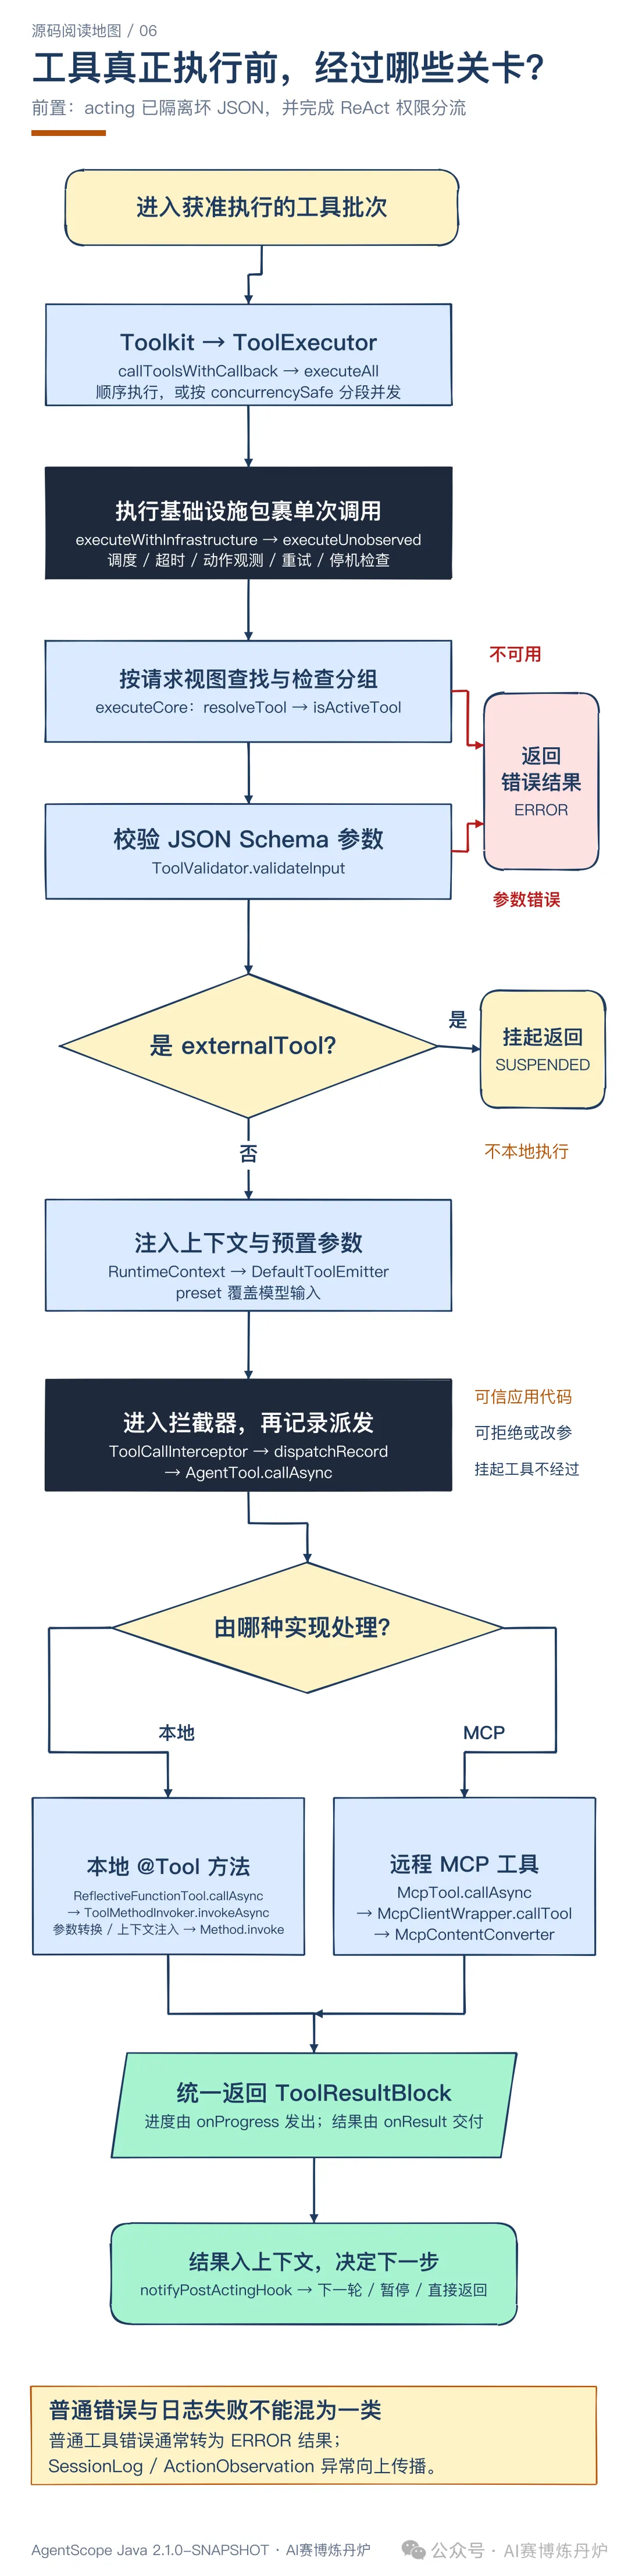
ToolExecutor#executeCore() 的顺序很值得细读:先按本次请求视图查找工具,再检查激活分组与 JSON Schema;通过后,如果是外部工具,就返回 SUSPENDED,交给外部系统执行。
本地路径继续合并运行上下文、创建进度发送器、注入预置参数,再进入 ToolCallInterceptor 链。预置参数在注册时从模型可见 Schema 中排除,执行时覆盖模型输入,适合由框架控制的租户标识等信息。但后面的拦截器仍能修改参数,它属于可信应用代码,不能当成不受约束的插件入口。
@Tool 方法由 ReflectiveFunctionTool 包装,经过 ToolMethodInvoker#invokeAsync() 转换参数、注入上下文,最终反射调用业务方法。MCP 工具则走 McpTool#callAsync(),交给 McpClientWrapper 发送远程请求,两条路径都返回 ToolResultBlock。
批量调用也不等于全部并行。关闭并行时顺序执行;开启后,连续的并发安全工具可以组成并发段,不安全工具形成串行屏障。并发段保持结果列表的声明顺序,进度和完成通知则可以随执行过程发出。
普通工具异常通常转换成错误结果,让模型获得下一步调整依据。会话日志和动作观测异常继续向上传播,因为这时连“刚才做了什么”都可能无法可靠记录。工具进度事件 ToolProgressEvent 也不能被当作最终成功结果。
还有一个会影响接入方式的边界:该源码中,权限评估遇到直接实现 AgentTool、但不继承 ToolBase 的工具,会直接放行;并发分区也把这类工具按可并发处理。需要框架权限规则的自定义工具,应使用 @Tool 包装或合适的 ToolBase 实现,再核对工具自身的检查逻辑。
工具执行顺序可以直接对照这个方法。
链接:https://github.com/agentscope-ai/agentscope-java/blob/dcb131a3f257f06e2b7ddcd3dacfe75d31d04028/agentscope-core/src/main/java/io/agentscope/core/tool/ToolExecutor.java#L217
6. 人工确认跨越两次调用,状态必须对得上
假设模型提出一个需要审批的工具调用。框架将工具标记为 ASKING,发出 RequireUserConfirmEvent 和停止请求,返回原因是 PERMISSION_ASKING。本次调用到这里结束,执行资源随后释放。
用户点击同意,才发起下一次调用。两次调用之间保存的是工具调用与确认状态,无需一直占着原来的执行线程等待。
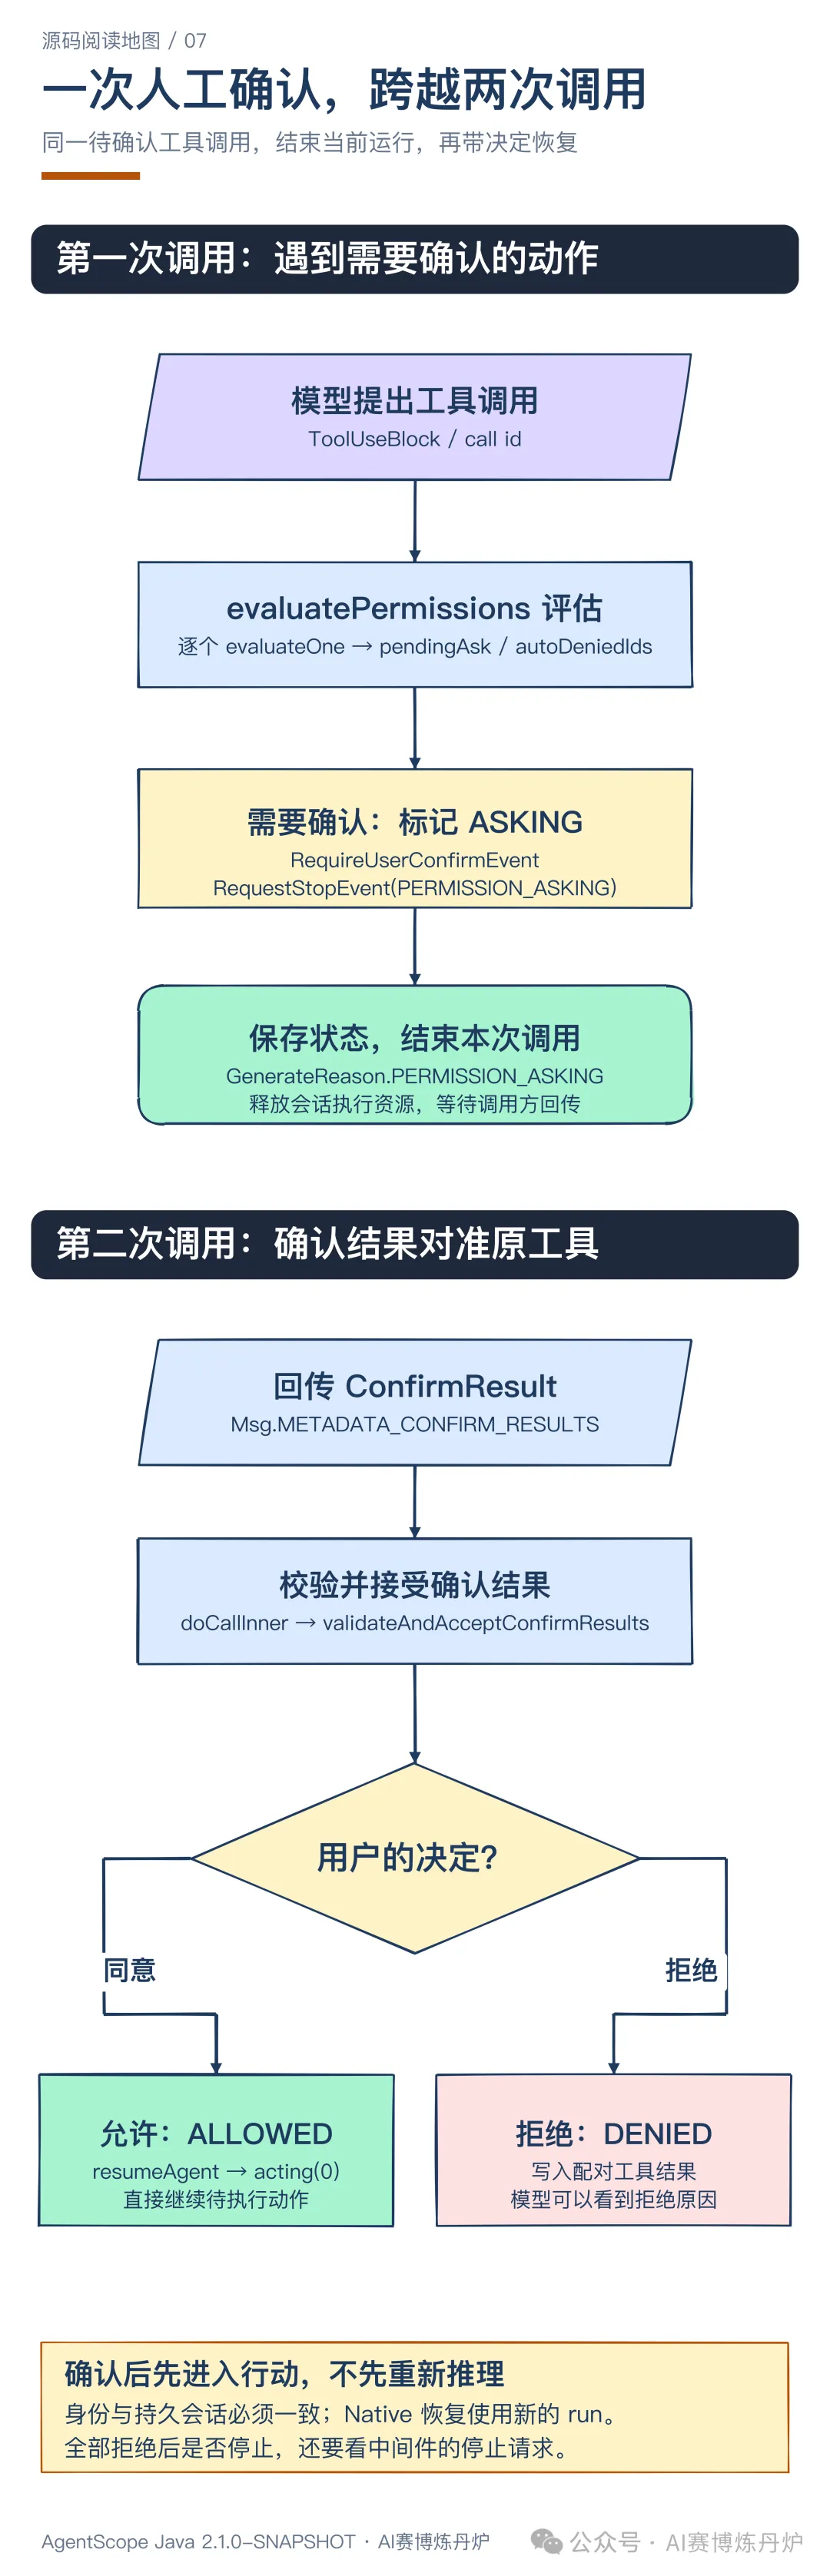
确认结果需要关联原工具调用。允许后标记为 ALLOWED,恢复行动;拒绝则写入 DENIED 工具结果。最近一轮全部被拒时,框架发出 AllToolsDeniedEvent,中间件可以要求停止;没有停止要求时,循环可以继续,让模型根据拒绝结果调整做法。
权限规则也有顺序:工具级 deny、ask 优先,然后检查工具自身限制,再看 allow 和模式兜底。默认模式下如果没有配置规则和额外工作目录,会走简化检查路径,不能推断“没配规则就一律询问”。
外部工具的暂停原因是 TOOL_SUSPENDED,恢复数据是工具结果;人工确认的暂停原因是 PERMISSION_ASKING,恢复数据是确认决定。两种暂停解决不同问题,前端不能只用一个“继续”按钮而忽略回传协议。
returnDirect 则是另一类结束路径:只有这一批满足条件的工具全部声明直接返回、全部成功且没有挂起等情况时,框架才把结果作为最终回答,标记 TOOL_RETURN_DIRECT。混入普通工具或失败结果,仍要回到模型。
7. 会话、运行和日志,分别保存什么
要读懂恢复,先把几个容易混用的对象分清。
MsgContentBlock | |
AgentState | |
RuntimeContext | |
RunControlAgentRun | |
AgentState.context 会随着压缩而变化,它与完整历史不是同一份数据。面向前端的 AgentEvent 流,也不能直接当成已持久化的完整会话。
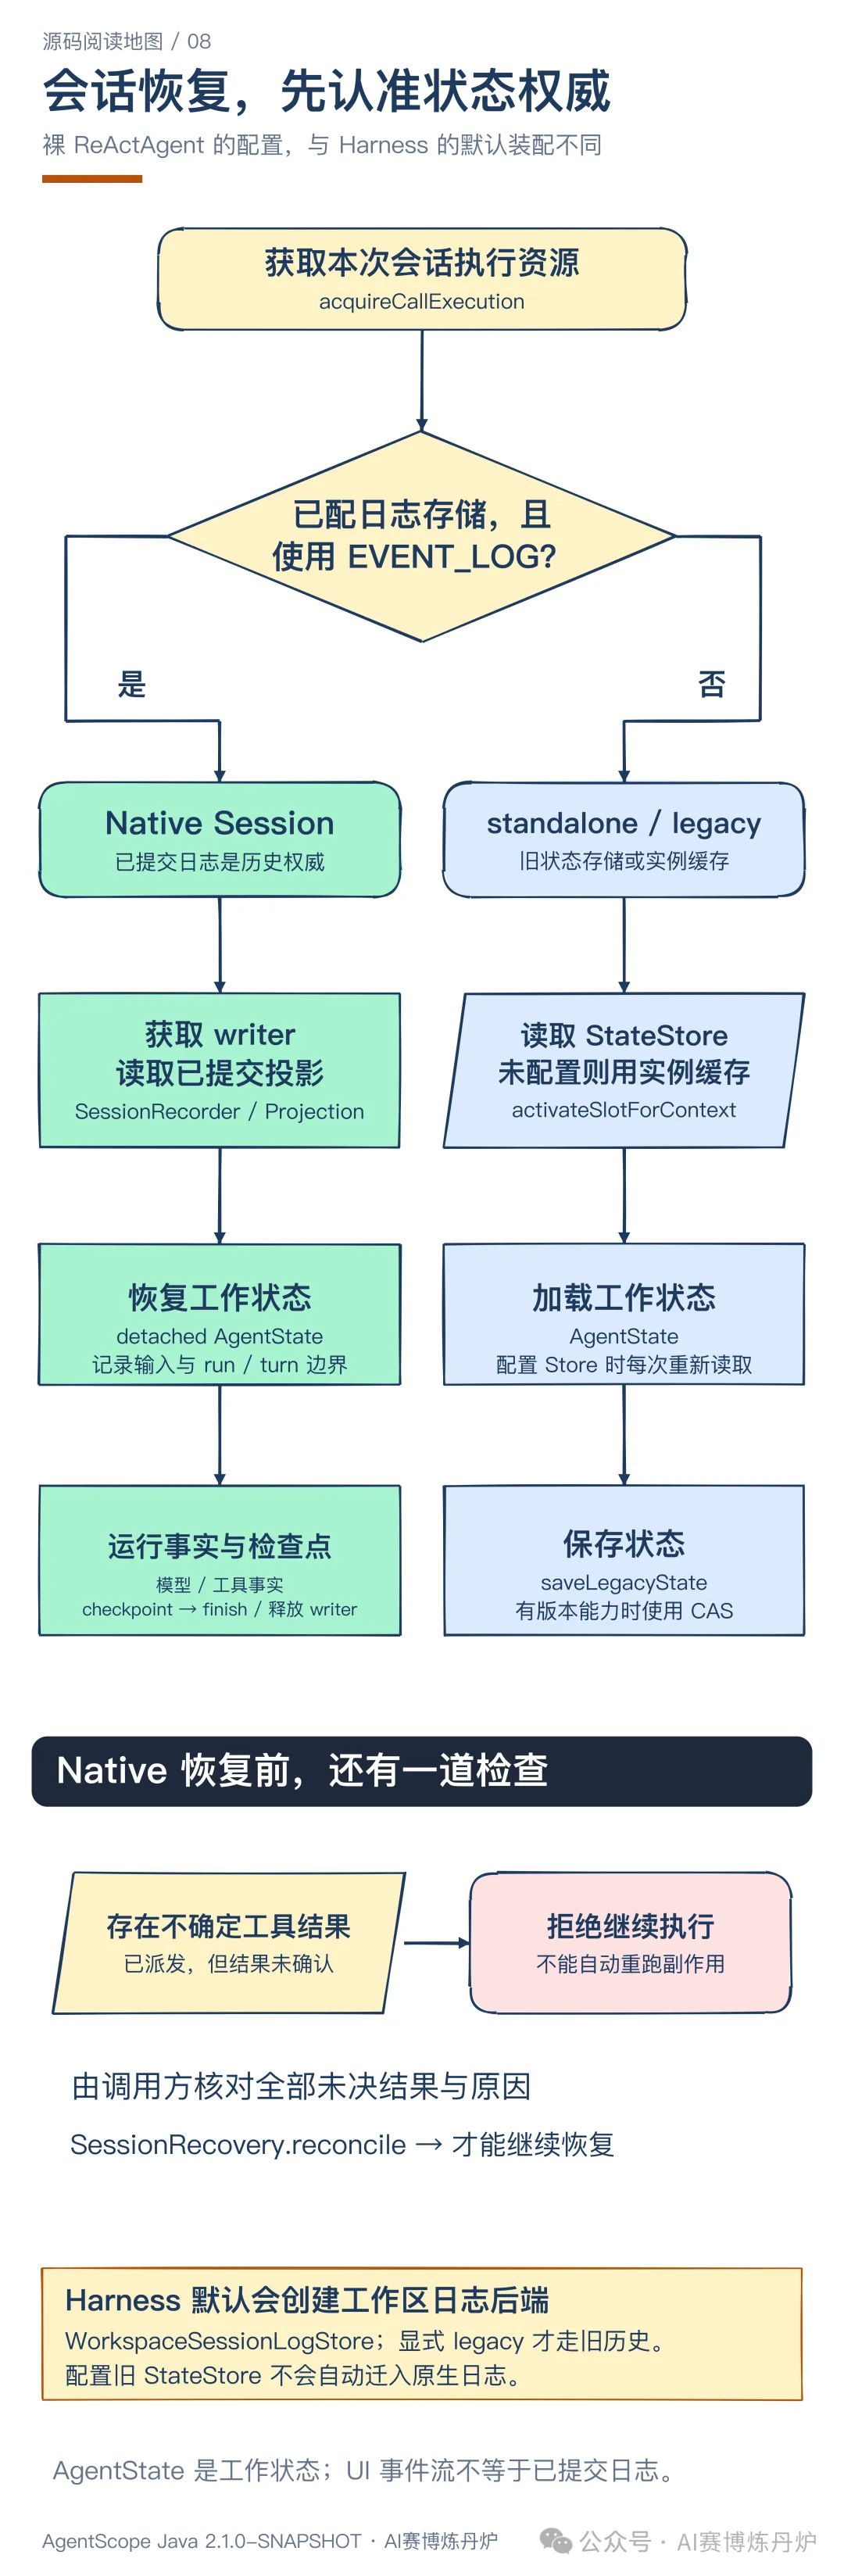
裸 ReActAgent 的 sessionHistoryMode 默认是 EVENT_LOG,但它**不会自动创建 SessionLogStore**。只有配置了日志存储且使用事件日志模式,才走 native 路径;否则走 standalone/legacy 状态路径,未配 AgentStateStore 时保留在实例缓存中。
Harness 的默认装配更完整:未配置日志后端时会使用 WorkspaceSessionLogStore。显式选择 legacy 才回到旧状态历史路径,旧 .stateStore(...) 里的会话不会自动迁入原生日志。
Native Session 获取执行时,会先取得 writer lease,读取已提交日志的投影,再恢复本次工作状态。运行中写入模型、工具事实与 checkpoint;结束时由 SessionRecorder#finish() 完成持久化收尾并释放 writer。
这里区分 turn 与 run:turn 是可以暂停和恢复的一次逻辑交互,run 是一次实际执行。恢复必须使用新的运行身份,已完成 turn 也不能继续冒充未完成回合。
更关键的是工具副作用:如果工具已经派发,却没来得及确认和提交结果,恢复后不能直接重跑。SessionRecorder 遇到不确定工具结果会拒绝继续,SessionRecovery.reconcile() 要求明确核对全部未决结果和原因。退款、发信、写文件等动作是否已经发生,不能由“连接断了”或“调用取消了”来推断。
原生会话的获取与恢复检查位于这里。
链接:https://github.com/agentscope-ai/agentscope-java/blob/dcb131a3f257f06e2b7ddcd3dacfe75d31d04028/agentscope-core/src/main/java/io/agentscope/core/session/SessionRecorder.java#L95
8. 正常、空结果、异常、取消,怎样结束
doCall() 在循环外安排保存,但 Reactor 不同信号触发的操作不同。只写一个 flatMap(save),无法覆盖空完成。
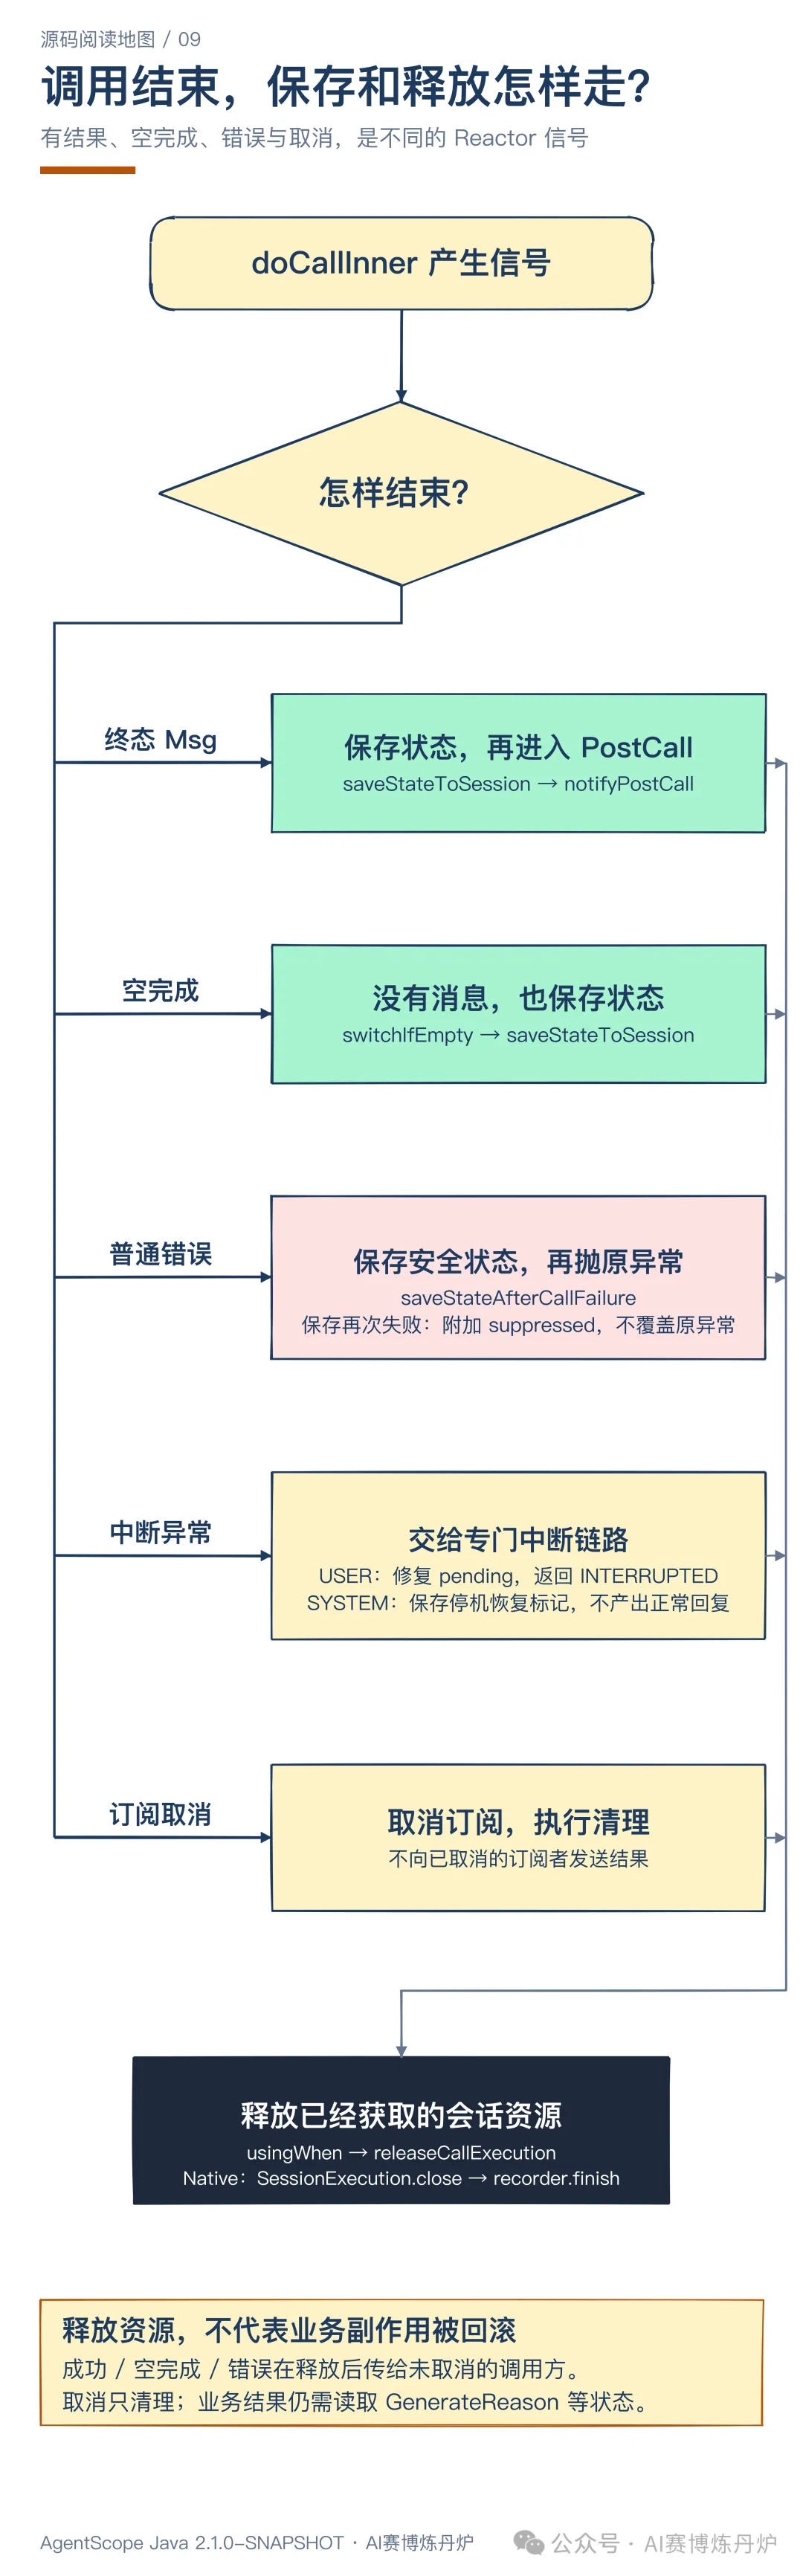
正常得到消息时,先保存状态再交给后续处理;空结果用 switchIfEmpty 同样保存。普通调用失败时,saveStateAfterCallFailure() 尝试保存安全状态,然后继续抛出原异常;保存再次失败,作为 suppressed 异常附加,避免覆盖最初故障。
保存本身发生在这个错误恢复操作的下游。因此,不能因为前面写了 onErrorResume,就认为后面的保存失败也被它处理了。 阅读响应式调用链时,操作符的位置决定了异常边界。
中断另走专门路径:用户中断会修复悬空工具结果并产生 INTERRUPTED 回复;系统停机保留恢复所需状态,不等同于给用户返回正常答案。订阅取消则触发资源清理,不再给已取消的订阅者发送结果。
已经获取的会话资源,由外层 usingWhen 分别按 completed、failed、cancelled 释放。AgentRun.Status.COMPLETED 表达 publisher 正常完成,权限暂停也可能走到这里。业务处理还要看 GenerateReason、持久化 turn 状态及实际工具结果,不能只用运行句柄的 completed 判断任务完成。
保存分支从 saveStateToSession() 往下看,native 写 checkpoint,legacy 才进入原来的状态存储与版本冲突处理。
链接:https://github.com/agentscope-ai/agentscope-java/blob/dcb131a3f257f06e2b7ddcd3dacfe75d31d04028/agentscope-core/src/main/java/io/agentscope/core/ReActAgent.java#L542
9. Harness 把工程能力接到哪里
理解 core 后,Harness 会清楚很多:它负责把工作区、会话、上下文和工具组合到同一个运行环境中,核心推理仍交给内部的 ReActAgent。
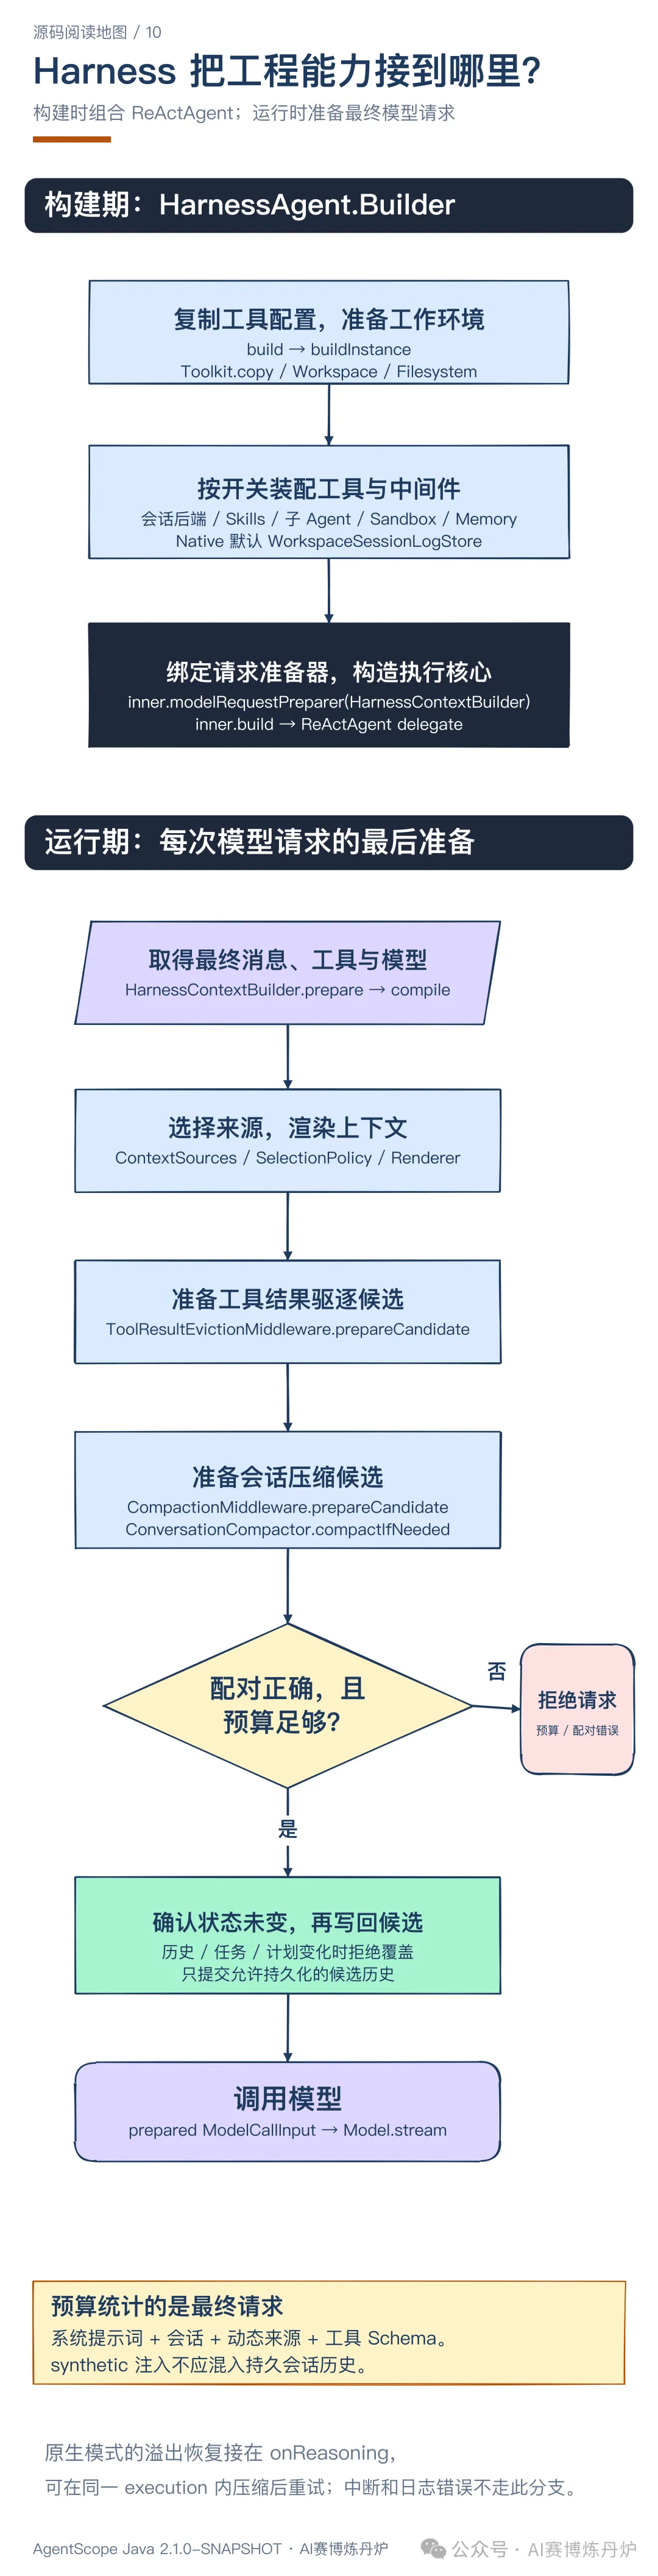
构建时,HarnessAgent.Builder#build() 复制配置并准备 Toolkit、工作区和文件系统,按开关注册中间件与工具,选择会话后端,最终构造内部 ReActAgent。调用时,外层补齐会话默认值,管理沙箱租约,再委托内部 Agent。
HarnessContextBuilder 则实现 ModelRequestPreparer,在最终模型请求边界统一处理上下文:选择来源、渲染内容、准备工具结果驱逐候选、准备压缩候选,再检查 token 预算和工具调用配对。
预算必须覆盖最终请求里的系统提示词、消息、动态来源与工具 Schema。只统计对话列表,会漏掉实际送给模型的一部分输入。候选处理通过检查、并确认历史未发生并发变化后,才写回允许持久化的内容;超预算可以直接报 ContextBudgetExceededException。
上下文溢出恢复也与会话模式有关。原生事件日志模式把恢复接在 onReasoning,可以在同一 execution 内压缩后重试;显式 legacy 模式使用另一条外层恢复路径。不能把旧的 wrappedCall 逻辑直接推广到所有流式入口。
AgentSession 是另一条值得单独读的入口:它提供 submit / resume / respond / steer / inject / interrupt / await 等会话操作,将持久输入与执行编排连接起来。子 Agent、后台任务、记忆维护也由 Harness 组织。拿到后台 task_id 只说明任务已被接纳,后续仍要读取状态与结果。
工具进程成功与任务验收通过还隔着一层:VerificationService 使用已持久化的动作证据检查已确认的验收条件,不会为了验证再执行一次动作。这个边界适用于会修改外部系统的任务。
Harness 的完整能力和装配位置在指南第七章。
链接:https://github.com/liulangjietou/AgentScope-source-analysis/blob/a861e5ef9f1ee6134f3cf97fb4586de93a75ea1a/07-Harness工程化外壳.md
10. 结构化输出,也是这条循环上的分支
业务代码要拿 Java 对象时,还要看 doStructuredCall()。它先生成 JSON Schema,再按模型能力选择原生结构化输出,或者工具兜底。
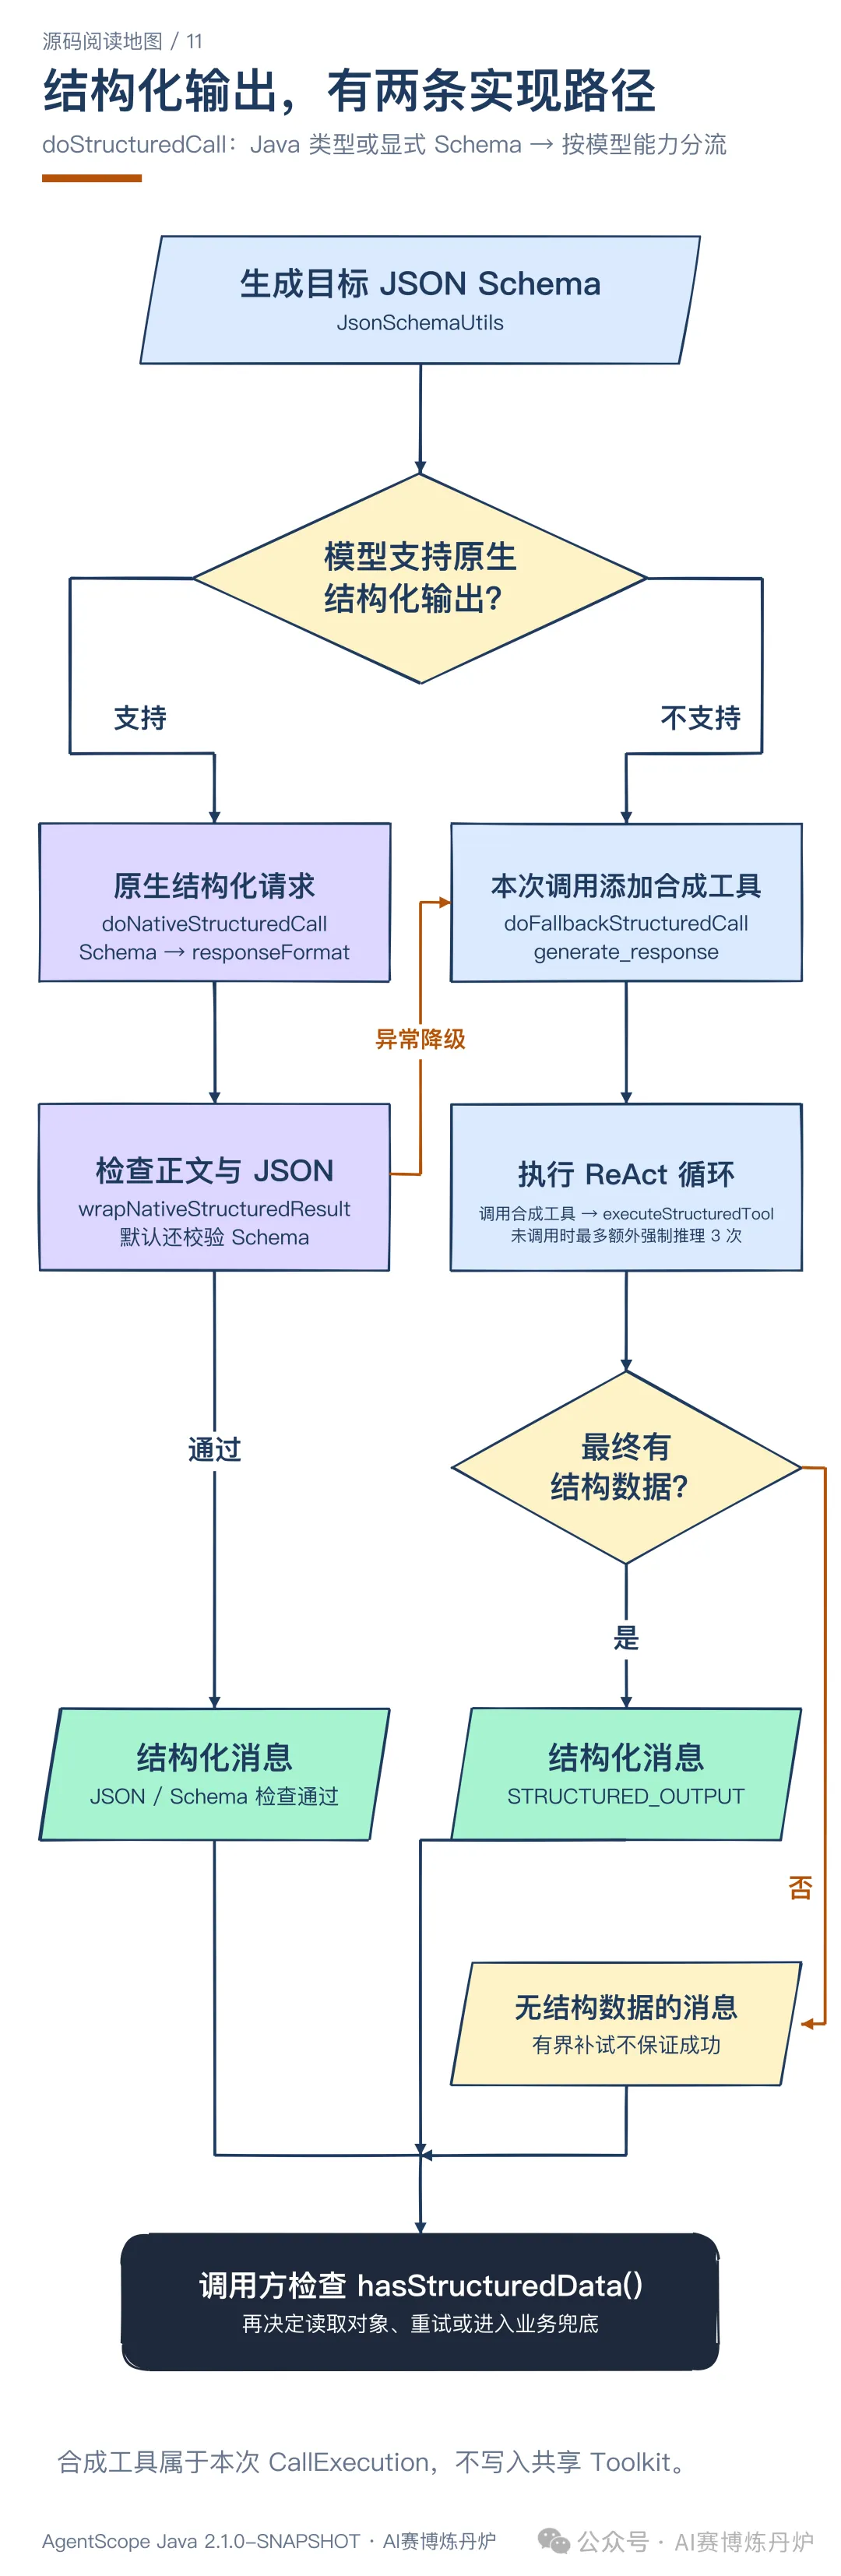
原生路径把 Schema 放进生成选项,随后检查正文、JSON 与配置要求的 Schema 约束;失败可以降级到兜底路径。兜底路径为本次调用添加 generate_response,执行通过 executeStructuredTool(),不污染共享 Toolkit 的注册表。
模型也可能一直只输出文字,没有调用这个工具。框架有独立上限的强制补试,但最终仍可能得到没有结构化数据的消息。因此,调用方应检查 hasStructuredData(),再决定怎样处理业务结果。
到这里,再回到 IDE,就有了一条可执行的阅读路线:
AgentBase#runInContextrunLifecycleBody | |
CallExecution#doCallInner | |
reasoningprepareRequest、HarnessContextBuilder | |
actingevaluatePermissions、ToolExecutor#executeCore | |
reasoningStreampublishEvent、各 middleware 切点 | |
saveStateAfterCallFailureSessionRecorder、SessionRecovery |
我更建议按一个具体问题读完这条链,再去扩展模块看一个厂商或一种存储实现。排查“工具没执行”,就确认它停在参数完整性、权限、分组、Schema、外部挂起,还是业务方法中;排查“会话恢复异常”,先确认状态权威、运行身份和未决工具结果。这样读源码,每经过一层,都知道自己在验证什么。