ARTICLE · 1349457
从一张 Excel 表到能接进业务系统的水文预报,我对 HydroMind 只说了三句话
从一张 Excel 表到能接进业务系统的水文预报,我对 HydroMind 只说了三句话
平时在单位或者课题组里,手里拿到一张原始数据表,真想把它变成业务系统能直接调的水文预报服务,中间要过好几道手:整理数据、训练和检验模型,最后还得写程序部署成接口,往往要既懂模型又会编程的人花不少工夫。HydroMind 就是为此做的:不懂编程的人跟它说几句日常的话,它就能自己把这些事做完,最后的接口部署也不用写代码。
现在让 AI 写段代码不难,大家真正犯嘀咕的是它弄出来的东西敢不敢真用。让大模型当场现编模型代码,公式错一行都不容易查出来。所以 HydroMind 把计算全放在提前写好、测过的程序里,连数据检查、训练验证检验三段划分和最后的部署走的都是固定程序,自带的 AI 助手 HydroAI 只管挑模型、定设置。内置了包含可微分新安江等的 85 个水文模型,几乎每一个都和论文作者公开的原始代码对照过,输出一致。这样 AI 顶多是在选什么模型、配什么设置上拿错主意,这些选择每一步都在后台留着记录,回头随时能查,哪步选得不合适改掉重跑就行。
下面就拿一张逐日 Excel 表走一遍全过程。对话框里一共给 HydroAI 发了三句话(HydroAI 是 HydroMind 自带的,你也可以换成自己顺手的 Claude Code、Codex、WorkBuddy、DeepSeek Harness 这类 AI 助手,文末有说),训出来的模型在没参与训练的 3 年检验期上 NSE 是 0.878,部署成接口以后我又拿真实数据去调,报回来的数跟检验结果逐个对得上。
这次演示只用了一个流域,跑的是内置模型 dHBV1.1p。做水文的同行对概念性模型 HBV 都很熟,dHBV1.1p 就是在 HBV 上接了神经网络,按天给出 HBV 的参数,再走 HBV 的水量平衡算出流量。因为输入的是逐日资料,这次报出来的也是逐日流量。真用的时候不局限于日尺度,拿逐小时或者逐月的数据进去,一样能训练、检验、做成部署,报出来的就是逐小时或逐月的预报。
第一句话:整理数据
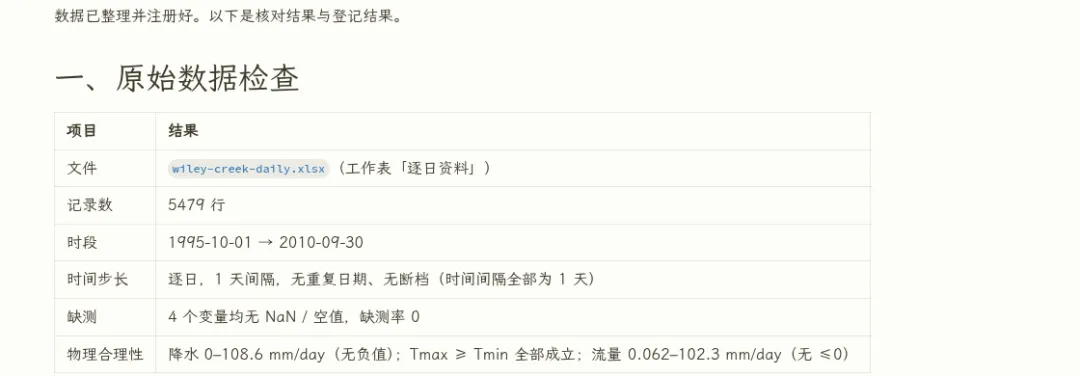
演示数据来自公开数据集 CAMELS-US 里美国俄勒冈州的 Wiley Creek 流域(编号 14187000),整理成了一张普通的 Excel 表。里面是 1995 年 10 月 1 日到 2010 年 9 月 30 日共 5479 天的记录,有降水(mm/day)、最高气温(degC)、最低气温(degC)和流量(mm/day)四个变量,列名里带着单位,整段没有缺测。把这张表拖进对话框,发出第一句话:
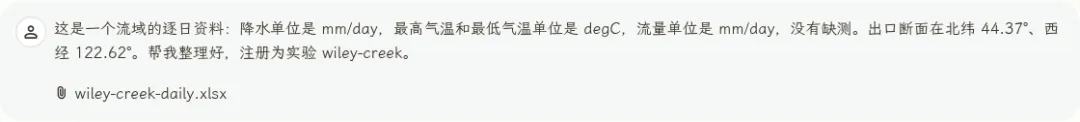
这是一个流域的逐日资料:降水单位是 mm/day,最高气温和最低气温单位是 degC,流量单位是 mm/day,没有缺测。出口断面在北纬 44.37°、西经 122.62°。帮我整理好,注册为实验 wiley-creek。
发出去等了约 2 分钟,HydroAI 就处理完了。它先把 5479 行逐日记录从头到尾过了一遍,确认时间连续、没有重复日期也没有缺测,又查了降水没有负值、最高气温没有低过最低气温的,流量也全是正数,最小的一天是 0.062 mm/day。顺手它还按年均值核对了量纲:算出来年均降水约 1900 mm,年均径流深约 1200 mm,径流系数约 0.6,放在喀斯特山脉西坡这种湿润流域里是说得通的。表里的原始数值它一个没改,原样转成 HydroMind 的标准数据格式,在文件里记下出口断面坐标和数据来源,最后又把刚注册好的数据重新读出来核对了一遍。如果你的数据有缺测或者其它任何问题,都可以直接让他检查。
第二句话:训练并检验模型
数据入库后,发出第二句话,提出训练和检验的要求:

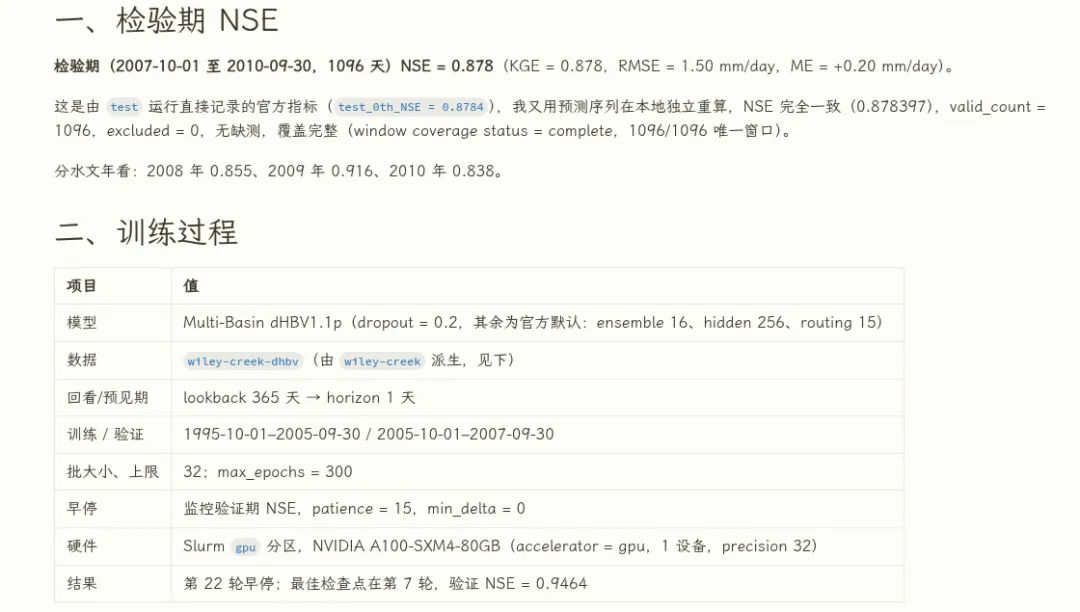
用实验 wiley-creek 训练一个 dHBV1.1p 模型:dropout 设为 0.2,batch size 32,最多训练 300 轮,验证期 NSE 连续 15 轮没有提高就停。1995-10-01 到 2005-09-30 训练,2005-10-01 到 2007-09-30 验证,2007-10-01 到 2010-09-30 检验,用显卡训练。训练完告诉我检验期的 NSE,并画出检验期实测和预测流量的过程线。
这里先交代一句:句子里写的 dropout、batch size、早停这些都是深度学习的训练设置,平时看不懂没关系,完全不用自己去学。不知道怎么设,直接问 HydroAI 就行,它会告诉你每个参数是干什么的、这次需要设哪些、建议设成多少以及为什么这么建议。这次演示里的这几个值,是演示前在验证期上试了几组选出来的。
HydroAI 可以帮你完善输入数据
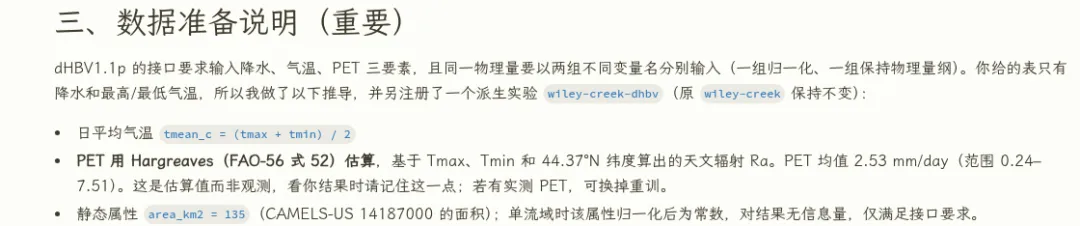
这句话里没有提到表里缺什么。这张 Excel 表只有降水、最高气温、最低气温和流量,但 dHBV1.1p 的接口要求输入降水、气温和潜在蒸散发(PET)三项,同一个物理量还得用两组不同的变量名各输一次(一组做数据换算,一组保留物理量纲),另外至少还要带一项流域属性。
HydroAI 读完模型要求,中间没有停下来提问,自己把缺的输入推导补齐了。它取最高和最低气温的均值当平均气温,又拿最高、最低气温加上第一句话里给的出口纬度,用 Hargreaves 公式算出了 PET,年均约 925 mm。流域属性那栏它填了流域面积 135 平方公里,单流域训练里这数其实是个常数,本身没有有效信息,纯粹因为接口要求必须有这一项。它专门另存了一份数据 wiley-creek-dhbv,原来的 wiley-creek 不动,正式训练前还先拿一小段数据试跑了一下,确认能跑通,才开始训练,并在回复里说明:
“dHBV1.1p 的接口要求输入降水、气温、PET 三要素,且同一物理量要以两组不同变量名分别输入(一组归一化、一组保持物理量纲)。你给的表只有降水和最高/最低气温,所以我做了以下推导,并另注册了一个派生实验 wiley-creek-dhbv(原 wiley-creek 保持不变)”
“这是估算值而非观测,看你结果时请记住这一点;若有实测 PET,可换掉重训。”
训练跑完,确定性系数(NSE)在训练期是 0.933,验证期是 0.946,没参与训练的 3 年检验期(2007-10-01 到 2010-09-30,共 1096 天)算出来是 0.878。HydroAI 随后又拿预测序列自己重算了一遍检验期 NSE,两个数完全一致。
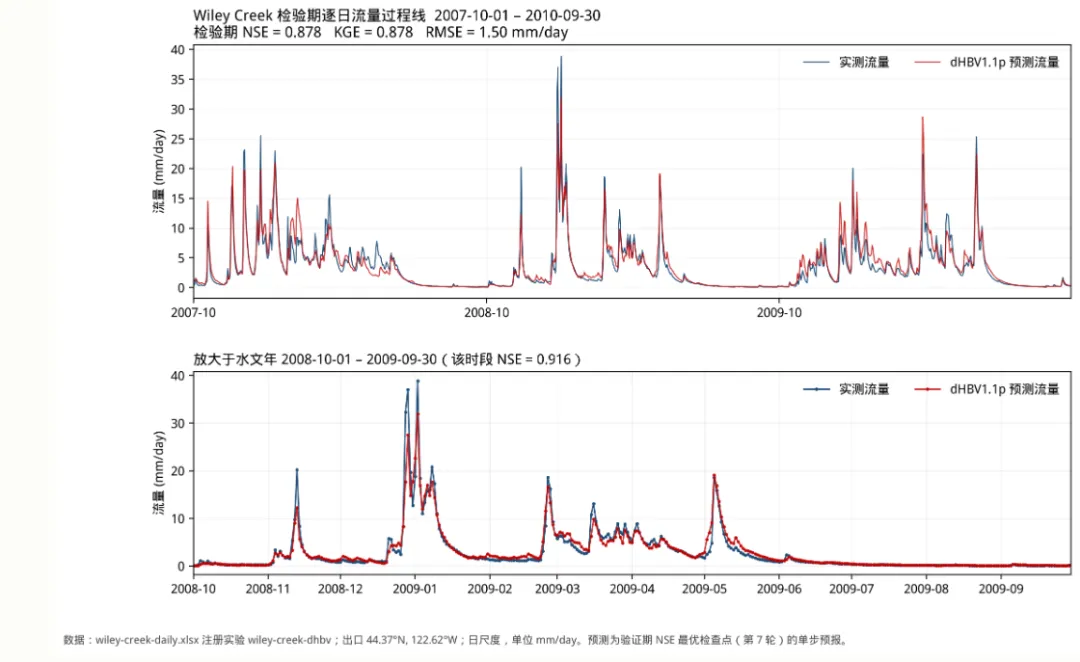
它还按要求把实测和预测流量的过程线直接画在了对话框里,除了 3 年检验期的全段,也单独给了一张 2009 水文年的局部放大图。
当然,0.878 是照着上面那句话跑了一把的结果,这句话只要求训练和检验,没让它想办法提精度,算不上 HydroMind 能做到的上限。平时真做项目,顺着对话框接着往下聊就行,比如让它查查误差主要出在哪,换别的模型结构试试,或者拿实测 PET 替掉估算值,多试几次再挑,在本例子中,实测可以把NSE提升到0.96。
第三句话:把模型做成接口,接入数字孪生系统
模型训练、检验完后,发出第三句话,让它把模型部署成服务:

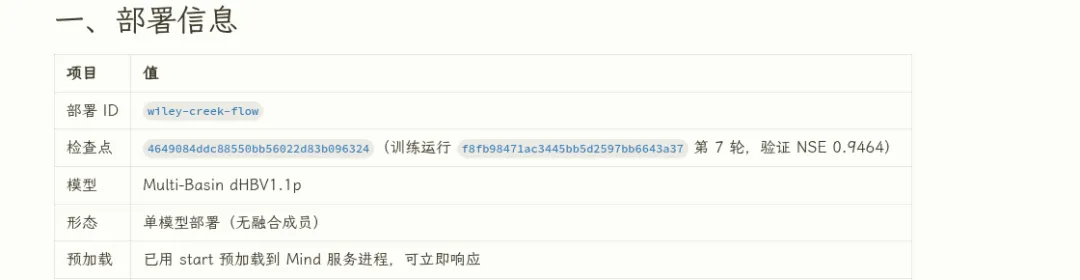
把刚才训练出的最好的检查点做成部署,部署 ID 叫 wiley-creek-flow。部署好后告诉我调用地址和请求格式。
大概等了 3.5 分钟,HydroAI 就挑出验证期表现最好的模型做成了部署,把调用地址和请求格式发了出来。这里的接口程序它也没现写,直接调用 HydroMind 自带的部署功能,所有模型上线走的都是同一套测过的程序。
调这个接口也很省事,调用方只传原始的观测值,不用自己换算。训练时对数据做过的换算(归一化),参数都跟模型存在一起,不用担心两边换算不一致把数算错,模型内部要用的另一组特征也由服务端自己补齐。调的时候只要传前 365 天的历史加上预报当天共 366 个降水、气温和 PET,再加上流域面积;让数字孪生系统的技术人员把它们对到 inputs 里的 rainfall_mm_day、tmean_c、pet_mm_day 和 area_km2(填 [[135.0]])就行:
{ "inputs": { "rainfall_mm_day": [[0.0], [3.2], "… 366 values …"], "tmean_c": [[4.1], [3.8], "…"], "pet_mm_day": [[1.2], [1.1], "…"], "area_km2": [[135.0]] }}服务跑起来以后,HydroAI 又自己从检验期抽真实数据组了 4 个请求去调接口,每次拿回来的值都跟同一天的离线批量预测一致,只差在小数点后很多位上。像 2009-01-02 那天,两边算出来都是 31.9669 mm/day,线上接口报的数跟检验期打分用的完全对得上。临了它还提醒了一句,线上预报的时候 PET 得用同样的 Hargreaves 公式去算。
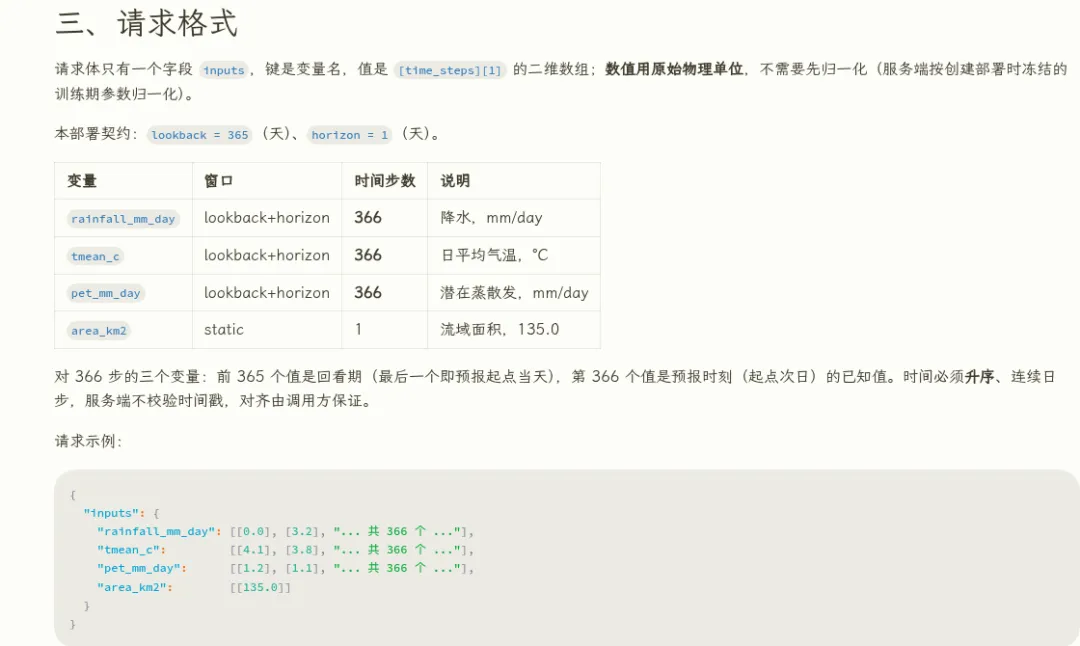
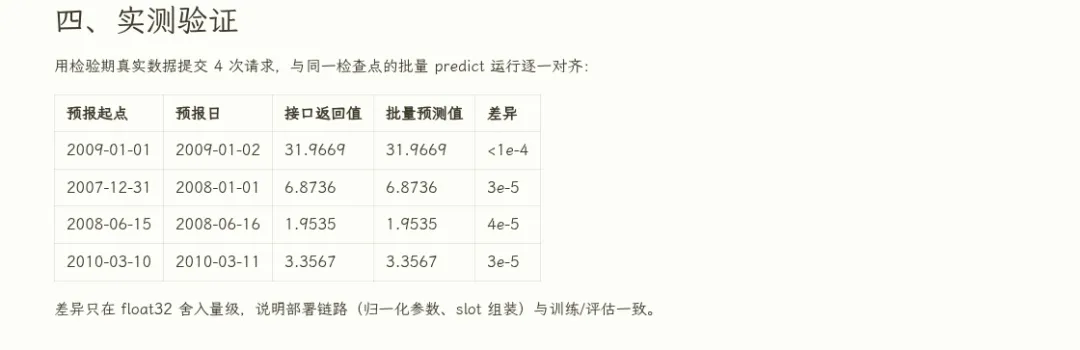
整套流程里,这一步最关键。模型做出来以后,真要往水文局、水利局、设计院的业务系统或者数字孪生平台上接,不用再专门找人写一遍接口程序了:业务系统只要按约定格式发来前 365 天的降水、气温和 PET,再加上要预报那一天的这三项,就能拿回那一天的流量预报。实际作业预报时,预报日那三项直接用天气预报的值,PET 由预报气温算出来就行。
考虑到业务系统最怕悄悄算错数,接口对输入输出卡得很严。要是发来的请求跟部署公开的输入输出说明对不上,比如漏了变量、时间步数不对,接口会直接报错拦下来,不会糊里糊涂算出一个错数。以后训出了更好的模型想换上去,如果新模型要求的输入跟旧的不一样,HydroMind 也会拒绝替换,让原来的部署照常跑着,不影响正在调它的系统。
换自己的数据,或者接你顺手的 AI 助手
你手头的 Excel 或 CSV 文件直接喂进去就行,几乎支持所有的表格文件。不用提前套模板,逐小时、逐月的资料或者多个流域合在一起训练也都支持。要是你电脑上平时已经在用 Claude Code、Codex、opencode、WorkBuddy、DeepSeek Harness 这类第三方 AI 助手,也不用非得在软件自带的 HydroAI 里聊,直接拿它们来操作 HydroMind 就行,官网文档的「用第三方 AI 助手」那一页写了接法。
想上手试试
官网地址是 hydromind.funzzz.top,从注册、花0.01元买许可证、下载安装包,到装好之后的第一次设置,官网和文档里都有说明。
在线许可证是 60 天 0.01 元。软件原本打算免费,但在线许可证每次启动都要联网向官网请求授权,要是完全免费,很容易有人拿脚本批量注册账号来挤占官网。象征性的收费、走实名的支付宝付一下,真正想用的同行基本不花什么钱,脚本就没法批量注册了。
非个人用户(政府部门、高校、企事业单位等)请联系作者,单位内网里不能上网的电脑要用离线许可证,也请联系作者。要是单位有保密要求,HydroAI 还可以接单位自己部署的大模型。联系方式在官网 → 文档 → 概览 的最后一节「联系我们」里。也可以进入QQ群联系我们:
想看详细文档,点文末「阅读原文」,打开的是这篇文章在HydroMind官网博客里的版本,文档链接都能直接点。也可以进官网,按下面的路径找:
• 准备自己的数据:官网 → 文档 → 建模 → 「准备自己的数据」 • 换别的模型:官网 → 文档 → 建模 → 「怎样选模型」(内置 85 个模型,包括可微新安江) • 部署和接入:官网 → 文档 → 部署 → 「创建和管理部署」「在其他系统里调用」 • 用 Claude Code、Codex 等第三方 AI 助手:官网 → 文档 → 安装与运维 → 「用第三方 AI 助手」 • 许可证的购买、续期和换电脑:官网 → 文档 → 安装与运维 → 「许可证和账户」