ARTICLE · 1351956
三面P10拍桌子问:知识库文档会过期,你怎么让 Agent 只用"当前有效"的知识?我从入库到失效下线五个环节一口气讲完后,他放下了手
前阵子粉丝去面一个 Agent 岗位的三面,面试官上来就抛了一个问题,这个问题看起来挺"工程"的:
你的知识库文档会迭代更新和过期失效,如何管理文档生命周期的?怎么确保线上知识库一直准确且不过时呢?
很多人做 RAG 的时候,注意力基本都放在切分、embedding、召回还有重排这些事情上,心里想着"把文档灌进向量库"就完事了。但是真上线之后才发现,事情不是这样的。知识库这个东西,不是建完就结束了,它其实每天都在腐烂。
先来看一个假设的场景。某家航司在 3 月份调整了免费托运行李的额度,从 20kg 改成了 15kg。但是知识库里留着的,还是旧版政策。这时候用户来问"我的航班能带多重的行李",Agent 就去引用了旧文档,回答说是 20kg。用户到了机场,被要求去补交超重费,转头就是一条投诉。
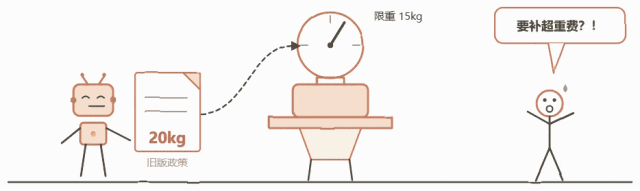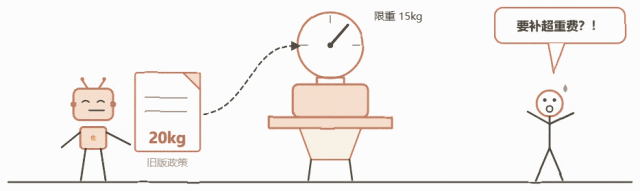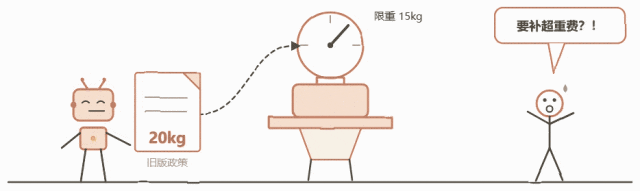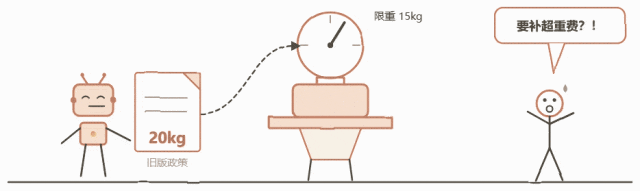
这个严格来说,不一定是传统意义上的模型幻觉。因为模型是忠实地去使用了知识源的,只不过这个知识源已经失效了。但它仍然是 Agent 系统层面的一种错误。你可以这么理解:模型正确地使用了一个已经失效的知识源。
所以这道题考的其实不是某个具体的工具。它考的是你有没有这个意识——把知识当成一种有生命周期的数据资产去运营。
先说一个前提。线上系统是没办法保证回答"永远准确"的。真正能做到的事情是,降低过期知识进入回答链路的概率,并且在没办法确认的时候,主动去拒答或者转人工。围绕这个目标,我把答案拆成了五个环节。
总思路:五个环节
这五个环节就是:生命周期管理 → 变更同步 → 时态检索 → 质量评测 → 线上闭环。
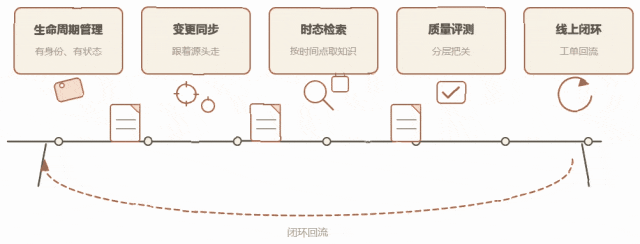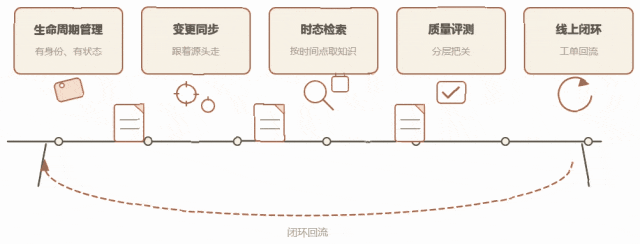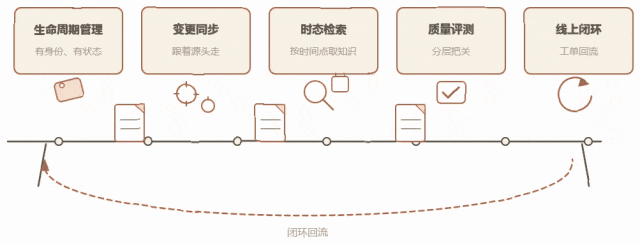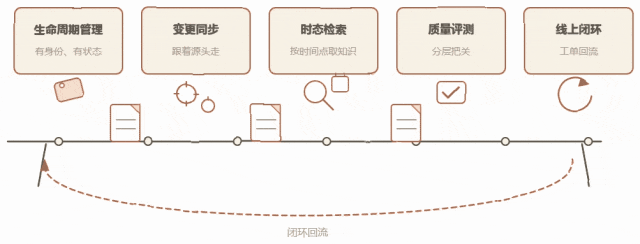
其中最容易被忽略、但也是最有技术含量的,是第三个。因为知识库检索的不只是"最新知识",而是"在当前业务上下文和目标时间点上有效的知识"。
1. 生命周期管理
第一个环节是生命周期管理,说白了就是让每一份知识都"有身份、有状态"。每个文档、每个 chunk 都要带上元数据。这里边有两组特别容易混淆的时间概念,必须给分开:
{ "doc_id": "policy_baggage_XX", "version": "v7", "source": "航司官网公告", "ingested_at": "2026-03-01", "effective_from": "2026-03-15", "expire_at": null, "review_due_at": "2026-06-15", "scope": {"airline": "XX", "route": "国际", "cabin": "经济舱"}, "owner": "国际机票产品组", "status": "active"}ingested_at 是入库时间,说的是这份知识什么时候进的库。effective_from / expire_at 是生效区间,说的是这份知识在业务上什么时候适用。review_due_at 是复核时间,说的是什么时候该有人再来确认一遍。scope 是适用范围,政策这个东西,可能是按航司、航线、舱位、票价产品这些维度去生效的。
这里有个关键概念:复核周期不等于有效期。
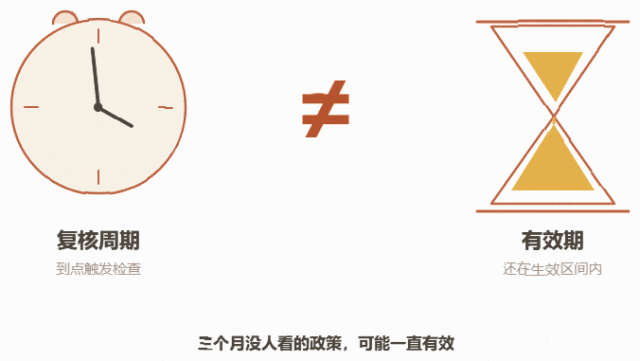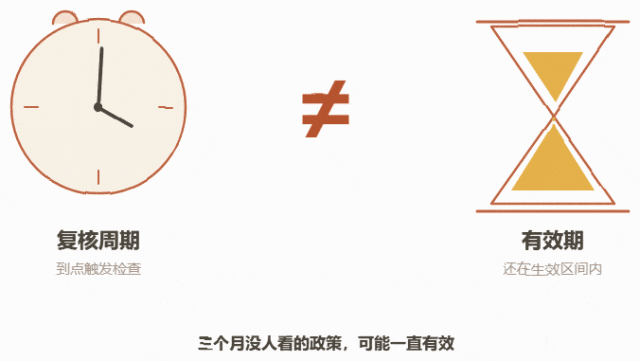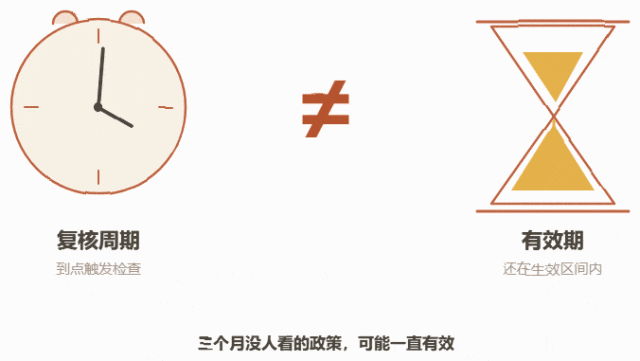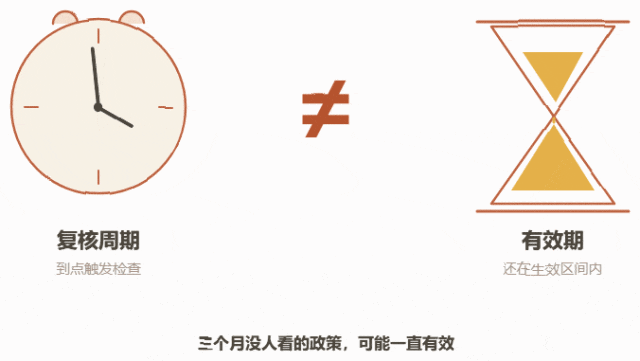
到了 review_due_at 这个时间点,不是去判定文档失效,而是触发复核。也就是通知 owner 来确认一下"这份文档还对吗"。一个政策类文档三个月没人看,不代表它过期了,它可能一直是有效的。
真正的失效,只应该由这么几类事件来决定:源系统明确废止了;有新版本把它替代了;文档本身带了明确的 expire_at;或者是 owner 和业务方审批确认了下线。
复核周期可以按文档类型设置默认值,但具体数字要结合业务和风险来定,没有通用标准:
对于超期还没复核的文档,我的做法是先标记风险,然后按需降权,再通知 owner 升级处理。至于要不要下线,这个由 owner 或者业务审批来决定,不要靠一个"超期 N 天就自动下线"的规则去一刀切。
旧版本呢,也不做物理删除,只改状态,改成 deprecated 或者 archived。为什么这么干,第三部分会讲到:历史时间点的问题还需要用到它们。
2. 变更同步
第二个环节是变更同步,目标是让库跟着源头走。
先说怎么发现变化。有事件的数据源,比如内部的 CMS、运营后台,就用 webhook 或者 CDC 去监听,改一条就同步一条。没有事件的数据源,比如外部官网、PDF 公告,就定时去拉取,拉完再做变更对比。
再说怎么做增量更新。
有一个常见的说法,叫"chunk 算 hash,只更新变化的 chunk"。但这个地方要严谨一点。因为文档重新切分之后,如果只是前面改了一句话,后面的 chunk 边界可能就整体位移了。位移了会怎样呢?一串 chunk 的 hash 全变了,看起来就跟"全变了"一样。
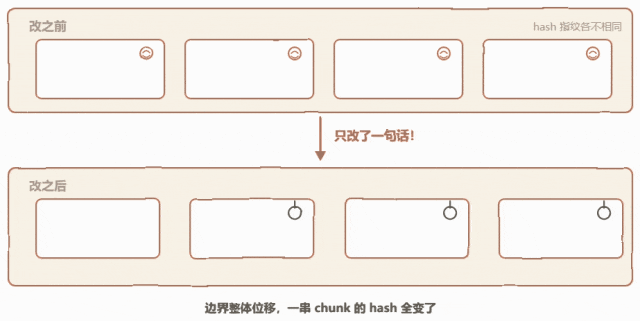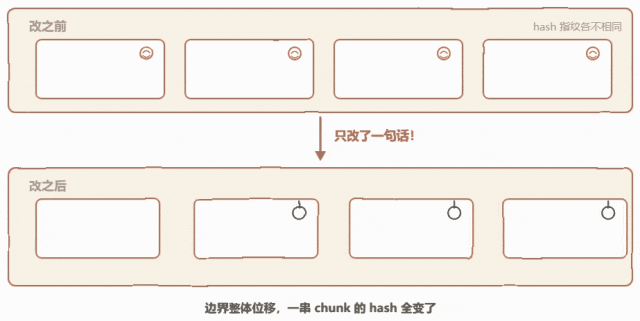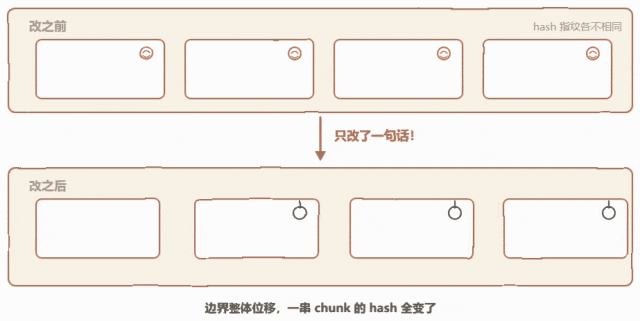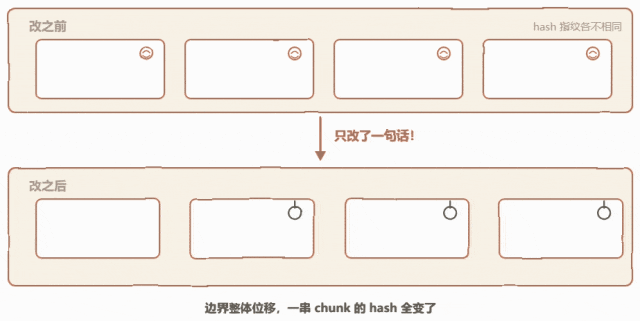
更稳妥的做法是这样的。
第一步,先对文档去做规范化,把没有意义的空白、格式噪声这些东西去掉,然后再去计算文档级的内容 hash。这样就能快速判断出来,这份文档有没有实质性的变化。
第二步,采用结构感知的切分,按标题、章节、条款去切,并且给 chunk 生成一个稳定标识,比如 doc_id + 章节路径 这种。这样一来,就算内容有个小改动,边界也不会大幅漂移。
第三步,在稳定标识的基础上去比较 chunk 的内容 hash,只有内容真的变了的那部分 chunk,才去重新做 embedding。
第四步,如果是切分策略变了,或者文档结构发生了大的调整,那就不要硬做增量了。直接新建索引、全量构建,评测通过之后用别名切过去,出了问题秒级回滚。
那怎么防漏呢?
定期做全量对账。拿数据源的文档清单,和向量库里的 doc_id、version 清单去 diff。源头已经删了但库里还在的,这是漏删。源头有新版本但库里还落后的,这是漏更。
3. 时态检索
第三个环节是时态检索,要去检索"当时、此地、此条件下有效"的知识。这是整套方案里边最能体现功力的一环。
只在检索的时候过滤 status=active,这是不够的。我们回过头再看行李额那个例子:
用户 3 月 10 日问:"我 3 月 12 日乘坐 XX 航班,免费行李额是多少?"
新政策是 3 月 15 日才生效的。如果你只取"最新入库的 active 文档",就会答成新规则。但用户那个航班,适用的其实是旧规则。反过来说,如果用户是 3 月 20 日出行,那就应该用新规则了。
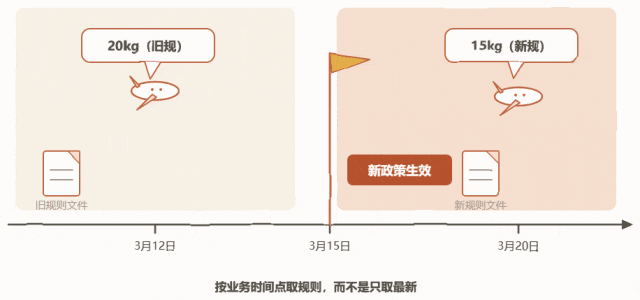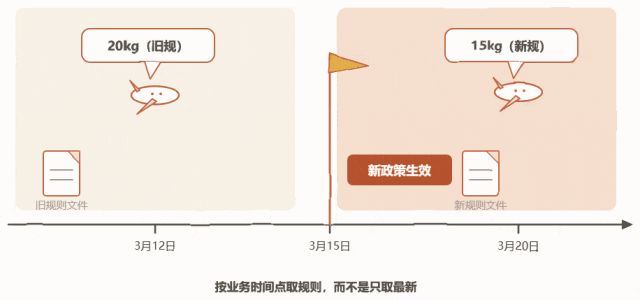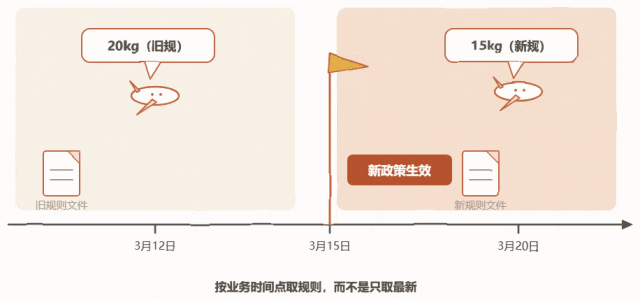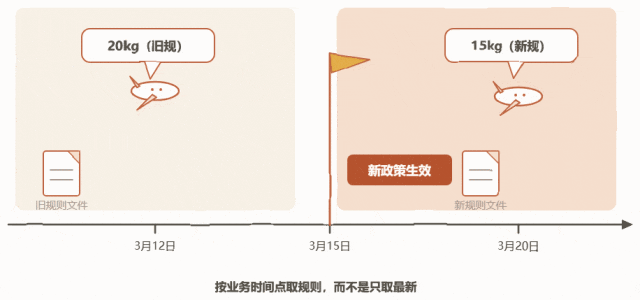
所以检索过滤的是业务时间点:
effective_from <= event_dateAND (expire_at IS NULL OR event_date < expire_at)AND scope 匹配(航司 / 航线 / 舱位 / 票价产品……)这里有几个工程细节要说一下。
第一个,event_date 从哪来?它来自用户问题里边的业务日期,比如出行日期、下单日期这些,需要在 query 理解的阶段抽取出来。抽不到怎么办?就让 Agent 去追问一句:"请问您的航班日期是哪天?"如果连追问都做不了,那就默认按当前日期来,并且在回答里把这个假设注明清楚。
第二个,旧版本不能物理删除。因为用户投诉的,可能是一张 3 月 10 日买的票。客服排查的时候,需要还原"当时适用的规则"。这就要求历史版本仍然可以按时间点去检索。所以 status 和有效区间要分开来管:deprecated 表示的是"不再是当前版本",不等于"对任何时间点都无效"。
第三个,scope 同样是过滤条件。同一个航司,不同的航线、舱位、票价产品,规则可能完全不一样。你只按时间过滤的话,还是会答错。
那知识冲突怎么处理?
同一个主题,常常会有好几份文档。官网公告、产品文档、客服 SOP、运营 Wiki,内容还可能互相矛盾。"取权威等级高的、更新时间新的",这个说法听起来挺合理,但它并不总是对的。
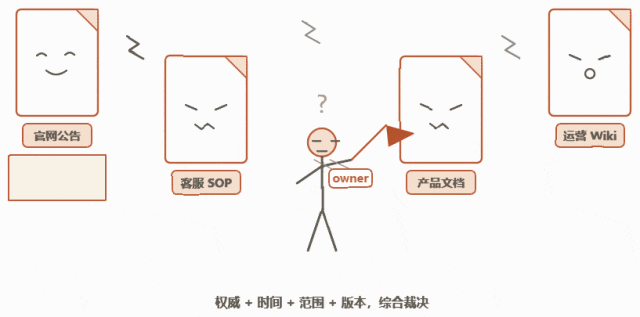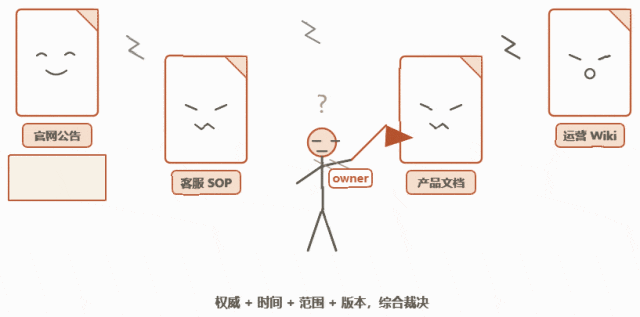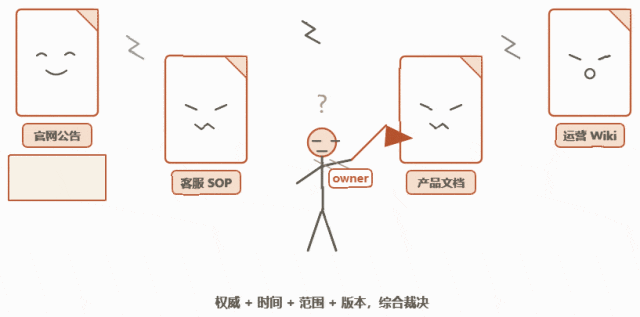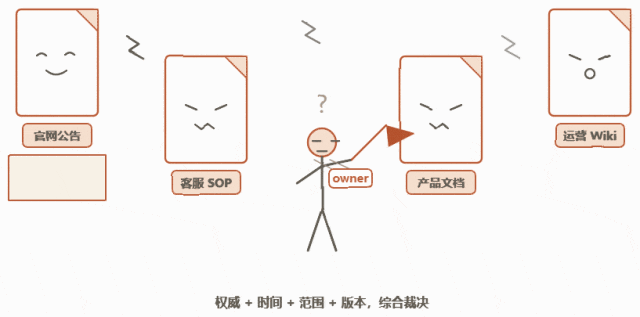
举个例子。官网政策是 3 月 1 日发布的,客服 SOP 是 3 月 10 日更新的。这个 SOP 可能只是在解释官网政策,并不是在跟它竞争。你不能因为官网权威,就去无视 SOP。也不能因为 SOP 更新得晚,就让它去覆盖官网。
更合理的做法是把多个因素综合起来看:来源权威性,加上生效时间,加上适用范围,再加上文档版本和业务上下文。
再往深一层说,知识冲突其实不是单纯的检索排序问题,它是知识治理的问题。发现了冲突之后,最好是进入人工审核或者合并的流程,由 owner 来确认以谁为准,而不是让 reranker 替你去决定哪个是真的。线上如果碰到暂时没办法裁决的冲突,宁可提示不确定然后转人工,也不要随随便便选一个出来。
4. 质量评测
第四个环节是质量评测,要用数据来证明知识库"没变坏"。
先说 golden set 回归集。你要维护一份带标准答案的问题集,把核心场景覆盖住,并且里面必须包含时态用例。比如"国际航班免费托运行李是多少公斤?"这个问题。同一个问题,把 event_date 分别设成 3 月 12 日和 3 月 20 日,期望得到的答案是不一样的。再比如"泰国现在对中国游客免签吗?"这种强时效问题,期望是走实时数据,或者提示以官方为准。
每次知识更新之后,自动去跑一遍回归。指标下降超过阈值,就拦截发布。这个相当于给知识库做了一个 CI。另外标准答案本身也要跟着政策去更新,不然的话,回归集自己就先过期了。
再说指标。指标要拆开来看,不要只说一个"准确率"就完了。开放式的 Agent 回答,很难去简单定义什么叫"和标准答案一致"。更工程化的做法是分层评测:
比如 Retrieval Recall@K,看的是该召回的文档有没有被召回到。Context Precision,看的是召回的内容里头,有多少是相关的、有效的。Faithfulness 或者叫 Groundedness,看的是回答有没有忠实于检索到的内容,有没有瞎编。Citation Correctness,看的是引用的文档是不是真的支持那句话,并且在目标时间点上有效。Answer Correctness,看的是答案要点对不对,可以用要点清单加评审模型来判断,再抽样做人工校准。最后还有 Abstention Accuracy,看的是该拒答的时候有没有拒答,不该拒答的时候有没有乱拒。
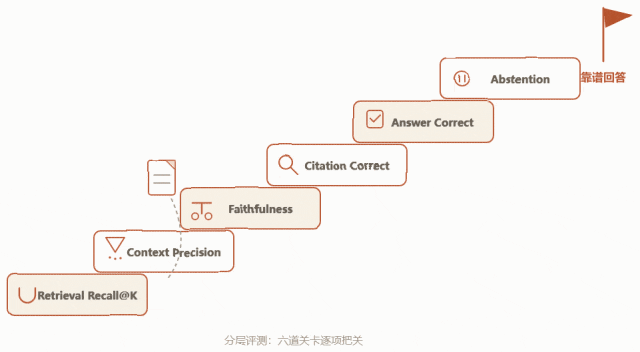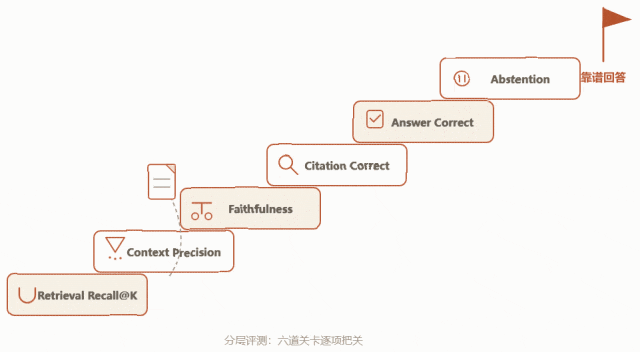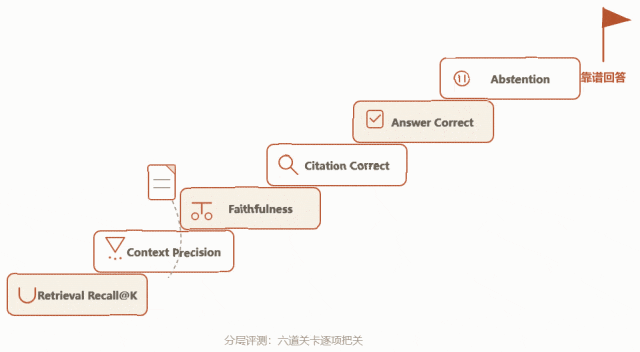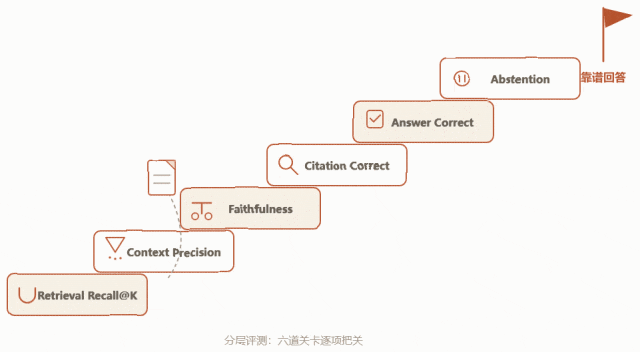
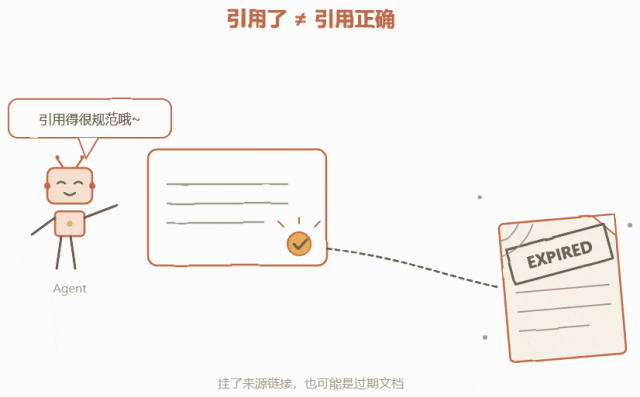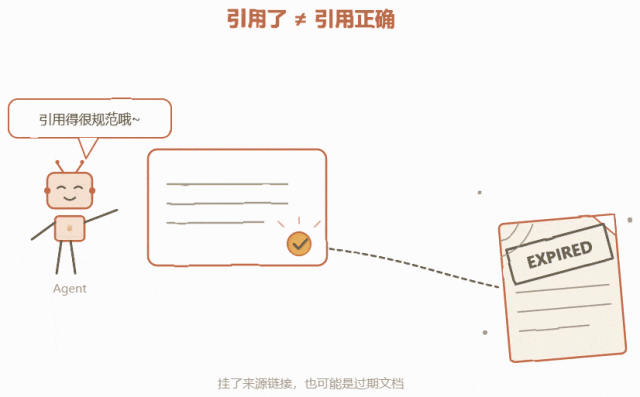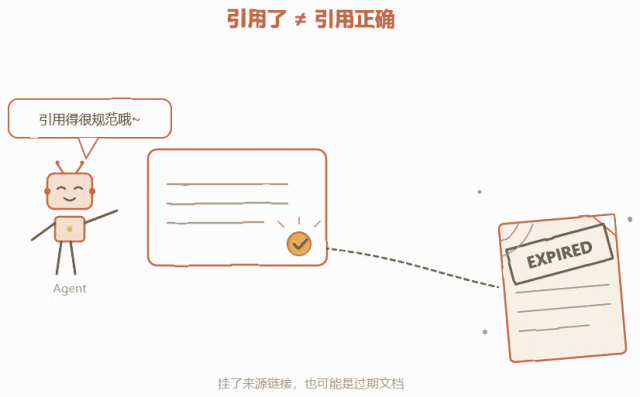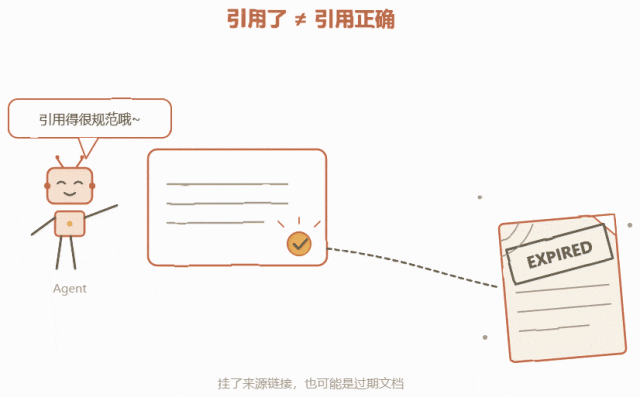
这里面我最想强调的是 Citation Correctness。因为"引用了知识库"这件事,不等于"引用正确"。回答里挂着一个来源链接,并不代表那个来源就支持这句话,更不代表它是当前有效的版本。这正是开头那个案例的延伸:Agent 引用得很规范,但引到的是过期文档。
5. 线上闭环
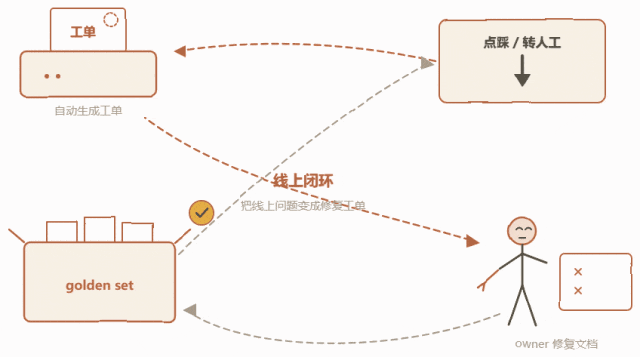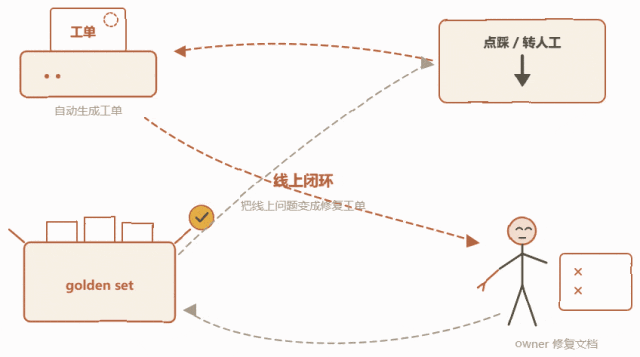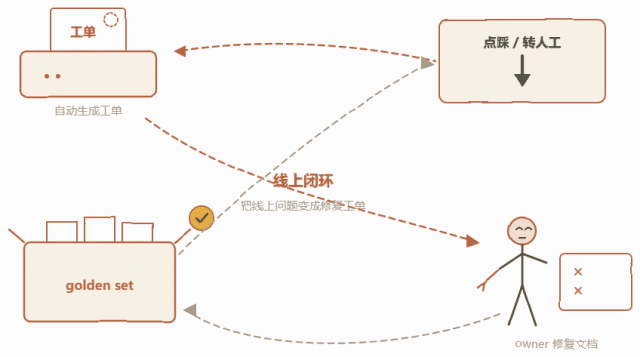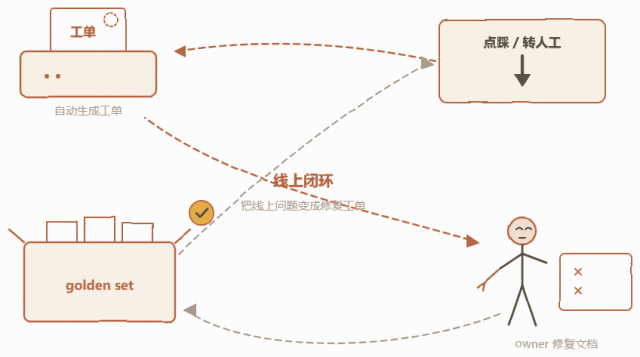
最后一个环节是线上闭环,核心是把线上问题变成知识库的修复工单。
先说反馈信号。用户点踩了、转人工了,这是一个信号。客服人工纠正了 Agent 的回答,这也是信号。Agent 自己出现了低置信度的拒答,还有引用了已经被标记为 deprecated、或者临近复核的文档,这些都是信号。
这里关键的一点,是要能够反查到具体的文档版本或者 chunk。比如某个 chunk 短期内被大量点踩,那就自动生成一个工单派给 owner,把出错的问题和回答样本附上去,修完之后再补进 golden set 里。
再说命中率监控。长期零命中的文档,可能是没人问了,也可能是切分或者元数据有问题,需要人工去看一眼。高频命中但点踩率又高的文档,这种优先级最高,先修它。
然后是回答层的兜底。知识库治理得再好,也可能有漏网之鱼,所以回答层要设最后一道防线。
第一,回答要带来源和时间。比如附上"来源:《XX航司行李政策》,适用于 2026-03-15 起的航班",这样用户和客服一眼就能判断时效。第二,时效敏感的问题优先走实时接口。像价格、库存这类问题,不要只依赖静态文档,实在要用文档的话,就提示一句"以官方最新公告为准"。第三,没办法确认的时候,拒答或者转人工。比如检索不到可靠的依据,或者依据之间有冲突还没裁决,或者缺少必要的业务时间。宁可说"这个问题我帮你转人工确认",也不要去编一个看起来挺合理的答案。
最后是发布流程。知识库的发布,本质上跟代码发布是一样的。重要的文档变更要走审批,变更有审计日志,要支持灰度,还要支持一键回滚。
面试里怎么收尾
面试里怎么收尾呢?回答完之后,可以用一句话点题:
"生命周期管理 + 变更同步 + 时态检索 + 质量评测 + 线上闭环"。目标不是保证永远准确,而是让 Agent 尽可能只使用当前有效的知识,并且在没把握的时候主动拒答。
如果面试官继续追问,你手里是有具体例子可以展开的。行李额政策的生效时间问题、复核周期跟有效期的区别、切分漂移下的增量更新、引用正确性的评测,这些都是现成的。
复盘
最后复盘一下。这道题其实在筛选两类候选人。一类是只做过 Demo 的人,讲切分、讲向量库讲得头头是道,但一说到"更新",就只会说"重新导入一遍"。另一类是真正做过线上系统的人,他们会去聊版本和生效区间、增量同步的边界情况、冲突治理、分层评测、反馈回流这些东西。
最后记住三句话。复核周期不等于有效期。最新文档不等于当前应该使用的文档。引用知识库不等于回答一定正确。
Agent 的能力上限,取决于模型。但 Agent 的可信度下限,取决于知识库的治理水平。如果你也在准备 Agent 方向的面试,建议把自己项目里的知识库,对着这五个环节过一遍。看看哪一环是空白的,把它补上,这就是你面试里的加分项。