ARTICLE · 1356875
从 PDF 提取信息:扫描页和表格怎样核对
PDF里的文字提取出来以后,数量和单价有没有串列,还要回到原页核对。文本读到了,账也未必对。
WB09练习的是后一半:把摘录重新放回原页,按行、按列核对。你会得到带文件名和PDF页码的摘录表,并知道哪些数字仍需人工确认。
本篇实测于2026-10-26,使用作者自制的四份PDF,没有真实票据和个人资料。前置是WB04的来源核对;环境为macOS、中文版WorkBuddy 5.9.2,默认Agent与默认权限。
同一张表,准备两种PDF
先解压练习包,复制一份exercise作为独立工作空间;input里已有四份PDF与提取要求。首轮只处理text.pdf和scan.pdf。两份PDF看上去是同一张物料表,但内部不同。
text.pdf有可提取的文字层。scan.pdf则把同一原页渲染成一张图,再放进PDF,作者已确认它没有文字层。
所以,文字提取返回空白,不等于这一页没有内容。接下来能否识别,要看实际OCR或视觉读取能力,不能只把文件重新打开一次就宣布成功。
这张表只有三条项目,适合逐格查:
编号:M01
项目:观星折页
数量:30
单价/元:2
金额/元:60
编号:M02
项目:红光卡片
数量:12
单价/元:3
金额/元:36
编号:M03
项目:记录纸
数量:40
单价/元:0.5
金额/元:20
合计是116元。它是一行合计,不是第四条物料。金额单位也要保留,不能把36写成“36张”。
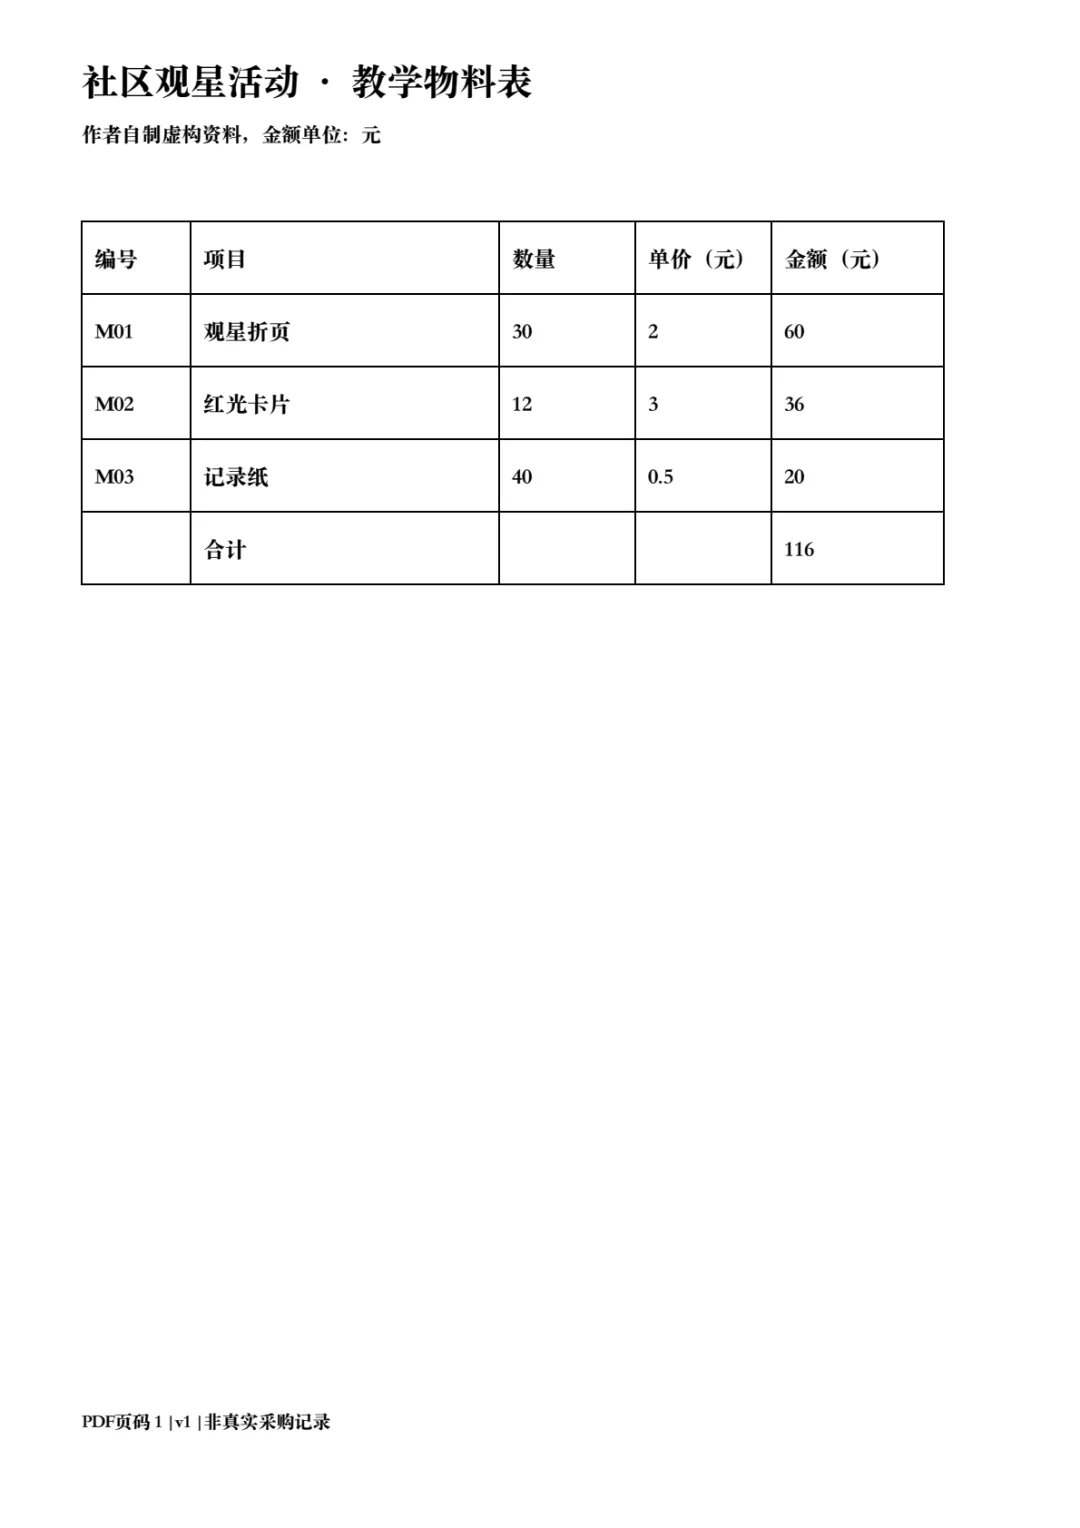
▲ 图1:自制教学PDF第1页。原页与摘录分别保留;这不是客户端截图。
把输入留一份副本,再在中文版新建任务,选择这份练习目录。原PDF应直接交给工具处理,不必先人工抄成文本,避免把自己的抄写错误混进识别结果。
先摘录,再回到那一格
本次要求使用与PDF对应的内置能力,输出CSV和核对说明:
这是WB09作者自制PDF练习。使用PDF相关内置技能,依据input/提取要求.md,先处理input/text.pdf与input/scan.pdf,输出根目录output/run-01/摘录.csv和核对说明.md;逐行保留PDF文件名、从1开始页码、项目编号、名称、数量、单价、金额、识别状态、页上依据。不要把合计行当项目行,别串列。扫描版无文本层时尝试当前实际可用OCR/视觉读取,不能识别要说明,不编造字段;不能识别也应保留行的待确认状态。不要安装外部软件、联网或改输入,记录实际读取方式与限制,源路径只写相对位置。 一条可查的摘录,应当能回答:出自哪份PDF、哪一页、哪个项目、哪一列;这格是明确读到的,还是仍需人工确认。
页码在这里统一按PDF文件从1开始数。若页面上另印了页码,要分别说明,不能把两个编号体系混成一个。
本轮CSV共六条项目记录:文本版和扫描版各三条。作者逐格核对名称、数量、单价、金额与PDF第1页一致;M03的0.5元保留正确,合计行没有混成项目行。扫描版先经历自动OCR失败,随后采用页面视觉读取,说明中分开记录。
核对时,不必先通读所有说明。选M02,沿着这一行查:项目名“红光卡片”,数量12,单价3元,金额36元;再查文件与页码。
接着查M03的小数点。0.5和5只差一个点,乘以40,金额就从20变成200。识别结果即使语言通顺,也需要回到原页确认这个符号。
最后检查三条项目合计60+36+20=116。合计能帮助发现问题,但总数碰巧对上,也不能替代每一格的核对。
扫描页的读取方式,也要记下来
中文官方办公文档四件套说明〔1〕列出了PDF提取和OCR相关能力。本例只记录本次环境实际采用的方式,不承诺扫描文件的统一识别率。
如果直接提取没有文字,先确认是不是纯图像页,再看当前任务是否尝试了实际可用的OCR或视觉读取。如果工具不可用,就把这个限制与未确认字段写在说明中。
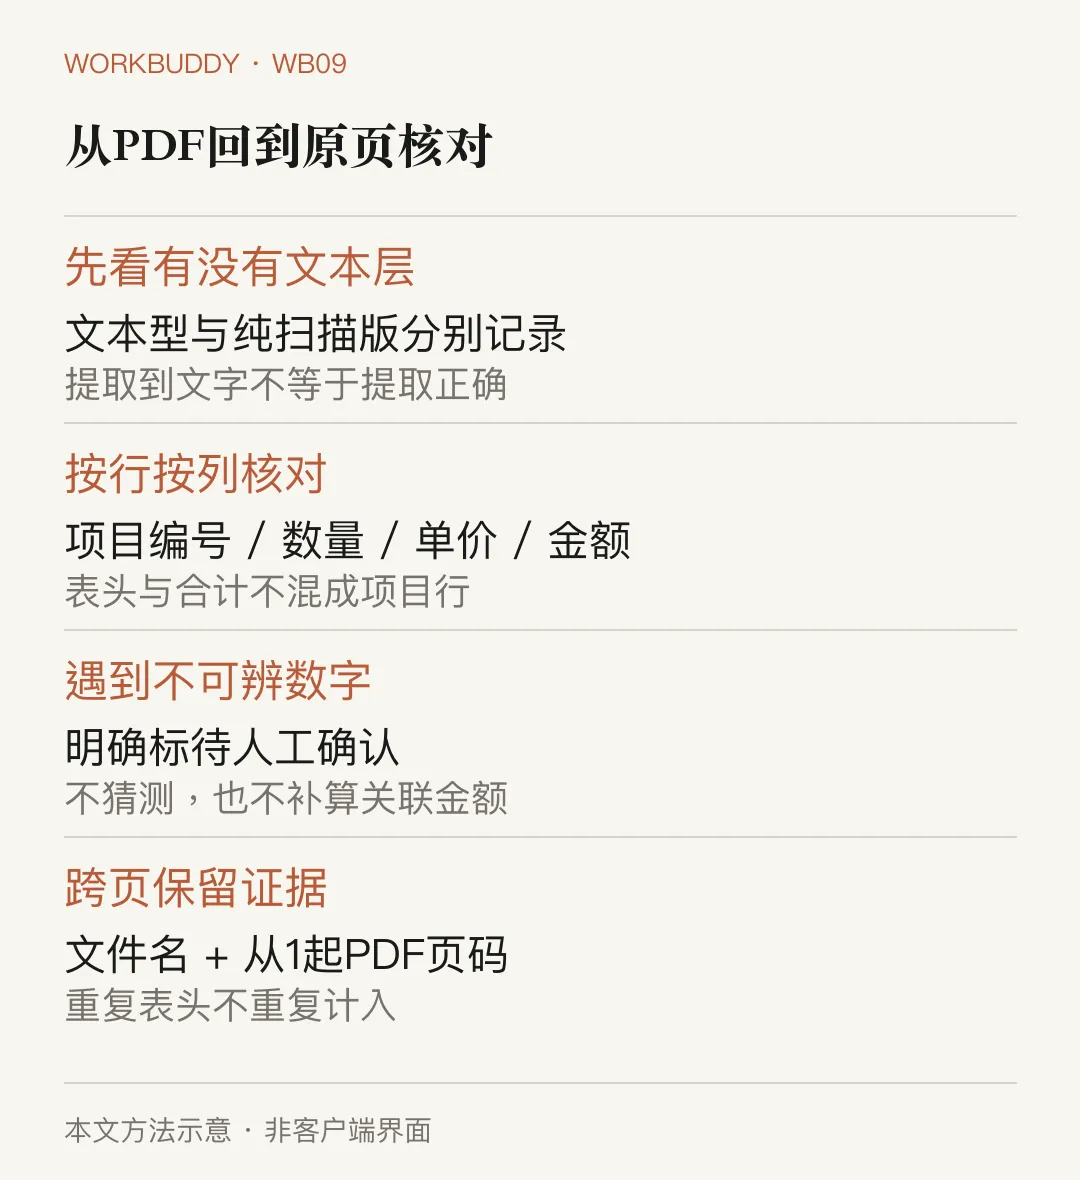
▲ 图2:本文方法示意。文字层、字段正确性和页码证据分别检查。
“已识别”是一个需要证据的状态。只生成空CSV,或者把text.pdf的数字直接复制给scan.pdf,都不能证明扫描版已经读取正确。
本篇的两份文件故意相同,是为了让作者建立对照,不是授权工具把另一份文件当作扫描页的替身。各文件的读取方式与结果要分别保留。
读完这一轮,可以遮住原页复述:哪一格最容易串列,哪一个小数点最需要检查,摘录表怎样帮助你找回证据。
看不清的数字保留,跨页的表接起来
再加入两份受控练习。ambiguous.pdf把数量印为“8?”,并明确说明第二位不可辨。这是作者设置的歧义标记,不冒充真实低清扫描,也不拿它测OCR识别率。
不能把它理解为8,也不能猜80。数量待确认时,关联金额也不能靠猜出的数量补算。
multipage.pdf则把同一张表分成两页,第二页重复表头。要按项目编号和PDF页码接起来,不能把重复表头当数据,也不能漏掉最后一项。
继续只处理input/ambiguous.pdf和input/multipage.pdf,输出根目录output/run-02/摘录.csv与核对说明.md,保留run-01及输入。ambiguous中数量印为“8?”且旁注明原稿第二位不可辨,这不是合法数量,请标待人工确认,关联金额也不补算。跨页表按PDF页码和项目编号对接,重复表头不算数据,首尾项目都保留。用实际工具读取,不安装软件、不联网,不猜未给数字。 本轮M04数量保留原印字符8?,识别状态为待人工确认,金额为原页未提供,没有猜出数值。跨页表保留M05—M08,页码为1、1、2、2,四项金额合计43;首轮两份产物的内容指纹不变。
跨页表的四条项目是M05到M08,金额8、20、12、3元,合计43元。先查第一页最后一项与第二页第一项,再查尾项M08,通常比只看摘要更容易找到漏行。
最后给摘录表做一个简单自测:①扫描版没有文字层,能写“原页为空”吗?②“8?”该写成哪个确定数值?③两页都出现表头,能算成两条项目吗?
参考:①不能,须看原页并记录实际识别条件。②不能确定,应标待人工确认,关联金额不猜补。③不能,按项目编号和表格结构去掉重复表头。
提取结束时,留下的应当是能回到原页的字段,以及尚未解决的问题。把不确定的那一格标出来,比替它补一个看似合理的数更有用。
上一课:WB08《把一份会议记录变成可交接的 Word 纪要》。
下一课:WB10《清理报名表:重复、空值和日期格式》。发布后补充链接。
配套资料:在「云间码客」公众号会话中发送 WB09,领取本课练习包。
资料来源
以下保留原文引用地址,供查对;网址可复制后打开。
〔1〕https://www.workbuddy.cn/docs/workbuddy/From-Beginner-to-Expert-Guide/WorkBuddy-Zero-Cost-Skill-Top-10/Office-Document-Suite