ARTICLE · 1371163
从文档库到知识库的跨越-可检索的知识图谱
关注公众号或发送消息“获取资料”,免费获取数据管理相关资料。
一万份合同堆在一个目录里——这叫合同文件库,不叫知识库。你搜"张三签过的所有合同",搜出来的是一堆文件名,不是答案。何况你输进去这么长的文字,也不一定能找到是张三的合同。
数据治理不是仅仅去治理数据库中的数据,而是让文件中的知识直接变成答案给到你。
知识不是文档,是"关联起来的文档"。通过四步工作,文档才变成知识。
从零件到机器:零碎的知识片段如何成为系统化的知识
从文档库到知识图谱,就像从一堆零件组装成一台机器。
先把零件分类——螺丝归螺丝,齿轮归齿轮。这叫实体对齐。
再把零件组装起来——齿轮带动链条,链条驱动轮子。这叫关系构建。
给机器装上仪表盘——转速表、温度计、油量表。这叫属性填充。
最后把机器放到车间里——随时能用、随时可查。这叫图谱存储。
少一步,机器都转不起来。
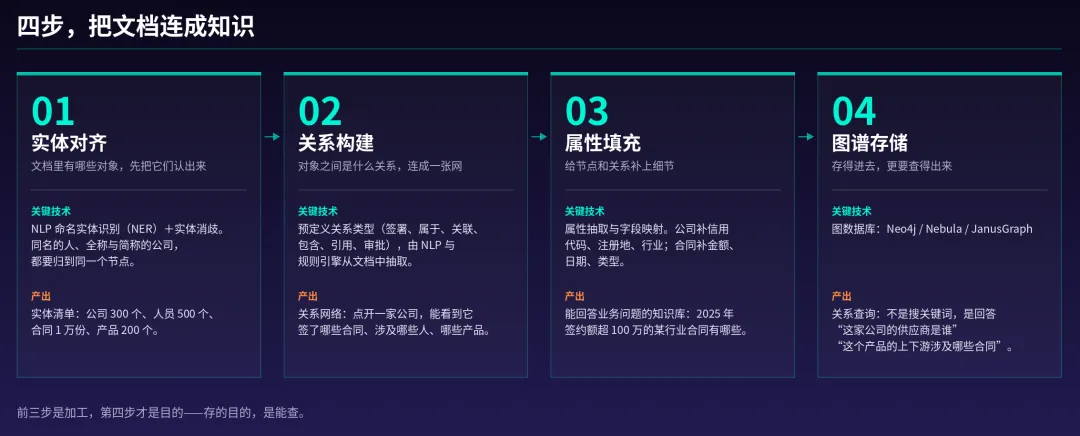
第一步:实体对齐——文档里有哪些对象
实体就是你的知识图谱里的"节点"。
一份合同里有哪些实体?甲方公司、乙方公司、签署人、合同项目、关联产品。所有这些都先识别出来,归好类。
技术手段:NLP 做命名实体识别(NER),把公司名、人名、金额、日期提取出来。然后做实体消歧——"张三"在合同 A 里和合同 B 里是不是同一个人?同一个公司的全称和简称是不是同一家?
产出:一个实体清单——公司 300 个、人员 500 个、合同 1 万份、产品 200 个……
第二步:关系构建——对象之间什么关系
关系就是实体之间的连线。
合同 A 的甲方是"XX 科技",乙方是"YY 集团"——这就建了一条"签署"关系。签署人是张三→属于"XX 科技"——又一条"属于"关系。
这一步把散落的实体连成网。关系类型提前定义好——签署、属于、关联、包含、引用、审批——然后 NLP 和规则引擎从文档里识别出这些关系。
产出:一个关系网络。点进去一个"公司",能看到它签了哪些合同、关联哪些人、涉及什么产品。
第三步:属性填充——给节点和关系补细节
光有实体和关系还不够。每个实体必须有自己的属性。
公司的属性:统一社会信用代码、注册地、行业。合同的属性:金额、签署日期、有效期、合同类型。人员的属性:部门、职位、联系方式。
这些属性让知识图谱不只是"关系图",而是一个"能回答业务问题的知识库"——"找出 2025 年签约金额超过 100 万的 XX 行业的全部合同"。
第四步:图谱存储——能存进去、能查出来
前三步都做完,选择图数据库存起来。Neo4j、Nebula、JanusGraph——选哪个下一篇说。
关键是存的目的是查。图谱查询不是"搜关键词",是"回答关系问题"——"这家公司的所有供应商是谁?""这个产品的上下游涉及哪些合同?"
三个问题,检验你的图谱建没建对
文档里有哪些对象?
实体类型定义清楚了吗?合同、公司、人、产品——至少这四类。每类实体的消歧逻辑有没有?
对象之间什么关系?
关系类型定义了吗?签署、属于、关联、包含——至少这四类。关系有没有方向?(A 签署 B,不是 B 签署 A)
怎么存、怎么查?
存进去后,能不能在 3 秒内查出一个公司关联的所有合同?不能——图谱存储选型有问题。
结尾的话
四步顺序不能乱。先做了关系构建再回头改实体对齐——基本等于返工。实体对齐是地基,地基没打牢,关系全白建。
带走一句话:
你的文档不是知识,知识是"关联起来的文档"。实体对齐→关系构建→属性填充→图谱存储——四步走完,文档才变成知识。
-----------------------------
关注公众号,获取数据治理相关资料地址。