ARTICLE · 1398740
下载破100亿次、连续29周第一:中国开源模型凭什么? | AI Agent总翻车?问题多半不在模型,在"接口"
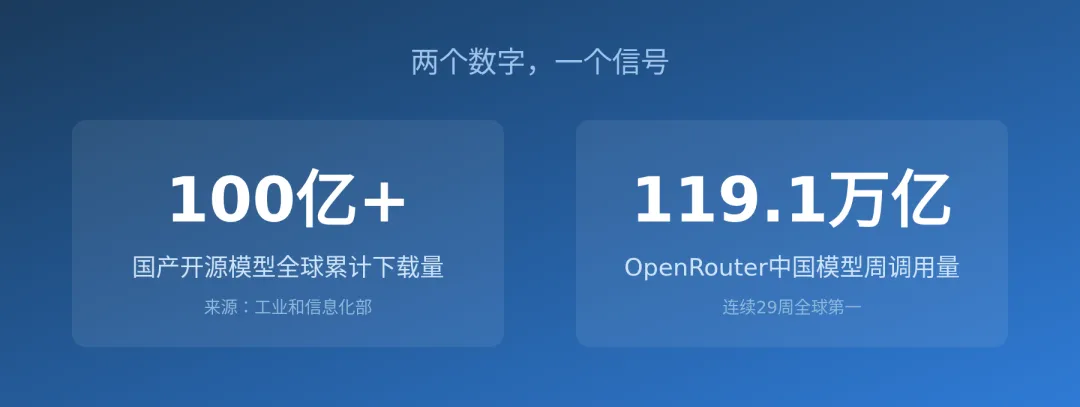
上周刷到一条数据,我盯着看了好几遍:工信部披露,国产AI开源大模型的全球累计下载量已经突破100亿次。100亿次是什么概念?差不多等于全球每个人平均下载了一次还多。
与此同时,OpenRouter这个全球模型聚合平台上,中国模型的周调用量达到119.1万亿词元,连续29周稳居第一。也就是说,全世界开发者用AI的“实际流量”里,中国开源模型才是最大的那块。下载量证明大家想拿走它,调用量证明大家真的在天天用它,分发和使用两端同时握在了一边手里。
开源的到底是什么
很多人以为开源就是把代码公开,但对大模型来说,开源的主要是“权重”。打个比方,模型像一个读过海量书籍的大脑,权重就是这个大脑里几千亿个参数的具体数值。你把权重下载下来,就能在自己的服务器上运行它,甚至拿自己的数据去微调它。
这对谁最有价值?先说企业。一家对数据隐私敏感的公司,可以把模型部署在自己的机房里,数据一步都不用出门,这比把业务全部托付给某一家闭源API放心得多。再说没钱从头训练的小团队,开源模型等于白送了一个底子极好的底座,直接在上面开发自己的产品就行。
词元成了新商品
另一个让我觉得有意思的变化是,“词元”本身变成了商品。国内日均词元调用量已经突破500万亿,网购平台上线了词元充值中心,今年双11直播间里连词元都成了抢手货。
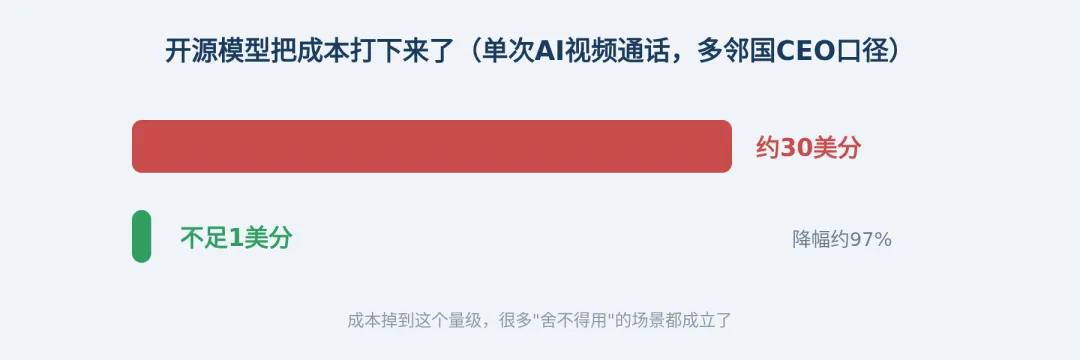
词元是AI读写文本的基本单位,它可计量、可定价、可交易。AI的使用方式因此变得像水电一样:按用量付费,随用随买。多邻国的CEO算过一笔账,开源模型把单次AI视频通话的成本从约30美分压到了不足1美分。成本掉到这个量级,很多原本“舍不得用”的场景就都成立了。
为什么开源能赢这一轮
回看今年的节奏。7月底月之暗面把2.8万亿参数的Kimi K3全量开源;近日又放出了K3.1 Pro完整权重,在技术社区引起不少讨论。DeepSeek的V4系列把百万字超长上下文带进开源领域;腾讯混元发布Hy4,首次把视觉能力带进这个系列。
11月中旬还有个标志性动作,Thinking Machines开源了594B参数的Inkling 2 Small,权重用Apache 2.0协议随便下载。海外实验室也加入了送权重的行列,这个趋势比任何一款单个模型都值得记一笔。
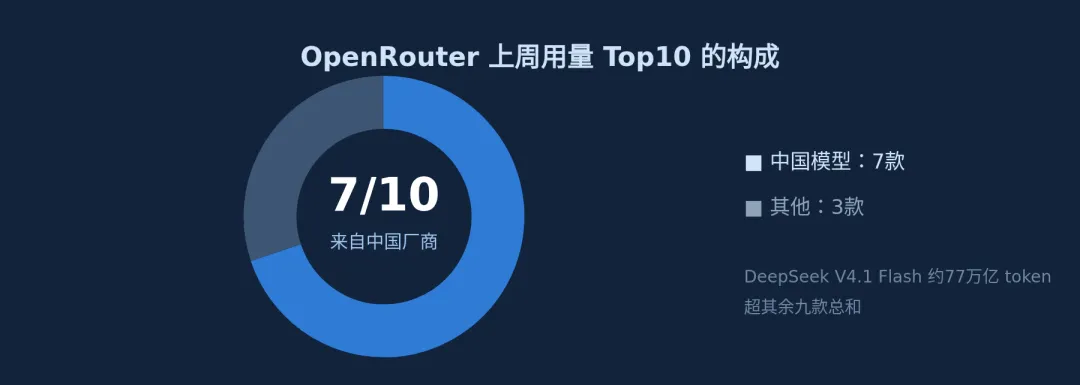
开源模型抢占流量的逻辑其实很朴素:免费、能下载、能改造,选型成本几乎为零,流量自然流过来。OpenRouter上周用量前十的模型里有7款来自中国厂商,仅DeepSeek的V4.1 Flash一款就处理了约77万亿token,比其余九款加起来还多。风投家比尔·格利甚至公开建议谷歌也开源,把免费开放当作对抗Anthropic的策略,当年谷歌用安卓对抗苹果,用的是同一个思路。
对普通人意味着什么
第一,把“付费API”默认改成“先看开源替代”。哪怕你不会部署模型,至少在选AI工具前查一下它底层跑的是什么。跑在开源权重上的产品,价格战打得更狠,你获得同等能力的成本更低。
第二,小团队攒“本地AI”的门槛低到了家庭级。一台带高性能显卡的电脑加一个开源模型,就能搭出不经过任何云端的私人助手,适合处理合同、病历这类敏感内容。预算不够可以选激活参数小的版本,效果已经够日常用。
第三,把“词元消耗”当成本意识培养。长上下文、反复追问、让它读整本书,都是烧词元的大头。给团队做AI预算时,按词元定价来估算,比按“每月订阅费”估算准确得多。
把红利接住
开源竞速跑到现在,红利已经落到你手里了:下一款你付费的AI产品,底层多半就是一个免费开源的模型。价格更低、迭代更快,正是这场竞速带来的。
门槛被拆掉的那一刻,人人都是赢家。
你在用哪款开源模型?评论区聊聊你的选择。
第二篇:AI Agent总翻车?问题多半不在模型,在“接口”
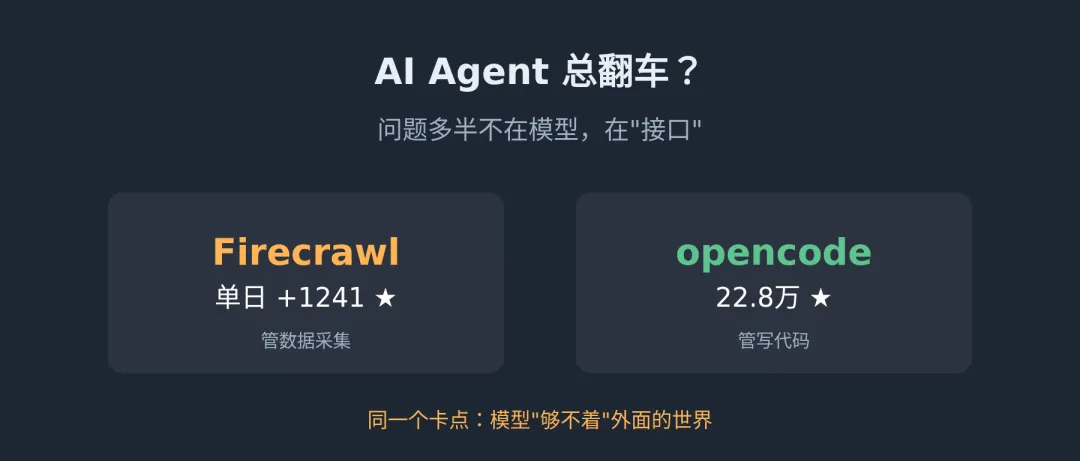
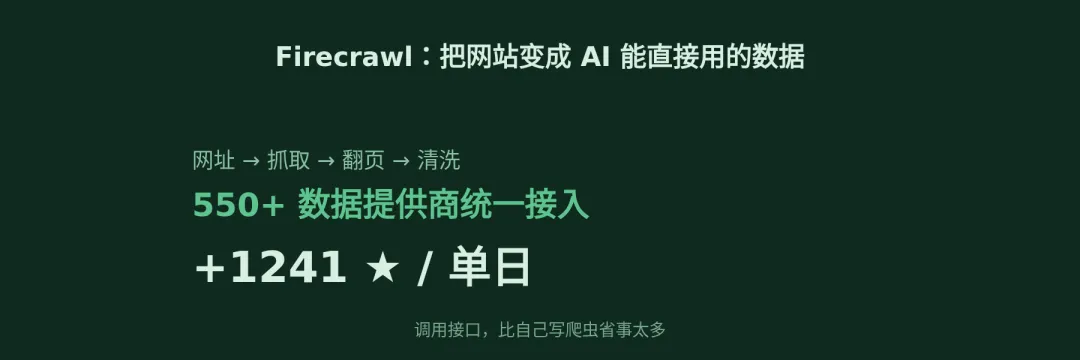
最近GitHub上有个爬虫工具突然爆火:Firecrawl单日新增1241颗星。同一时间,开源AI编程agent opencode悄悄冲过了22.8万颗星,是GitHub上热度最高的AI编程agent之一。
两个项目方向完全不同,一个管数据采集,一个管写代码,但涨星的原因指向同一处:今天绝大多数agent卡住的,多半是模型“够不着”外面的世界。这两件事加在一起,正好把一个新分层讲清楚了。
Agent最缺的一层:接口
想象你雇了个能力超强的助理,但他没有电脑、不能上网、看不到你的文件。再聪明也白搭,因为他干活的前提是先拿到信息。
今天绝大多数agent卡的就是这一步。让AI帮你做行业调研,它得能读几百个网页;让它管库存,它得连上你的ERP;让它写代码修bug,它得能搜整个代码库。模型负责“想”,但“看”和“拿”是另一层工程。这层做不好,前面的聪明全是空转。
Firecrawl:给AI配一双“联网的手”
Firecrawl做的事,是把网站变成AI能直接用的数据。给它一个网址,它会抓页面、翻页,还能绕过那些专为人类设计的交互,最后输出干净的结构化文本。它的最新亮点是接入了550多个数据提供商,等于一个统一入口。
点星的理由很实际:调用一个爬虫接口比自己写爬虫省事太多。抓一个网页不难,难的是抓一百个结构各异的网页还要保持稳定,这正是agent项目最容易被拖垮的地方。工具化、服务化之后,开发者只管用。
opencode:开源社区养出来的编程agent
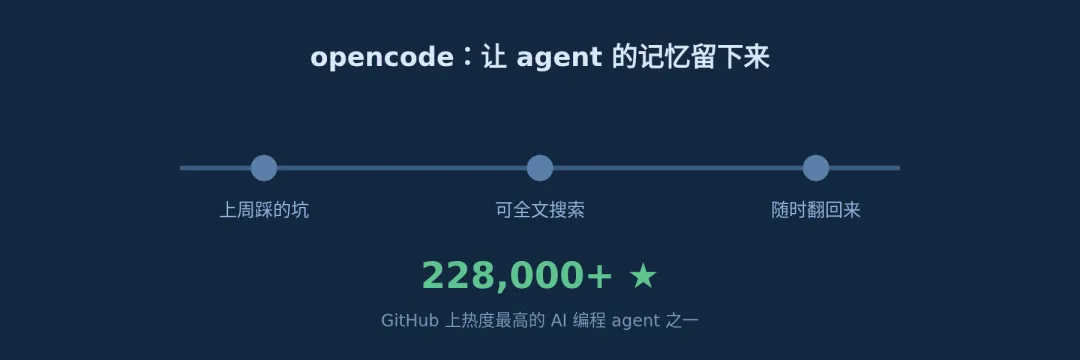
opencode是另一个思路的样板。商业编程助手不少,opencode坚持开源、社区驱动,星数一路涨到22.8万,是GitHub上热度最高的AI编程agent之一。它最近在开发会话全文搜索功能,让你能在和AI的整段工作记录里直接检索,还打磨了自动化配置。
这个功能小,但它指向的痛点很真实:用AI写代码最大的浪费是重复劳动,同一个坑上次问过,这次又问一遍。历史记录能搜,agent的记忆就从“聊完即焚”变成了可积累的资产。半年后新同事接手项目,能直接搜到当时怎么踩的坑。开源路线还有个隐性好处,功能跟着真实用户的需求走,更新节奏全透明。
三条建议,今天就能用
第一,搭agent先解决“数据接入”再调prompt。顺序别搞反。模型回答不好,很多时候是喂进去的信息就是脏的、缺的。先确认工具能不能稳定拿到目标数据,再去优化提示词,效率高一个量级。
第二,把“历史可检索”当选型标准。不管选编程agent还是别的,优先挑支持会话记录搜索、能导出工作日志的。AI工作过程沉淀下来,新人和后来的自己都能省下一大笔重复探索。
第三,开源项目别只看星数,看更新密度。星数衡量热度,commit频率和issue响应速度才衡量健康度。Firecrawl、opencode这类高热项目值得跟进,但接入前先翻翻最近两周的提交记录,别接一个停更半年的项目。
聪明要有着力点
模型竞争吸引了所有眼球,但真正决定agent能不能干活的,往往是这些不起眼的“水电煤”层。数据接得进来,记忆留得下来,聪明才有着力点。
模型能力每半年洗一次牌,接口层一旦搭好就是长期资产。
你搭过AI agent吗?卡在模型还是在数据上?评论区聊聊。