ARTICLE · 1399426
手把手教你用Dify搭公司级知识库:从文档切分到验收,一篇讲透!
前面我们已经聊过,关于如何搭建自己的知识库收藏百篇干货全吃灰?实测4套AI知识库,手把手教你搭(附提示词),这次我们就来聊聊如何打造企业级的RAG知识库。
个人平时自己用的知识库,偶尔漏答一句、答偏一次,你自己顺手翻一下原文就过去了。
但一旦把公司几百份规章制度、合同范本、产品参数手册、售后SOP塞进知识库,准备丢给员工或客户自助查询,很多人马上会撞上一堵墙:演示Demo时像神仙,一上真实业务就翻车——退款条款的前提条件被切丢了、问具体产品型号搜不出来、去年的作废制度比今年的新规排名还靠前、客户连问两句系统就彻底失忆。
个人玩具库追求「差不多能用就行」;而给团队和客户用的知识库,追求的是确定性。答错一个报销标准,员工就按错的去贴票;答错一句售后政策,客服就要替AI背锅。
为什么直接把文档往向量库里一扔,做不出能交付的系统?
今天这篇,我们先拆开腾讯ima公开的底层问答架构,看清企业级知识库是怎么运转的;再把落地时高频踩中的4个典型事故和对应的Dify全套调优配置、防胡编提示词、上线前8道验收题一次性摊开。照着配完,你的知识库才能真正从「玩具」变成「敢上线的业务系统」。
01
PART
先看标杆:腾讯ima
很多人好奇,像腾讯ima这类成熟产品,为什么塞进去公众号文章、PDF、Word之后,既能搜出同义表达,又能准确跳回原文高亮?
根据腾讯工程师公开分享的技术架构,它的底层链路其实非常清晰,分成入库和提问两段:
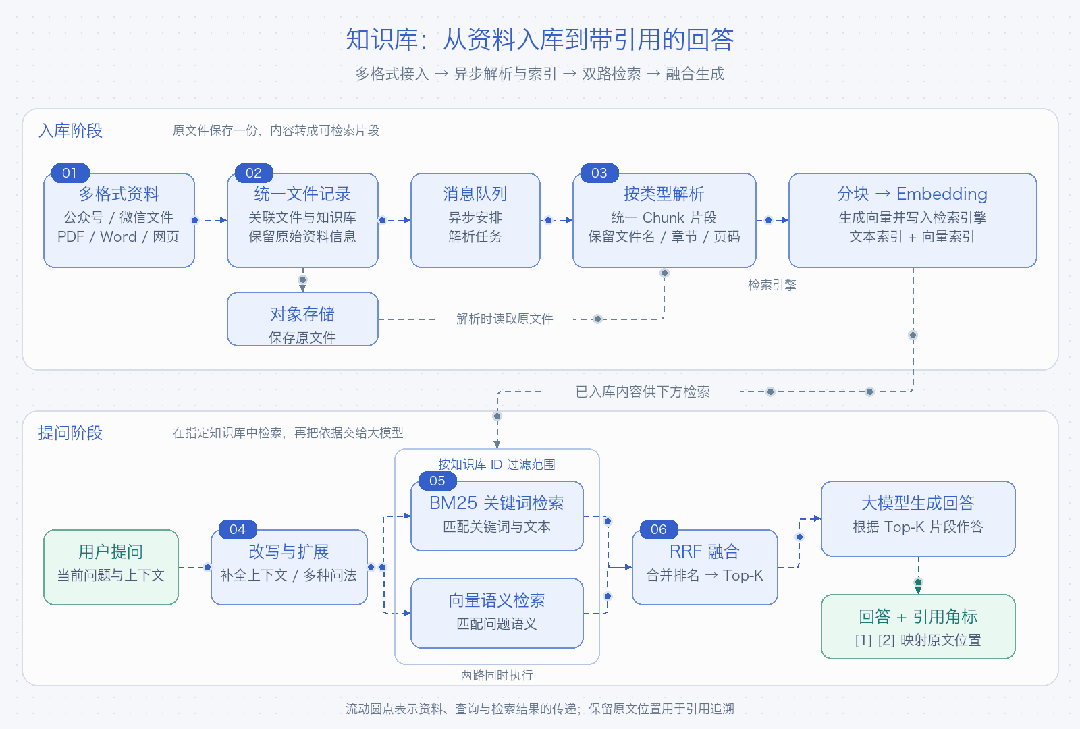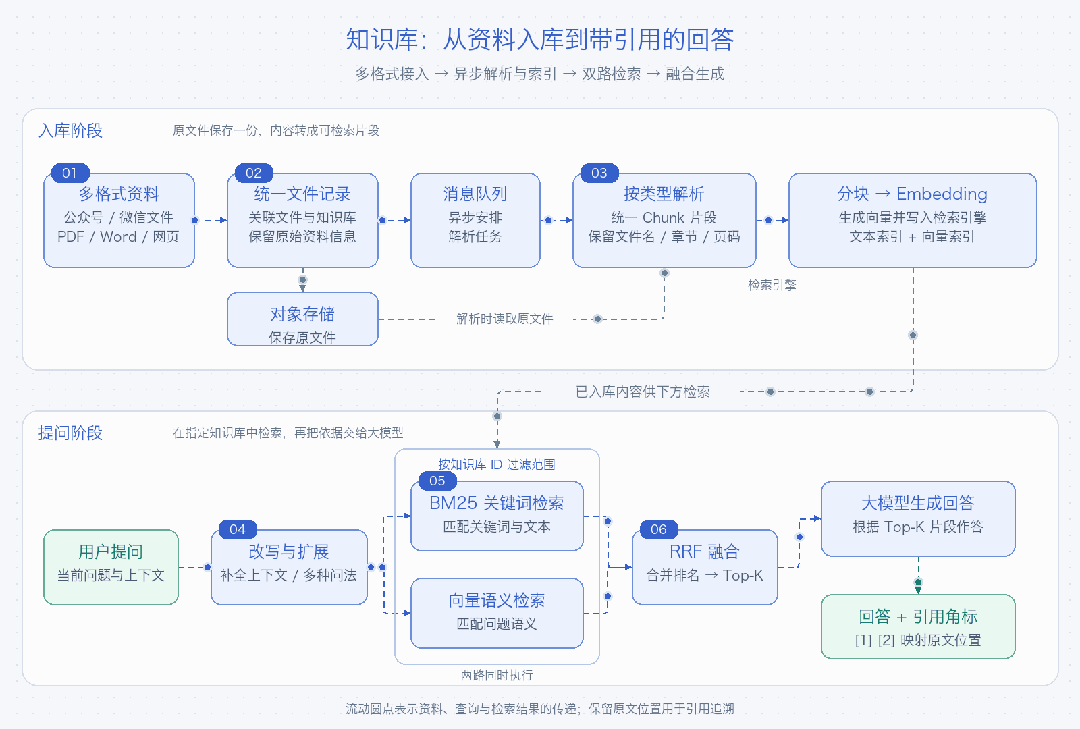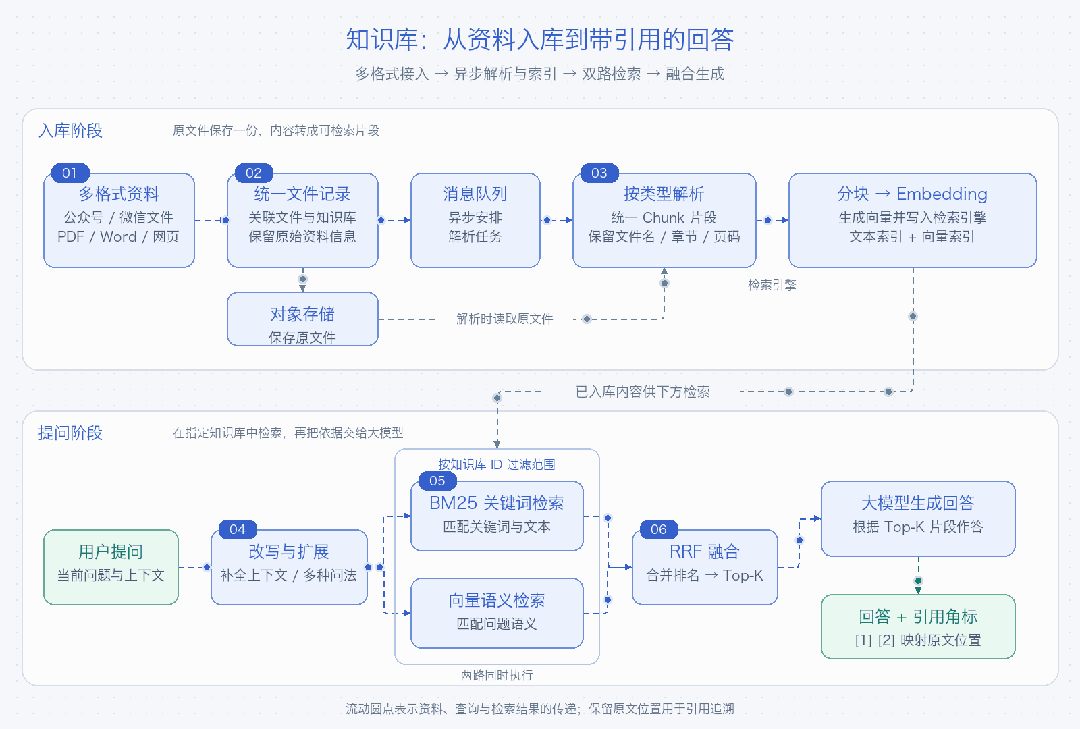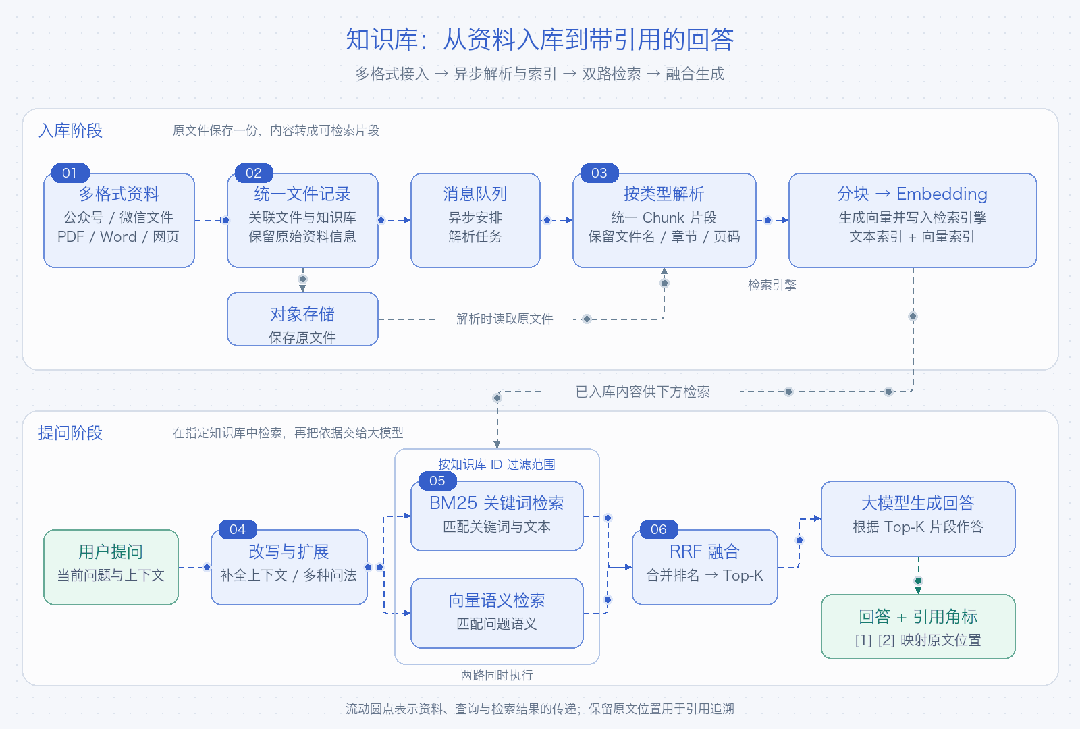
看懂这个,你就抓住了企业级知识库能稳住不翻车的3根支柱:
不能只靠单路向量检索:像「退货」和「退款」这种近义词靠向量语义检索;但药品名、合同条款号、商品SKU、错误码,必须靠BM25关键词检索精确命中,两路结果融合才稳。
切分时必须保住结构与位置数据:片段里除了正文,还要锁住文件名、章节、页码和完整语义单元,回答里的[1][2]角标才能准确跳回原文。
提问前有改写,生成时有约束:用户的口语化半截提问要先补全再搜;大模型生成答案时必须被严格限制在检索片段内,没依据就拒答。
这套大厂架构,我们自己用开源工具能不能复刻出来?完全可以。用Dify就能把这一整套链路搭出来,但前提是你得跨过下面这4个真实业务里的高频卡点。
02
PART
企业落地的4个典型事故
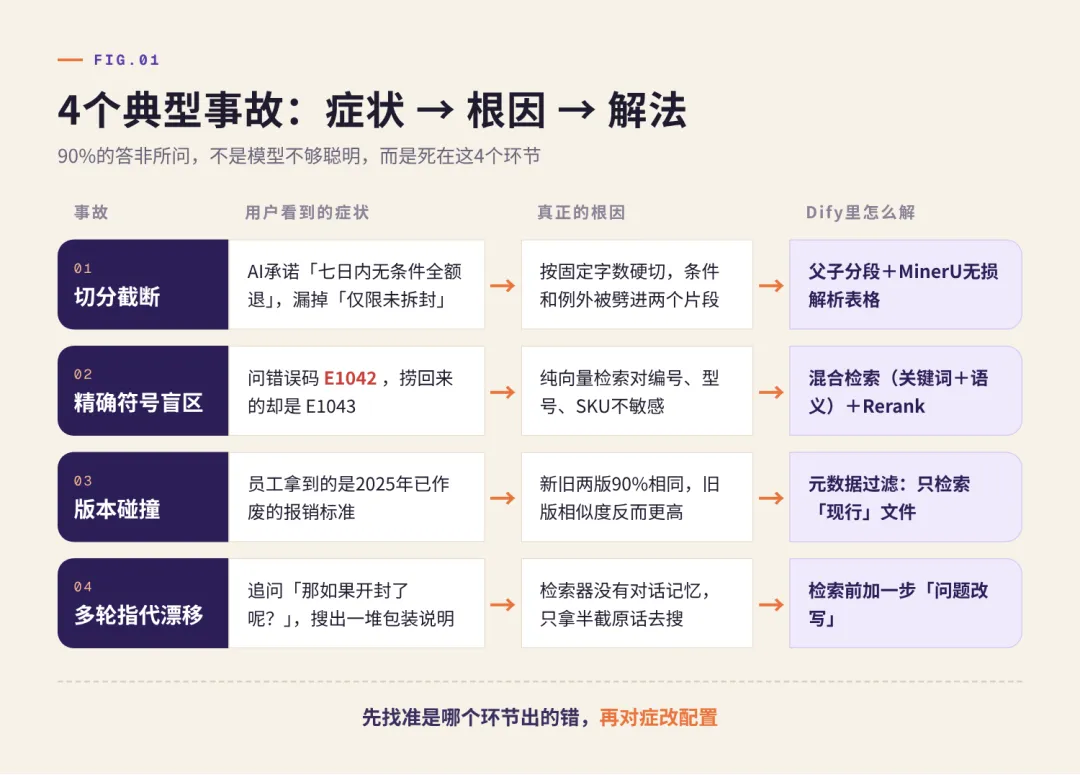
在帮团队排查知识库问题时,我发现90%的「答非所问」,都不是大模型本身不够聪明,而是死在了下面这4个环节:
事故一:条款被腰斩、表格丢表头(切分截断)
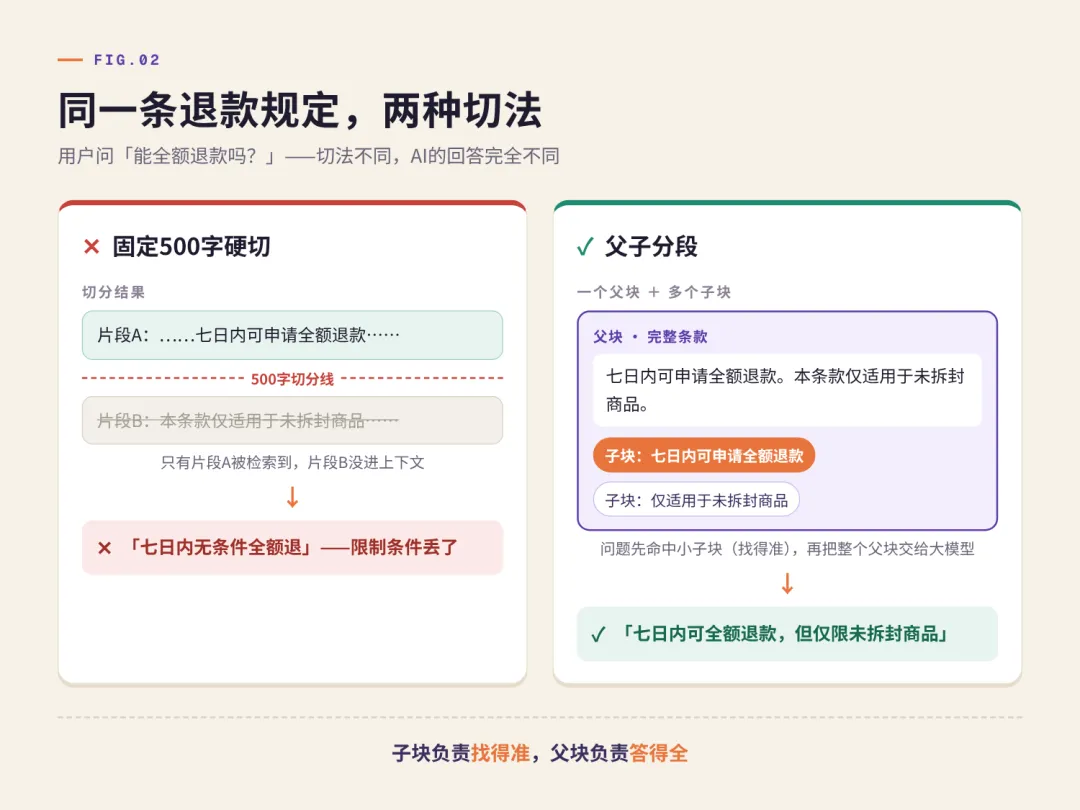
很多初级方案默认按固定字数硬切,比如每500字切一块。合同、制度和参数表一遇上这种刀法必死无疑。
来看一个真实的售后翻车现场:公司的退款规定前半句写「七日内可申请全额退款」,后半句写「本条款仅适用于未拆封商品」。结果500字切分线刚好落在这两句话中间,把它们劈进了两个不同的片段。
客户来问「能全额退款吗」,系统只检索到了前半段交给大模型,后半段的限制条件根本没进上下文——AI当场向客户承诺「七日内无条件全额退」。
表格也是一样。一页PDF里的产品参数表按纯文本流切开后,第15行的数值和第1行的表头彻底分家,AI连这一列代表「电压」还是「售价」都分不清,答出来的数字全是张冠李戴。
工程铁律:一条完整的业务约束(条件+例外+适用范围),或者一张表格的表头与数据,必须落在同一个交付给模型的上下文单元里。
事故二:搜得出「上不了网」,却搜不出「错误码E1042」(精确符号盲区)
很多人迷信「向量检索万能」。的确,用户口语化问「电脑上不了网怎么办」,文档里写的是「网络连接异常排查流程」,字面完全不同,向量检索靠语义相近能漂亮地捞出答案。
但一旦到了真实业务现场,员工和客户问的全是精确符号:系统报错码E1042、故障工单号INC-2026-Q4-011、产品SKU、合同编号、具体药名与规格。
这类编号在向量空间里几乎是孤立点。纯向量检索会把一堆「看起来像故障排查」的泛泛段落捞上来,甚至把E1043的处理步骤当成E1042喂给模型,偏偏漏掉真正写着E1042的那一行。
事故三:2025年的作废旧规,把2026年新规挤了下去(版本碰撞)
公司的制度年年更新。2025版和2026版差旅报销制度,往往90%的文字一模一样,只改了住宿标准金额和生效日期。
如果两版文件同时躺在知识库里,纯靠相似度排序,旧版因为历史引用多、表述标准,得分经常比新版还高。把新旧两个版本一起塞进Top-K让大模型「自己看着办」,结果就是员工拿到的往往是去年的作废标准。
事故四:追问一句「那如果开封了呢?」,搜出一堆包装说明(多轮指代漂移)
真实问答很少只问一句。客户前4轮一直在聊「Pro套餐的退货政策」,第5轮突然随口问了一句:「那如果开封了呢?」
如果你直接拿「那如果开封了呢?」这7个字去知识库里做检索,检索器是没有对话记忆的——它会满世界去搜包含「开封」两个字的文档,最后给你捞回来一堆《包装盒防拆标签说明》《开箱验货指南》,回答瞬间崩盘。
看清了这4个事故的根因,接下来我们直接进Dify,一步步把它们全部解决掉。
03
PART
Dify建库前:必须选对的3个不可逆开关
Dify既可以用云端版快速试跑,也可以用开源社区版免费部署在公司自己的服务器上。但在点击「创建知识库」时,有3个核心开关建好后就不能直接互换或降级,第一步就要选对:
数据来源:普通纯文本文件选「导入文件」即可;但如果你的资料里有大量扫描件、复杂表格,或者需要组合网页、云盘、Notion与专用解析插件,直接选「知识流水线」——普通知识库建好后,没法直接切换成流水线。
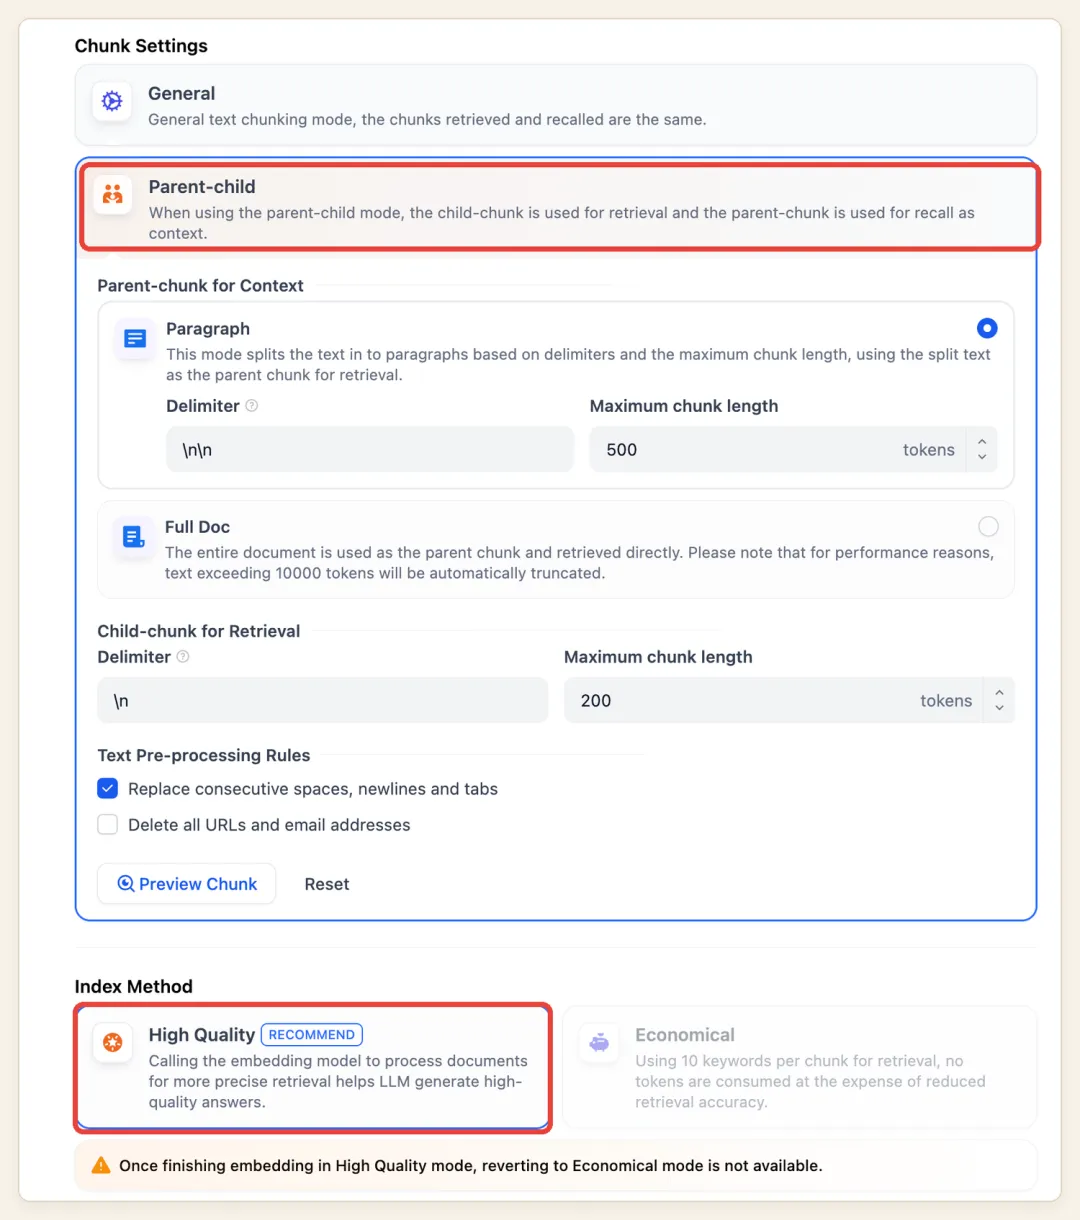
分段模式:分为「通用模式」和「父子模式」,建库后不可互换(后面只能调分隔符和长度)。企业制度、合同、手册,一律优先选父子模式。
索引方式:分为「高质量」和「经济模式」,选了高质量后不可降回经济模式。企业级应用直接选高质量,这样才能开启向量与混合检索。
另外,如果是公司服务器自部署Dify,默认的单文件上传上限是15MB。遇到几十兆的大型PDF手册,让管理员在环境变量里调大UPLOAD_FILE_SIZE_LIMIT即可。
04
PART
父子分段+表格与扫描件无损解析
怎么保证条款不被腰斩、表格不丢表头?在Dify里用这套组合拳:
1. 分段策略:用「父子模式」兼顾检索准度与完整上下文
父子模式的逻辑非常聪明:先把文档切成较大的父块(比如按完整章节或大段落),再把每个父块切成较小的子块(比如按单句或小条)。用户提问时,系统拿问题去匹配子块(小块语义集中,找得准);一旦命中某个子块,系统会把整个父块(带完整前提条件和例外条款的大段落)一起交给大模型。
不同资料直接按这张表选:
配置父子分段时,有两个实战小窍门:
别拿正文字词当分隔符:Dify切分时会把你填的分隔符本身删掉!比如你填「第」去切合同,切完每一条开头的「第」字全没了。稳妥的做法是:在文档副本每个完整条款开头插入独占一行的###,再用###做分隔符,切完去「分段预览」里检查一遍。
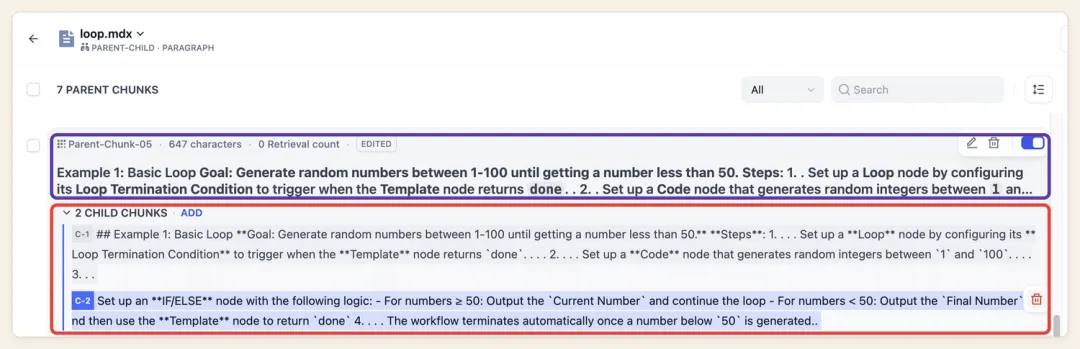
把子块改写成「口语钩子」:在Dify里手动编辑子块,不会改动父块原文。如果某条制度原文写得很官方(例如「差旅交通工具等级与席别规定」),员工搜「出差能不能坐高铁一等座」可能匹配不上。你直接在该父块下新建或修改一个子块,写上「出差能不能坐一等座」「飞机舱位报销标准」——子块当鱼钩,钓上来的是原汁原味的父块规定。
2. 扫描件与复杂表格:3步保住表头和数据
遇到图片式扫描件和跨页表格,按这3步处理:
扫描件换专用解析器:在Dify知识流水线里,去Marketplace装上MinerU插件把复杂PDF直接还原成结构化Markdown;或者选用Unstructured解析器,策略调成OCR-only或hi_res。
给表格片段加「摘要」:表格转成Markdown后,先在分段预览里确认整张表没有被腰斩。然后点开表格所在的片段,在「摘要」栏写清楚这张表是什么(例如:「2026款各型号设备电池容量与续航参数对比表」)。Dify会把这段摘要单独生成向量参与检索,直接解决纯数字表格难以被语义检索命中的痛点。
原生Excel别转PDF:本来就是Excel的参数表或问答表,千万别先导出成PDF再去切,直接保持表格结构或用QA分块入库。
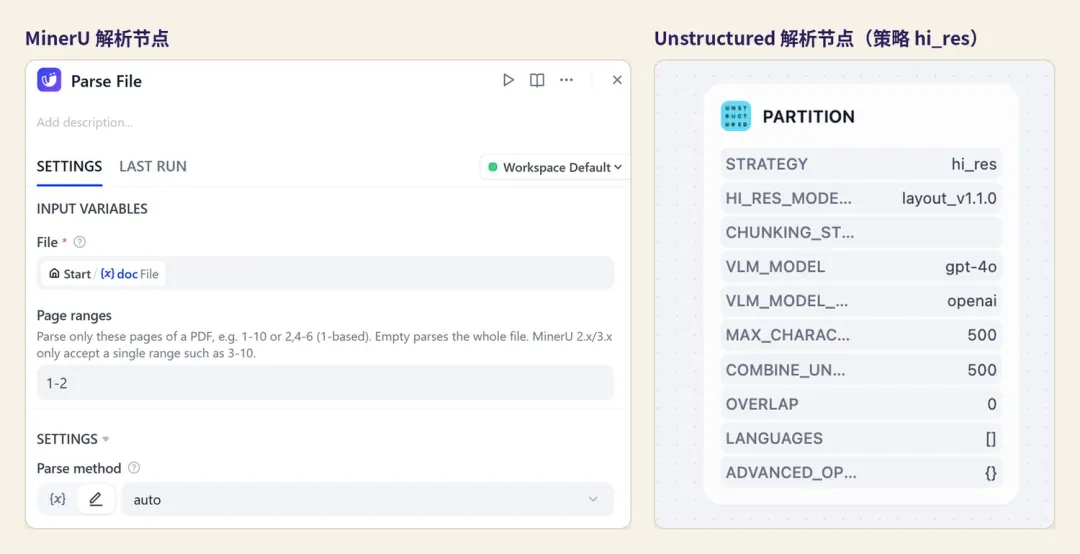
如果文档里带有2MB以下的架构图、流程图(JPG/PNG/GIF),Dify会自动提取并挂载在对应片段上。只要你的Embedding模型和Rerank模型同时选带Vision标记的多模态模型,连图片都能直接参与检索并返回。
05
PART
混合检索调优+元数据版本硬过滤
资料切干净了,接下来解决「搜不到型号」和「新旧制度打架」:
1. 开启混合检索(BM25+向量)与Rerank重排
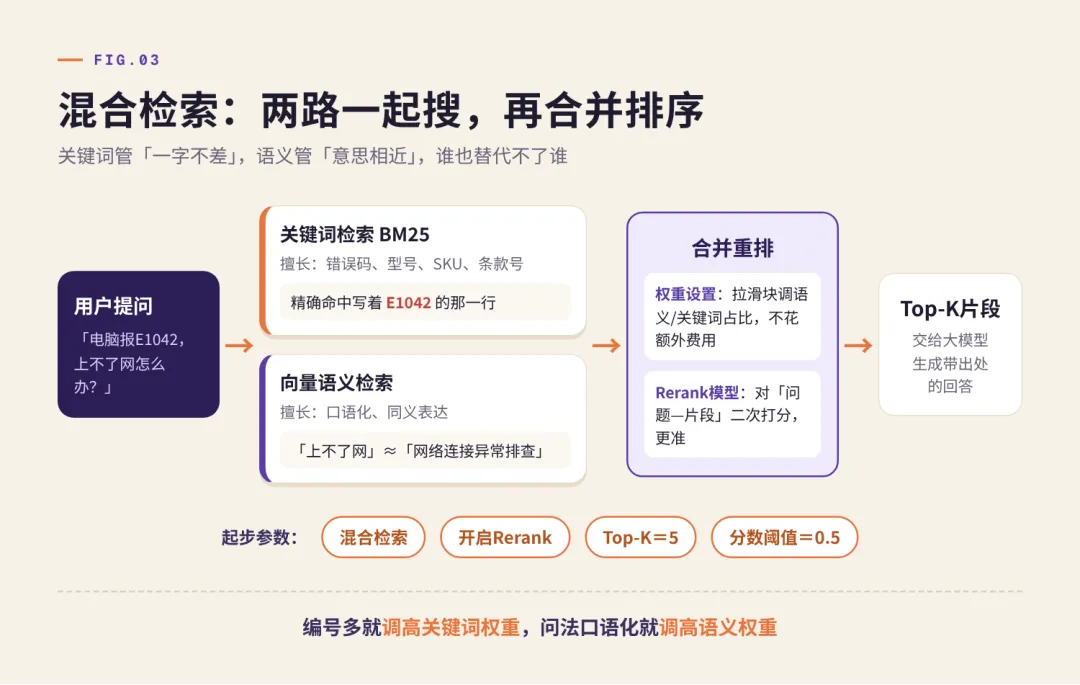
进入知识库设置,在高质量索引下直接勾选「混合检索」,让关键词检索和向量检索同时发力。Dify提供两种结果融合方式:
权重设置:直接拉动「语义」与「关键词」的占比滑块,不消耗额外模型费用。库里产品型号、错误码、条款号多,就把关键词权重调高;员工平时问法五花八门、偏口语化,就把语义权重调高。
Rerank模型:在初筛出候选片段后,调用专门的重排模型(如BGE-Reranker等)对「问题—片段」做二次精细打分。产线环境优先配Rerank模型,准确率稳出一大截。
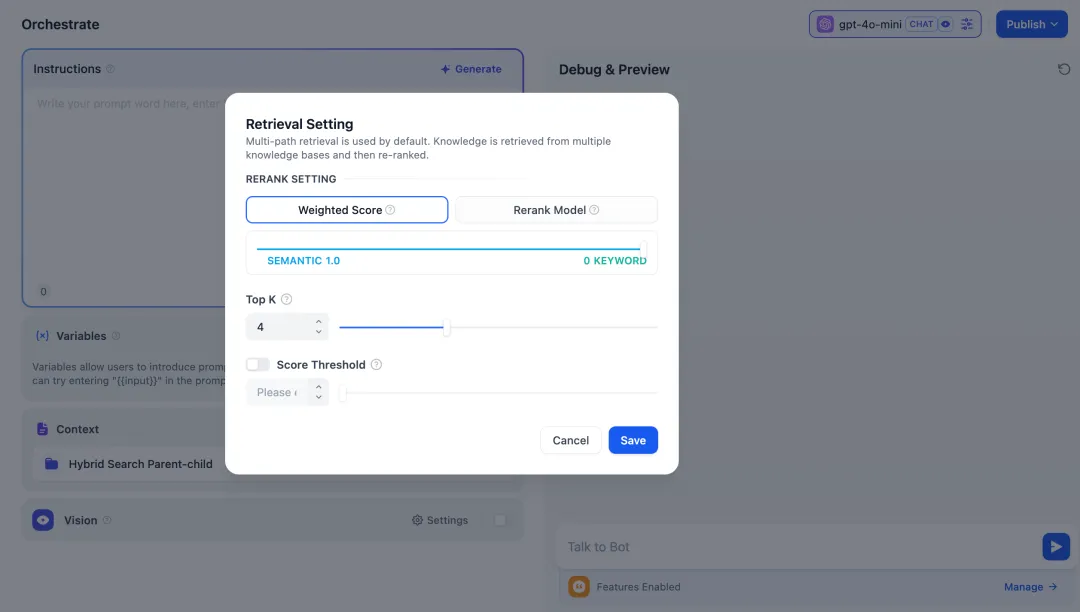
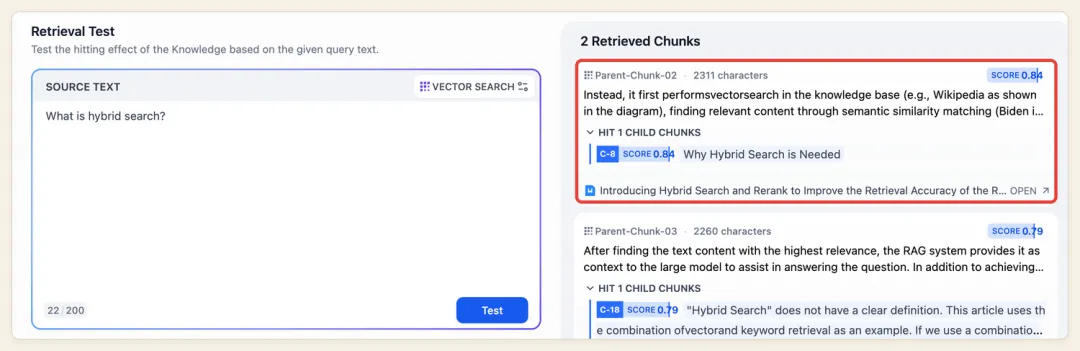
起步调参建议:先按「混合检索 + 开启Rerank + Top-K设为5 + 分数阈值设为0.5」起步。配好后,点进左侧的「召回测试」页面,把你准备好的20个真实业务问题(特别是带型号、带错误码的问题)一条条输进去试,看正确的片段有没有稳稳排在前3名。
注意一个细节:在「召回测试」页面里临时改的参数只对当次测试生效,调出满意的数值后,一定要回到知识库「设置」页点保存。
2. 用「元数据(Metadata)」锁死现行有效版本
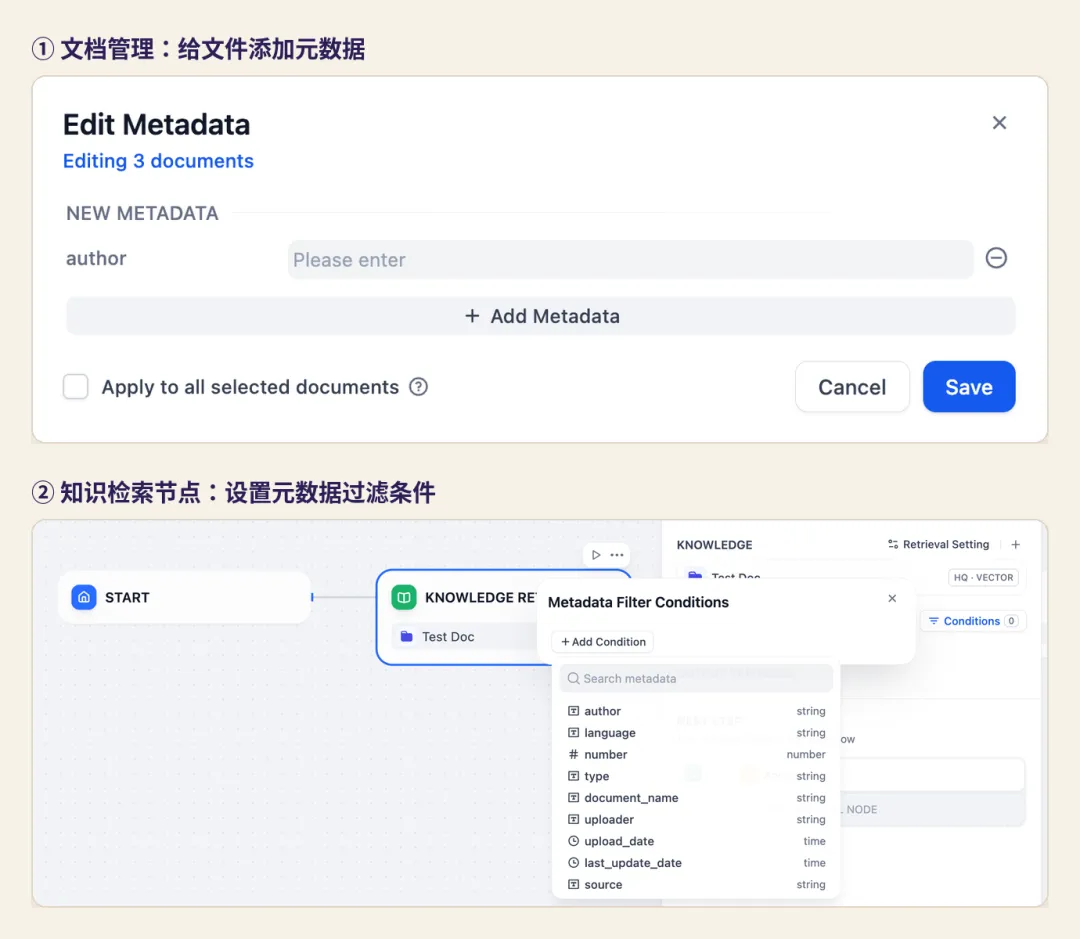
绝不能把「区分2025旧版和2026新版」的任务丢给大模型去猜。在Dify知识库的文档管理页,给每份文件打上自定义元数据标签,例如:status: 现行/作废、department: HR/财务/售后、product_line: Pro系列。
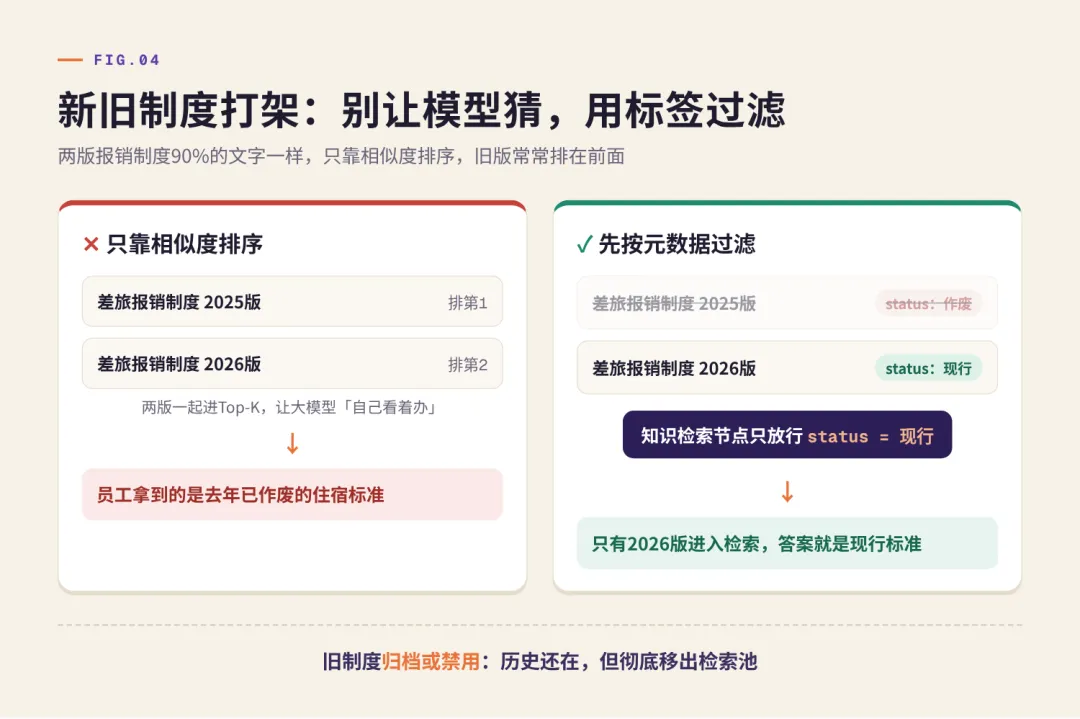
然后在Chatflow的「知识检索」节点里开启元数据过滤,硬性规定只检索status = 现行的文档;已经废止的老制度,直接在文档列表里点「归档」或「禁用」,既保留历史存档,又彻底移出检索池。
06
PART
多轮问题改写+防胡编System Prompt
1. 在检索前加一步「问题改写(Query Rewrite)」
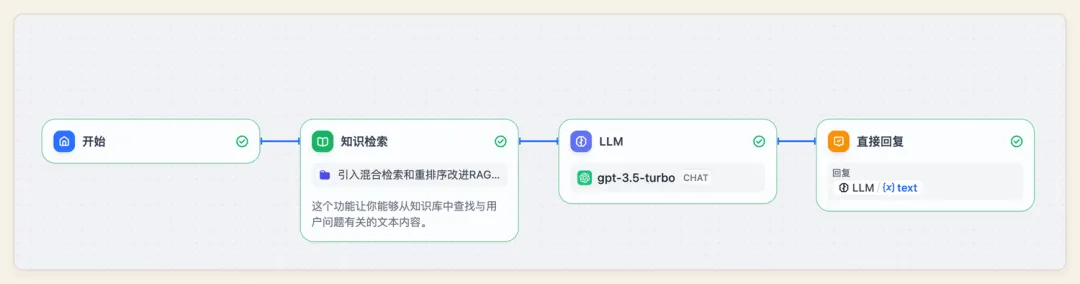
为了防止客户追问「那如果开封了呢?」时检索漂移,在Dify搭建Chatflow对话流时,不要把用户的原话直接连进「知识检索」节点,而是按这4步连线:
用户输入 → 问题改写(轻量LLM节点) → 知识检索 → 最终回答(主力LLM节点)
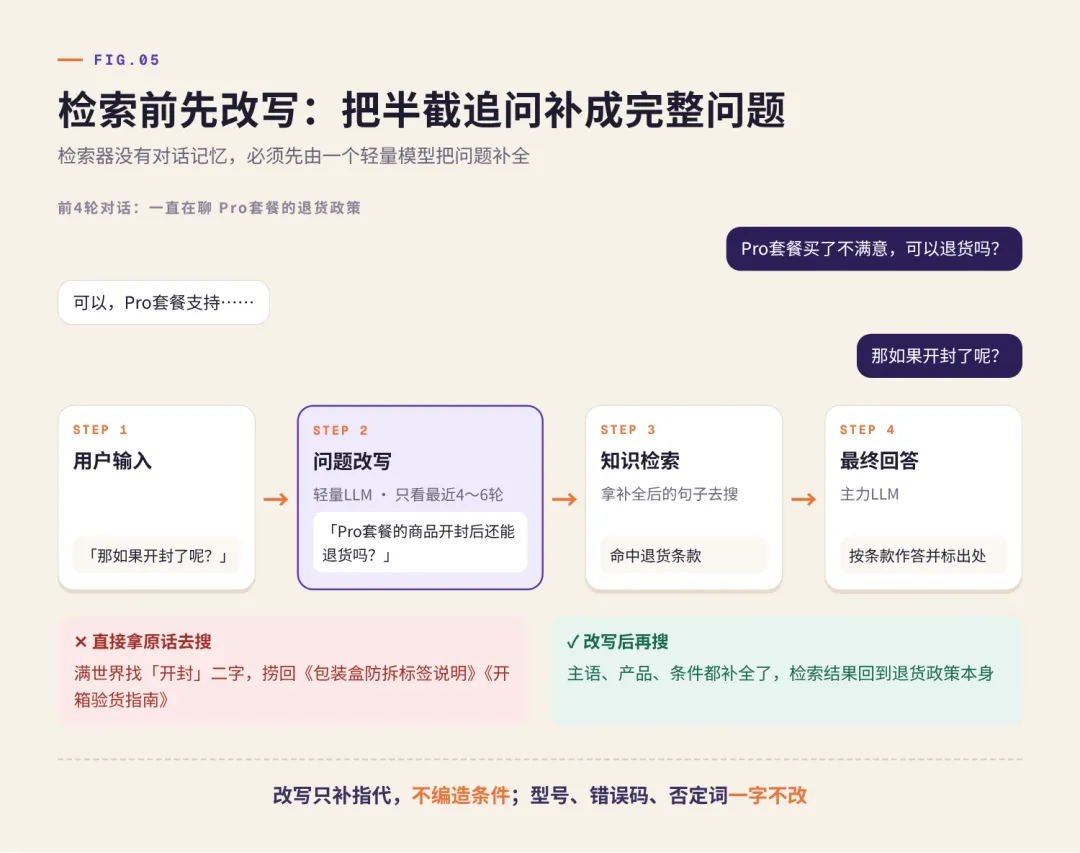
在「问题改写」节点里,开启会话历史记忆,但滑动窗口只保留最近4~6轮对话(别把几十轮历史全塞进去,否则前面的旧话题会污染当前问题),贴入这段改写指令:
2. 逼AI「句句标出处、没依据直接拒答」的系统提示词
到了最后一个负责生成答案的LLM节点,除了打开左下角功能里的引用和归属(Citations and Attributions)开关,还要在系统提示词(System Prompt)里把规矩钉死。直接复制这套模板:
如果是退款金额、医疗剂量这类零容错的高频问题,还可以打开Dify的「标注回复」功能:把人工审定好的标准问答对存进去,只要用户提问命中相似度阈值,系统直接返回完全受控的标准答案,连大模型生成这一步都省了。
07
PART
上线前必跑:8道验收题与6种翻车速修表
配置全部跑通后,怎么判断这个知识库敢不敢发给全公司或客户用?
验收要分两步走:先在「召回测试」页看检索找没找对片段,再进对话界面看模型答没答对。上线前必须跑通这8类验收题:
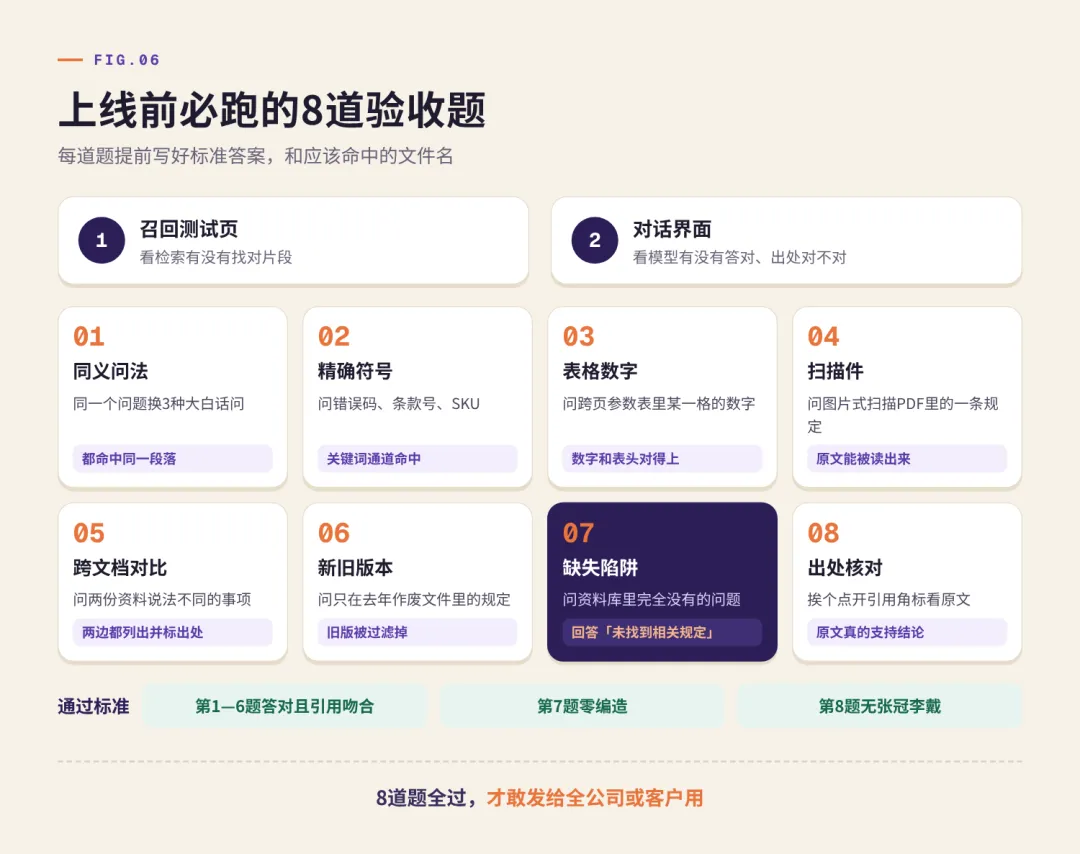
如果测下来发现某道题翻车了,不用慌,直接按这张排障速修表对症下药:
08
PART
写在最后
把上面这套链路走完一遍你就会发现:一个真正能上生产环境的企业级知识库,20%的工夫在接模型,80%的真功夫全在文档解析、父子分段设计、混合检索调参和验收题打磨上。
一旦把这4步配稳,不管是律所的合同案例库、诊所与医疗团队的指南共识库、电商与SaaS团队的售后工单库,还是咨询公司与OPC(一人公司)长年积累的交付方案库,都能真正变成一个回答有理有据、随时点回原文、能替你分担80%重复问答与资料检索的可靠系统。
如果你手头正好有一批业务文档、SOP、合同或行业资料,想在公司内部或自己的OPC业务里搭一套带出处、不乱答、支持私有化部署的知识库与自动化工作流,不想自己花几个星期从头试解析器、调分段参数和写验收集,欢迎直接联系我。
我可以帮你从梳理现有资料开始,定制解析与分段方案、调好混合检索与防胡编规则、配好权限,最后拿你们团队真实的业务问题跑完一轮完整验收,直接交付一套能上手干活的成品系统与后续维护手册。
THANKS FOR READING