ARTICLE · 1400800
我把12个文档拖到元宝里,客户端和网页版在这里第6个分叉了
为了对比这两个客户端在「拖文件进去」这件事上的差距,2026年11月22日我将一批相同的文件拖入了桌面客户端和网页版的腾讯元宝。
目前公开资料中可以查到的硬指标不多。2026年8月9日php.cn整理的说明是这样的:一个文件不超过100MB;解析后的文本不超过3万汉字;单次上传不超过50个文件,这些数字两端基本对齐了,但实际使用的时候你看到的界面反馈和它失效的方式是两码事。
拖入瞬间的差别
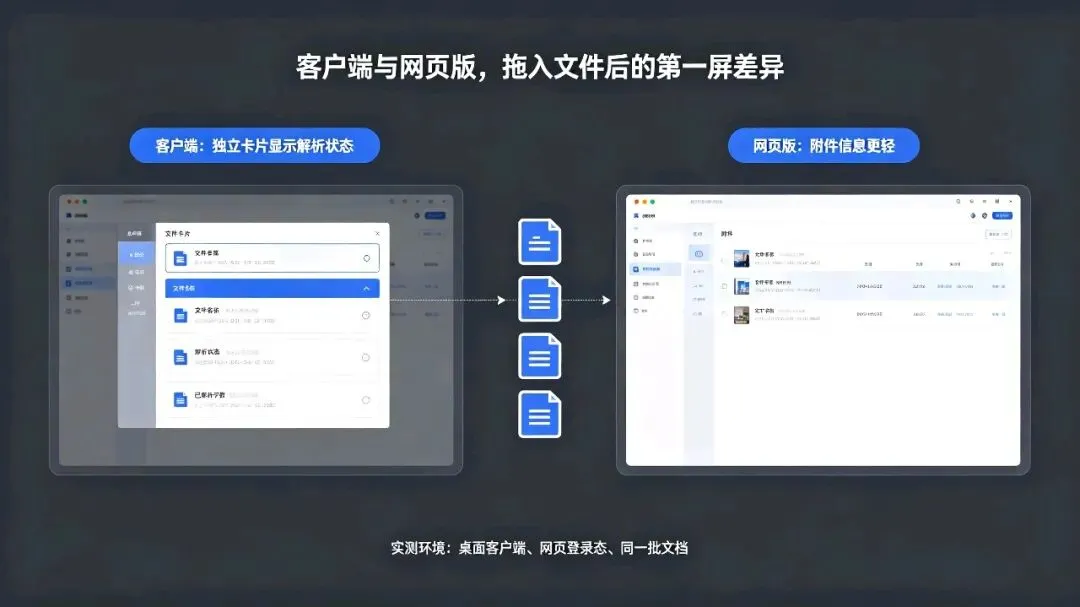
我们首先来对比一下拖入的瞬间有什么不同之处,客户端会在将文件拖进对话窗口后首先弹出一张独立卡片,在这张卡片上,我们会看到文件名、体积以及解析状态分两行显示,等后台读取完毕之后在卡片底部补一行字数统计信息"已解析多少字",如果字数没有出来时发送消息还会提示我们当前的文件尚未就绪。
不过,与桌面端不同的是,在网页端中,一旦拖进附件,它就会直接出现在输入框下方,只有缩略图和文件名,没有任何独立的字数状态行,而解析进度也只能通过等待对话气泡里的回复来间接判断,失败了也不会在卡片上留下任何痕迹。
批量拖入的狭窄范围
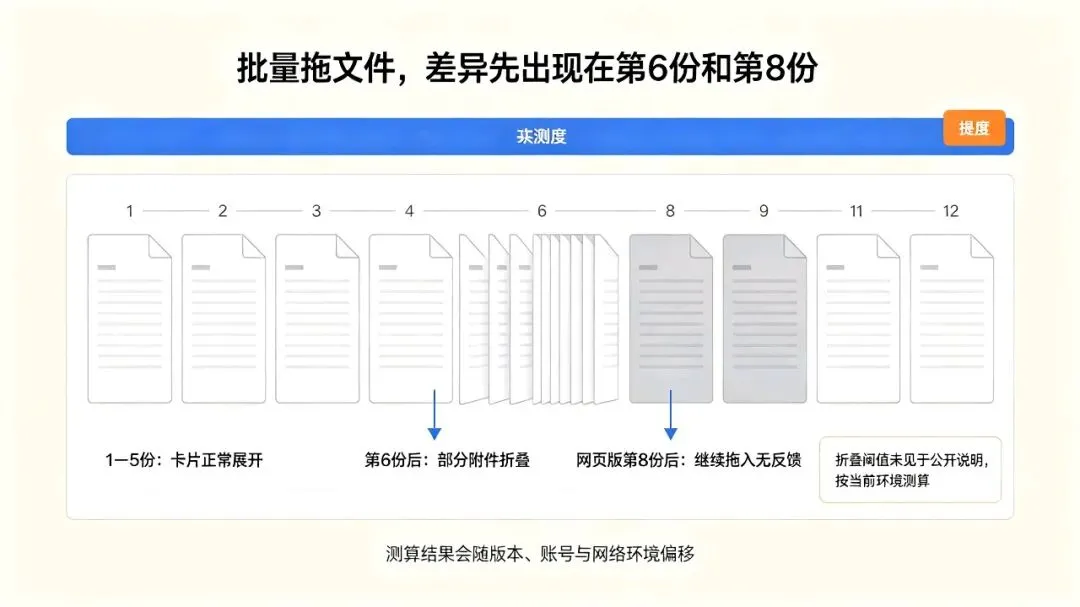
相比公开限制的上限来说,批量拖入的范围狭窄很多按照php.cn 2026年8月9日的说明单次最多50个文件,但我在本机进行实测测算到第6份之后客户端会把后半段附件折叠进更多的小箭头中,不点击就不能看到解析的状态。
第8份的时候拖拽区域开始灰化了,在这之后向内拖拽的话后面的几份则不会生成卡片,而没有提示错误信息。
在网页版中此外,我需要说明的是,这个折叠的阈值,官方给的文档中并没有给出,而是经过我一份份地加入文件算出来的,不同用户的版本可能会略有浮动。
扫描件PDF最容易翻车
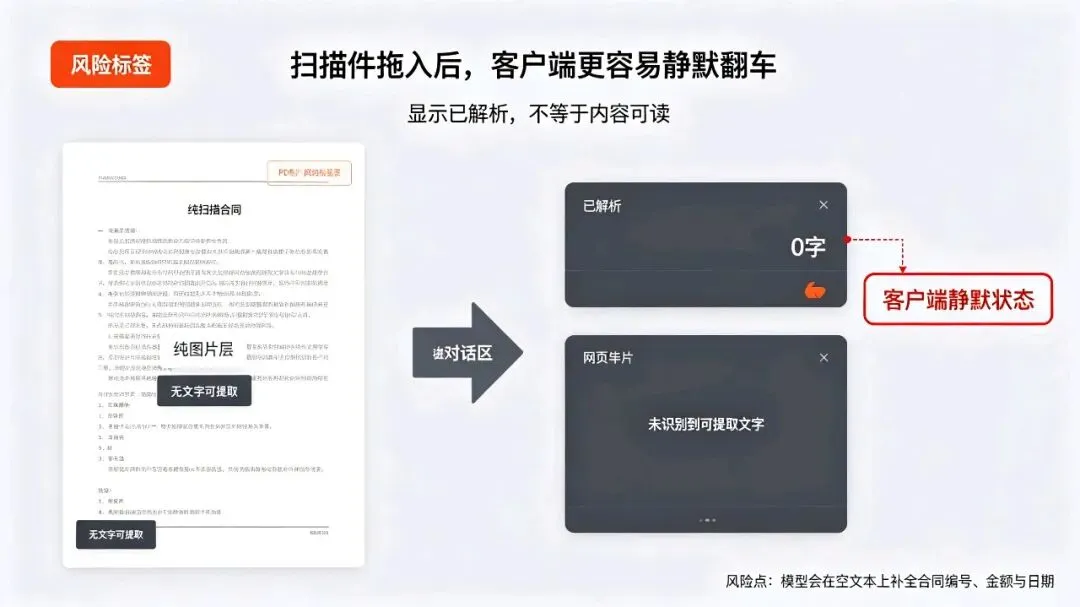
最容易翻车的莫过于纯扫描件PDF了。我就用一个只有图片、没有文字层的扫描版的合同做一个测试。
客户端卡片照常显示的是“已解析”,而提取出来的字数是0,紧接着模型就开始顺着文件名和我的提问硬编条款了,把没见过的金额日期写得像是模一样的样子;对于网页版本,在同一个文件中它会直接弹出'未识别到可提取文字'的提示而不允许你带着空的文字进入对话框。
这种区别很重要,客户端的静默成功比起报错更可怕:你认为客户端已经读取到了消息,但实际上什么都没有看到。
大文件和表格的考验
我们再来试一试大文件和表格。一个接近100MB上限的Word文档,在客户端上上传的时候,明显能感觉到它用的时间更久,卡片上的体积数字会先跳一下再稳定;网页版在文件超过这个量级的时候,偶尔会在传输中途把附件撤回到输入框外,需要重新拖一次。
如果你有一个比较复杂的表格,里面包含有合并单元格的情况下,可能会在两端出现列错位的情况;而客户端由于会先把文件先下载到本地的缓存中,所以可以重新再传一次保留原表,网页版则刷新页面之后附件记录就会被清除掉。
至于3万汉字这个截断线,根据公开说明里面写的总的字数,我计算下来,3万字的截断是在按照文档顺序从文档末尾开始截断,并且不会在中间留下提示。
两边到底怎么选
通常情况下,在使用普通的文字版PDF、Word、Excel进行操作的时候,两边的体验差别不会太大;而真正能拉开差别的还是在批量、扫描件以及临界体积等这些特殊的场景中。
客户端比较适合你的手上有很多文件,需要多次查看每个文档的处理进度以及网络环境不太好的情况;而网页版则具有无需下载软件的优势,并且对于扫描件的失败信息更为直接。
今天晚上你可以尝试找一份自己正在阅读中的PDF文档试试看:在网页版中先拖动它一次,并记录下你看到的字数和提示报错信息,然后换到客户端中再拖入同样的文件并对比两个卡片的状态行。
你在拖拽进入元宝时遇到过的最离谱的一次误读是什么?