当前时间: 2026-08-17 18:10:25
分类:办公文件
评论(0)
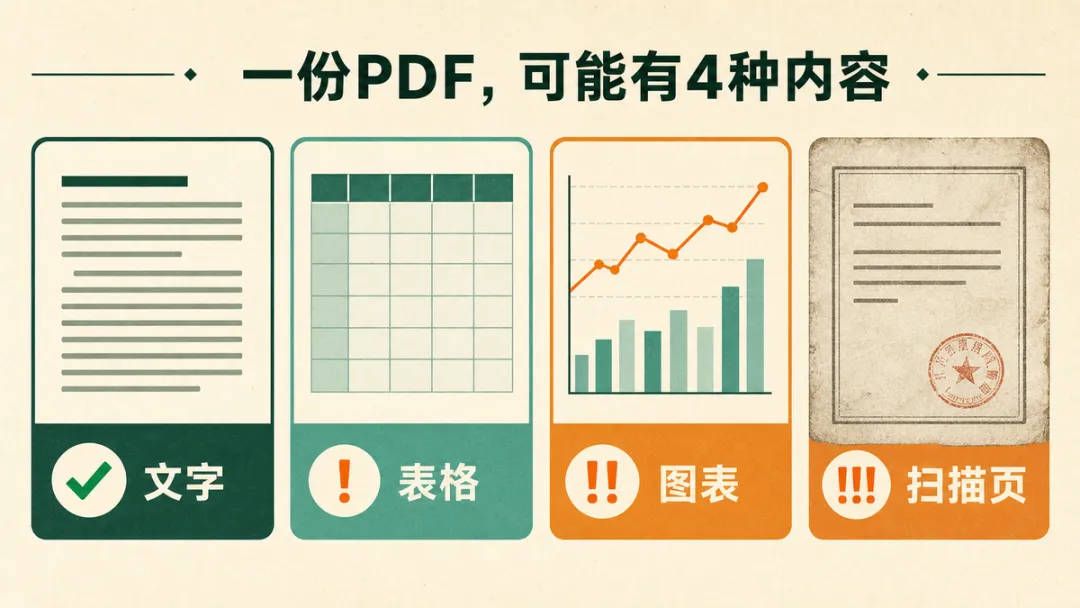
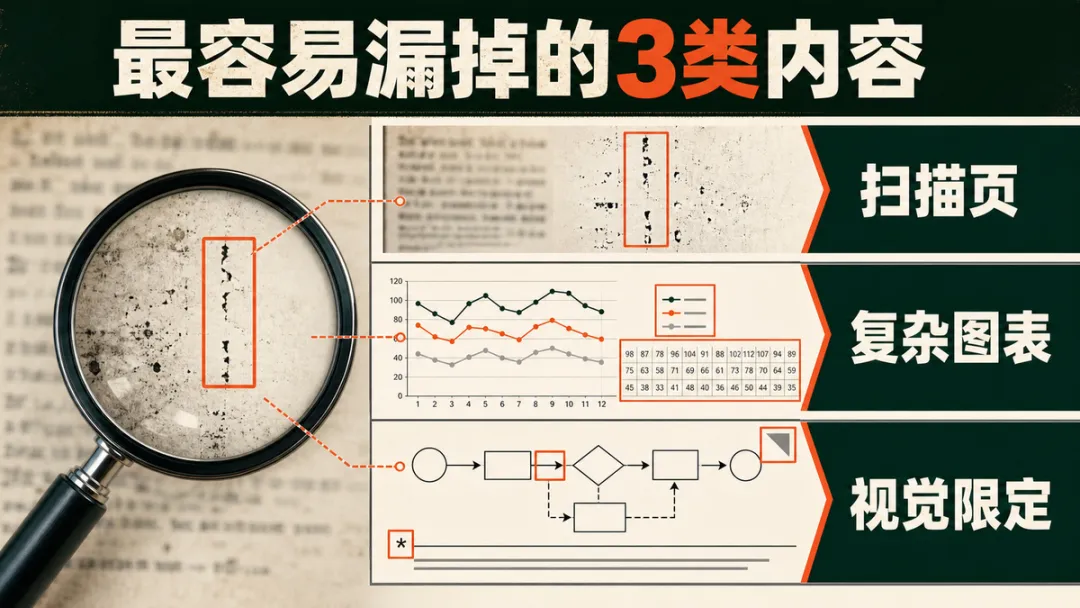
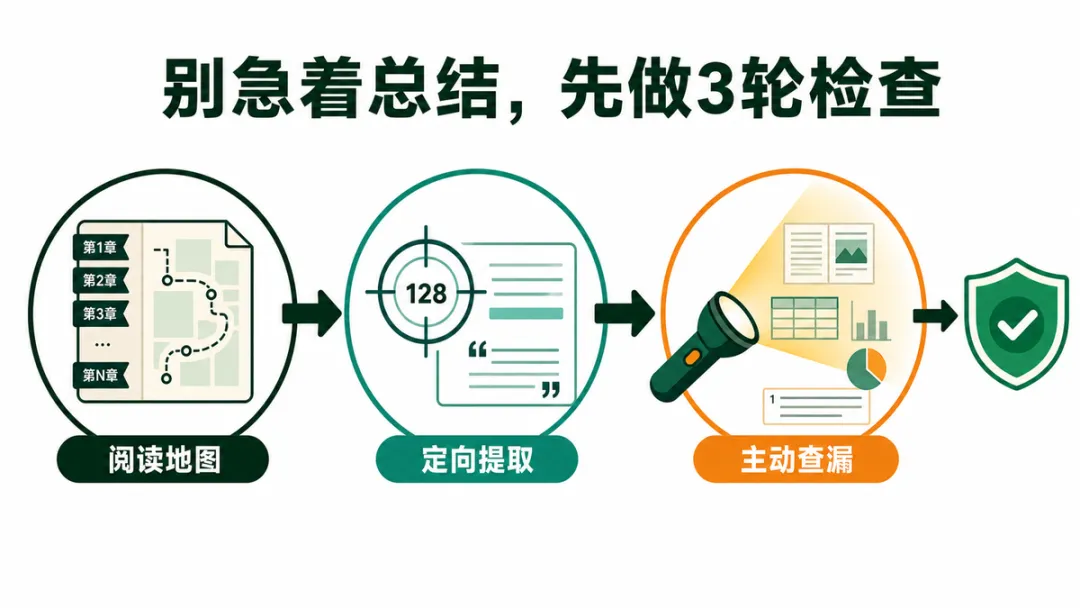
GPT能直接读长PDF吗?真正容易漏掉的是图表手里有一份几十页甚至上百页的PDF,很多人的第一反应是:文件上传成功,不等于GPT完整看懂了文件里的每一项内容。尤其当关键结论藏在扫描页、图表、流程图或复杂排版里时,一份读起来很流畅的摘要,也可能漏掉真正重要的信息。对于文字清晰、结构正常的PDF,GPT很适合帮助你完成三类工作:它可以先列出文档主题、章节结构、关键结论和需要重点阅读的位置。你不用从第一页开始逐字翻。“这份文件中所有涉及交付时间、费用、违约责任的内容分别在哪一页?”这种带着明确目标的提取,通常比一段笼统摘要更有用。例如把调研报告整理成会议提纲,把制度文件整理成执行清单,或者比较两份方案的差异。OpenAI目前的官方说明也把PDF上传的典型用途归为综合、转换和信息提取,包括总结研究报告、查找特定主题和抽取相关内容。如果文件中的页面本质上是一张张图片,而不是可以选中的文字,精确提取就可能不稳定。数字、印章、小字和表格尤其需要人工复核。一张趋势图可能用颜色区分不同数据,一张报价表可能存在合并单元格。GPT即使说出了一个合理结论,也不代表它准确读取了每个数值和对应关系。例如流程图中的箭头、图片旁的小字、页面角落里的限定条件。目前不同方案对PDF内嵌视觉内容的处理能力并不完全相同。不能默认所有账户都能把PDF里的图片、图表和文字一起完整理解。请先不要总结。请列出这份PDF的章节结构、每个章节的页码范围、主要主题,并标记你无法确认或可能没有读取完整的页面。请只提取与“费用、交付时间、责任边界”有关的原文信息。每条都标出页码;找不到就写“未找到”,不要自行补充。请列出本次回答可能遗漏的内容,重点检查扫描页、表格、图表、脚注和附录。哪些地方需要我单独截图上传?这三轮的价值不在于让GPT“保证不出错”,而是让遗漏更容易被发现。如果你要用PDF里的信息做报价、合同、政策或经营决策,不要直接采用摘要里的数字。
发现关键内容位于图表或扫描页时,可以把对应页面单独截图,再让GPT识别和解释。最终数字仍应回到原文件核对。所以,GPT读长PDF最实用的方式,不是“一键读完后替你下结论”,而是:这才是真正能节省时间、又不容易被流畅答案误导的用法。参考资料:OpenAI《File Uploads FAQ》《Data analysis with ChatGPT》,信息核验日期为2026年7月25日。具体可用能力可能因方案、模型和工作区设置不同而变化。
 夜雨聆风