文档文本内容
专题 03 概率与统计下的新定义
【题型归纳目录】
题型一:二项式定理新定义
题型二:排列组合新定义
题型三:概率新定义
题型四:统计方法新定义
题型五:信息熵问题
【方法技巧与总结】
解概率与统计下的新定义题,就是要细读定义关键词,理解本质特征,适时转化为“熟悉”问题.总
之,解决此类问题,取决于已有知识、技能、数学思想的掌握和基本活动经验的积累,还需要不断的实践
和反思,不然就谈不上“自然”的、完整的解题.
【典型例题】
题型一:二项式定理新定义
【典例1-1】(2024·湖南衡阳·二模)莫比乌斯函数在数论中有着广泛的应用.所有大于1的正整数 都可
以被唯一表示为有限个质数的乘积形式: ( 为 的质因数个数, 为质数,
),例如: ,对应 .现对任意
,定义莫比乌斯函数
(1)求 ;
(2)若正整数 互质,证明: ;
(3)若 且 ,记 的所有真因数(除了1和 以外的因数)依次为 ,证明:
.
【解析】(1)因为 ,易知 ,
所以 ;
又 ,因为5的指数 ,所以 ;
(2)①若 或 ,因为 ,所以 ;
②若 ,且存在质数 ,使得 或 的质因数分解中包含 ,则 的质因数分解中一定也包含
,
所以 ,
③若 ,且不存在②中的 ,可设 ,其中 均为质数,则 ,
因为 互质,所以 互不相等,
所以 ,
综上可知
(3)由于 ,所以可设 , 为偶数,
的所有因数,除了1之外都是 中的若干个数的乘积,从 个质数中任选 个数的
乘积一共有 种结果,
所以
,
所以 .
【典例1-2】(2024·安徽合肥·一模)“ 数”在量子代数研究中发挥了重要作用.设 是非零实数,对任
意 ,定义“ 数” 利用“ 数”可定义“ 阶乘”
和“ 组合数”,即对任意 ,
(1)计算: ;
(2)证明:对于任意 ,
(3)证明:对于任意 ,
【解析】(1)由定义可知,
.
(2)因为 ,.
又
,
所以
(3)由定义得:
对任意 .
结合(2)可知
即 ,
也即 .
所以 ,
,
……
.
上述 个等式两边分别相加得:
.
【变式1-1】(2024·高三·江苏苏州·阶段练习)甲、乙、丙三人以正四棱锥和正三棱柱为研究对象,设棱
长为 ,若甲从其中一个底面边长和高都为2的正四棱锥的5个顶点中随机选取3个点构成三角形,定义
随机变量 的值为其三角形的面积;若乙从正四棱锥(和甲研究的四棱锥一样)的8条棱中任取2条,定
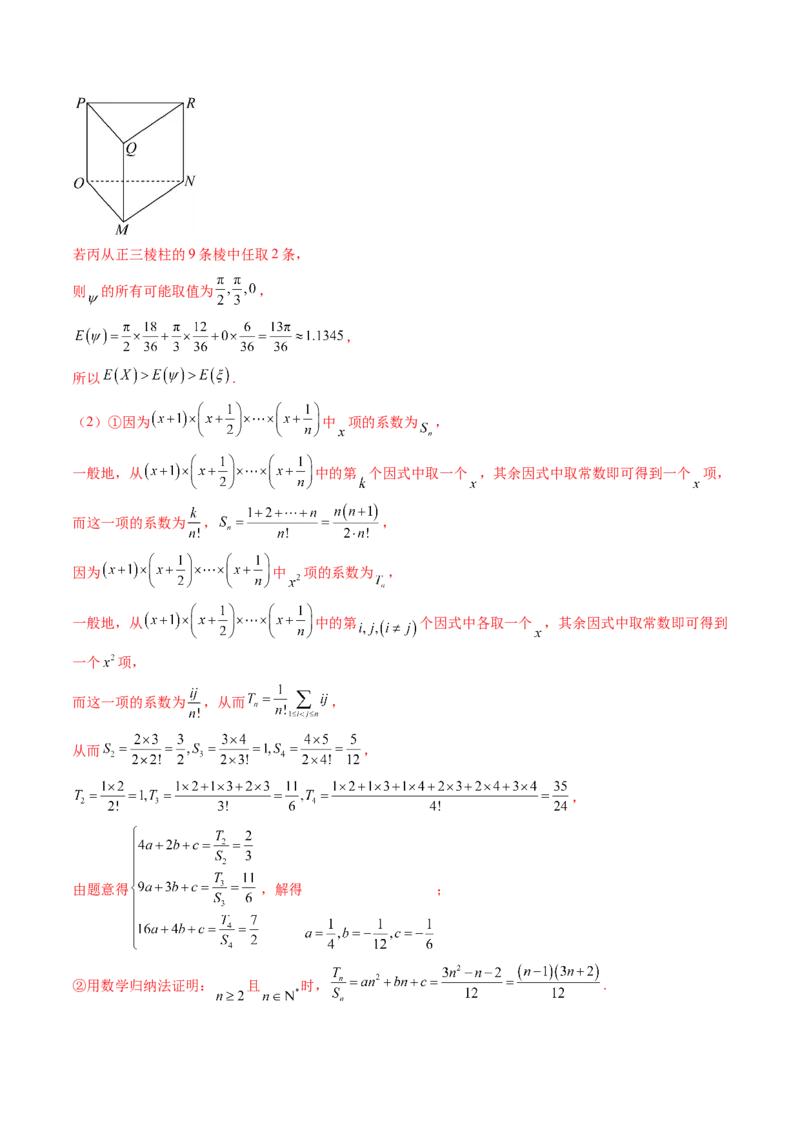
义随机变量 的值为这两条棱的夹角大小(弧度制);若丙从正三棱柱的 9条棱中任取2条,定义随机变
量 的值为这两条棱的夹角大小(弧度制).(1)比较三种随机变量的数学期望大小;(参考数据
)
(2)现单独研究棱长 ,记 ( 且 ),其展开式中含 项的系数为 ,
含 项的系数为 .
①若 ,对 成立,求实数 , , 的值;
②对①中的实数 , , 用数字归纳法证明:对任意 且 , 都成立.
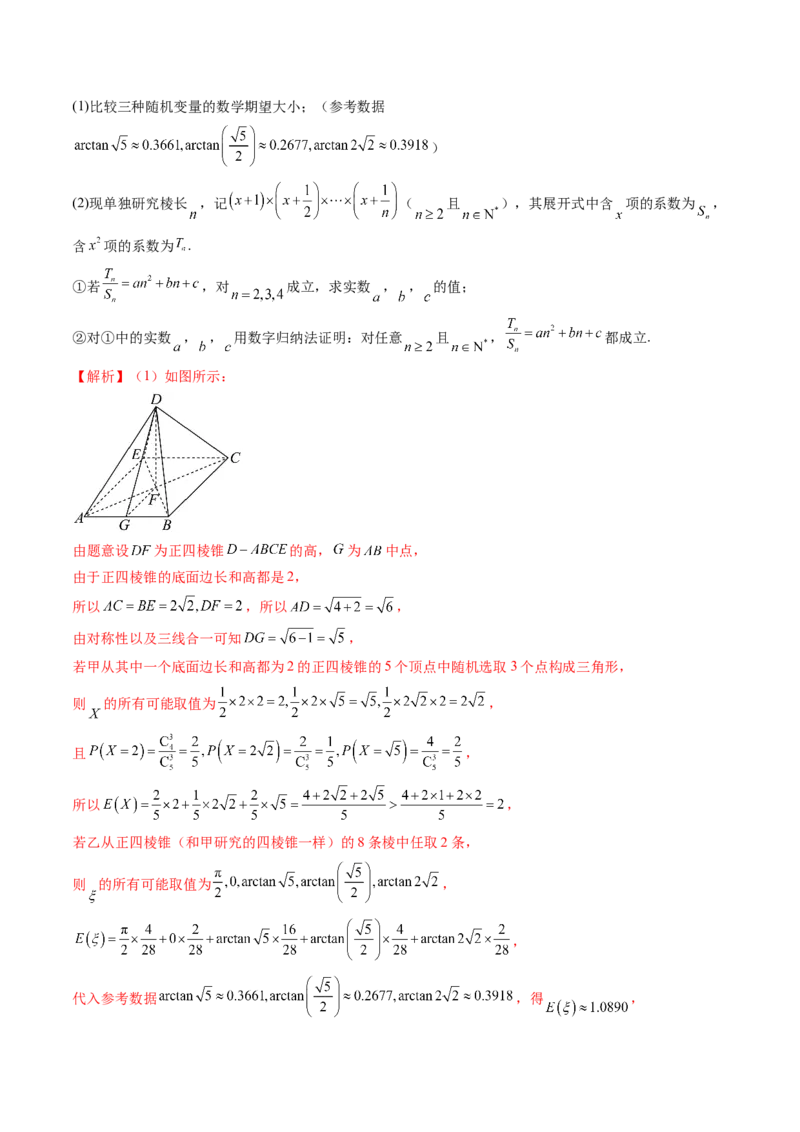
【解析】(1)如图所示:
由题意设 为正四棱锥 的高, 为 中点,
由于正四棱锥的底面边长和高都是2,
所以 ,所以 ,
由对称性以及三线合一可知 ,
若甲从其中一个底面边长和高都为2的正四棱锥的5个顶点中随机选取3个点构成三角形,
则 的所有可能取值为 ,
且 ,
所以 ,
若乙从正四棱锥(和甲研究的四棱锥一样)的8条棱中任取2条,
则 的所有可能取值为 ,
,
代入参考数据 ,得 ,若丙从正三棱柱的9条棱中任取2条,
则 的所有可能取值为 ,
,
所以 .
(2)①因为 中 项的系数为 ,
一般地,从 中的第 个因式中取一个 ,其余因式中取常数即可得到一个 项,
而这一项的系数为 , ,
因为 中 项的系数为 ,
一般地,从 中的第 个因式中各取一个 ,其余因式中取常数即可得到
一个 项,
而这一项的系数为 ,从而 ,
从而 ,
,
由题意得 ,解得 ;
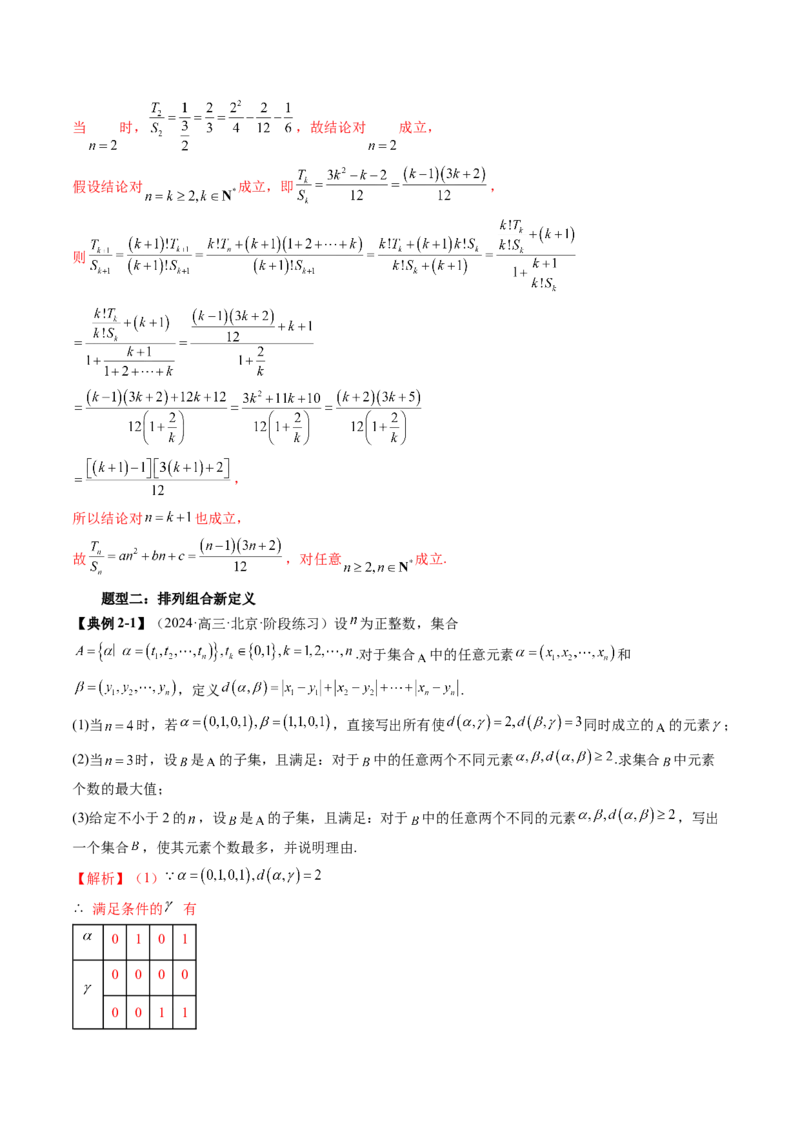
②用数学归纳法证明: 且 时, .当 时, ,故结论对 成立,
假设结论对 成立,即 ,
则
,
所以结论对 也成立,
故 ,对任意 成立.
题型二:排列组合新定义
【典例2-1】(2024·高三·北京·阶段练习)设 为正整数,集合
.对于集合 中的任意元素 和
,定义 .
(1)当 时,若 ,直接写出所有使 同时成立的 的元素 ;
(2)当 时,设 是 的子集,且满足:对于 中的任意两个不同元素 .求集合 中元素
个数的最大值;
(3)给定不小于2的 ,设 是 的子集,且满足:对于 中的任意两个不同的元素 ,写出
一个集合 ,使其元素个数最多,并说明理由.
【解析】(1)
满足条件的 有
0 1 0 1
0 0 0 0
0 0 1 10 1 1 0
1 0 0 1
1 1 0 0
1 1 1 1
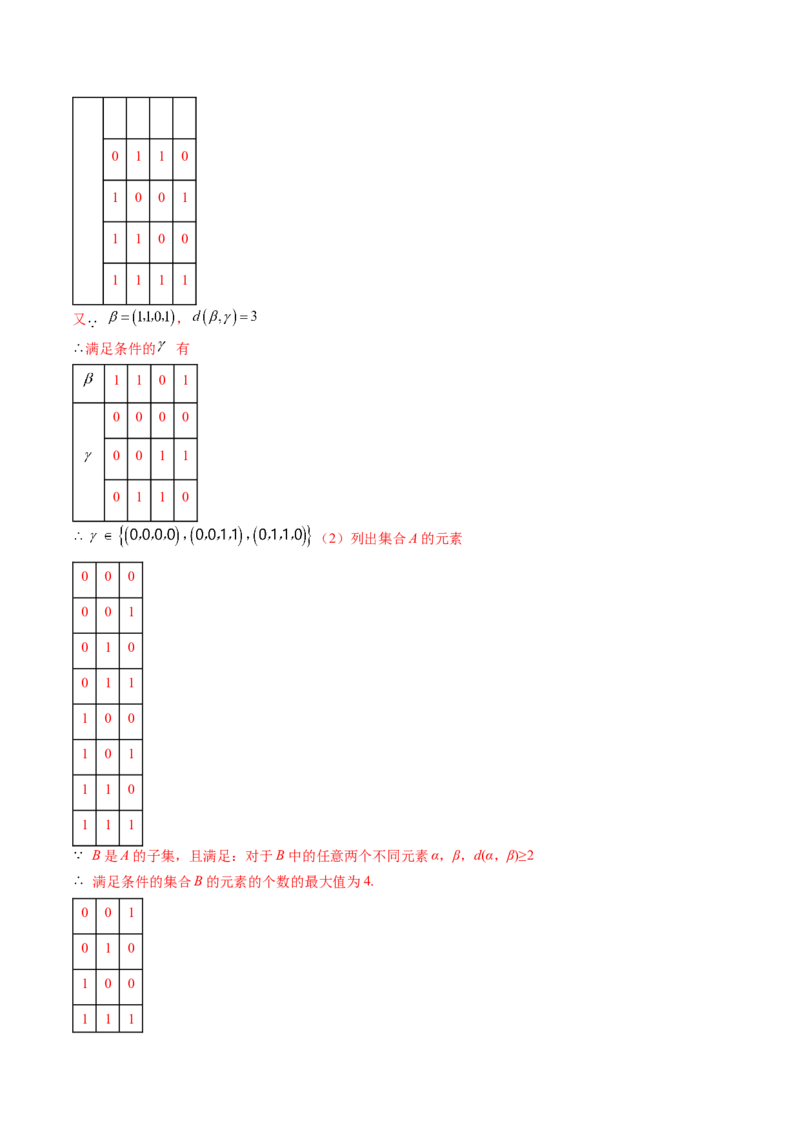
又 ,
满足条件的 有
1 1 0 1
0 0 0 0
0 0 1 1
0 1 1 0
(2)列出集合A的元素
0 0 0
0 0 1
0 1 0
0 1 1
1 0 0
1 0 1
1 1 0
1 1 1
B是A的子集,且满足:对于B中的任意两个不同元素α,β,d(α,β)≥2
满足条件的集合B的元素的个数的最大值为4.
0 0 1
0 1 0
1 0 0
1 1 1(3) d(α,β)≥2
B中的元素应该含有奇数个1
若n=2,则含有奇数个1的元素有 个;
若n=3,则含有奇数个1的元素有 个;
若n=4,则含有奇数个1的元素有 个;
若n=5,则含有奇数个1的元素有 个;
当n=3时,
【典例2-2】(2024·高三·浙江·开学考试)一般地, 元有序实数对 称为 维向量.对于两个
维向量 ,定义:两点间距离 ,利
用 维向量的运算可以解决许多统计学问题.其中,依据“距离”分类是一种常用的分类方法:计算向量与
每个标准点的距离 ,与哪个标准点的距离 最近就归为哪类.某公司对应聘员工的不同方面能力进行测
试,得到业务能力分值 、管理能力分值 、计算机能力分值 、沟通能力分值 (分值
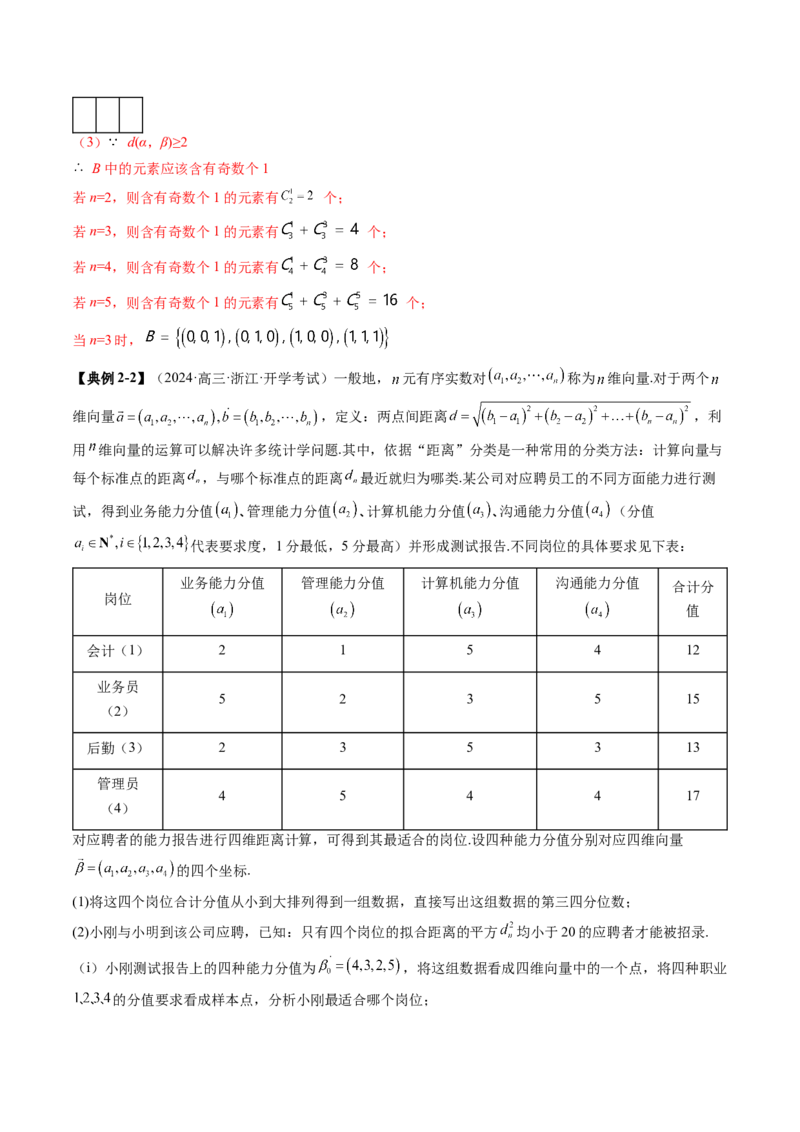
代表要求度,1分最低,5分最高)并形成测试报告.不同岗位的具体要求见下表:
业务能力分值 管理能力分值 计算机能力分值 沟通能力分值 合计分
岗位
值
会计(1) 2 1 5 4 12
业务员
5 2 3 5 15
(2)
后勤(3) 2 3 5 3 13
管理员
4 5 4 4 17
(4)
对应聘者的能力报告进行四维距离计算,可得到其最适合的岗位.设四种能力分值分别对应四维向量
的四个坐标.
(1)将这四个岗位合计分值从小到大排列得到一组数据,直接写出这组数据的第三四分位数;
(2)小刚与小明到该公司应聘,已知:只有四个岗位的拟合距离的平方 均小于20的应聘者才能被招录.
(i)小刚测试报告上的四种能力分值为 ,将这组数据看成四维向量中的一个点,将四种职业
的分值要求看成样本点,分析小刚最适合哪个岗位;(ii)小明已经被该公司招录,其测试报告经公司计算得到四种职业 的推荐率 分别为
,试求小明的各项能力分值.
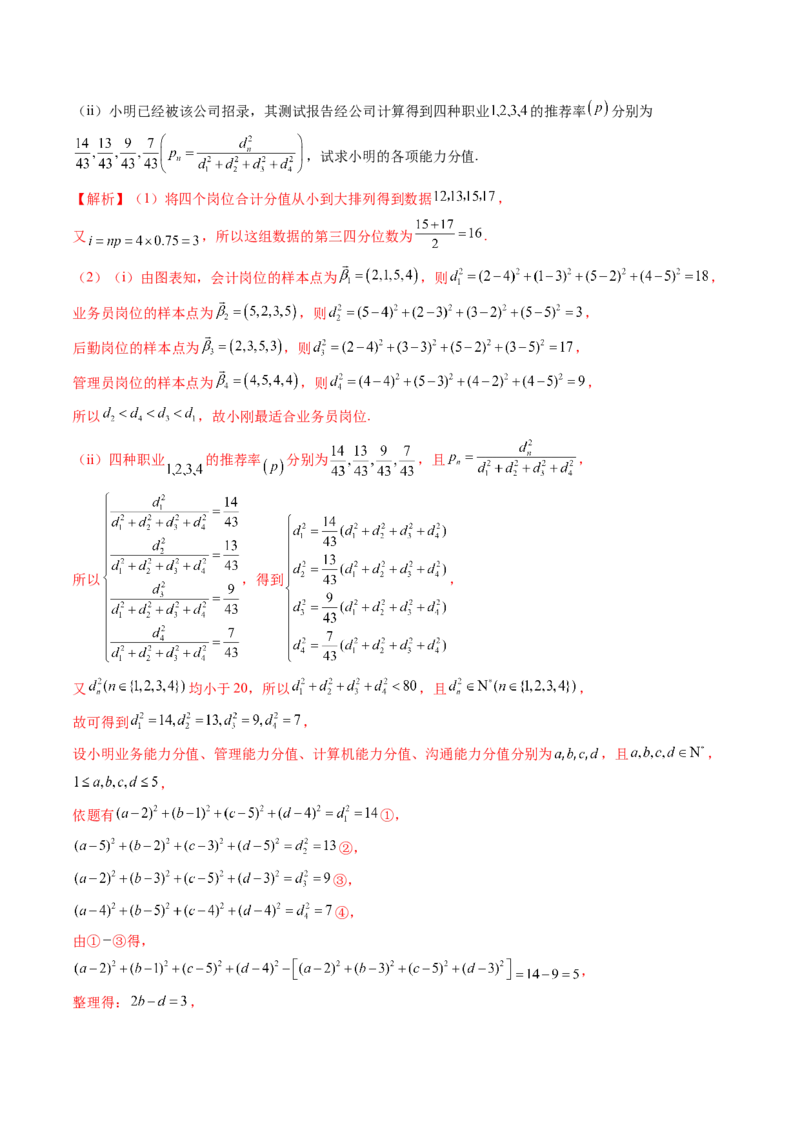
【解析】(1)将四个岗位合计分值从小到大排列得到数据 ,
又 ,所以这组数据的第三四分位数为 .
(2)(i)由图表知,会计岗位的样本点为 ,则 ,
业务员岗位的样本点为 ,则 ,
后勤岗位的样本点为 ,则 ,
管理员岗位的样本点为 ,则 ,
所以 ,故小刚最适合业务员岗位.
(ii)四种职业 的推荐率 分别为 ,且 ,
所以 ,得到 ,
又 均小于20,所以 ,且 ,
故可得到 ,
设小明业务能力分值、管理能力分值、计算机能力分值、沟通能力分值分别为 ,且 ,
,
依题有 ①,
②,
③,
④,
由① ③得,
,
整理得: ,故有 三组正整数解,
对于第一组解,代入④式有 ,不成立;
对于第二组解,代入①式有 ,
解得 或 ,代入②④式均不成立;
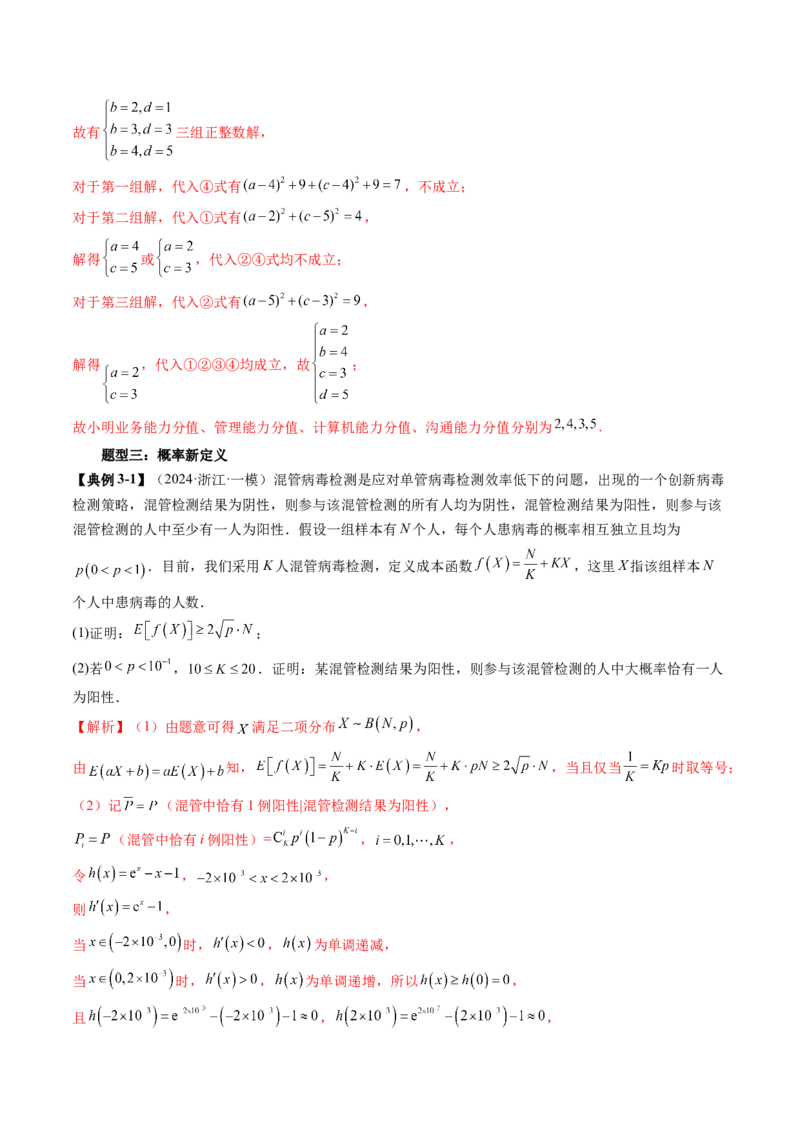
对于第三组解,代入②式有 ,
解得 ,代入①②③④均成立,故 ;
故小明业务能力分值、管理能力分值、计算机能力分值、沟通能力分值分别为 .
题型三:概率新定义
【典例3-1】(2024·浙江·一模)混管病毒检测是应对单管病毒检测效率低下的问题,出现的一个创新病毒
检测策略,混管检测结果为阴性,则参与该混管检测的所有人均为阴性,混管检测结果为阳性,则参与该
混管检测的人中至少有一人为阳性.假设一组样本有N个人,每个人患病毒的概率相互独立且均为
.目前,我们采用K人混管病毒检测,定义成本函数 ,这里X指该组样本N
个人中患病毒的人数.
(1)证明: ;
(2)若 , .证明:某混管检测结果为阳性,则参与该混管检测的人中大概率恰有一人
为阳性.
【解析】(1)由题意可得 满足二项分布 ,
由 知, ,当且仅当 时取等号;
(2)记 (混管中恰有1例阳性|混管检测结果为阳性),
(混管中恰有i例阳性)= , ,
令 , ,
则 ,
当 时, , 为单调递减,
当 时, , 为单调递增,所以 ,
且 , ,所以当 , 即 ,两边取自然对数可得 ,
所以当 , 时,
所以 ,
则 .
故某混管检测结果为阳性,则参与该混管检测的人中大概率恰有一人为阳性.
【典例3-2】(2024·辽宁·模拟预测)条件概率与条件期望是现代概率体系中的重要概念.近年来,随着人们
对随机现象的不断观察和研究,条件概率和条件期望已经被广泛的利用到日常生产生活中.定义:设X,Y
是离散型随机变量,则X在给定事件 条件下的期望为
,其中 为X的所有可能取值集合,
表示事件“ ”与事件“ ”都发生的概率.某射击手进行射击训练,每次射击击
中目标的概率均为p( ),射击进行到击中目标两次时停止.设 表示第一次击中目标时的射击次数,
表示第二次击中目标时的射击次数.
(1)求 , ;
(2)求 , .
【解析】(1)由题设, ,
.
(2)由题设,
;
同(1), , ,
所以 .
【变式3-1】(2024·福建漳州·一模)在数字通信中,信号是由数字0和1组成的序列,发送每个信号数字
之间相互独立.由于随机因素的干扰,发送的信号0或1有可能被错误地接收为1或0.
(1)记发送信号变量为 ,接收信号变量为 ,且满足 , ,
,求 ;(2)当发送信号0时,接收为0的概率为 ,定义随机变量 的“有效值”为
(其中 是 的所有可能的取值, ),发送信号“000”的接收
信号为“ ”,记 为 , , 三个数字之和,求 的“有效值”.( , )
【解析】(1)由题意可知: , ,
所以 .
(2)由题意可知:当发送信号0时,接收为0的概率为 ,接收为1的概率为 ,
可知: 的可能取值有0,1,2,3,
则 ,
,
可得 的“有效值”
,
即 的“有效值”约为0.45.
题型四:统计方法新定义
【典例 4-1】(2024·全国·模拟预测)某校 20 名学生的数学成绩 和知识竞赛成绩
如下表:
学生编号 1 2 3 4 5 6 7 8 9 10
8
数学成绩 100 99 96 93 90 85 83 80 77
8
7 10
知识竞赛成绩 290 160 220 200 65 90 60 270
0 0
1
学生编号 11 12 13 14 15 17 18 19 20
6
数学成绩 75 74 72 70 68 6 60 50 39 356
3
知识竞赛成绩 45 35 40 50 25 20 15 10 5
0
计算可得数学成绩的平均值是 ,知识竞赛成绩的平均值是 ,并且 ,
, .
(1)求这组学生的数学成绩和知识竞赛成绩的样本相关系数(精确到 ).
(2)设 ,变量 和变量 的一组样本数据为 ,其中 两两不相同,
两两不相同.记 在 中的排名是第 位, 在 中的排
名是第 位, .定义变量 和变量 的“斯皮尔曼相关系数”(记为 )为变量 的排名和变
量 的排名的样本相关系数.
(i)记 , .证明: .
(ii)用(i)的公式求这组学生的数学成绩和知识竞赛成绩的“斯皮尔曼相关系数”(精确到 ).
(3)比较(1)和(2)(ii)的计算结果,简述“斯皮尔曼相关系数”在分析线性相关性时的优势.
注:参考公式与参考数据. ; ; .
【解析】(1)
由题意,这组学生数学成绩和知识竞赛成绩的样本相关系数为
(2)(i)证明:因为 和 都是1,2, , 的一个排列,所以
,
,
从而 和 的平均数都是 .
因此, ,同理可得 ,
由 于
,
所以 ;
(ii)由题目数据,可写出 与 的值如下:
同学编号 1 2 3 4 5 6 7 8 9 10
数学成绩排名 1 2 3 4 5 6 7 8 9 10
知识竞赛成绩排名 1 5 3 4 9 8 7 6 10 2
同学编号 11 12 13 14 15 16 17 18 19 20
数学成绩排名 11 12 13 14 15 16 17 18 19 20
知识竞赛成绩排名 12 14 13 11 16 15 17 18 19 20
所以 ,并且 .
因此这组学生的数学成绩和知识竞赛成绩的斯皮尔曼相关系数是
(3)答案①:斯皮尔曼相关系数对于异常值不太敏感,如果数据中有明显的异常值,那么用斯皮尔曼相
关系数比用样本相关系数更能刻画某种线性关系;
答案②:斯皮尔曼相关系数刻画的是样本数据排名的样本相关系数,与具体的数值无关,只与排名有关.
如果一组数据有异常值,但排名依然符合一定的线性关系,则可以采用斯皮尔曼相关系数刻画线性关系.
【典例4-2】(2024·全国·模拟预测)冰雪运动是深受学生喜爱的一项户外运动,为了研究性别与学生是否
喜爱冰雪运动之间的关系,从某高校男、女生中各随机抽取100名进行问卷调查,得到如下列联表
.
喜爱 不喜爱
男生
女生(1)当 时,从样本中不喜爱冰雪运动的学生中,按性别采用分层抽样的方法抽取6人,再从这6人中
随机抽取3人调研不喜爱的原因,记这3人中女生的人数为 ,求 的分布列与数学期望.
(2)定义 ,其中 为列联表中第 行第 列的实际数据,
为列联表中第 行与第 列的总频率之积再乘以列联表的总额数得到的理论频数,如 ,
.基于小概率值 的检验规则:首先提出零假设 (变量X,Y相互独立),然
后计算 的值,当 时,我们推断 不成立,即认为X和Y不独立,该推断犯错误的概率不超过 ;
否则,我们没有充分证据推断 不成立,可以认为X和Y独立.根据 的计算公式,求解下面问题:
①当 时,依据小概率值 的独立性检验,分析性别与是否喜爱冰雪运动有关?
②当 时,依据小概率值 的独立性检验,若认为性别与是否喜爱冰雪运动有关,则至少有多少
名男生喜爱冰雪运动?
附:
0.1 0.025 0.005
2.706 5.024 7.879
【解析】(1)当 时,用分层抽样的方法抽取的不喜爱冰雪运动的6人中,男生有2人,女生有4人,
由题意可知, 的可能取值为1,2,3.
, , ,
的分布列为
1 2 3
P
.
(2)①零假设为 :性别与是否喜爱冰雪运动独立,即性别与是否喜爱冰雪运动无关联.
当 时, , , , ,
, , , ,
.∵ ,
∴根据小概率值 的独立性检验,我们推断 不成立,即认为性别与是否喜爱冰雪运动有关联,
此推断犯错误的概率不超过0.005.
② ,
由题意可知, ,整理得 .
又 , ,∴ , 的最大值为4.
又 ,∴至少有76名男生喜爱冰雪运动.
【变式4-1】(2024·高三·北京·期末)在测试中,客观题难度的计算公式为 ,其中 为第 题的难度,
为答对该题的人数, 为参加测试的总人数.现对某校高三年级240名学生进行一次测试,共5道客观
题.测试前根据对学生的了解,预估了每道题的难度,如下表所示:
题号 1 2 3 4 5
考前预估难度 0.9 0.8 0.7 0.6 0.4
测试后,随机抽取了20名学生的答题数据进行统计,结果如下:
题号 1 2 3 4 5
实测答对人 1 1
16 14 4
数 6 4
(1)根据题中数据,估计这240名学生中第5题的实测答对人数;
(2)从抽样的20名学生中随机抽取2名学生,记这2名学生中第5题答对的人数为X,求X的分布列和数学
期望;
(3)定义统计量 ,其中 为第 题的实测难度, 为第 题的预估难度
.规定:若 ,则称该次测试的难度预估合理,否则为不合理.判断本次测试的难度预
估是否合理.
【解析】(1)因为20人中答对第5题的人数为4人,因此第5题的实测难度为 ,
所以估计240人中有 人实测答对第5题.
(2) 的可能取值是0,1,2.
; ; .
的分布列为:
0 1 2.
(3)第1题的实测难度为 ,同理可得:第2题的实测难度为 ,
第3题的实测难度为 ,第4题的实测难度为 ,第5题的实测难度为0.2,
故 .
因为 ,
所以,该次测试的难度预估是合理的.
题型五:信息熵问题
【典例5-1】(2024·高三·河北·阶段练习)信息熵是信息论之父香农(Shannon)定义的一个重要概念,香
农在1948年发表的论文《通信的数学理论》中指出,任何信息都存在冗余,把信息中排除了冗余后的平均
信息量称为“信息熵”,并给出了计算信息熵的数学表达式:设随机变量 所有可能的取值为
,且 ,定义 的信息熵 .
(1)当 时,计算 ;
(2)若 ,判断并证明当 增大时, 的变化趋势;
(3)若 ,随机变量 所有可能的取值为 ,且 ,证
明: .
【解析】(1)当 时,则 ,所以
(2) 随着 的增大而增大.
当 ,则 ,
设 ,则 ,
因此 随着 的增大而增大.
(3)证明:若 ,随机变量 所有可能的取值为 ,且
..
,
因为 ,故
故 ,
由于 ,所以 ,
所以 ,所以 ,
所以 .
【典例5-2】(2024·高三·河北·期末)在信息论中,熵(entropy)是接收的每条消息中包含的信息的平均
量,又被称为信息熵、信源熵、平均自信息量.这里,“消息”代表来自分布或数据流中的事件、样本或特征.
(熵最好理解为不确定性的量度而不是确定性的量度,因为越随机的信源的熵越大)来自信源的另一个特
征是样本的概率分布.这里的想法是,比较不可能发生的事情,当它发生了,会提供更多的信息.由于一些
其他的原因,把信息(熵)定义为概率分布的对数的相反数是有道理的.事件的概率分布和每个事件的信息
量构成了一个随机变量,这个随机变量的均值(即期望)就是这个分布产生的信息量的平均值(即熵).熵
的单位通常为比特,但也用 、 、 计量,取决于定义用到对数的底.采用概率分布的对数作为信息
的量度的原因是其可加性.例如,投掷一次硬币提供了1 的信息,而掷 次就为 位.更一般地,你需要
用 位来表示一个可以取 个值的变量.在1948年,克劳德•艾尔伍德•香农将热力学的熵,引入到信息
论,因此它又被称为香农滳.而正是信息熵的发现,使得1871年由英国物理学家詹姆斯•麦克斯韦为了说明
违反热力学第二定律的可能性而设想的麦克斯韦妖理论被推翻.设随机变量 所有取值为 ,定义
的信息熵 ,( , ).
(1)若 ,试探索 的信息熵关于 的解析式,并求其最大值;
(2)若 , ( ),求此时的信息熵.
【解析】(1)当 时, , ,
令 , ,
则 ,所以函数 在 上单调递增,在 上单调递减,
所以当 时, 取得最大值,最大值为 .
(2)因为 , ( ),
所以 ( ),
故 ,
而 ,
于是 ,
整理得
令 ,
则 ,
两式相减得
因此 ,
所以 .
【变式5-1】(2024·安徽合肥·模拟预测)在一个典型的数字通信系统中,由信源发出携带着一定信息量的
消息,转换成适合在信道中传输的信号,通过信道传送到接收端.有干扰无记忆信道是实际应用中常见的信
道,信道中存在干扰,从而造成传输的信息失真.在有干扰无记忆信道中,信道输入和输出是两个取值
的随机变量,分别记作 和 .条件概率 ,描述了输入信号和输
出信号之间统计依赖关系,反映了信道的统计特性.随机变量 的平均信息量定义为:
.当 时,信道疑义度定义为(1)设有一非均匀的骰子,若其任一面出现的概率与该面上的点数成正比,试求扔一次骰子向上的面出现的
点数 的平均信息量 ;
(2)设某信道的输入变量 与输出变量 均取值0,1.满足:
.试回答以下问题:
①求 的值;
②求该信道的信道疑义度 的最大值.
【解析】(1)设 表示扔一非均匀股子点数,则
1 2 3 4 5 6
扔一次平均得到的信息量为
.
(2)①由全概率公式,得
②由题意, .
所以,
;其中 .
令
.
时 时, ,
.
【过关测试】
1.(2024·高三·全国·专题练习)定义: 为不超过 的最大整数部分,如 , .
甲、乙两个学生高二的6次数学测试成绩(测试时间为90分钟,满分100分)如下表所示:
高二成
第1次考试 第2次考试 第3次考试 第4次考试 第5次考试 第6次考试
绩
甲 68 74 77 84 88 95
乙 71 75 82 84 86 94
进入高三后,由于改进了学习方法,甲、乙这两个学生的数学测试成绩预计有了大的提升.设甲或乙高二
的数学测试成绩为 ,若 ,则甲或乙高三的数学测试成绩预计为
;若 ,则甲或乙高三的数学测试成绩预计为
100.
(1)试预测:在将要进行的高三6次数学测试成绩(测试时间为90分钟,满分100分)中,甲、乙两个学生
的成绩(填入下列表格内);
高三成
第1次考试 第2次考试 第3次考试 第4次考试 第5次考试 第6次考试
绩
甲
乙
(2)记高三任意一次数学测试成绩估计值为 ,规定: ,记为转换分为3分; ,记为转
换分为4分; ,记为转换分为5分.现从乙的6次数学测试成绩中任意抽取2次,求这2次成绩
的转换分之和为8分的概率.
【解析】(1)由已知,预测高三6次数学测试成绩如下:高三成
第1次考试 第2次考试 第3次考试 第4次考试 第5次考试 第6次考试
绩
甲 84 90 93 93 97 100
乙 87 91 91 93 95 100
(2)在乙的高三6次数学测试预测成绩中,转换分为3分的有1次,记为A;
转换分为4分的有4次,记为 ;转换分为5分的有1次,记为 .
现从中任意抽取2次,一共有15种结果,它们是:
,
,
其中2次成绩的转换分之和为8分有7种结果,它们是:
,
则所求概率为 .
2.(2024·全国·一模)正态分布与指数分布均是用于描述连续型随机变量的概率分布.对于一个给定的连
续型随机变量 ,定义其累积分布函数为 .已知某系统由一个电源和并联的 , , 三
个元件组成,在电源电压正常的情况下,至少一个元件正常工作才可保证系统正常运行,电源及各元件之
间工作相互独立.
(1)已知电源电压 (单位: )服从正态分布 ,且 的累积分布函数为 ,求 ;
(2)在数理统计中,指数分布常用于描述事件发生的时间间隔或等待时间.已知随机变量 (单位:天)表
示某高稳定性元件的使用寿命,且服从指数分布,其累积分布函数为 .
(ⅰ)设 ,证明: ;
(ⅱ)若第 天元件 发生故障,求第 天系统正常运行的概率.
附:若随机变量 服从正态分布 ,则 , ,
.
【解析】(1)由题设得 , ,
所以
(2)(ⅰ)由题设得:,
,
所以 .
(ⅱ)由(ⅰ)得 ,
所以第 天元件 , 正常工作的概率均为 .
为使第 天系统仍正常工作,元件 , 必须至少有一个正常工作,
因此所求概率为 .
3.为考查一种新的治疗方案是否优于标准治疗方案,现从一批患者中随机抽取100名患者,均分为两组,
分别采用新治疗方案与标准治疗方案治疗,记其中采用新治疗方案与标准治疗方案治疗受益的患者数分别
为 和 .在治疗过程中,用指标 衡量患者是否受益:若 ,则认为指标 正常;若
,则认为指标 偏高;若 ,则认为指标 偏低.若治疗后患者的指标 正常,则认为患
者受益于治疗方案,否则认为患者未受益于治疗方案.根据历史数据,受益于标准治疗方案的患者比例为
0.6.
(1)求 和 ;
(2)统计量是关于样本的函数,选取合适的统计量可以有效地反映样本信息.设采用新治疗方案治疗第 位
的患者治疗后指标 的值为 , ,2, ,50,定义函数:
(ⅰ)简述以下统计量所反映的样本信息,并说明理由.
① ;
② ;
(ⅱ)为确定新的治疗方案是否优于标准治疗方案,请在(ⅰ)中的统计量中选择一个合适的统计量,并
根据统计量的取值作出统计决策.
【解析】(1)
由题设知 服从二项分布 ,
所以 , .
(2)(ⅰ)统计量 反映了未受益于新治疗方案的患者数,理由如下:
若患者 受益于新治疗方案,则其指标 的值 满足 ,否则 ,会被统计量 计入,且每位未受益于新治疗方案的患者恰使得统计量 的数值加1.
统计量 反映了未受益于新治疗方案且指标 偏高的患者数量,理由如下:
若患者 接受新治疗方案后指标 偏低或正常,则其指标 的值 满足
若指标 偏高,则 , ,会被统计量 计入,
且每位未受益于新治疗方案且指标 偏高的患者恰使得统计量 的数值加1.
(ⅱ)由题设知新治疗方案优于标准治疗方案等价于一次试验中 的观测值大于 的数学期望,
由(ⅰ)知 的观测值 ,
因此当 ,即 时,认为新治疗方案优于标准治疗方案;
当 ,即 时,认为新治疗方案与标准治疗方案相当;
当 ,即 时,认为新治疗方案劣于标准治疗方案.
4.(2024·高二·四川遂宁·期末)2020年新冠肺炎疫情期间,某区政府为了解本区居民对区政府防疫工作
的满意度,从本区居民中随机抽取若干居民进行评分(满分100分),根据调查数据制成如下表格和频率
分布直方图,已知评分在 的居民有600人.
满意度评
分
满意度等
不满意 基本满意 满意 非常满意
级
(1)求频率分布直方图中a的值及所调查的总人数;
(2)定义满意度指数 ,若 ,则防疫工作需要进行大调整,否则不需要
大调整.根据所学知识判断该区防疫工作是否带要进行大调整?(同一组中的数据用该组区间的中点值为
代表)
(3)为了解部分居民不满意的原因,从不满意的居民评分在 , 中用分层抽样的方法抽取6名
居民,倾听他们的意见,并从6人中抽取2人担任防疫工作的监督员,求这2人中仅有一人对防疫工作的
评分在 内的概率.
【解析】(1)由频率分布直方图得 ,即 ,解得 ,
设总共调查了 人,则 ,解得 .
(2)由频率分布直方图知,各段的频率分别为: ,
所以 ,所以该区防疫工作
不需要大的调整.
(3)由 ,
即不满意的人数在两段的人数分别为 ,
所以每段抽取的人数分别为 ,
即在第一段的人记作 ,第二段的人为 ,
所以抽取两人的基本事件为: ,共有15个,
仅由一人来自 的基本事件有: ,共有8个,
所以,这2人中仅有一人对防疫工作的评分在 内的概率为 .
5.(2024·高三·北京·阶段练习)设离散型随机变量X和Y有相同的可能取值,它们的分布列分别为
, , , , .指标 可用来刻
画X和Y的相似程度,其定义为 .设 .
(1)若 ,求 ;
(2)若 ,求 的最小值;
(3)对任意与 有相同可能取值的随机变量 ,证明: ,并指出取等号的充要条件
【解析】(1)不妨设 ,则 .
所以
.
(2)当 时, ,
记,
则
,
令 ,则 ,
令 ,则 ,
当 时, , 单调递减;
当 时, , 单调递增;
所以 ,则 单调递增,而 ,
所以 在 为负数,在 为正数,
则 在 单调递减,在 单调递增,
所以 的最小值为 .
(3)令 ,则 ,
当 时, , 单调递增;
当 时, , 单调递减;
所以 ,即 ,当且仅当 时,等号成立,
则当 时, ,所以 ,即 ,
故 ,
当且仅当对所有的 时等号成立.
6.(2024·高三·河南·期末)某国家队要从男子短道速滑1500米的两名种子选手甲、乙中选派一人参加
2022年的北京冬季奥运会,他们近期六次训练成绩如下表:
次序( ) 1 2 3 4 5 6
13
甲( 秒) 142 140 139 141 140
813
乙( 秒) 138 142 137 143 141
9
(1)分别计算甲、乙两人这六次训练的平均成绩 ,偏优均差 ;
(2)若 ,则称甲、乙这次训练的水平相当,现从这六次训练中随机抽取3次,求有
两次甲、乙水平相当的概率.
注:若数据 中的最优数据为 ,定义 为偏优均差.本
题中的最优数据即最短时间.
【解析】(1)由题可知 ,
,
,
,
.
(2)六次训练中只有第4,6次甲、乙水平相当,
从六次中任选三次的结果有
,
,
共20种,
其中有两次甲、乙水平相当的结果有4种,
故所求概率 .
7.(2024·全国·模拟预测)某医科大学科研部门为研究退休人员是否患痴呆症与上网的关系,随机调查了
市100位退休人员,统计数据如下表所示:
患痴呆症 不患痴呆症 合计
上网 16 32 48
不上网 34 18 52
合计 50 50 100
(1)依据 的独立性检验,能否认为该市退休人员是否患痴呆症与上网之间有关联?
(2)从该市退休人员中任取一位,记事件A为“此人患痴呆症”, 为“此人上网”,则 为“此人不患痴呆症”,定义事件A的强度 ,在事件 发生的条件下A的强度 .
(i)证明: ;
(ⅱ)利用抽样的样本数据,估计 的值.
附: ,其中 .
0.050 0.010 0.001
3.841 6.635 10.828
【解析】(1)
根据列联表中的数据,得
,
根据小概率值 的独立性检验,我们推断 不成立,
即认为该市退休人员是否患痴呆症与上网之间有关联,
此推断犯错误的概率不大于0.01.
(2) ,
所以 ,
故
.
(ⅱ)由样本数据可得 ,
所以 ,所以估计 的值为2.8.(2024·高三·山西朔州·开学考试)某校20名学生的数学成绩 和知识竞赛成绩
如下表:
学生编号i 1 2 3 4 5 6 7 8 9 10
8
数学成绩 100 99 96 93 90 85 83 80 77
8
7 10
知识竞赛成绩 290 160 220 200 65 90 60 270
0 0
1
学生编号i 11 12 13 14 15 17 18 19 20
6
6
数学成绩 75 74 72 70 68 60 50 39 35
6
3
知识竞赛成绩 45 35 40 50 25 20 15 10 5
0
计算可得数学成绩的平均值是 ,知识竞赛成绩的平均值是 ,并且 ,
, .
(1)求这组学生的数学成绩和知识竞赛成绩的样本相关系数(精确到0.01);
(2)设 ,变量 和变量 的一组样本数据为 ,其中 两两不相同,
两两不相同.记 在 中的排名是第 位, 在 中的排名是
第 位, .定义变量 和变量 的“斯皮尔曼相关系数”(记为 )为变量 的排名和变量 的
排名的样本相关系数.
(i)记 , .证明: ;
(ii)用(i)的公式求得这组学生的数学成绩和知识竞赛成绩的“斯皮尔曼相关系数”约为0.91,简述
“斯皮尔曼相关系数”在分析线性相关性时的优势.
注:参考公式与参考数据.
; ; .
【解析】(1)由题意,这组学生数学成绩和知识竞赛成绩的样本相关系数为;
(2)(i)证明:因为 和 都是1,2, , 的一个排列,所以
,
,
从而 和 的平均数都是 .
因此, ,
同理可得 ,
由于
,
所以 .
(ii)这组学生的数学成绩和知识竞赛成绩的斯皮尔曼相关系数是0.91,
答案①:斯皮尔曼相关系数对于异常值不太敏感,如果数据中有明显的异常值,那么用斯皮尔曼相关系数
比用样本相关系数更能刻画某种线性关系;
答案②:斯皮尔曼相关系数刻画的是样本数据排名的样本相关系数,与具体的数值无关,只与排名有关.
如果一组数据有异常值,但排名依然符合一定的线性关系,则可以采用斯皮尔曼相关系数刻画线性关系.
9.(2024·高二·湖北·阶段练习)“难度系数”反映试题的难易程度,难度系数越大,题目得分率越高,
难度也就越小,“难度系数”的计算公式为 ,其中L为难度系数,Y为样本平均失分,W为试卷
总分(一般为100分或150分).某校高二年级的老师命制了某专题共5套测试卷(总分150分),用于
对该校高二年级480名学生进行每周测试,测试前根据自己对学生的了解,预估了每套试卷的难度系数,
如下表所示:
试卷序号i 1 2 3 4 5
考前预估难度系数 0.7 0.64 0.6 0.6 0.55测试后,随机抽取了50名学生的数据进行统计,结果如下:
试卷序号
1 2 3 4 5
i
平均分/分 102 99 93 93 87
(1)根据试卷2的预估难度系数估计这480名学生第2套试卷的平均分;
(2)试卷的预估难度系数和实测难度系数之间会有偏差,设 为第i套试卷的实测难度系数,并定义统计量
, 若 ,则认为试卷的难度系数预估合理,否则认为不
合理.以样本平均分估计总体平均分,试检验这5套试卷难度系数的预估是否合理.
(3)聪聪与明明是学习上的好伙伴,两人商定以同时解答上述试卷易错题进行“智力竞赛”,规则如下:双
方轮换选题,每人每次只选1道题,先正确解答者记1分,否则计0分,先多得2分者为胜方.若在此次竞
赛中,聪聪选题时聪聪得分的概率为 ,明明选题时聪聪得分的概率为 ,各题的结果相互独立,二人约
定从0:0计分并由聪聪先选题,求聪聪3:1获胜的概率 .
【解析】(1)由题意,
由试卷2的难度系数 ,
解得平均失分: ,
∴这480名学生第2套试卷的平均分为 分;
(2)由题意及(1)得,
, , ,
, ,
则
,
∴这5套试卷难度系数的预估合理
(3)由题意及(1)(2)得,
聪聪先答对第一题:
聪聪没先答对第一题:
∴聪聪3:1获胜的概率聪聪3:1获胜的概率:
10.(2024·高三·四川成都·开学考试)在三维空间中,立方体的坐标可用三维坐标 表示,其中.而在n维空间中 ,以单位长度为边长的“立方体”的项点坐标可表
示为n维坐标 ,其中 .现有如下定义:在n维空间中两点间的曼
哈顿距离为两点 与 坐标差的绝对值之和,即为
.回答下列问题:
(1)求出n维“立方体”的顶点数;
(2)在n维“立方体”中任取两个不同顶点,记随机变量X为所取两点间的曼哈顿距离
①求出X的分布列与期望;
②证明:在n足够大时,随机变量X的方差小于 .
(已知对于正态分布 ,P随X变化关系可表示为 )
【解析】(1)对于n维坐标 有 两种选择( ).
故共有 种选择,即 个顶点
(2)①对于 的随机变量,在坐标 与 中有k个坐标值不同,
即 ,剩下 个坐标值满足 .
此时所对应情况数为 种.
即
故分布列为:
0 1 2 …
…
数学期望
倒序相加得
即 .
②当n足够大时, .
设正态分布 ,正态分布曲线为 ,由定义知该正态分布期望为 ,方差为 .
设题中分布列所形成的曲线为 .
则当 与 均在 处取最大值,若当 时,
且 ,则可认为方差 .
I. :当 时,有
即 .
II.
当n足够大时,有
当 时,
当 时,
故 .
综上所述,可以认为 .
11.(2024·高二·福建莆田·期末)为了考查一种新疫苗预防某一疾病的效果,研究人员对一地区某种动物
进行试验,从该试验群中随机抽查了50只,得到如下的样本数据(单位:只):
发
没发病 合计
病
接种疫苗 8 16 24
没接种疫苗 17 9 26
合计 25 25 50(1)能否有95%的把握认为接种该疫苗与预防该疾病有关?
(2)从该地区此动物群中任取一只,记 表示此动物发病, 表示此动物没发病, 表示此动物接种疫苗,
定义事件 的优势 ,在事件 发生的条件下 的优势 .
(ⅰ)证明: ;
(ⅱ)利用抽样的样本数据,给出 , 的估计值,并给出 的估计值.附:
,其中 .
0.050 0.010 0.001
3.841 6.635 10.828
【解析】(1)根据联表可得 ,
所以有95%的把握认为接种该疫苗与预防该疾病有关.
(2)(ⅰ)由于 ,
所以 , ,
故 ,故得证.
(ⅱ)由二联表中的数据可得 , ,所以 ,
12.(2024·高一·山东济南·期末)独立事件是一个非常基础但又十分重要的概念,对于理解和应用概率论
和统计学至关重要.它的概念最早可以追湖到17世纪的布莱兹·帕斯卡和皮埃尔·德·费马,当时被定义为彼
此不相关的事件.19世纪初期,皮埃尔·西蒙·拉普拉斯在他的《概率的分析理论》中给出了相互独立事件
的概率乘法公式.对任意两个事件 与 ,如果 成立,则称事件 与事件 相互独立,
简称为独立.
(1)若事件 与事件 相互独立,证明: 与 相互独立;
(2)甲、乙两人参加数学节的答题活动,每轮活动由甲、乙各答一题,已知甲每轮答对的概率为 ,乙每轮
答对的概率为 .在每轮活动中,甲和乙答对与否互不影响,各轮结果也互不影响,求甲乙两人在两轮活动中答对3道题的概率.
【解析】(1)证明:已知事件 与事件 相互独立,则
因为 ,且事件 与事件 互斥
所以
所以
由事件的独立性定义, 与 相互独立;
(2)设 分别表示甲在两轮活动中答对1道题,答对2道题的事件
分别表示乙在两轮活动中答对1道题,答对2道题的事件
根据独立性假定,得
设 “甲乙两人在两轮活
动中答对3道题”,则
且 与 互斥, 与 , 与 分别相互独立
所以
所以甲乙两人在两轮活动中答对3道题的概率时 .
13.(2024·高二·浙江台州·期末)袋中有大小、形状完全相同的2个红球,4个白球.采用放回摸球,从袋
中摸出一个球,定义T变换为:若摸出的球是白球,把函数 图象上所有点的横坐标缩短到原来 倍,
(纵坐标不变);若摸出的是红球,将函数 图象上所有的点向下平移1个单位.函数 经过1次T
变换后的函数记为 ,经过2次T变换后的函数记为 ,…,经过n次T变换后的函数记为
.现对函数 进行连续的T变换.
(1)若第一次摸出的是白球,第二次摸出的是红球,求 ;
(2)记 ,求随机变量 的分布列及数学期望.
【解析】(1)第一次从袋子中摸出的是白球,把函数 变换为 ;
第二次从袋子中摸出的是红球,把函数 变换为 ;
所以 .
(2)经过3次T变换后 有3种情况,若摸出的3个球都是白球,则 , ;
若摸出的3个球为2个白球1个红球,则 , ;
若摸出的3个球为1个白球2个红球,则 , ;
若摸出的3个球都是红球,则 , .
所以随机变量X的取值为 ,
因为一次摸球取得为红球的概率为 ,取得白球的概率为 ,
所以 , ,
, .
所以求随机变量 的分布列为
所以 .
14.(2024·高三·上海宝山·阶段练习)已知 为正整数,对于给定的函数 ,定义一个 次多项式
如下:
(1)当 时,求 ;
(2)当 时,求 ;
(3)当 时,求 .
【解析】(1)若 ,则 ,
所以 .
(2)若 ,则 ,
因为,
所以
.
(3)若 ,则
.
15.(2024·高一·辽宁葫芦岛·期末)通信信号利用BEC信道传输,若BEC信道传输成功,则接收端收到
的信号与发来的信号完全相同.若BEC信道传输失败,则接收端收不到任何信号.传输技术有两种:一种
是传统通信传输技术,采用多个信道各自独立传输信号(以两个信道为例,如图1).
另一种是华为公司5G信号现使用的土耳其通讯技术专家Erdal Arikan教授的发明的极化码技术(以两个信
道为例,如图2).传输规则如下,信号 直接从信道2传输;信号 在传输前先与 “异或”运算得
到信号 ,再从信道1传输.若信道1与信道2均成功输出,则两信号通过“异或”运算进行解码后,传
至接收端,若信道1输出失败信道2输出成功,则接收端接收到信道2信号,若信道1输出成功信道2输
出失败,则接收端对信号进行自身“异或”运算而解码后,传至接收端.(注:定义“异或”运算: ).假设每个信道传输成
功的概率均为 .
(1)对于传统传输技术,求信号 和 中至少有一个传输成功的概率;
(2)对于Erdal Arikan教授的极化码技术;
①求接收端成功接收信号 的概率;
②若接收端接收到信号 才算成功完成一次任务,求利用极化码技术成功完成一次任务的概率.
【解析】(1)设“信号 和 中至少有一个传输成功”为事件 ,“信号 传输成功”为事件 “信
号 传输成功”为事件
则
(2)若信道1和信道2都传输成功,
由 可得 被成功接收,概率为 ;
若信道1传输成功,信道2传输失败,
由 可得 被成功接收, 接收失败,概率为 ;
若信道2传输成功,信道1传输失败,
可得 被成功接收, 接收失败,概率为 ;
若信道1,2都传输失败,
可得 接收失败,概率为 ;
①接收端成功接收信号 的概率为 ;
②接收端接收到信号 的概率为
16.(2024·高三·河南·阶段练习)2020年新冠肺炎疫情期间,某区政府为了解本区居民对区政府防疫工作
的满意度,从本区居民中随机抽取若干居民进行评分(满分100分),根据调查数据制成如下表格和频率分
布直方图,已知评分在[80,100]的居民有600人满意度评
分
满意度等 基本满
不满意 满意 非常满意
级 意
(1)求频率分布直方图中a的值及所调查的总人数;
(2)定义满意度指数 =(满意程度的平均分)/100,若 <0.8,则防疫工作需要进行大调整,否则不需要大调
整.根据所学知识判断该区防疫工作是否带要进行大调整?(同一组中的数据用该组区间的中点值为代表)
(3)为了解部分居民不满意的原因,从不满意的居民评分在[40,50).[50,60)中用分层抽样的方法抽取6名
居民,倾听他们的意见,并从6人中抽取2人担任防疫工作的监督员,列出抽取的所有基本事件并求这2
人中仅有一人对防疫工作的评分在[40,50)内的概率
【解析】(1) 解得 .
(2)第一步求平均分
第二步满意度指数 所以不需要.
(3)第一步求解在[40,50)的总人数 ,在[50,60)中的总人数 ,共抽取6
人,所以在[40,50)的抽2人,记为 ;在[50,60)中抽4人,记为 .所以抽取的所有基本事件有
共15个基本事件,其中仅有一人对防疫工作的评分在[40,50)
内的基本事件 有8个,所以概率为 .
17.(2024·全国·模拟预测)受疫情、网购的影响,实体店的经营难度增大.某商场在开业时采取打折促销、
直播带货、增加商品体验度等多种方式吸引顾客,力求提高商品销售量.在开业后的前 天,某商品第 天的
日销售量 (单位:件)的统计数据如下表:
时间 1 2 3 4 5
日销售量 /件 100 90 95 80 85
(1)经统计分析,日销售量y与时间t之间具有线性相关关系,试用最小二乘法求出 关于 的线性回归方程
;
(2)定义 ,其中 是实际日销售量, 是预报日销售量, ,2,3,4,
5.若 ,则认为线性回归方程拟合效果优秀;若 ,则认为线性回归方程拟合效果良好;若
,则认为线性回归方程拟合效果很差.试判断第(1)问所求线性回归方程的拟合效果.参考公式:回归直线 的斜率和截距的最小二乘估计公式分别为 , .
【解析】(1) , ,
, ,
, ,
所求线性回归方程为 .
(2) , , ,
同理可得: , , , ,
,∴ ,
,则认为线性回归方程拟合效果优秀;
∴第(1)问所求线性回归方程拟合效果优秀.
18.(2024·高三·陕西西安·阶段练习)“难度系数”反映试题的难易程度,难度系数越大,题目得分率越
高,难度也就越小“难度系数”的计算公式为 ,其中L为难度系数,Y为样本平均失分,W为试
卷总分(一般为100分或150分).某校高二年级的老师命制了某专题共5套测试卷(总分150分),用
于对该校高二年级480名学生进行每周测试,测试前根据自己对学生的了解,预估了每套试卷的难度系数,
如下表所示:
试卷序号i 1 2 3 4 5
考前预估难度系数 0.7 0.64 0.6 0.6 0.55
测试后,随机抽取了50名学生的数据进行统计,结果如下:
试卷序号
1 2 3 4 5
i
平均分/分 102 99 93 93 87
(1)根据试卷2的难度系数估计这480名学生第2套试卷的平均分;
(2)从抽取的50名学生的5套试卷中随机抽取2套试卷,求抽取的2套试卷中恰有1套学生的平均分超
过96分的概率;(3)试卷的预估难度系数和实测难度系数之间会有偏差,设 为第i套试卷的实测难度系数,并定义统
计量 , 若 ,则认为试卷的难度系数预估合理,否则
认为不合理.以样本平均分估计总体平均分,试检验这5套试卷难度系数的预估是否合理.
【解析】(1)由试卷2的难度系数得 ,
解得平均失分 ,
所以根据试卷2的难度系数估计这480名学生第2套试卷的平均分为 分;
(2)5套试卷中随机抽取2套试卷,
,共10种情况,
恰有1套学生的平均分超过96分为 共6种,
所以恰有1套学生的平均分超过96分的概率为 ;
(3) ,
,
,
,
,
则
,
所以这5套试卷难度系数的预估合理.